谁是最接近整数的无理数?一份近整数质量排行榜
- 更新时间 2026-09-25 11:03:36
很久以前,我写过一篇关于近整数(almost integer)的科普文章[1],其中我也提到了我最喜欢的近整数:
文章发表后,反响不错,但也有读者反馈称:近整数不稀奇,可以用程序找到一大堆,比如:
但我们能明显感觉到以上这种近整数与 的区别:后者质量更高,更具美感。所以我就考虑找出一种可以衡量近整数质量的定量标准。
首先,近整数必须是个无理数。其次,我们可以确信两点:
近整数越接近整数,也就是小数点后的0或9越多,其质量越高。这个指标是可以直接计算的。
近整数越“简单”,其质量越高;越“复杂”,其质量越低。
问题就变成了:如何衡量一个近整数的简单或复杂程度?当然,表示一个近整数所需的字符越多,肯定就越复杂。但同样一个字符,0和 的复杂程度是有很大不同的。所以,纯粹以字符多少衡量一个近整数的复杂度并不合理。
幸好已经有人做了类似的事,那就是ries[2]。 ries是一个根据一个数的小数形式,寻找其最可能的表达式的工具,比如对2026.0923这个小数:
./ries 2026.0923 Your target value: T = 2026.0923 mrob.com/ries x/5 = e^6 for x = T - 8.94833 {68} 4 x = e^9 for x = T - 0.321318 {67} sqrt(x-1) = 5*9 for x = T - 0.0923 {79} 4 x-1 = e^9 for x = T - 0.0713181 {82} 9^2/x = atan2(1,5^2) for x = T - 0.0127604 {100} (log_3(x))+e = sqrt(e)+8 for x = T + 0.00343544 {107} 1/(log_3(ln(x))) = sqrt(1-1/sqrt(2)) for x = T - 0.00019062 {112} ln(x/8) = 3^tanpi(1/pi) for x = T + 4.47414e-05 {110} (log_pi(x))+1/phi = tanpi(1/e)+5 for x = T + 2.83762e-05 {127} x-(5*9)^2 = e^(1/(7 phi)) for x = T + 5.46692e-06 {129} (for more results, use the option '-l3') atan2(y,x) = Angle of ray from origin through point (y,x) pi = 3.14159... log_A(B) = logarithm to base A of B = ln(B) / ln(A) tanpi(X) = tan(pi * x) e = base of natural logarithms, 2.71828... sqrt(x) = square root ln(x) = natural logarithm or log base e phi = the golden ratio, (1+sqrt(5))/2 --LHS-- --RHS-- -Total- max complexity: 69 61 130 dead-ends: 3317929 4577545 7895474 Time: 0.124 expressions: 171193 298455 469648 distinct: 83322 100371 183693 Memory: 12928KiB Total equations tested: 8363112462 (8.363e+09)其中输出的第一行是:
x/5 = e^6 for x = T - 8.94833 {68}它的意思就是:,后面的"{68}"就是以上等式左右两边表达式的复杂度,取较高复杂度的一边。它的复杂度计算规则大致如下:
将表达式写成后缀形式,复杂度是每个符号权重之和,权重 = 基数 10 + 符号的个别权重。基数保证每个符号权重为正,搜索才能按复杂度递增终止;它同时让 complexity/10 近似于描述整个表达式所需的十进制位数。
权重表大致如下:
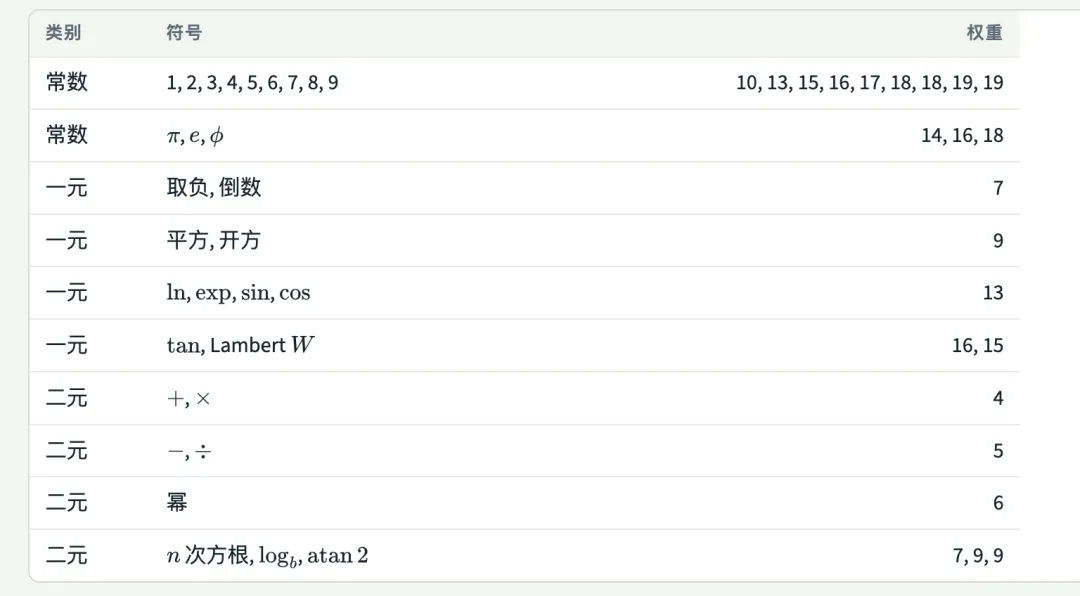
后缀表达式的意思就是运算数字在前,运算符号在后,这样就不需要任何括号。
比如对数字10,先要拆成后缀表达式:2 5 *,其对应的复杂度就是:。一个数字可能有多种后缀表达式写法,所以还需要设法找出其中复杂度最低的一种。
以上这种复杂度计算方式的原理在于,其能使表达式的复杂度近似等于其信息量。可以想象在所有数学论文中,出现频率最高的字符,都是很简单的,其信息量也最低,比如0、1、+、 等。而出现频率越低的符号,其也越复杂,包含的信息也越多。
以上方法可以使表达式的复杂度自然地与其出现频率成反比,同时也贴近其信息量。ries的这个复杂度度量方法非常有效,但用在近整数上,还需要做点改进。需要改进的地方就是要杜绝近整数问题上的两种“作弊”方法。
一种作弊方法是对非常接近 的值进行三角函数运算。比如 是 的一个非常好的近似,则 、 自然会是好的近整数。如果再嵌套几重,就可以以非常小的复杂度代价获得非常好的近整数,比如:
我们需要排除这种情况。目前采取的手段是:如果一个表达式的形式是 ,且内部的值非常接近 ,则会将这个近整数视为 的形式。如果有嵌套,也会继续剥离外层,取核心。如此操作,足够使这种作弊手段实效。
另一种作弊情形就是皮索特数[3](Pisot Number)的幂次。皮索特数的定义是:大于1的实代数整数,且其所有共轭的绝对值均小于1。这种数的幂次天然具有越来越接近整数的效果。最为人熟知的一个皮索特数就是黄金分割比:,可以计算验证:
所以皮索特数也是一种以较低复杂度获取高精度近整数的“作弊”手段,排行榜上已完全排除这种数字类型。
综上所述,我最终选择的近整数质量度量方法是:
其中:
n是该近整数小数点后连续的0或9的数量,确切算法是:。 为与x最接近的整数。
complexity为按以上ries算法计算出的复杂度。
surplus的意思是“盈余”。因为 实际上决定了一个表达式平均可以接近整数的程度,那么 就是比平均情况多出的“盈余”。这个值越大,我们就认为这个近整数质量越高。
我让AI把市面上常见近整数按以上方法进行了一次质量排名,放在这个网站[4]上。前10名是:
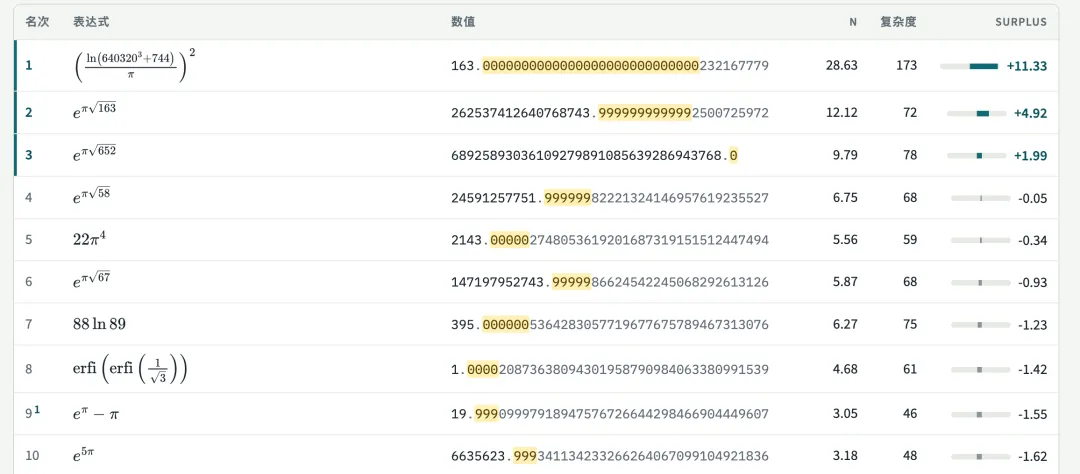
可以看到,这个排名结果与我个人的直觉是很接近的。其中 排在第二,但第一名其实就是第二名的变体,本质上是同一个。也可以看出,有时需要考虑相对精度和绝对精度的区别,但这样有点太复杂了,所以没有搞。
这次的研究带给我几个发现:
前4名的近整数都是 的形式,它们成为近整数是有数学原理[5]的,所以质量自然很高。而 是拉马努金发现的,其原理至今仍是个未解之谜。
用计算机暴力搜索出的近整数,一般来说surplus值在-5到-6之间。所以,如果你找到一个网站上没有的,且surplus值大于-4的近整数,欢迎你告诉我,我会更新到网站上。我的网站也提供了一个surplus计算器[6]。
之前我看到知乎知名作者王赟关于乱排常数[7](我更想叫它“插队常数”)的系列文章,其中提到了一个近整数:
我曾经很想找出这个数字成为近整数的原理,AI也好几次给出了让我感觉非常像那么回事的答案,但最终我都发现了其中不靠谱的地方。我对以上数字做了质量计算,其surplus值仅为-5.46,只是平均水平。现在我相信这个数字成为近整数只是巧合。
之前还有网友告诉我,其发现了一个近整数:
其surplus值为-3.44,已经算相当高了。但AI发现了其来历:
它的来源也能看出来:126e^π + 8π⁴ = 6·(21e^π + 5π⁴) − 22π⁴,也就是把族内第二名放大 6 倍再减去 Ramanujan 的 22π⁴ ≈ 2143,两个近似的误差恰好相消。这是一个 3 项整数关系搜索(PSLQ 类型)的典型产物,指标把它归入平凡结果是恰当的。
不过我觉得说它是平凡结果有点过了,那两个近似的误差能正好抵消,也是很难得的巧合。
以上就是我关于近整数质量的研究和排名,希望你喜欢,也希望你发给我一些新的高质量近整数!
参考资料
科普文章: 从无理数中算出整数--形形色色的“近整数”
[2]ries: https://mrob.com/pub/ries/
[3]皮索特数: https://mathworld.wolfram.com/PisotNumber.html
[4]网站: https://youhuali.github.io/almost_integer_rank/#/
[5]数学原理: https://mathworld.wolfram.com/RamanujanConstant.html
[6]计算器: https://youhuali.github.io/almost_integer_rank/#calc
[7]乱排常数: https://zhuanlan.zhihu.com/p/31547382
