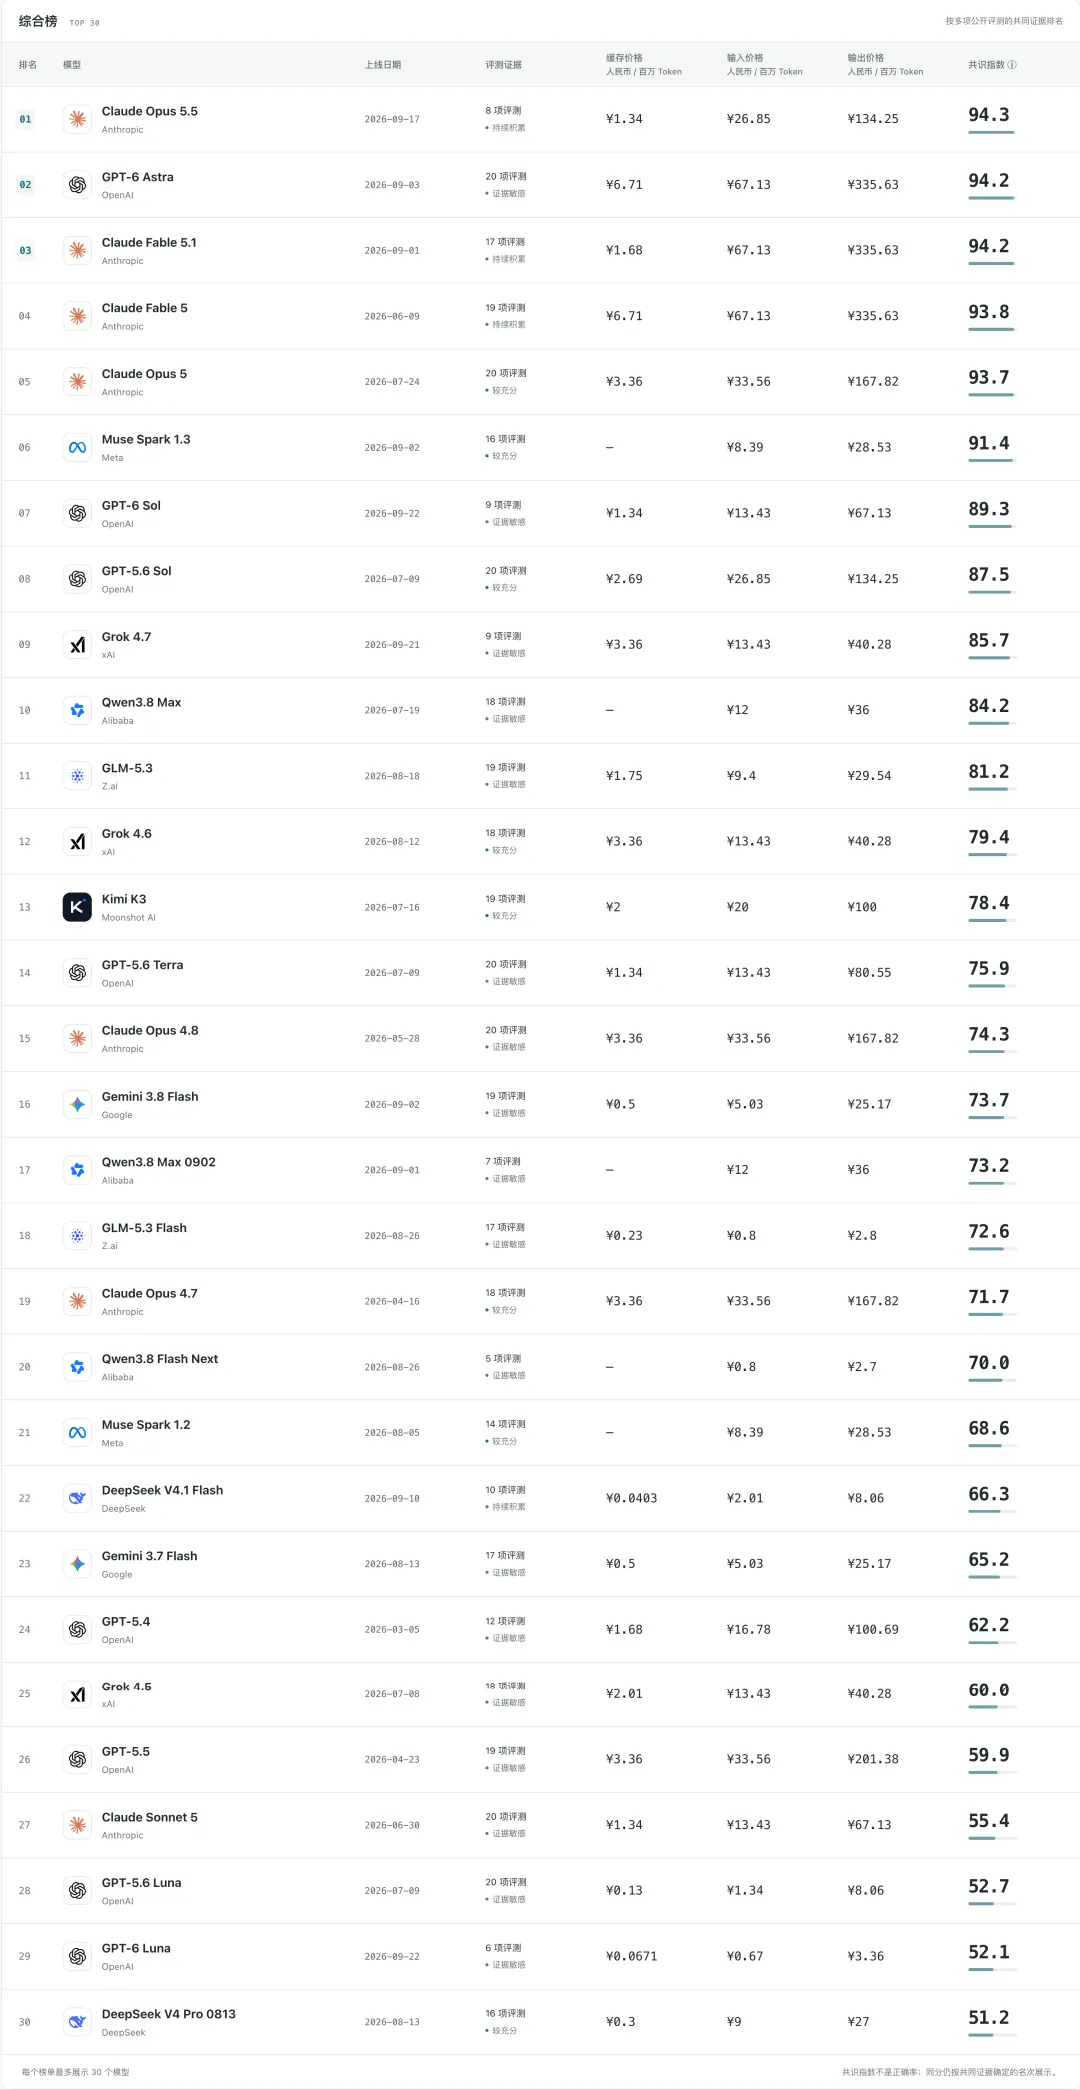
一张榜单,看懂当前全球AI模型竞争格局
过去一年,AI行业的发展速度依然超出很多人的预期。
从最开始的聊天、写作,到如今的代码开发、数据分析、图像处理,AI模型正在不断进入更多工作场景。
与此同时,市场上的选择也越来越多。
除了大家熟悉的 GPT、Claude、Gemini 等海外模型,国内的 DeepSeek、通义千问、智谱、豆包等国产大模型也在快速发展。
那么问题来了:
现在主流AI模型之间,到底是什么水平?
最近公布的一份AI模型综合能力排行榜,也让这个问题再次受到关注。
AI模型竞争,已经进入多模型时代
如果回顾过去几年,AI行业的发展路线其实非常明显。
早期:
用户更多关注:
“有没有一个足够强的AI?”
后来:
大家开始关注:
“哪个AI更适合我的工作?”
因为随着模型数量增加,大家发现:
不同模型之间,并不是简单的“谁完全替代谁”。
有些模型在逻辑推理方面表现突出;
有些模型在代码任务中效率更高;
有些模型更适合长文本分析;
有些模型则在中文理解和本土化应用方面更有优势。
AI竞争正在从单纯比参数,逐渐转向比实际使用体验。
GPT、Claude、Gemini依然是全球关注焦点
目前全球范围内,GPT、Claude、Gemini等模型依然是用户讨论最多的AI产品。
它们代表了不同的发展路线。
GPT:
长期积累了大量用户基础,在通用能力、生态和应用场景方面具有较强影响力。
Claude:
近年来受到很多专业用户关注,尤其是在长文本处理、复杂分析等任务中表现突出。
Gemini:
依托谷歌生态,在多模态能力和信息整合方面持续发展。
这些模型之间的竞争,也推动了整个行业快速进步。
国产大模型发展到了什么阶段?
过去很多人提到AI模型,第一反应可能是海外产品。
但近年来,国产大模型的发展速度非常快。
包括:
都在不断优化模型能力。
国产模型的发展方向,并不只是追求参数规模,而是在实际应用中寻找优势。
例如:
中文理解能力;
企业办公场景;
行业知识应用;
本地化服务;
成本控制。
对于大量国内用户来说,这些实际需求同样重要。
排名靠前,就一定适合所有人吗?
这是很多人在看排行榜时容易忽略的问题。
模型排名可以帮助我们了解整体趋势。
但实际选择时,还需要看自己的使用场景。
比如:
如果主要用于写作:
可能更关注语言表达和内容组织能力。
如果用于程序开发:
可能更关注代码理解和调试能力。
如果用于企业应用:
可能更关注稳定性、安全性和部署成本。
所以:
排行榜告诉我们模型的大致水平,但真正决定体验的是使用场景。
AI模型未来会如何竞争?
未来AI竞争可能不会只是简单比较:
“谁的分数最高”。
更多竞争可能集中在:
谁能够更好地解决真实问题。
例如:
企业希望AI帮助提升效率;
开发者希望AI辅助编程;
设计师希望AI提高创作速度;
普通用户希望AI成为日常助手。
模型能力只是基础。
真正重要的是,它能不能融入用户的工作和生活。
写在最后
最新AI模型排行榜,让我们看到一个明显趋势:
全球AI竞争正在持续加速。
GPT、Claude、Gemini等海外模型仍然保持较强影响力;
国产大模型也正在快速成长,并在不同应用场景中寻找自己的位置。
未来,AI模型之间的竞争还会继续。
排名会变化,产品会更新。
对于普通用户来说,比起关注每天谁排第一,更重要的是:
找到适合自己的AI工具,并真正把它用起来。
因为最终决定效率提升的,不只是模型本身。
而是人与AI结合的方式。