一句话讲清楚👉🏻 卡内基梅隆大学团队实测了判决式评测服务 JEV :它只回判定和概率、不写理由,在常规偏好比较和证据核验上跟最强对照 GPT-6 差不到 3 个百分点,费用只有对方的 0.36%;再按它自己报的置信度把没把握的样本转给 GPT-6 ,费用只剩原来的 47%、准确率保留 99.6%(这是事后挑阈值的口径;换成阈值事先冻结的稳健版本,费用是 56.8%、准确率只差 0.59 个百分点)。
论文标题:JEV-as-a-Judge: Accept When Confident, Escalate When Unsure
论文链接:https://arxiv.org/abs/2609.26550
服务文档:https://docs.typesafe.ai/api
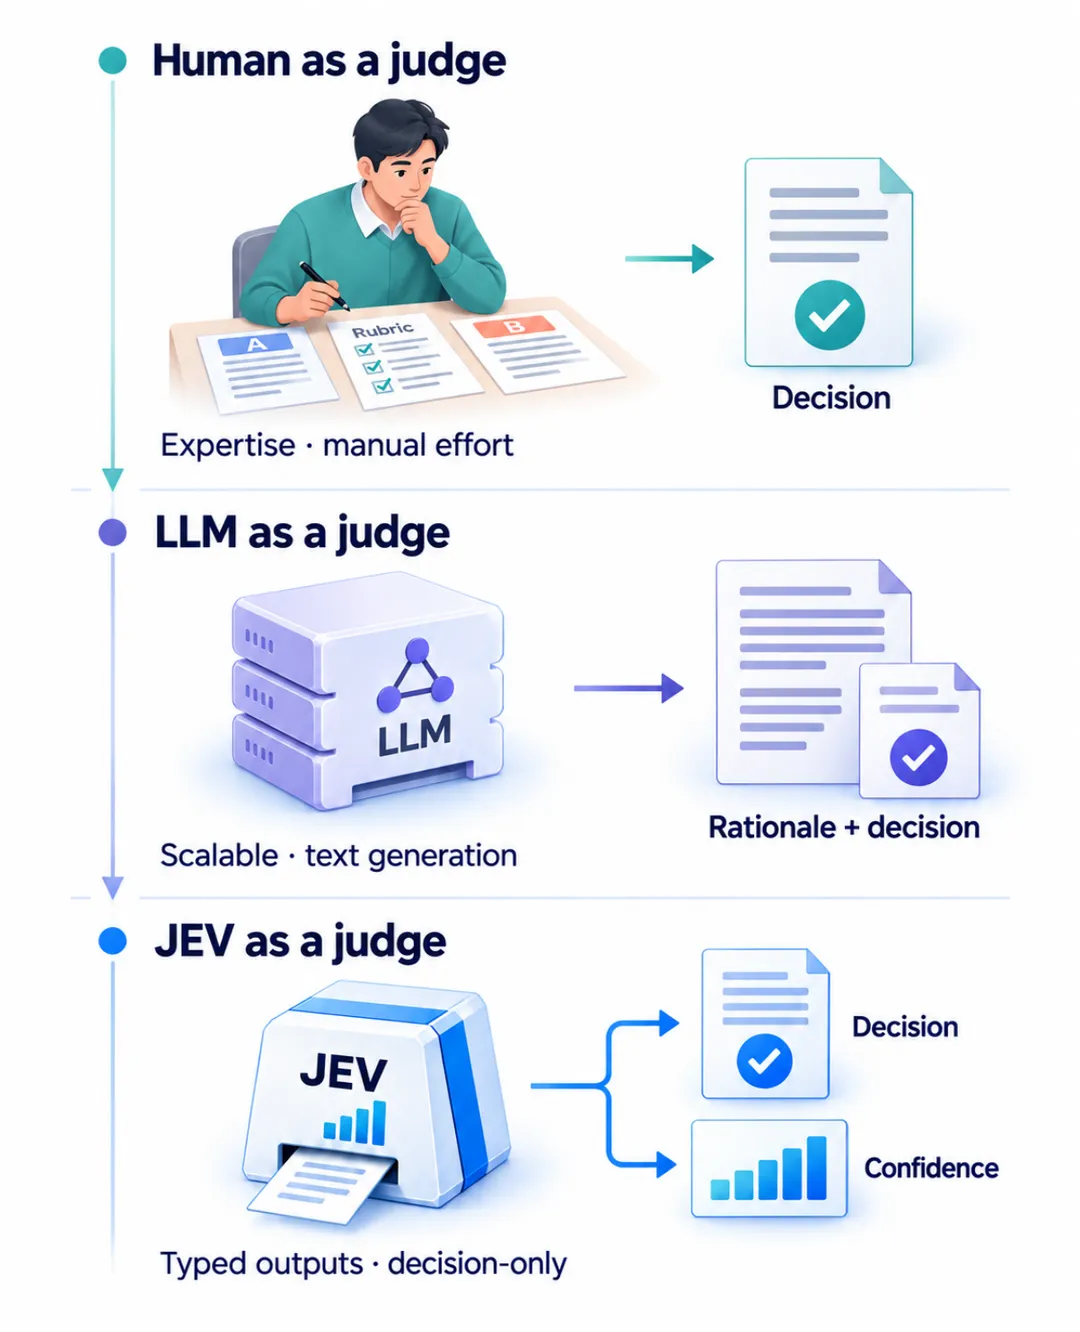
三种评测接口。人做评测依赖专业判断和人工投入;生成式 LLM 评测器输出一段理由再加结论; JEV 只暴露结构化的判定标签和标签概率,把概率汇总成置信度。生成式对照模型拿到的是同一份「结论加概率」输出契约,区别是它们的概率靠模型自己口头估计。
设想你负责一条标注或评测流水线:模型每迭代一版,手上那 5 万条回答就得重新判一遍。
用 GPT-6 判,一轮 609 美元。一个季度改三版, 1800 多美元。换成 JEV ,同样的条数只要 2.2 美元。
评测原本是一份免费裁判,一旦进到迭代循环里,就变成了一项固定支出。推理按 token 计费,链条越长越贵,同一批样本还会被反复判。作者举的例子是,判断一条几十字的回答该记对还是记错,模型可能先写出上千个 token 的推理过程。可简单样本上,多出来的计算经常换不来更准的结论。
JEV 是 TypeSafe AI 提供的一个闭源托管评测接口,费用按输入 token 算。它的取舍是砍掉理由、只留结论。它要求每次调用必须在三种预设的输出格式里挑一种返回: Choice 在候选标签集合上给每个标签一个概率, Noul 只给一个「是」的概率(是/否二分类), Score 在有序评分档上给概率。返回值里既有判定,也有完整的概率分布,最大标签概率可以直接当置信度用。
JEV 自己还返回一个厂商定义的置信度字段,作者把这一项搁在一边,改用最大标签概率 。理由是两者在三个数据集上的斯皮尔曼相关系数(衡量两组数值排序是否一致的指标, 1 表示完全一致)分别为 0.971 、 0.999 和 0.948 ,几乎同步,用哪个都不影响结论,而最大标签概率是读者自己就能算出来的。
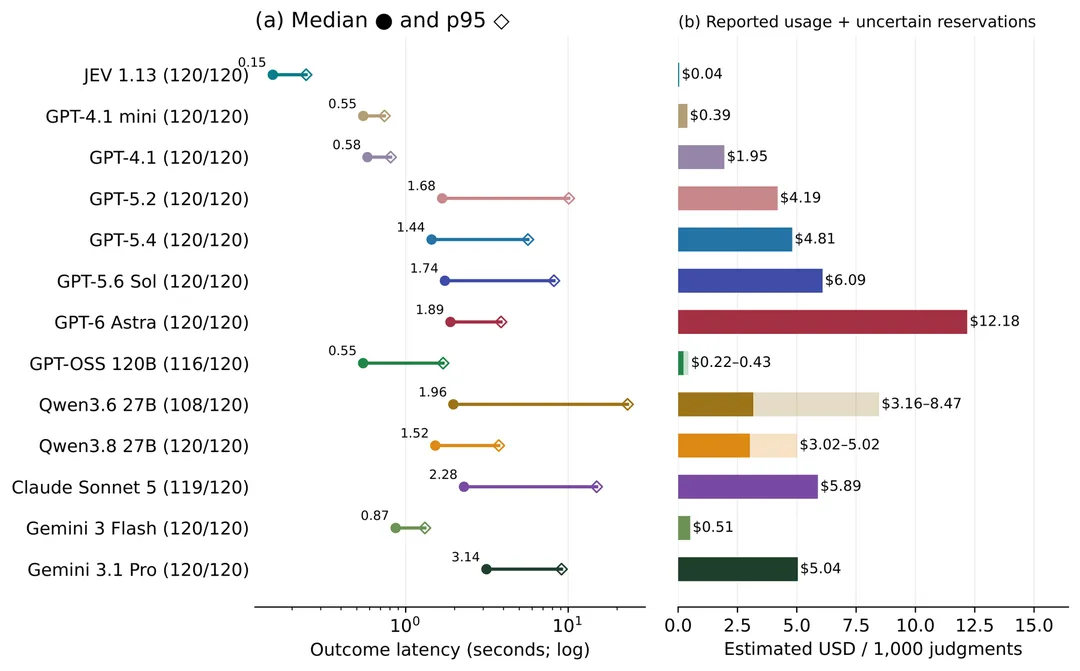
先看钱。论文把 13 个托管评测器的延迟和费用画在了同一页上。
同一批 120 条判断、 13 个托管评测器。左图是每次判断的端到端延迟,实心点为中位数、空心菱形为 p95 ;右图是费用估算,口径统一折算成「每判断 1000 次要花多少美元」,浅色段表示用量数据缺失时按保守值补上的部分。按这个口径, JEV 中位 0.152 秒、 0.044 美元, GPT-6 是 1.885 秒、 12.182 美元。
按这批数据, JEV 的收费是 GPT-6 的 1/277 、是 GPT-4.1 mini 的 1/9 ;中位延迟 0.152 秒,约为 GPT-6 ( 1.885 秒)的 1/12 、 GPT-4.1 mini ( 0.548 秒)的 1/3.6 。它的价格对应收集时的计费方式:每百万输入 token 收 0.042 美元,输出不计费。这里要留意测量的口径。延迟是端到端观测值,包含网络、供应商和重试时间,不等于纯粹的推理耗时; p95 指 5% 的判断比这个数更慢, 120 条的样本量也只够看中位数和 p95 两个位置,说明不了吞吐。
十七个评测器,一批先冻结的样本
任务分三类:生成文本的成对偏好比较、对着给定证据判断单条答案、以及对最终答案的裁定。三类需要的语义能力不同,一个类型化的输出接口本身不解决其中任何一类。
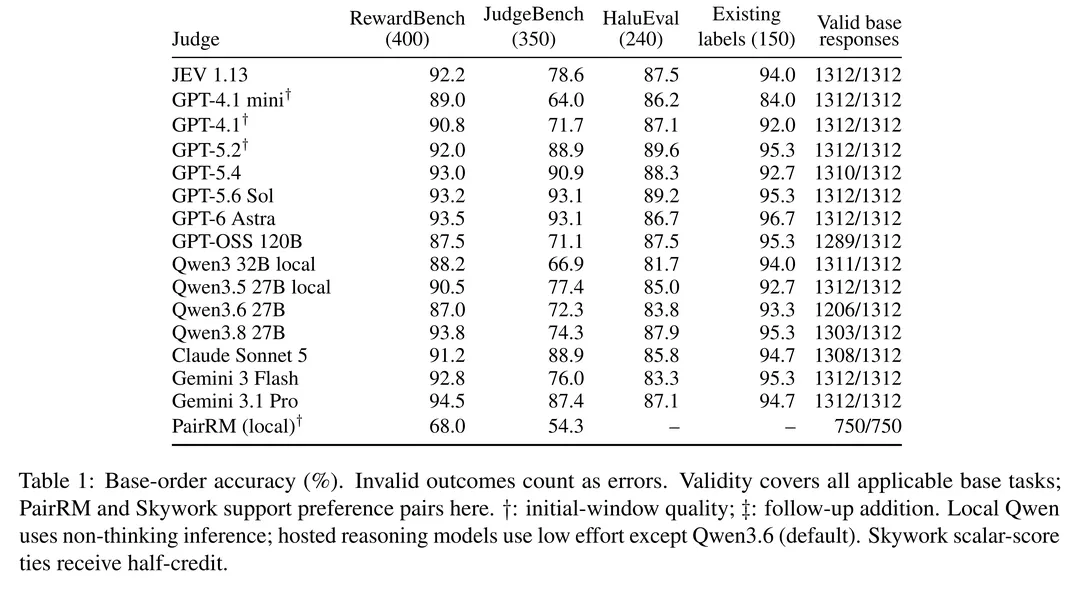
各评测器在四个任务上的基础准确率,无效输出计为错误。最后一列是合规输出条数: JEV 是 1312/1312 , PairRM 只评偏好对所以是 750/750 , GPT-5.4 ( 1310 )、 Claude Sonnet 5 ( 1308 )、 Qwen3.8 ( 1303 )等因为无效输出低于满分, Qwen3.6 最低,只有 1206/1312 。
样本来自三个公开基准加一个现成标注集,再加两组自建对照,共 1312 条判断。 RewardBench 出 400 对偏好比较, JudgeBench 出 GPT-4o 划分的 350 对(考客观正确性), HaluEval 出 240 条证据核验( 120 个问题,每个问题配一条参考答案和一条幻觉答案),另有 150 条带标注的多轮问答回复做最终承诺裁定。自建的两组是最基础能力的对照: 108 条 GSM8K 九轮对话的最终回复, 64 条合成证据判断。
数据划分做了一次隔离。 642 条的 pilot 在任何推理发生之前定死,其中公开任务按来源问题 40/60 拆成选择集和测试集:选择集( 96 对偏好样本)只用来拟合温度和分流阈值,测试集只用来打分。 670 条的 extension 在查看 pilot 准确率之前定死,完全不参与调参。合起来 1312 条,另有 894 条诊断项: 750 对全部反向重判,外加 48 个固定样本上的两次重复请求和一次改写评分细则的请求。
对照面铺得比较开,含 JEV 在内一共 17 种配置: 13 个托管模型( JEV 、 GPT-4.1 mini 、 GPT-4.1 、 GPT-5.2 、 GPT-5.4 、 GPT-5.6 Sol 、 GPT-6 Astra 、 Groq 上的 GPT-OSS 120B 、 Qwen3.6 27B 、 Qwen3.8 27B 、 Claude Sonnet 5 、 Gemini 3 Flash 、 Gemini 3.1 Pro )加 4 个本地模型( Qwen3 32B 、 Qwen3.5 27B 、 PairRM 、 Skywork-Reward-V2-Qwen3-8B )。最后两个是奖励模型:它们不写理由,任务就是把两份回答比出个高低,属于「判决式」思路的老前辈。
打分规则统一:输出要能对上字段和标签,概率非负、和落在 1 附近(容忍 0.025 的舍入误差),并且不许出现「概率最大的标签和它给出的结论不是一个」这种自相矛盾。任何一条不合规就整条算错,不修复、不重跑。另外 17 个配置里有 16 个是 JEV 的对照,摘要里说的「十六个评测器」指的就是这些。
后面出现的区间都来自同一套算法:把同一道来源问题下的条目整组重抽 2000 次,看差值怎么波动。整组重抽是为了不让一道题的正反两种问法被当成两个独立样本,否则区间会被算窄。
常规任务:差不到 3 个百分点
尺子先立好:下面所有「配对差」都是 JEV 减对照评测器,负数表示 JEV 更低,单位是百分点;方括号是 95% 集群区间,跨过 0 就意味着这个差距在统计上说不清。
在 RewardBench 上 JEV 是 92.2%, GPT-6 是 93.5%,配对差 −1.25 个百分点,区间 [−3.8, 1.5]; HaluEval 上 87.5% 对 86.7%,差 +0.83 个百分点,区间 [−1.25, 2.92]。这前两处的区间都跨过 0 。第三处是 150 条既有标注上的 94.0% 对 96.7%,样本量更小,论文没有给配对差和区间。
基准标签并不总是最终判据,团队让一名成员在不看标签、也不看两个评测器输赢的情况下,对所有判定不一致的条目做盲评。人类裁决差的口径是「净胜条数 ÷ 该任务总条数」: RewardBench 的 29 条分歧里, 17 条判给 GPT-6 、 5 条判给 JEV , 7 条无法裁决,净胜 12 条摊到 400 条上就是 −3.0 个百分点([−5.3, −0.8]); HaluEval 的 10 条分歧里 8 条判给 GPT-6 、 2 条判给 JEV ,净胜 6 条摊到 240 条上是 −2.5 个百分点([−5.0, −0.4])。盲评对 JEV 比标签更不利,但幅度仍然落在三个百分点以内。
另一个细节解释了 HaluEval 上的接近:两个评测器都判错的 26 条里,有 24 条的基准标签本身与证据不符。按盲评结果替换这批标签后, JEV 是 95.8%, GPT-6 是 98.3%。这项对比已经贴着天花板,标签噪声占了不小比重。
总分打平,拆到子领域就露馅了。
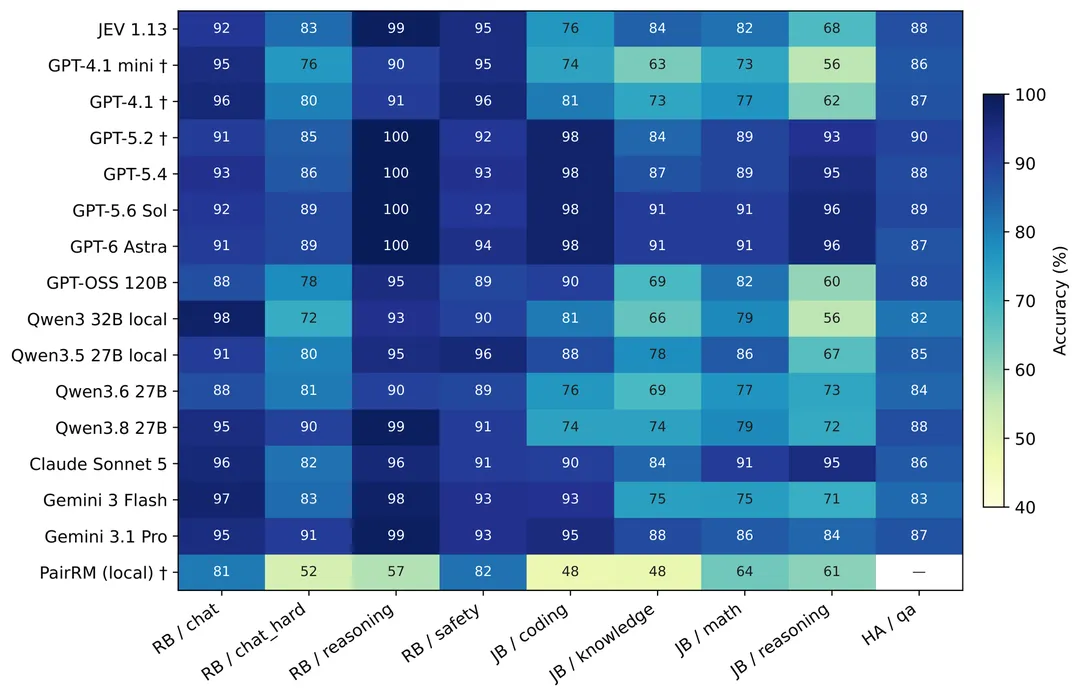
按子领域拆分的基础准确率热力图,颜色越深越好,深蓝接近 100 、浅黄接近 40 。 RB 是 RewardBench 、 JB 是 JudgeBench 、 HA 是 HaluEval 。 JEV 在 RB/chat ( 92 )和 RB/reasoning ( 99 )与最强的几个模型同档; JB/coding 是 76 对 98 , JB/reasoning 是 68 对 95 到 96 ,两处拉开最大。
困难任务:差距 9 到 20 个百分点
JudgeBench 把评测器分成了两拨。 JEV 78.6%, GPT-5.6 和 GPT-6 都是 93.1%,配对差 −14.6 个百分点([−18.9, −10.3])。差距最宽的是推理( 68.4% 对 95.9%, 98 条)和代码( 76.2% 对 97.6%, 42 条),最窄的是知识( 84.4% 对 90.9%, 154 条)。这一次不能归给标签: 69 条分歧里盲评判给 GPT-6 的有 57 条、判给 JEV 的 1 条、 11 条无法裁决,净胜 56 条摊到 350 条上是 −16.0 个百分点([−20.0, −12.3])。三个子领域的胜负也很干脆:推理 27 条判给 GPT-6 、 0 条判给 JEV ,代码 9 比 0 ,数学 7 比 0 。
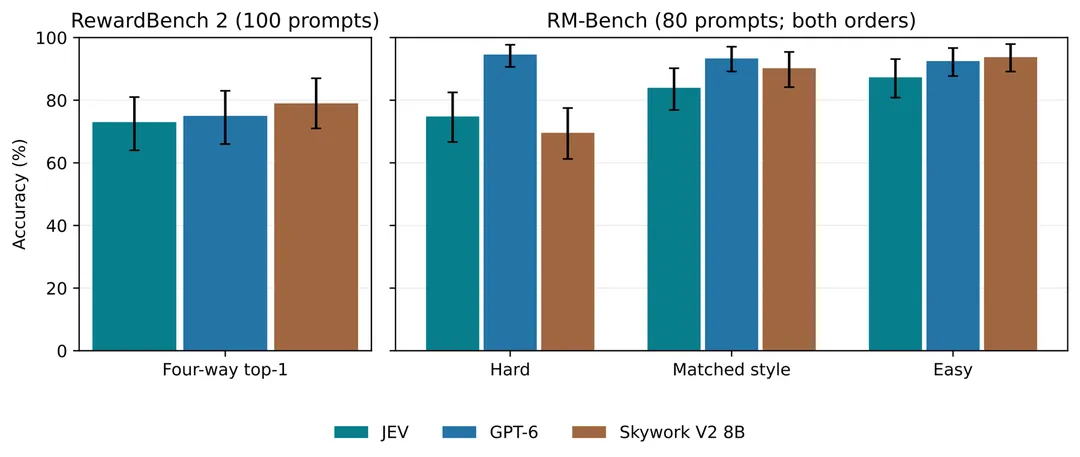
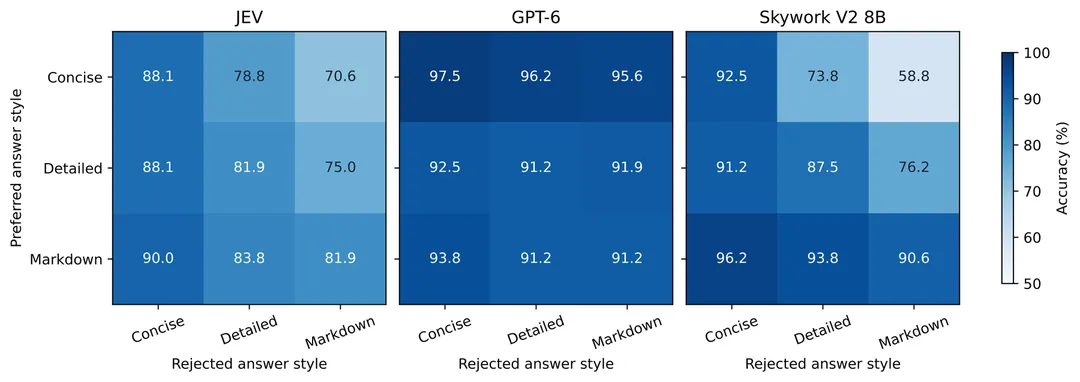
偏好对上的困难来自另一个方向。 RM-Bench 把两份答案的风格配对控制住,三种条件分别是难对、同风格对和易对:难对指被拒的那条答案写得更详细,同风格对指两条风格一致,易对指应选的那条更详细。 JEV 在难对上只有 74.8%,同风格对 84.0%,易对 87.3%; GPT-6 分别是 94.6%、 93.3%、 92.5%,三种条件下几乎不动。与 GPT-6 的差距因此从易对的 −5.2 个百分点,扩大到同风格对的 −9.4 ([−16.7, −2.9])和难对的 −19.8 ([−27.7, −12.7])。
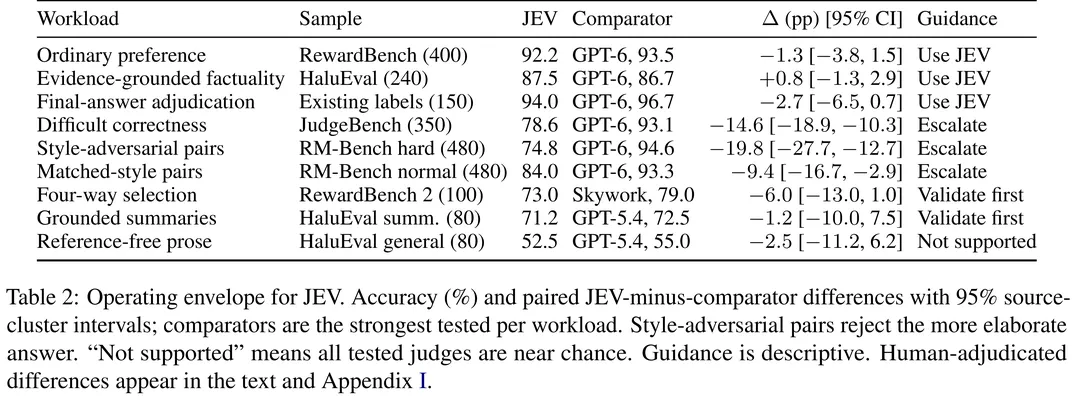
论文给出的工作负载清单,每一行是 JEV 与该项最强对照评测器的配对差和 95% 集群区间,最后一列是作者给出的使用建议。「不推荐」指的是被测评测器全部贴近随机猜测。
这张表是全文最实用的一页。常规偏好、证据核验、最终答案裁定三类活, JEV 与最强评测器的差距都在 3 个百分点以内,可以放心当第一道筛子。涉及多步推导( JudgeBench −14.6 )和风格对抗( RM-Bench 难对 −19.8 )时应升级到强模型。四选一和带参考的摘要属于要先本地验证的类型。不给参考的自然散文,所有被测评测器都做不到。
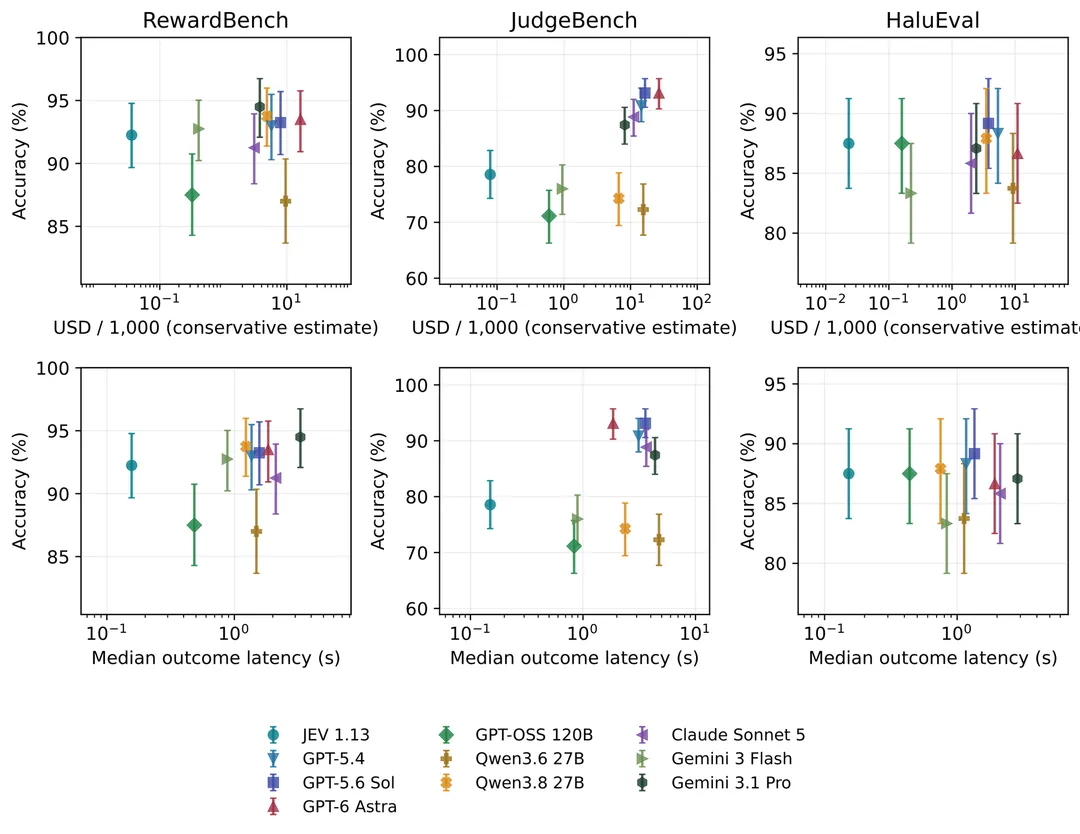
把价格线卡在每 1000 次 1 美元以下,同一档里能打的托管评测器只剩几个: GPT-4.1 mini 是 0.39 美元、 JudgeBench 64.0%, GPT-OSS 120B 在 0.22 到 0.43 美元之间、 71.1%, Gemini 3 Flash 0.51 美元、 76.0%。 JEV 用 0.044 美元拿到 78.6%,在这个价位上找不到对手。往上一档是 GPT-5.6 和 GPT-6 , JudgeBench 能到 93.1%,代价变成每 1000 次 6 到 12 美元。也就是说,多出来的 14 个百分点的标价是每 1000 条六美元往上,值不值取决于判错会造成什么:用于数据去重或粗筛,不值得;用于决定一条推理轨迹要不要进训练集,就得先算清噪声的代价。
还有一句要配着区间读。「差不到 3 个百分点」的配对标区间是 RewardBench [−3.8, 1.5]、 HaluEval [−1.25, 2.92],而 400 条和 240 条的样本量能分辨的最小差异本来就在两三个百分点附近。这个结论既描述了 JEV 的位置,也描述了这批实验的分辨率;想按 1 个百分点的尺度比较两个评测器,得自己补样本。
换一张图,横轴改成费用,整片战场的样子立刻不一样。
横轴是费用(上排)和中位延迟(下排,均为对数刻度),纵轴是准确率,误差条是来源集群区间,三列对应三个公开任务。 JEV 在 RewardBench 和 HaluEval 上落在最优性价比的角落,在 JudgeBench 上被 GPT-5.x/6 整片压在右上方。
两个更难的补充样本
四选一的 RewardBench 2 上, JEV 73.0%, Skywork-Reward-V2 79.0%,差 −6.0 个百分点([−13.0, 1.0]), GPT-6 是 75.0%。样本只有 100 条,区间很宽,作者把它归到「先本地验证」。
JEV 、 GPT-6 和现代奖励模型 Skywork-Reward-V2 在同一个冻结样本上的对比。左图是 RewardBench 2 的四选一,右图是 RM-Bench 的三种风格条件:难对(被拒答案写得更详细)、同风格对、易对。
把风格这一维拆到格子级别,模式就更明显了。
RM-Bench 九种风格组合的准确率。行是应被选中的答案风格,列是被拒答案的风格,每格平均 80 个来源问题在正反两个顺序上的 160 次判断。 JEV 最差的一格是「应选简洁、被拒详细 Markdown 」的 70.6%, GPT-6 在同一格是 95.6%, Skywork 掉到 58.8%。
沿着列看能看出问题的性质:同一行里,被拒答案写得越详细, JEV 的准确率越低。它「应选 Markdown 、被拒简洁」时是 90.0%,换成「应选简洁、被拒详细 Markdown 」就只剩 70.6%, GPT-6 在最难的那一格仍有 95.6%。作者对此的判断是,挑出正确的答案和抵抗一个写得漂亮的错误答案是两种不同的能力;这种能力和推理链长度是否直接相关,论文没有拆开验证。
置信度到底准不准
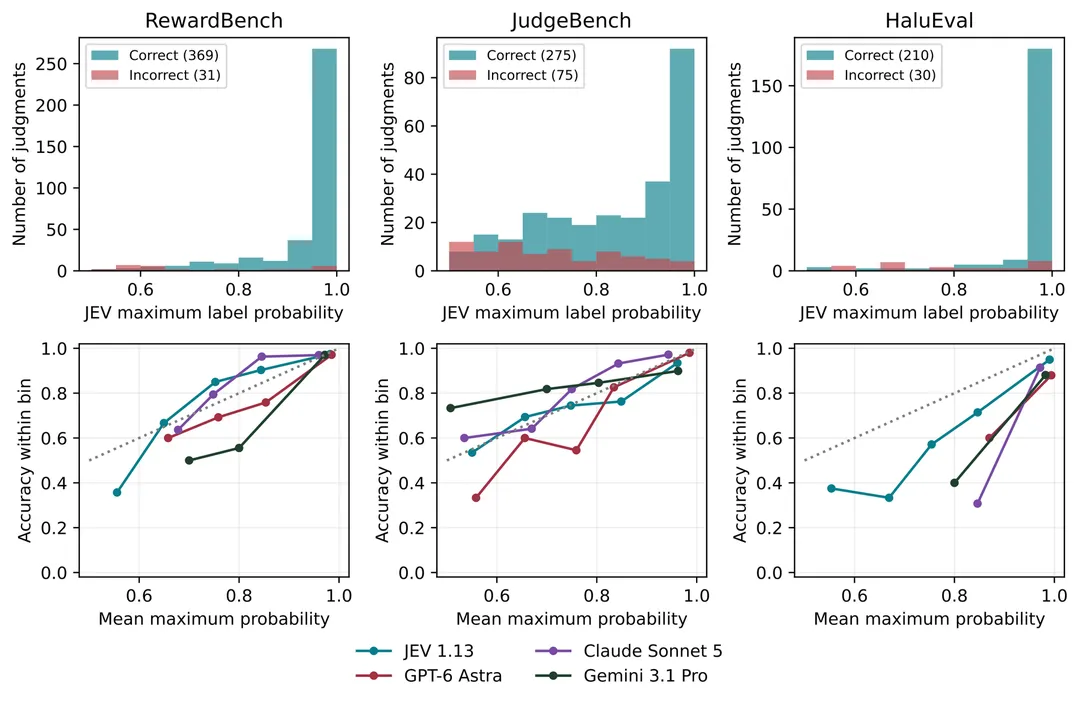
分流能不能用,取决于置信度是否真的能排序错误。这一步要回答两个问题:错的那批条目,概率分布长什么样;概率和实际正确率对不对得上。
上排是 JEV 最大标签概率的分布,蓝色为判对的条目、红色为判错的条目;下排是同一统计量下的可靠性曲线,虚线是理想对角线。三个任务里错误条目都集中在高概率一侧, JudgeBench 上的重叠最严重。
数字上有两面。先看校准,它问的是「说自己有把握的时候是不是真有把握」。校准用 Brier 分数衡量,把每条判断的置信度和它的对错一起算误差,越低越好: JEV 在 RewardBench 、 JudgeBench 、 HaluEval 上分别是 0.111 、 0.297 、 0.176 , GPT-6 是 0.104 、 0.095 、 0.245 。在困难的成对比较上 GPT-6 又准又校准,但在证据核验的不确定性上 JEV 的概率更好。
再看错误排序能力,它问的是「能不能把错的那条挑出来」。这一项用错误检出的 AUROC :随机取一条判错的、一条判对的,看 $1-q$ 有多大概率把错的那条排在前面, 0.5 等于瞎猜。 GPT-6 在这里全面领先( 0.891 、 0.907 、 0.899 对 0.869 、 0.745 、 0.863 )。同一个模型在 HaluEval 上错误排得更好、 Brier 分数却更差,两个指标会给出不同的先后顺序,单独看哪一个都会误导。
温度缩放这个常用手段在这里并不通用。它做的事是给概率做一次统一的拉伸,把过于自信的压低、过于保守的抬高。在 pilot 选择集上拟合出的拉伸系数,拿到 extension 上: HaluEval 的负对数似然(衡量模型给正确答案分配了多少概率,越低越好)从 0.333 降到 0.284 , JudgeBench 从 0.449 升到 0.475 , RewardBench 从 0.205 升到 0.232 。三个任务连拉伸方向都相反, RewardBench 要 0.65 (把概率往两头推),另两个要 2.15 和 4.45 (往中间压)。同一个系数不能在任务之间复用,照着别的任务搬只会把原本校准得不错的概率改坏。
按置信度分流
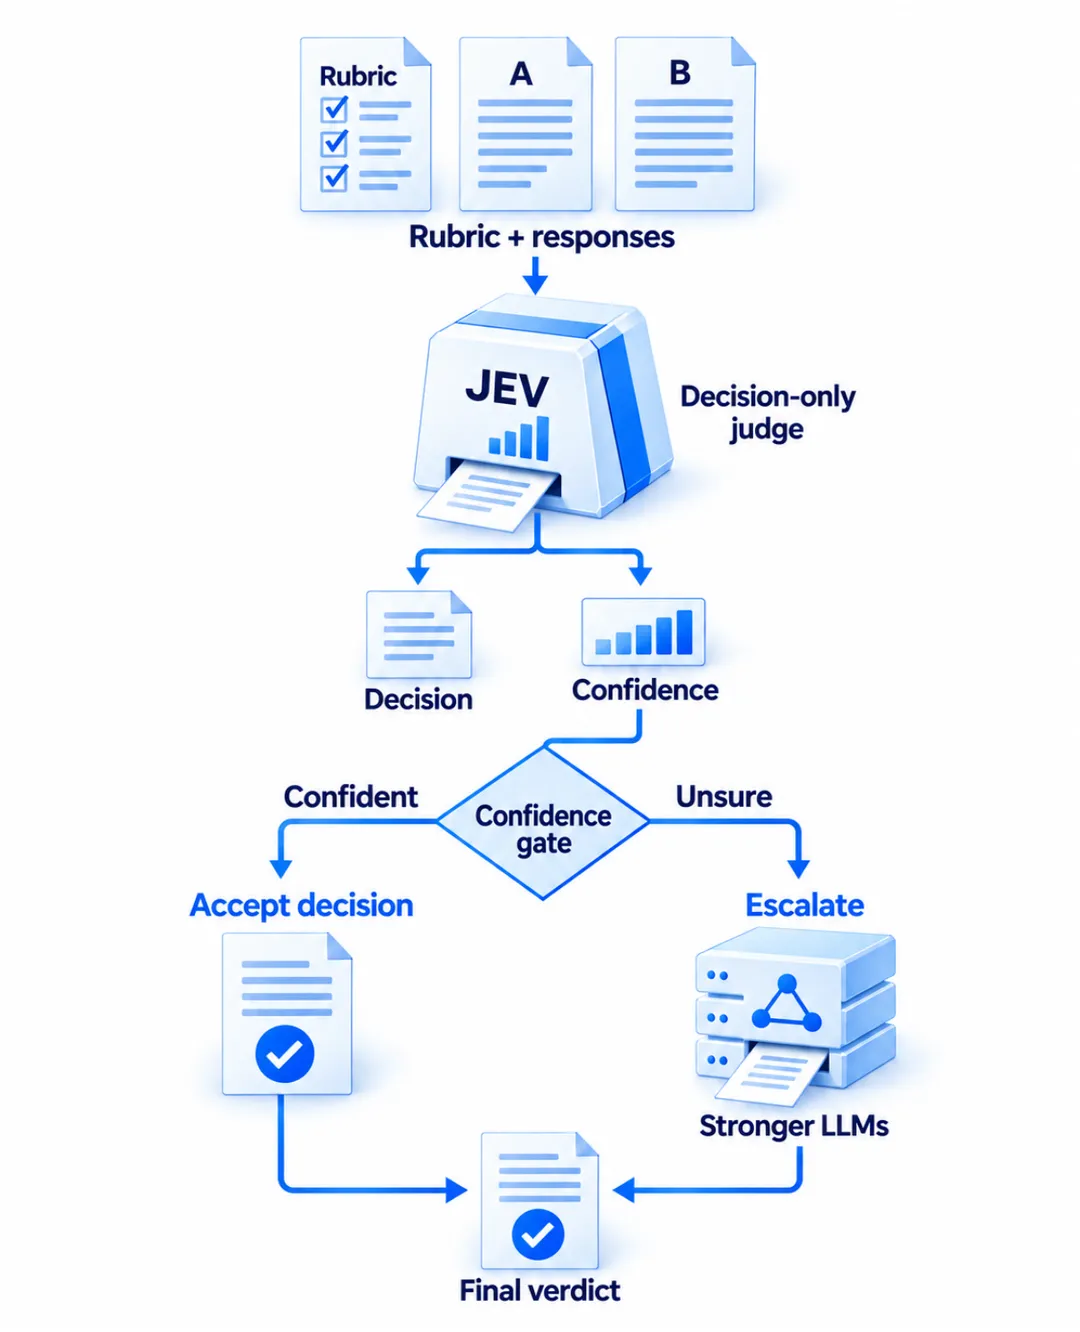
这篇工作的主线在下面这张图里:判定交给便宜的第一级,置信度决定要不要再问一次贵的那一级。
判决式评测器的分流结构。 JEV 给出判定和置信度,置信度过闸的判定直接采纳,没过的转给更强的模型,最终结论以后者为准。成对判断时,两个候选顺序下的概率会先换算到同一个语义候选再平均,阈值按工作负载单独验证。
成对判断还要处理顺序问题:同一个问题换个顺序问,答案可能不同。作者把两份候选都问一遍,把第二序的概率翻过来再平均:
读法:第一次问得到「 A 更好」的概率,第二次问把「 B 更好」的概率翻过来(用 1 减去它),两个数各占一半。这样做的代价是成对判断的钱要花两份,好处是位置偏差被对冲掉一部分。
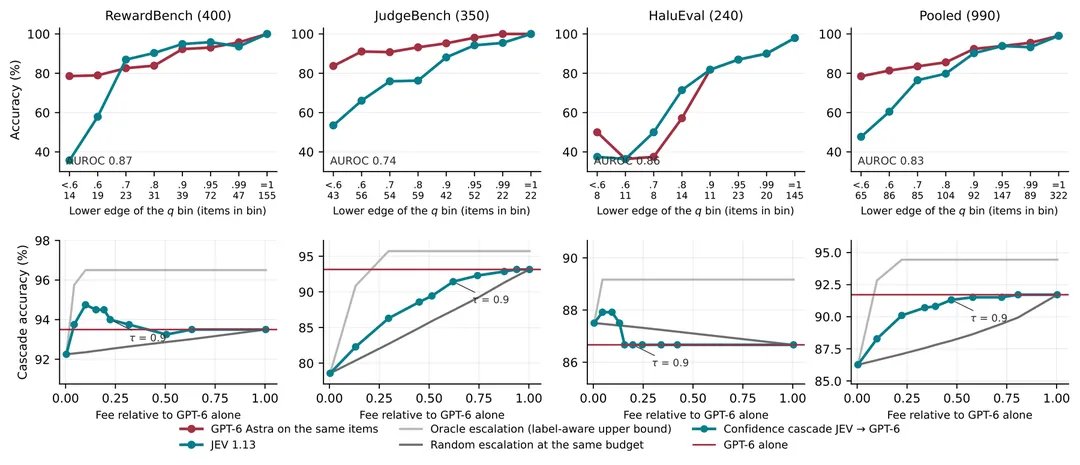
上排是 JEV 和 GPT-6 在同样条目上的准确率,按 JEV 置信度分箱,横轴下方是每箱的条目数;下排是单序级联:置信度到阈值就采纳 JEV ,否则去问 GPT-6 。横轴是相对 GPT-6 单独运行的费用,灰线是同一预算下随机挑样本升级的期望,浅灰阶梯是升级上界。
这里说的 990 条是三个公开任务的条目( 400 + 350 + 240 ),不含那两组自建对照。
JEV 报的把握基本可信。它最有把握的那 322 条()里, 99.1% 确实判对了;它最没把握的 65 条()只对了 47.7%,差不多等于抛硬币。中间几档平稳往上爬: 85 条落在 [0.7, 0.8),准确率 76.5%; 147 条落在 [0.95, 0.99), 93.9%。其余档位见图。
换成同一套分箱看 GPT-6 ,在 JEV 最没把握的那一箱它只有 78.5%,到 JEV 最有把握的那一箱升到 99.1%,前后只涨 20 个百分点。它的优势恰好落在 JEV 没把握的地方。分界线大致在 0.9 : 的条目两者几乎可以互换( 95.8% 对 96.5%,按盲评修正的标签是 97.2% 对 98.5%); 才是需要升级的那部分, GPT-6 在这些条目上领先 15 个百分点( 67.9% 对 82.6%)。
浅灰那条阶梯是假想上界:假设能提前知道每条的正确答案,专挑 JEV 判错的那些去升级,最好能到 94.4%。现实里做不到,但可以拿它衡量 这个信号到底值多少。
单序仿真里,阈值取 0.9 时升级 34% 的条目,总分 91.3% 对 GPT-6 的 91.7%,保住 99.6% 的准确率,费用是 GPT-6 的 47%。按同一批 990 条样本的口径,这约合每 1000 次判断 6.3 美元。这 34% 的挑选是有用的。同样升级三分之一,随机挑只能到 88.1%,按 挑能到 91.3%;而 94.4% 是预先知道答案、专挑错题升级才够得着的上界。 等于把 88.1% 到 94.4% 之间的收益走掉了一半。分任务看, RewardBench 上级联反而超过 GPT-6 单独运行( 94.0% 对 93.5%),费用只有 22%,原因是两者的错误分布不重合。
不过单序仿真的阈值是事后读出来的——它在打分用的那批条目上挑、又在这批条目上算分。更接近部署情形的检验,是作者预先冻结阈值的那组双序策略。
真正的考场在这 510 对偏好样本上,它们是 extension 里全部偏好对,阈值事先冻死、没有事后挑选的余地。阈值取 0.9 时, GPT-6 级联接受 53.7% 的对,准确率 92.5% 对 93.1%,配对差 −0.59 个百分点([−1.78, 0.59]),费用降到「全部交给 GPT-6 单独跑」的 56.8%(保守上界 62.2%)。迁移并不总是成功:换成 GPT-5.6 做后备、阈值 0.7 时接受 81.0% 的对,却掉了 2.35 个百分点,超出事先定好的「不超过 2 个百分点」这条线。阈值压到 0.5 时, GPT-5.4 、 GPT-5.6 、 GPT-6 这三个后备方案几乎没有条目会落在线下,也就没有任何一条会被升级,此时 JEV 只是把同一对候选正反各问一次取平均,后备模型完全没上场。
顺手算一笔账。级联花掉 GPT-6 的 47%、约合每 1000 次 6.3 美元,倒推回去, GPT-6 在这批 990 条样本上的单价是每 1000 次 13.4 美元左右,和前面 120 条体检图测到的 12.18 美元是同一量级。两批样本互不重叠、分开计算,却给出接近的单价,这至少说明费用那条线没有算错。
误差互补是这套设计的根据:两个评测器错的地方不一样,升级才有收益。
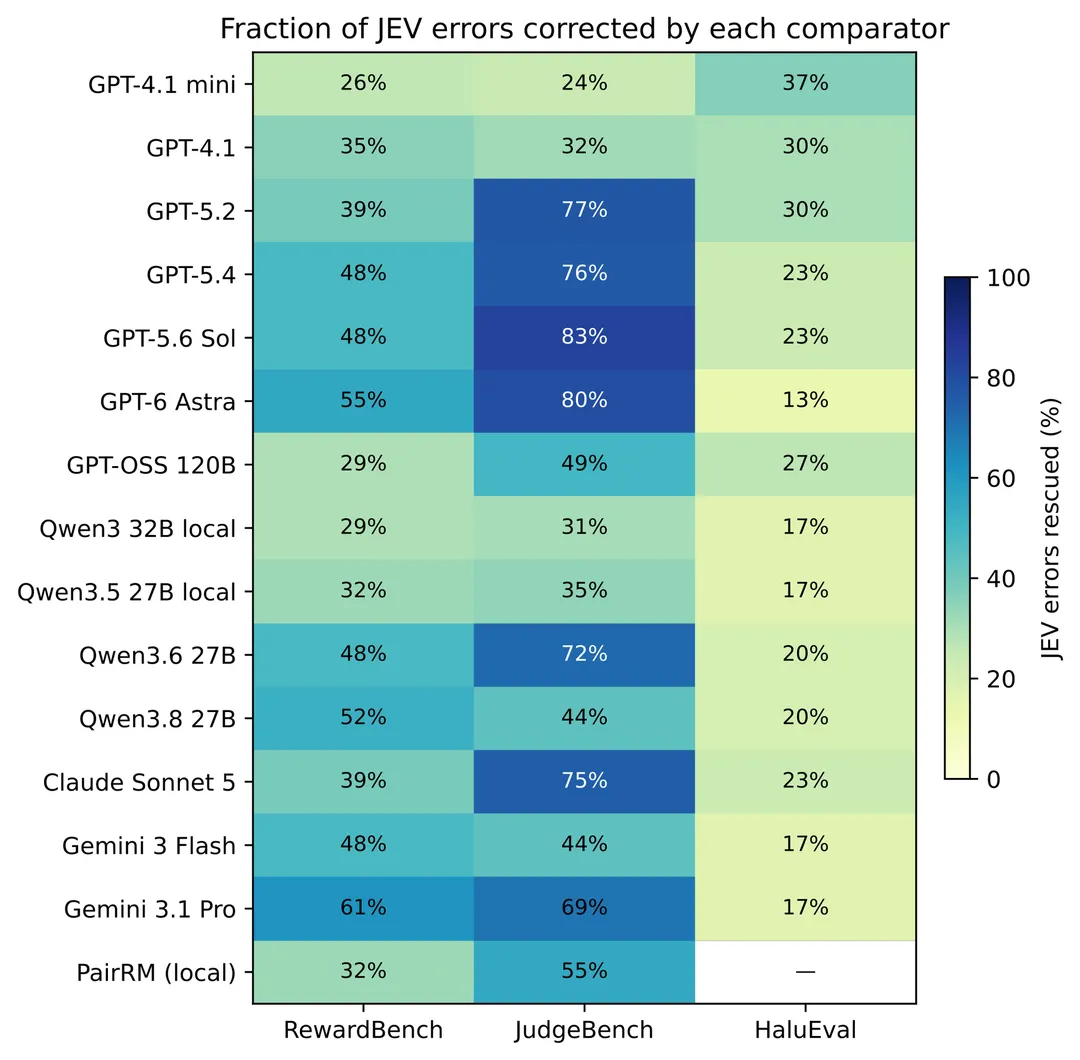
各对照评测器能纠正多少 JEV 的错误(用标签算出来的上界)。 GPT-6 能纠正 JEV 在 JudgeBench 上 75 个错误中的 60 个( 80%)、 RewardBench 上的 55%,但在 HaluEval 上只有 13%;两边都判错的条目往上顶,并集在 JudgeBench 上能到 95.7%, HaluEval 上则被标签噪声压住。
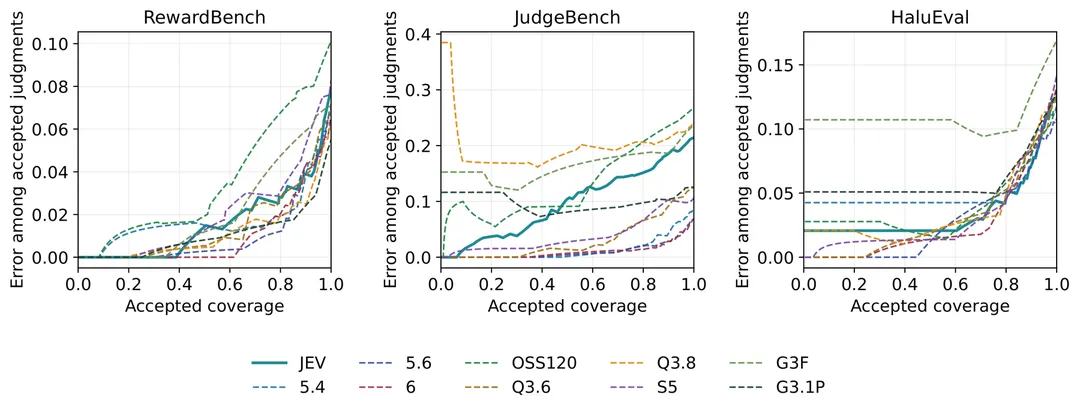
风险与覆盖率的关系是分流策略的另一面。
允许模型「不确定就不判」会发生什么。用最大标签概率当门槛,低于门槛的样本不采纳,横轴是最终采纳的比例,纵轴是采纳部分里的错误率。每个子图里都画了十来个评测器, JEV 那条曲线在每个任务上都是单调的:只采纳一半样本,错误率大致降到原来的三分之一到一半。 JudgeBench 整体准确率最低,整条曲线都在上方。
边界:没参考就不能评自然散文
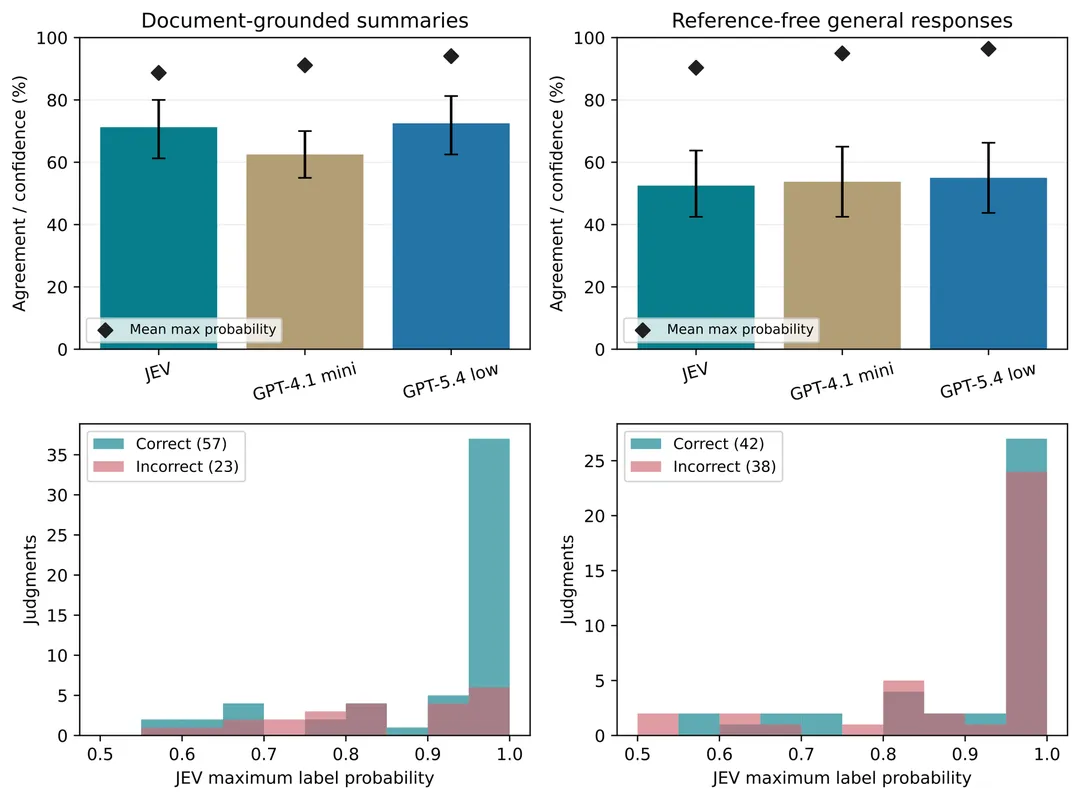
作者专门做了一组自然语言的实验,两组样本各 80 条:一组是根据文档写摘要(有依据),另一组是没有参考的一般回答。
上排是三个评测器在两批样本上的判定一致率(柱)和平均最大概率(菱形,无参考那一批),下排是 JEV 的置信度分布。有文档依据时 JEV 是 71.2%,没有参考时掉到 52.5%。没有参考那一批里,三个评测器的平均最大概率都在 0.90 以上,而被判错的条目仍然堆在 0.95 到 1.0 那一格。
这组数字说明了分流信号的失效条件。先说判不准:无参考的一般回答上, JEV 只有 52.5%, GPT-4.1 mini 53.8%、 GPT-5.4 55.0%,三家全都在随机猜的水平。
再说很自信:同一批样本上,三家的平均最大概率分别是 0.90 、 0.95 、 0.96 。 JEV 在这批新样本上的 Brier 分数升到 0.815 (不能和前面三个任务的 0.111 到 0.297 直接比),错误检出 AUROC 只有 0.518 。判不准、又很自信,这正是分流最怕的组合。
同一个信号在 RM-Bench 难对上也变弱。 和正确性之间的 AUROC 从易对的 0.918 、同风格对的 0.902 掉到 0.770 。在难对上, JEV 给自己 [0.9, 0.95) 的条目里有三分之一判错,[0.95, 0.99) 里有 15% 判错;阈值 0.9 的级联只能保住 GPT-6 96.5% 的准确率( 90.8% 对 94.2%),要回到 98.7% 就得把阈值提到 0.95 ,代价是升级 58% 的对。
低置信度上的错还有救,闸门会把它送上去升级。麻烦的是高置信度上的错:判定会被直接采纳,升级机制根本不会启动。这条边界适用于任何自动评测器,触发条件也很具体:样本需要外部依据,或者错误答案被写得更像正确答案。
稳定性与接口细节
几个容易被忽略的工程数字。难样本上一对候选换个顺序问,十次里有一次结论会变,所以单次调用的概率不适合直接当门槛,正反各问一遍再平均才算稳。
把 39 个不一致的 JudgeBench 对摊开看: 14 个总是选前者、 25 个总是选后者,两个方向都有,所以它并没有偏向某个位置。这是顺序造成的判定变化,和前面盲评时统计的分歧条数不是同一个口径。
重复请求则几乎没有抖动: 48 个样本上 96 次重复判定,一次都没变,把评分细则改写一遍, 48 次里有 4 次改了结论。同一份判断用不同接口问,概率并不完全一致:在 48 个样本的比对里, Choice 与 Noul 的平均差是 0.055 , Noul 的补概率残差平均 0.045 ,硬标签有 1 例不同。
最后是格式的口径。答案格式带来的差异有限:同一批 40 道题上, JEV 从选择题的 100.0% 掉到自由作答的 92.5%(−7.5 个百分点),远小于工作负载之间的差距。换成「先抽出模型的最终选项、再和参考答案比较」这条路径,一致率从 91.3% 掉到 86.0%(−5.3 个百分点),抽选项还会带来更多模糊输出,没有换来一致率的提升。
它在同类工作里的位置
靠便宜模型打头阵、把难样本转给贵模型,思路本身不新。区别在于每家解决的是哪一段路。
FrugalGPT 做的是生成成本的级联,用打分函数决定要不要换更大的模型接着回答; RouteLLM 干脆把路由当成可学习的模块,从人类偏好数据里训出一条规则,输入是问题、输出是选谁。这两项的省钱对象都是「生成」。最接近本文的两项则落在评测上: Jung 等人给级联评测器加了一致性保证, Xu 等人把奖励模型没把握的比较转给强 LLM 评测器,方向都是「什么时候该转」,而且同样是从数据里学。
这篇论文走的是最朴素的一条路:不训路由模型,只有一个固定阈值加一张实测账单。这带来两个可验证的差别。
好处是成本可控、可预算。阈值一定,升级比例就落在一个区间里,财务上能提前算清楚,这对量大、重复、预算敏感的流水线很重要。代价是它不随工作负载自适应:同一套阈值挪到 RM-Bench 难对上就得升级 58% 的对才能保命,所以作者反复强调阈值必须在本地选择集上重挑。
它还补了一个同类工作常跳过的前提。别人问的是「级联能不能做得更准」,本文先问「便宜那一级的置信度能不能真的把错误排到前面」。在无参考自然散文那种 AUROC 只有 0.518 的情形下,再精巧的路由规则也没有可用信号。这属于可用性前提:机制能不能用起来,先于它能给出多强的承诺。
这套实测里有一个别的路由工作少见的细节:成对判断按正反两个顺序各问一遍、把概率换算到同一候选后再平均。作者自己测出的顺序反转率是 RewardBench 3.25%、 JudgeBench 11.14%,也就是说在难样本上,一次调用的概率会被位置效应污染,直接拿来当门槛并不稳妥。
结论
这份工作把「便宜的够不够用」拆成了三个能用数字回答的问题:判定对不对、置信度能不能排序错误、升级之后省下多少钱。答案在前面那张工作负载清单里已经写清,落地时值得记住的是分界线——常规偏好比较、带证据的事实核验、多选题和数值题的最终答案裁定,交给 JEV 就够;涉及多步推导和风格对抗时差距从 9 个百分点拉到 20 个百分点,这部分钱省不下来;没有参考的自然散文,目前没有哪个被测评测器能做,这不是 JEV 单独的短板。
作者列出的清单里,两条对做评测流水线的人最有用。第一条是成对判断正反各问一次,把两个顺序换算到同一候选之后再取平均。第二条是升级阈值要在本地选择集上挑、再到留出的样本上复核。第二条有硬证据: GPT-5.6 那条策略在阈值 0.7 时接受 81% 的条目,却掉了 2.35 个百分点,说明阈值不能跨后备模型照搬。
执行第二条的成本也不高。作者自己挑阈值只用了 96 对带标注的偏好样本,其中 64 对来自 RewardBench 、 32 对来自 JudgeBench 。落到自己的场景,先抽几百条业务样本标一遍,看 能不能把错误排到前面、再定阈值,一两天就能给出第一轮判断。
判决式评测最合适的活,是量大、单条价值有限、错了还有下游兜住的那类:训练数据粗筛、去重、批量打标、回归测试。反过来,如果评测结论直接决定一条推理轨迹要不要进训练集,风格对抗上那 20 个百分点的差距会以噪声的形式进到数据里,而这批样本正好是 JEV 的薄弱区。
需要提醒的地方也有。 JEV 是闭源托管服务,论文测的是 1.13.0 这一个版本,这类服务的行为会随版本变化。作者自己把模型家族扩展的分析标为探索性,训练数据重叠和基准污染都无法排除。级联的费用是离线仿真,真实串联的延迟没有测。人类盲评只有一名标注者完成 183 条,且不是随机抽查。把它当成一份「哪类任务可以先用便宜评测器」的操作手册是合适的,当成 JEV 的长期性能承诺则不合适。
如果判决式评测服务继续降到这个价位,评测流水线的常见形态大概会变成两级:大部分普通判断交给第一级,预算集中投在多步推导和风格对抗这两类样本上。真正需要人手的地方会往后移,从「逐条打分」变成「抽样核对第一级在哪些题上过于自信」。
⭐️关注我,实时跟进 AI 最新进展⭐️