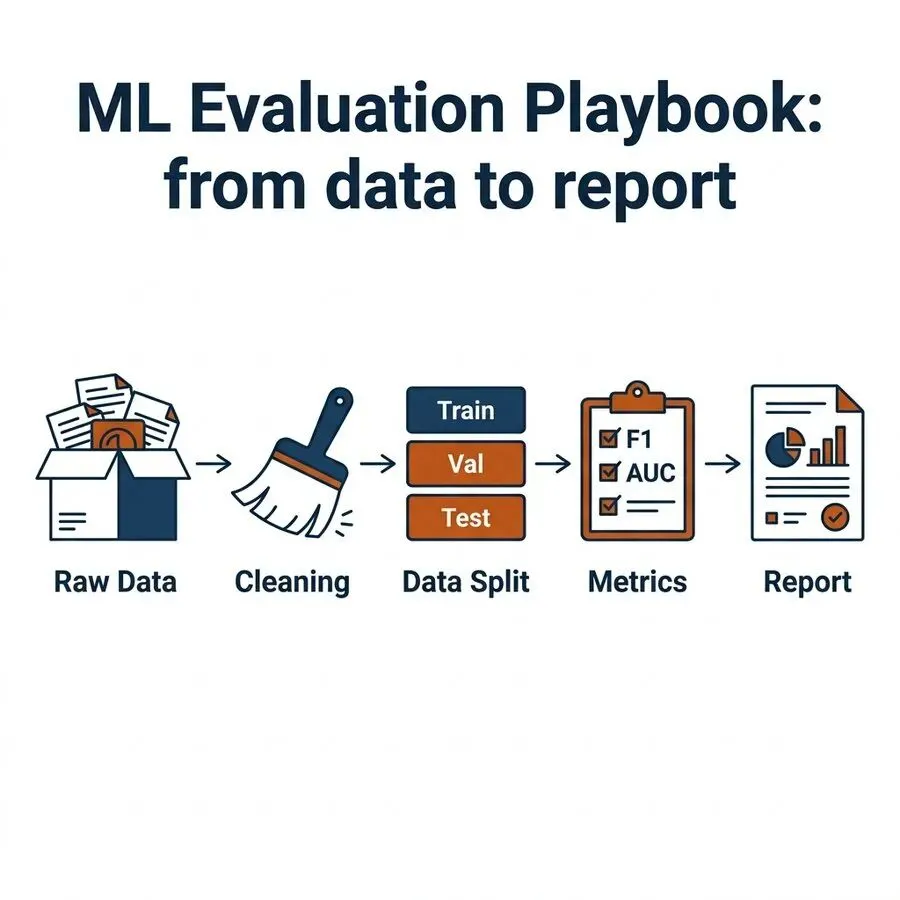
你看到的所有 benchmark 分数,可信度都取决于背后的数据与方法干不干净。这篇手册不讲玄学,给出可直接照做的六步流程:数据收集 → 清洗预处理 → 指标定义 → 测评流程 → 结果分析 → 避坑清单。每一步都配有具体操作和检查清单,照着做,你的评测就能复现、可信、扛得住质疑。
0. 引言:先回答"分数可信吗",再回答"怎么测"
昨天 DeepSeek 发布 V4-Pro,公布 DeepSWE 62.7;今天 GLM-5.3 说 Terminal Bench 3.0 开源第一。分数满天飞的年代,最该学会的不是"看分数",而是自己动手测。
因为评测界自己刚经历了一场可靠性危机:MMLU、HumanEval、GSM8K 等主流测试集被发现大量混进模型训练数据(MIT+Stanford 研究显示 MMLU 污染率 15%-28%),模型考的是"记性"而非"能力"。OpenAI 今年甚至停报 SWE-bench Verified。
所以,与其争论别人的分数,不如掌握一套自己的评测方法论。这篇手册把整个过程拆成六步,每一步都有操作指引和检查清单。
1. 地基:三套数据与一条红线
动手之前,先立住两个概念,它们是后面所有步骤的前提。
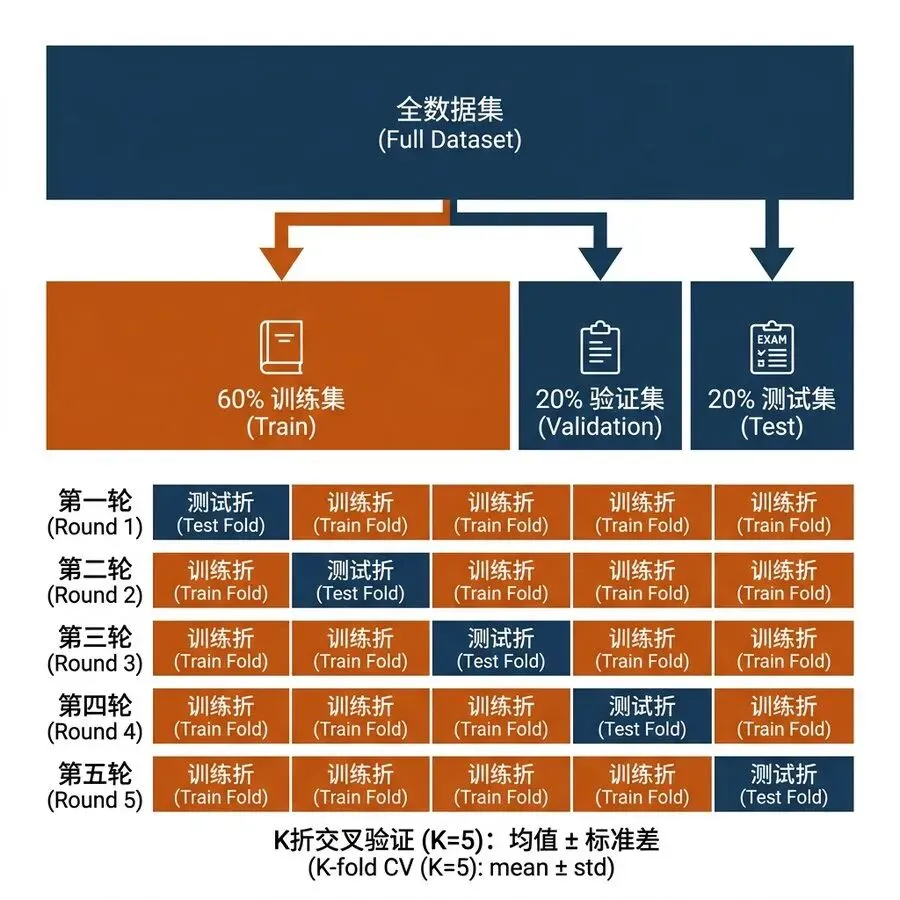
三套数据,职责分离:
一条红线:测试集从训练开始到结束,绝不能碰。
- 甚至"看了测试集结果再改模型"也不行——看了就相当于考试前看了卷子。
✅ 检查清单(地基)
- 所有预处理(见第 3 步)都在训练集上拟合,再应用到验证/测试集
2. Step 1:数据收集
2.1 公开数据集渠道(按场景选)
| | |
|---|
| | |
| | 最全的 NLP/多模态数据集集散地,可 load_dataset() 一行加载 |
| Papers with Code、arXiv 附录 | |
| SWE-bench、LiveCodeBench、HumanEval | 代码评测;LiveCodeBench 按发布日期门控 |
| 金融(Wind/同花顺)、医疗(MIMIC-IV)、电商公开日志 | |
2.2 自采数据(当没有现成数据集时)
- Web 爬取:Python
requests + BeautifulSoup(静态页)、Scrapy(大规模)、Playwright(需要 JS 渲染的页面); - API 采集:优先用官方 API(GitHub API、X API、各类开放数据平台),稳定且合规;
- 日志/埋点
2.3 数据规模怎么定(经验法则)
- 传统机器学习:样本量 ≥ 特征数 × 10;分类任务每类至少几百条起步;
- 深度学习:数据量上不封顶,先小规模验证流程,再扩容;
- 评测集规模:想区分两个模型 ±5% 的差距,每类至少 100 条;想区分 ±2%,每类 400+ 条(可算置信区间,见第 6 步);
- 类别不均衡时,小类样本量决定评测可靠性——别只看总量。
✅ 检查清单(收集)
- 每个数据来源记录在案(名称/URL/抓取日期/许可协议)
- 商用/发布前确认数据许可(CC、Apache、专有协议)
3. Step 2:数据清洗与预处理
3.1 去重
- 完全重复:直接
df.drop_duplicates(); - 近似重复(文本):MinHash/SimHash(大文本)、句子级编辑距离;大模型语料去重用近似重复检测(如
datasketch 库); - 注意:评测集内部绝不能有重复题——同一题出现两次等于放水。
3.2 缺失值处理(按缺失率与场景选)
3.3 归一化/标准化(数值型特征)
- Min-Max 归一化:
(x - min) / (max - min) → [0,1];适合分布有界、模型对尺度敏感(如神经网络输入); - Z-score 标准化:
(x - μ) / σ → 均值 0 方差 1;适合分布近似正态、模型假设高斯(如 SVM、PCA 前); - RobustScaler
- 铁律:归一化参数只在训练集上计算,再用同一参数变换验证/测试集——否则就是数据泄漏。
3.4 文本预处理(NLP/LLM)
- 去 HTML 标签、乱码、控制字符;统一编码(UTF-8);
- 中文:分词(jieba)、繁简转换(opencc);
- 英文:小写化、去停用词(按任务决定,有些任务停用词有意义);
- LLM 数据:用长度/困惑度过滤低质文本,去重到句子级,去 PII。
3.5 异常值与类别不平衡
- 异常值:IQR 法(超出 [Q1-1.5×IQR, Q3+1.5×IQR] 标记)、Z-score(|z|>3);先查业务含义再决定删/留;
- 类别不平衡:欠采样(删多数类)、过采样(SMOTE 合成少数类)、权重调整(
class_weight);评测时用小类别的 F1/召回率,别只用准确率。
✅ 检查清单(清洗)
- 清洗前/后各保存一版,统计行数变化(记录清洗日志)
4. Step 3:测评指标——定义与公式
4.1 分类任务(最常用)
先有混淆矩阵:TP(真正例)、FP(假正例)、FN(假负例)、TN(真负例)。
图1:混淆矩阵与 Precision / Recall / F1 公式
- 准确率 Accuracy = (TP + TN) / (TP + FP + FN + TN)。类别不平衡时不可靠——99% 多数类,全猜多数类也 99% 分。
- 精确率 Precision = TP / (TP + FP)。预测为正的里面,有多少真的为正。误报敏感的场景看它(垃圾邮件误杀)。
- 召回率 Recall = TP / (TP + FN)。真正的正例里,找回了多少。漏报敏感的场景看它(癌症筛查、风控)。
- F1 = 2 × Precision × Recall / (Precision + Recall)。精确率与召回率的调和平均,不平衡任务的默认首选。
- Fβ:给召回率加权(β>1 更看重召回,如 F2 用于疾病筛查)。
- AUC-ROC:随机正例排在随机负例之前的概率,阈值无关,适合排序场景。
4.2 回归任务
- MAE = (1/n)Σ|yᵢ - ŷᵢ|:平均绝对误差,量纲直观;
- MSE = (1/n)Σ(yᵢ - ŷᵢ)²:放大离群值惩罚;
- RMSE
- R² = 1 - SS_res/SS_tot:解释方差比例,0-1(可负)。
4.3 检索/排序
- Precision@K / Recall@K
- MRR
- NDCG
4.4 生成式任务(LLM)
- BLEU / ROUGE:机器翻译/摘要的传统指标,参考译文对比,与人类判断相关性有限;
- pass@k:代码生成,k 次尝试内至少一次通过的比例(LLM 评测标配);
- 人工评测 / Arena Elo:对话质量的金标准——让真人盲选 A/B,用 Elo 排名(LMSYS Chatbot Arena 就是这个模式)。
指标选用速查
类别平衡 → 准确率;不平衡 → F1 / 召回率;排序 → NDCG/MRR;生成 → 人工 + pass@k;回归 → RMSE + R²。
✅ 检查清单(指标)
- 至少报告两个互补指标(如 F1 + AUC,或 Precision + Recall),别只报一个
- 已声明是宏观平均还是加权平均(macro 对每类一视同仁;weighted 按样本量加权)
5. Step 4:测评流程拆解
5.1 数据划分方式
图2:留出法(60/20/20)与 K 折交叉验证
- 留出法(hold-out):60/20/20 或 70/15/15,随机 + 分层抽样(每类的比例与全量一致);
- K 折交叉验证:数据分 K 份,轮流 1 份做测试、其余训练,报告 K 次均值±标准差。K 常用 5 或 10。适合数据量中等、需要稳健估计;
- 分层 K 折:每折内类别比例保持(
StratifiedKFold),分类任务默认用它; - 时间序列:不能用随机划分(未来泄漏进过去)——用滚动窗口/前向链(TimeSeriesSplit),训练集永远在测试集之前;
- LLM 评测:用时间门控——只测模型训练截止日期之后的数据(LiveCodeBench 的做法),从根上防污染。
5.2 基准测试(Baseline)
- 至少对比 3 类基线:随机猜测 / 多数类(下限)、经典方法(逻辑回归、TF-IDF+SVM 等传统线)、当前最优(SOTA);
- 你真正想问的是"我的方案比基线强多少",而不是"绝对分多高"。
5.3 交叉验证的执行要点
- 固定
random_state(种子),保证可复现; - 每次折内独立做预处理拟合(归一化、特征选择、SMOTE 都只在训练折内做,绝不跨折);
- 如果各折标准差很大(>5%),说明数据分布不稳定,先查划分是否有问题。
🚨 红线清单(防泄漏)
6. Step 5:结果分析与报告撰写
6.1 对比基线
- 报告增量:我的方法 vs 基线 +ΔX,并给出各方法的完整指标表;
- 显著性检验:两个模型差 0.5% 未必有意义——用配对检验:分类用 McNemar 检验,连续指标用配对 t 检验或 Bootstrap 置信区间(重复抽样 1000 次,看置信区间是否包含 0)。不会算就用 Bootstrap,最通用。
6.2 误差分析(必做,别省)
- 看混淆矩阵,找出错得最多的类别对(哪两类老搞混);
- 随机抽 50-100 个错例,人工归类错误模式(标注错?边界样本?长尾罕见?数据本身错?);
6.3 可视化呈现
- 混淆矩阵热力图
- PR 曲线 / ROC 曲线
- 学习曲线(训练量 vs 分数)——判断"数据不够"还是"模型不够";
- 特征重要性 / 消融实验柱状图
6.4 报告模板(直接套)
1. 背景与目标(要解决什么问题,为什么这么测) 2. 数据描述(来源、规模、划分方式、清洗摘要) 3. 方法(模型、超参数、种子、环境版本) 4. 结果(指标表 + 基线对比 + 显著性 + 可视化) 5. 误差分析(错例模式、失败案例) 6. 消融/敏感性分析 7. 限制(数据偏差、评测局限、未覆盖场景) 8. 可复现信息(代码仓库、随机种子、依赖版本、数据 hash)
✅ 检查清单(分析报告)
7. Step 6:常见陷阱与注意事项
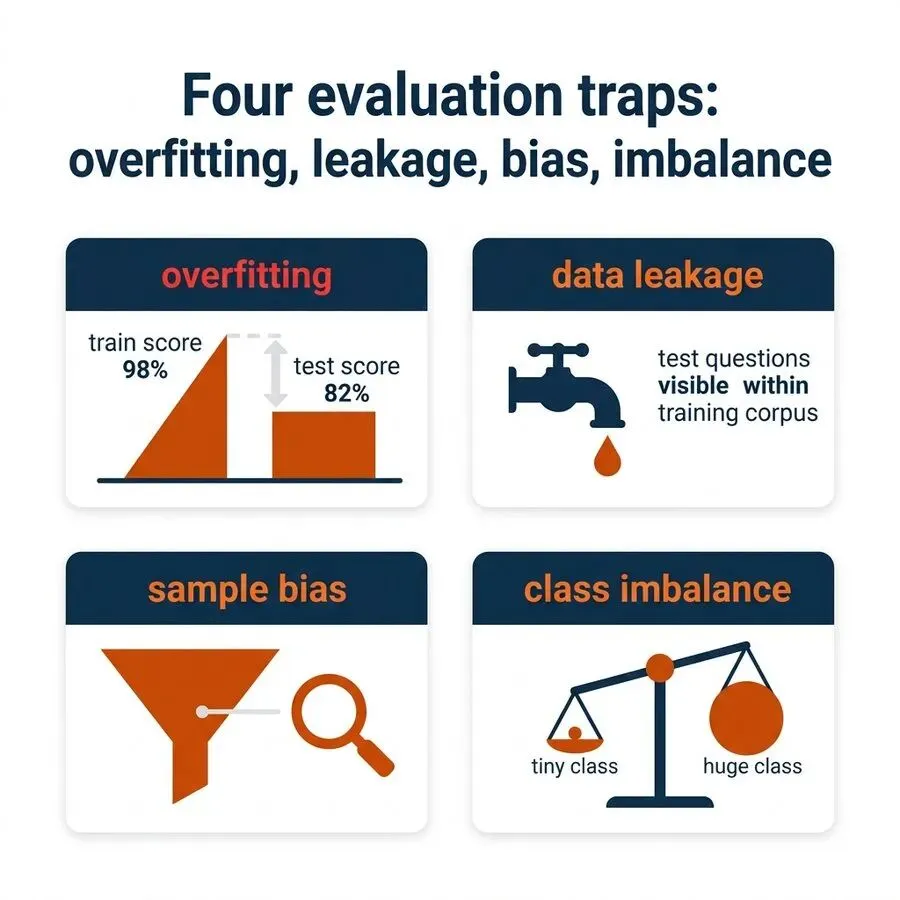
图3:四大评测陷阱——过拟合 / 数据泄漏 / 样本偏差 / 类别不平衡
7.1 过拟合(Overfitting)
症状:训练分 98%,测试分 82%,且差距越来越大。排查与缓解:加正则化(L1/L2、dropout、早停);增加数据或做数据增强;交叉验证确认方差是否过大;降低模型复杂度(特征更少、层更少)。
7.2 数据泄漏(Data Leakage)——最隐蔽、最致命
除了 5.4 节的预处理泄漏,还有三种:
- 未来信息泄漏:预测时用了"当时不可能知道"的信息(时序数据经典坑);
- 重复样本跨折:同一用户的多个样本被分到训练和测试两折——按用户/实体分组划分(
GroupKFold)解决; - 评测集污染(LLM 特有):测试题在模型训练语料里。对策:时间门控 + 私有测试集 + 只信 cutoff 后的分。
7.3 样本偏差(Bias)
- 选择偏差
- 时间偏差:用 2023 年数据训,2026 年分布已变(分布漂移);
- 对策:明确数据的时间/人群范围,报告限制;生产环境定期重采样、监控漂移。
7.4 其他高频坑
- 类别不平衡下只看准确率
- 评测集太小
- 忘记固定种子:结果不可复现 → 固定 random_state + 记录环境;
- 只看均值不看方差
8. 结语:把"分数"变成"证据"
回到开头的 V4-Pro 62.7 分——现在你应该知道怎么验证它了:查它考的是什么题、题是否在模型 cutoff 之后、测试集是否可能泄漏;更重要的,是学会用自己的数据、自己的流程,跑出自己的分数。
评测的本质,是把"感觉"变成"证据"。而证据的可信度,取决于每一步操作是否经得起追问:数据哪来的?怎么洗的?指标怎么算的?划分怎么做的?结果能不能复现?
六步走完,再有人给你看一个 90 分,你可以平静地问一句:这套流程,你走完了几步?
附录:核心操作速查· 收集:记来源、查许可、按区分度定规模 → 版本 hash、脱敏· 清洗:去重→缺失→归一化→文本清洗→异常值 → 参数只在训练集拟合· 指标:不平衡用 F1/召回,排序用 NDCG,生成用人工+pass@k → 至少两个互补指标· 划分:分层留出 / 分层 K 折 / 时序滚动 / cutoff 门控 → 测试集只碰一次· 分析:基线对比 + 显著性 + 误差分析 + 可视化 → 均值±标准差、种子· 避坑:过拟合、泄漏、样本偏差、类不平衡 → 按 7.1-7.4 逐条过关键信息源· 评测污染背景:《Re-evaluating MMLU》(MIT+Stanford,2026 Q1):MMLU 污染率 15-28%· 防污染基准:LiveCodeBench(ICLR 2025,时间门控)、FrontierMath(Epoch AI,答案保密)、HLE、GPQA Diamond、Arena Elo· V4-Pro / GLM-5.3 分数:厂商及公开报道(2026-08-13/14)· 操作类方法(MinHash 去重、SMOTE、StratifiedKFold、Bootstrap 检验等)为机器学习社区标准实践