整理这组漫画时,我最大的感受是:Agent 评测的内容真的很多。光看“评测体系”四个字,好像就是准备一些题,再给回答打分。往下看才发现,模型、工具、记忆、执行过程,每一块都有要检查的地方。
我先把这次学到的东西整理成一个框架:为什么要评、具体评什么、短程和长程任务有什么差别,以及刚开始怎么搭。
下面的图来自这组 10 页漫画,资料主要参考美团、阿里、Anthropic 和小山学堂。这篇也是学习笔记。真正放到业务里,还会遇到很多图里没有的问题。
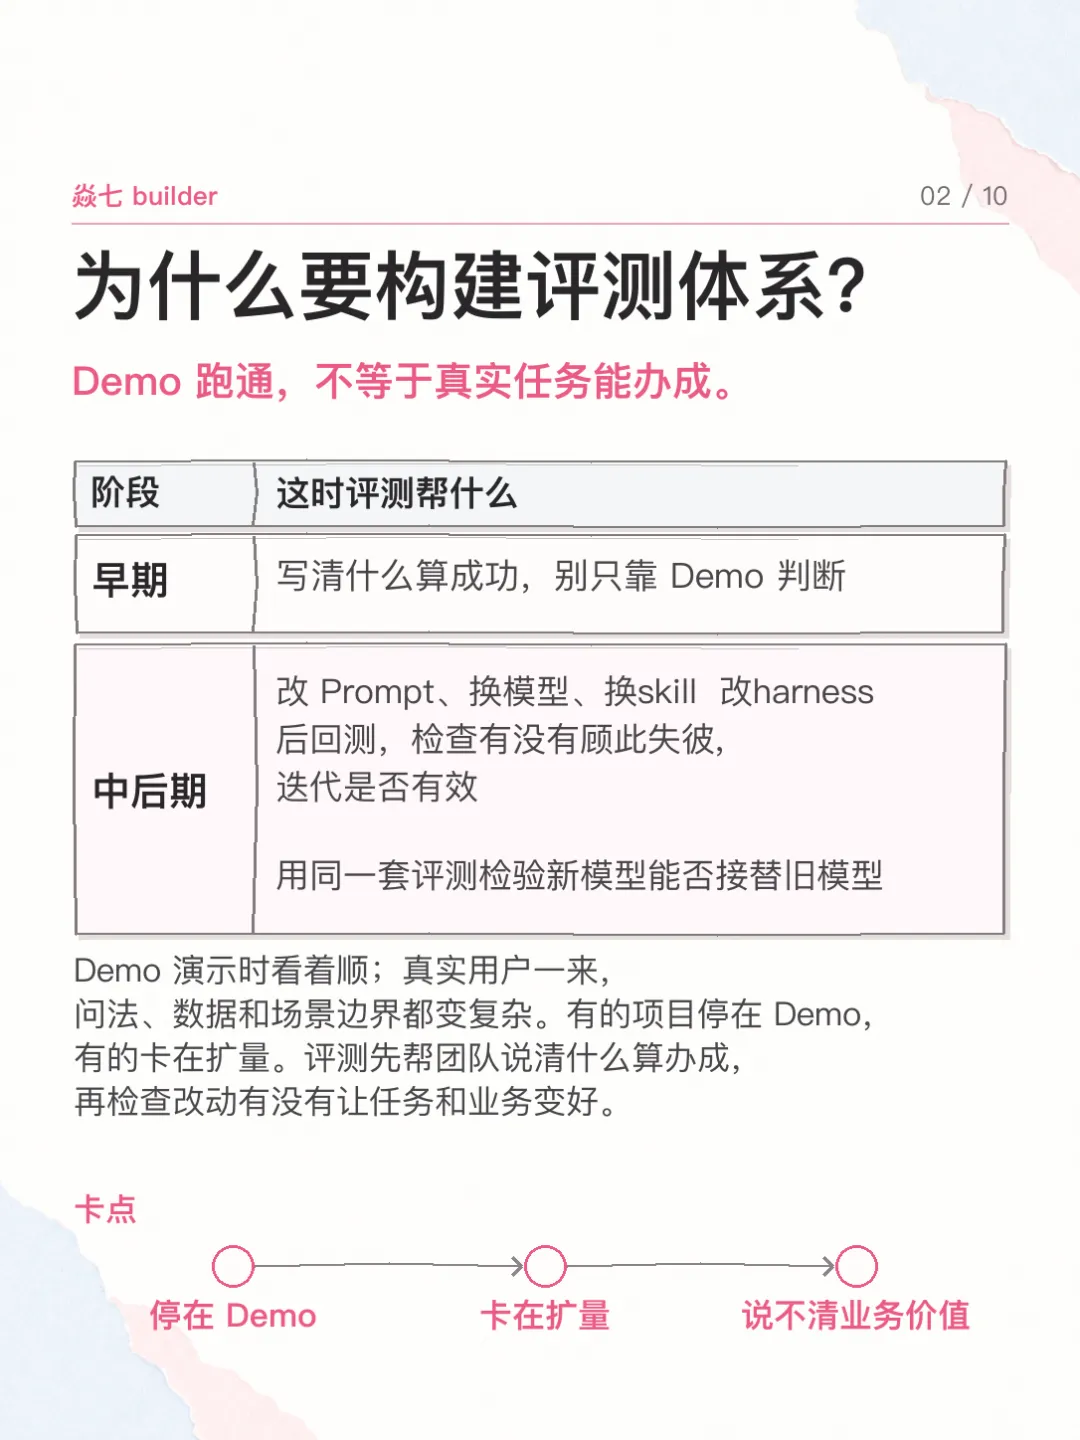
1.Demo 跑通之后,为什么还要评测?
做演示时,问题通常是准备好的,数据也比较整齐。换成真实用户,问法会变,信息可能缺一半,工具也不一定每次都能返回结果。
比如让 Agent 查一笔订单的收益。回答“4 元”看着很简单,但它查的是不是用户说的那笔订单?有没有把销售额当成收益?查不到时,会不会自己编一个数字?
这些问题,需要先写进“什么算做对了”的标准里。否则,这次觉得回答不错,下次换个人看,又可能得出不同结论。
到了中后期,评测还有一个很实际的用处:检查改动有没有让原来能办好的事变差。 改 Prompt、换模型、调整 Skill 或执行程序之后,把已有任务重新跑一遍,才知道这次修改到底帮到了哪里,又影响了哪里。
2.模型能力强,任务就一定能办好吗?
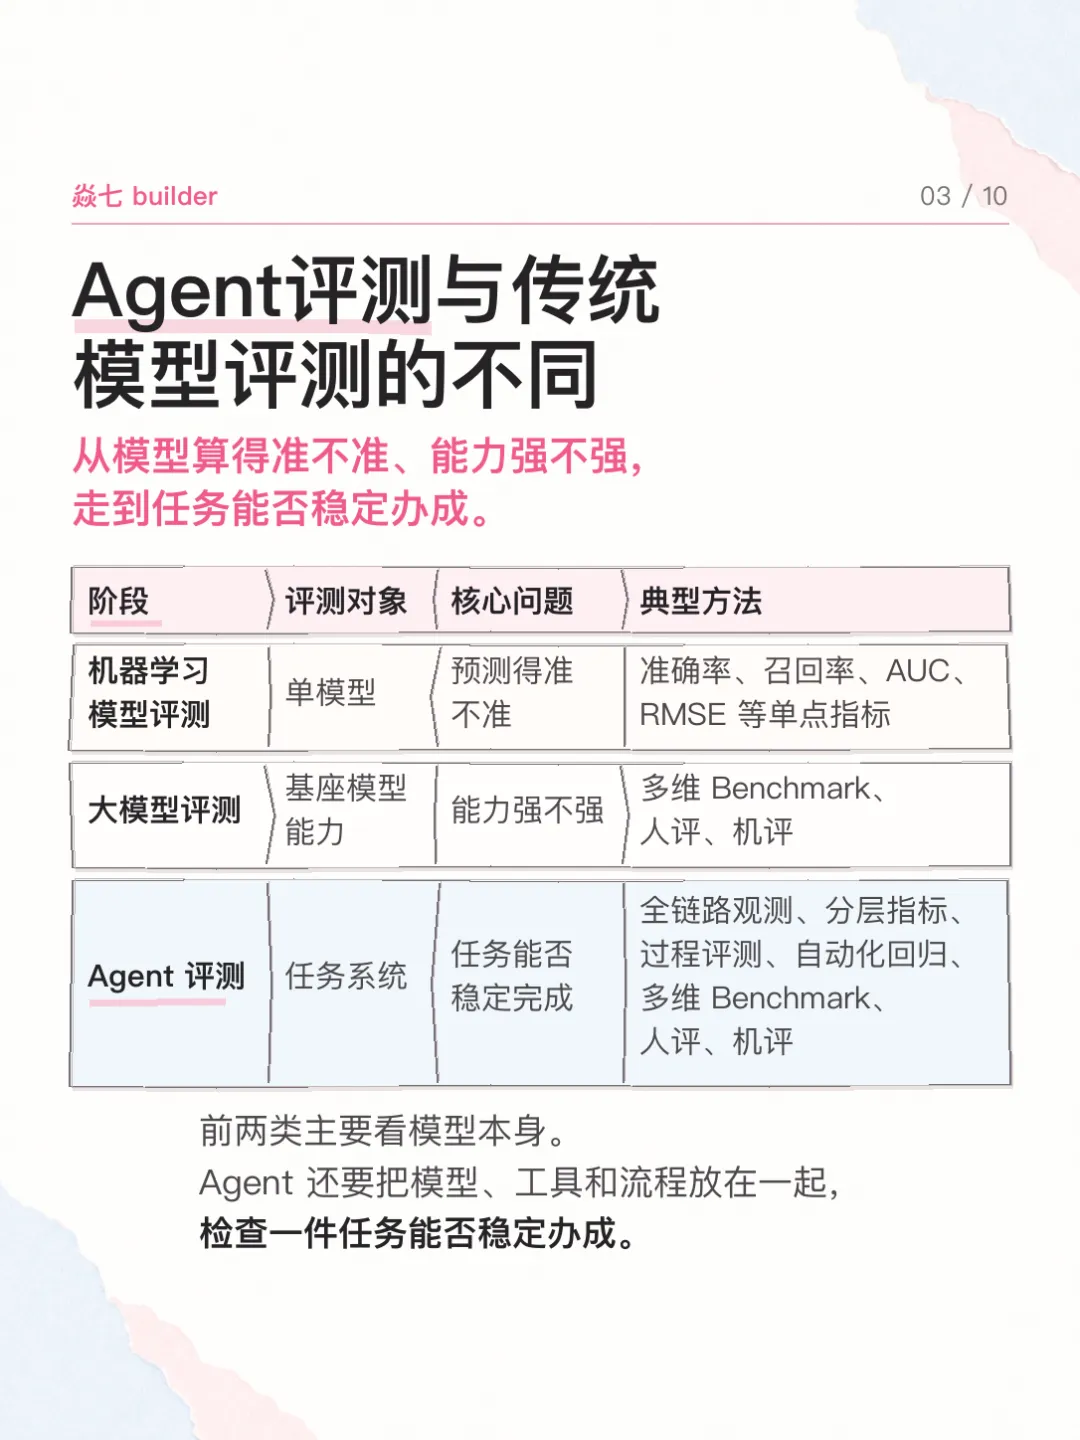
传统机器学习评测,常用准确率、召回率等指标,检查模型预测得准不准。大模型评测会考察更广的能力,比如理解、推理和生成。
到了 Agent,我们还要往外看一层:模型接到了什么信息,选了什么工具,参数有没有填对,工具返回后又做了什么。
模型可能理解了“查上一单收益”,却调用了查销售额的接口;工具也可能没有出错,但拿到的数据不完整。最后的回答同样不可靠。
所以,Agent 评测的对象是完成任务的整套系统。模型本身的能力仍然要看,工具和执行流程也要一起检查。
3.把一次任务展开,才知道该检查哪一步
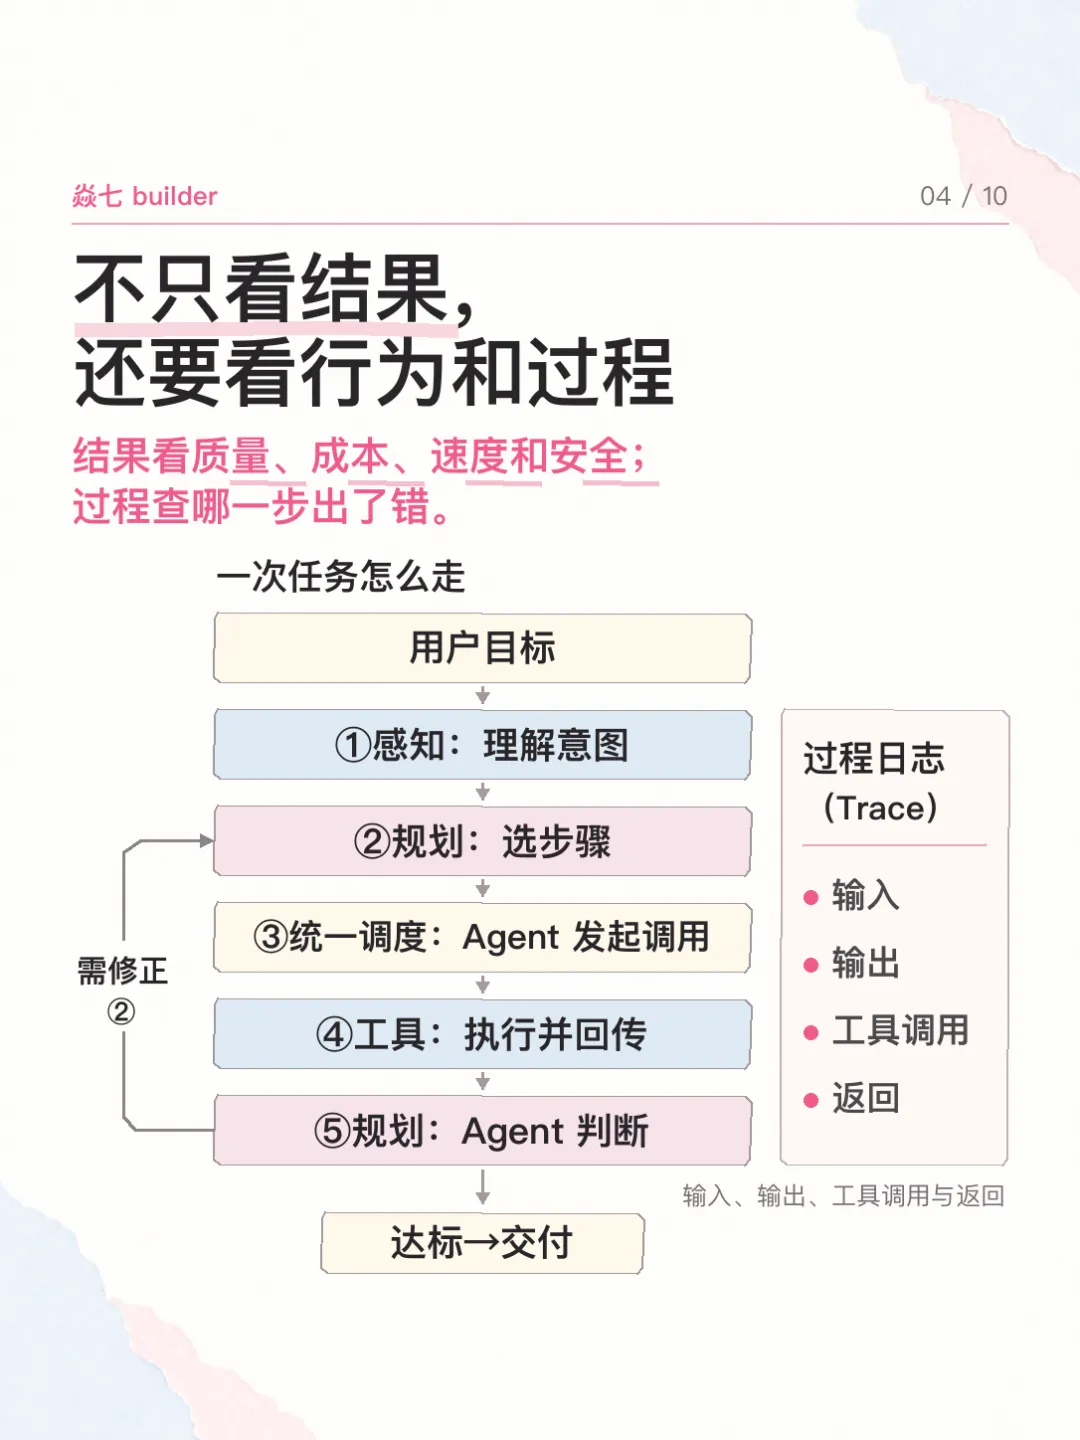
漫画里把一次需要调用工具的任务画成了几步:理解用户目标、选择步骤、发起调用、工具执行并返回、Agent 判断下一步。
这里有两个动作容易混在一起。Agent 决定要调用什么,工具负责执行具体操作并返回结果。 Agent 收到结果后,再决定继续、调整,还是交付。这个过程可能走一遍,也可能来回多次。
假设两次都查到了正确收益。第一次一次调用就完成了;第二次先查错订单,重试几轮才拿到答案。只看最后的“4 元”,两次没有差别;看过程,才能发现第二次多花了时间和调用成本。
过程日志,也就是 Trace,要把相关的输入、输出、工具调用和返回结果记下来。排查时能沿着这些记录回看:是目标理解错了、参数填错了,还是工具返回后处理错了。
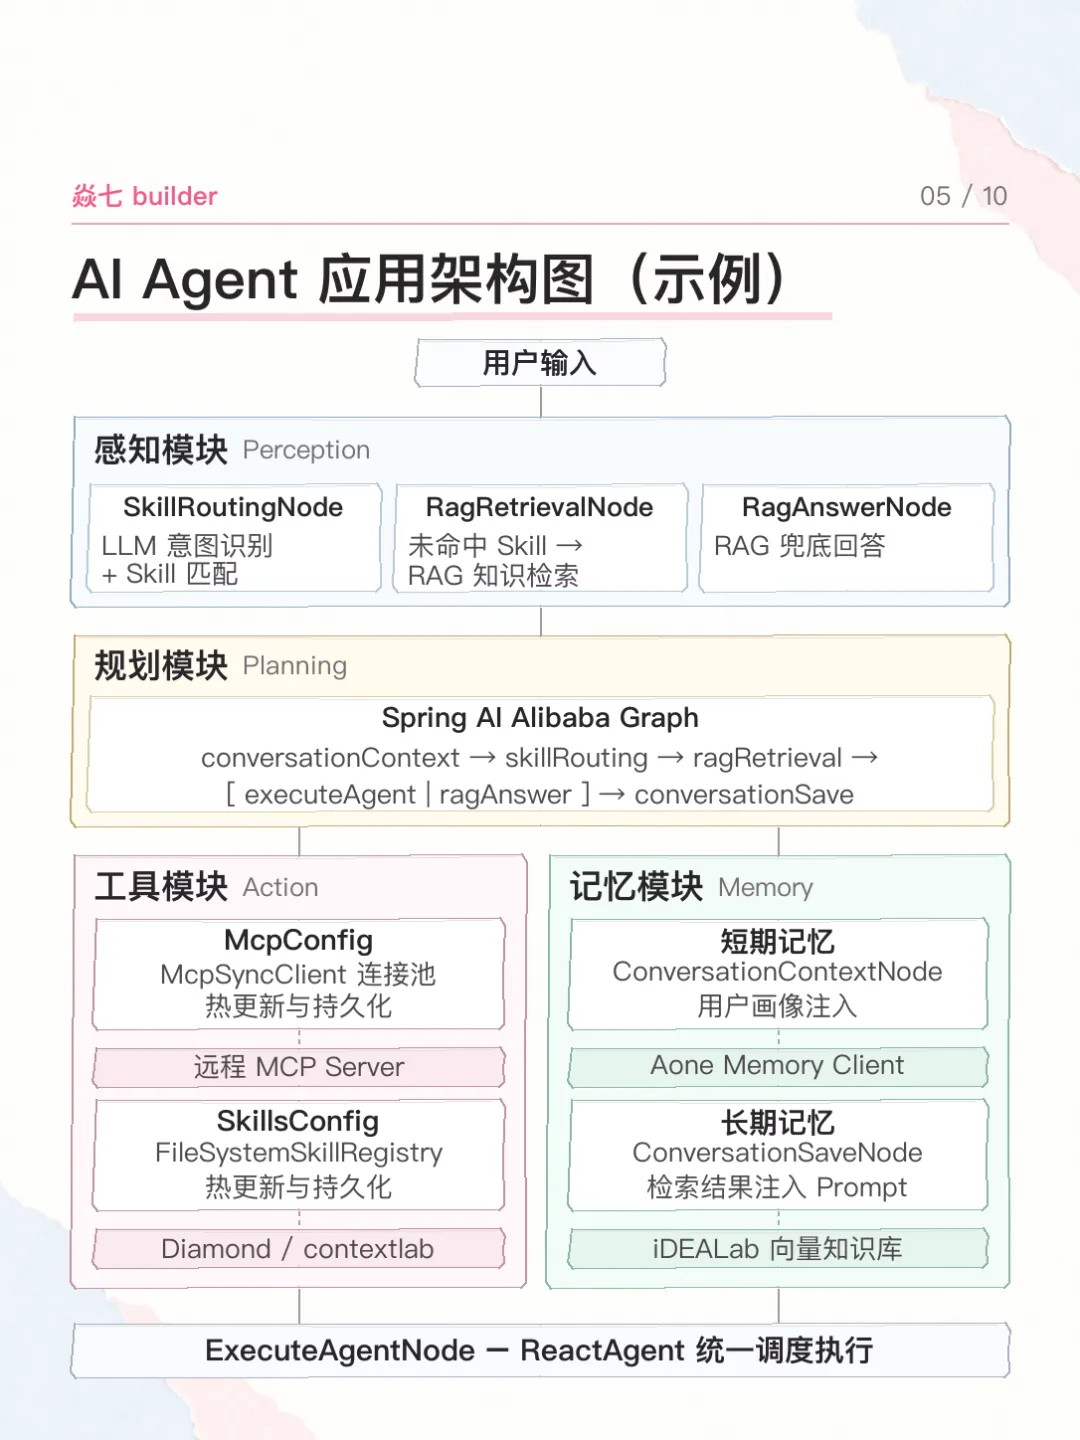
这些步骤放进实际系统,会对应不同模块。下面是阿里文章中的一个应用架构示例:感知模块处理意图和匹配,规划模块安排执行路径,工具模块连接具体能力,记忆模块提供上下文支持。
读这张图时,可以先看模块之间怎样接力,再看里面的节点名称。其中没有匹配到 Skill 时转向 RAG 检索和回答,是这个案例的具体设计。其他业务的模块划分和分支可能不同。
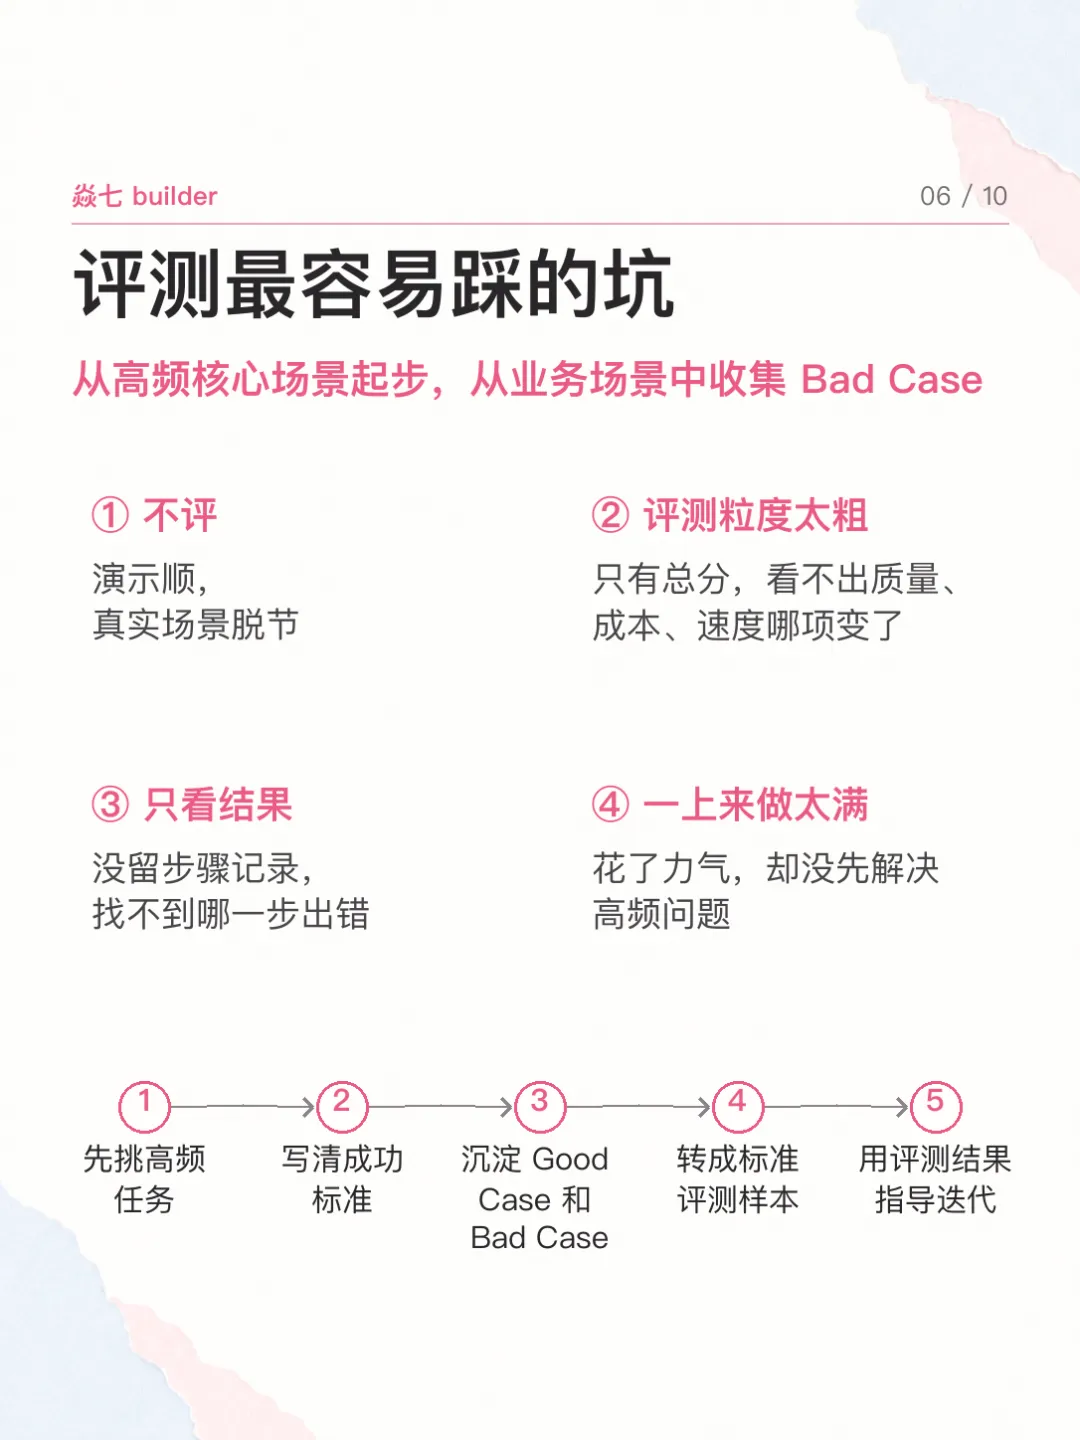
4.最容易踩的坑,是连“哪里变了”都看不出来
漫画里整理了四种情况:没有评测、只有一个总分、只看最后结果,以及刚开始就想把所有东西都做全。
总分有时会掩盖问题。一个版本回答更准确了,却多调用了几次模型;另一个版本速度快了,却更容易漏掉用户的要求。把它们压成一个分数,很难决定下一步该改什么。
刚开始可以挑一类高频任务,把成功标准写具体。比如查订单,至少要说清查哪一笔、使用什么数据、怎么算收益,以及查不到时怎么处理。
接着收集办成和没办成的例子。失败案例也要留下当时的输入、返回结果和出错位置。修完之后,再把这些例子跑一遍,看看问题是否解决。这样,下一次改动时就有东西可以对照。
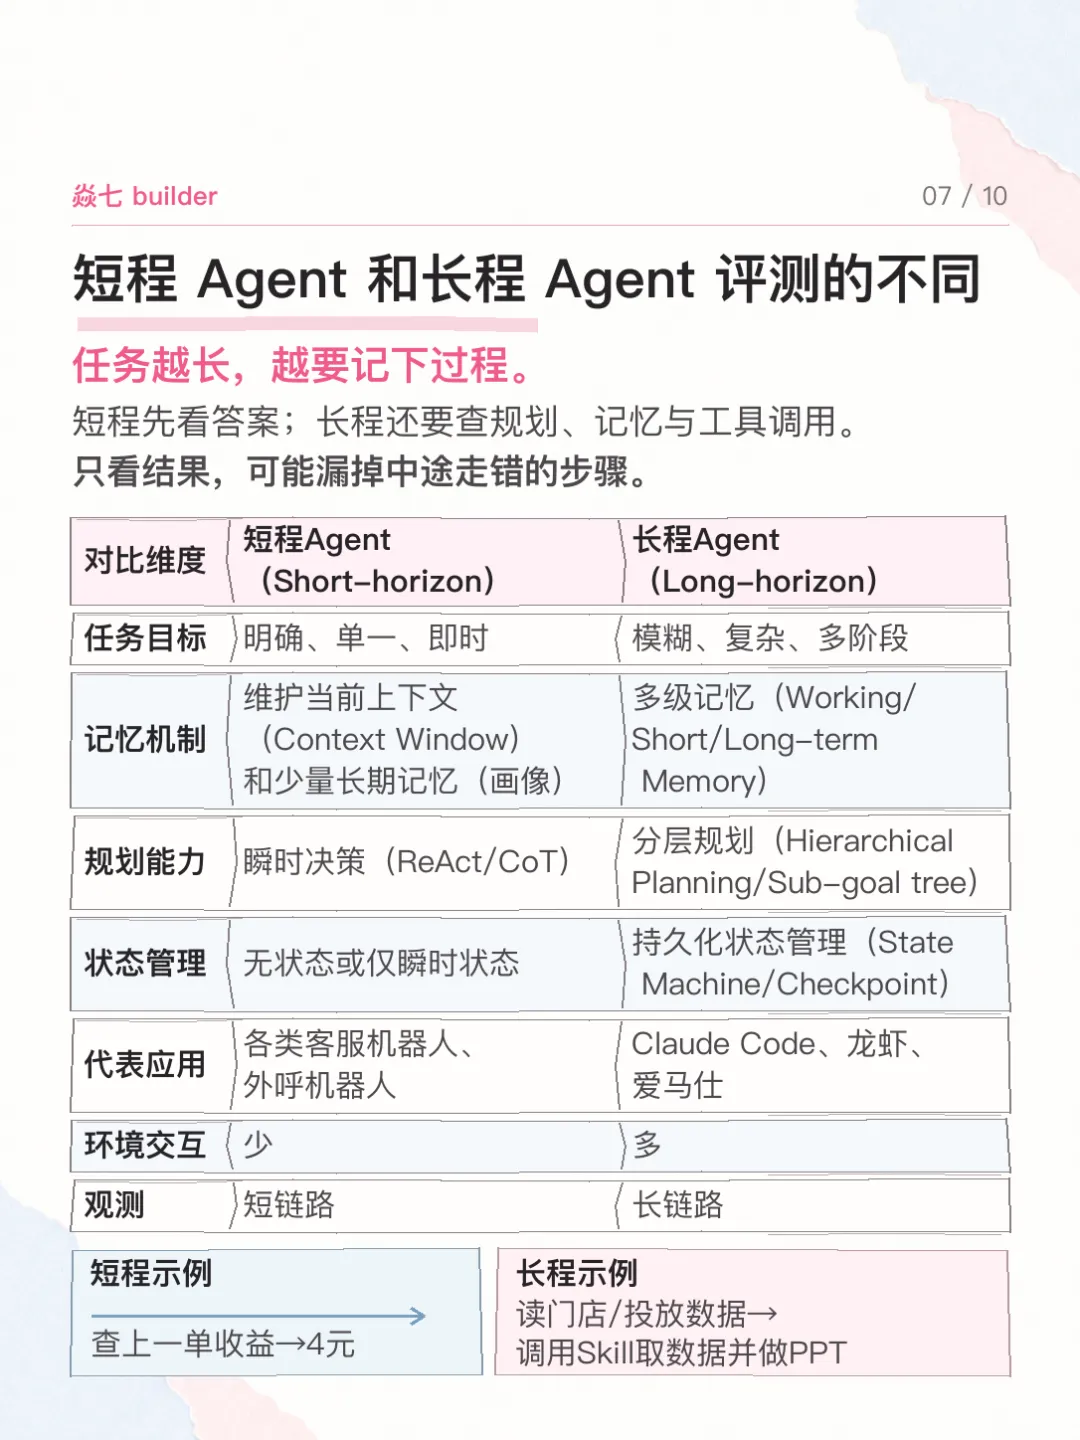
5.短程和长程,评测的差别在哪里?
短程、长程,可以先按任务需要经历多少步骤、多少次反馈来理解。单纯用运行时间来分,不够准确。
查上一单收益,目标和结果都比较明确。主要看有没有查对、算对、答对,以及完成这件事花了多少时间和成本。短程任务也可能调用工具,也需要留下必要记录。
再看漫画里的长程例子:读取门店和投放数据,做分析,最后生成 PPT。中间要确认时间范围、整理数据、核对计算、组织结论,再把结果写进文件。
最后能打开 PPT,只说明文件生成了。里面的数据是否对应同一时间段?结论能不能从数据里得到支持?前面发现的问题有没有在后面修正?这些都要检查。
任务步骤越多,越需要检查中间状态。 否则第一步拿错了数据,后面每一步都执行得很顺,最终交付也可能是错的。
图里列的是常见差异。具体任务需要多少记忆、是否保存状态,还要看它怎么运行,不能只凭“短程”或“长程”的名字判断。
6.指标很多,先问清每个指标在查什么
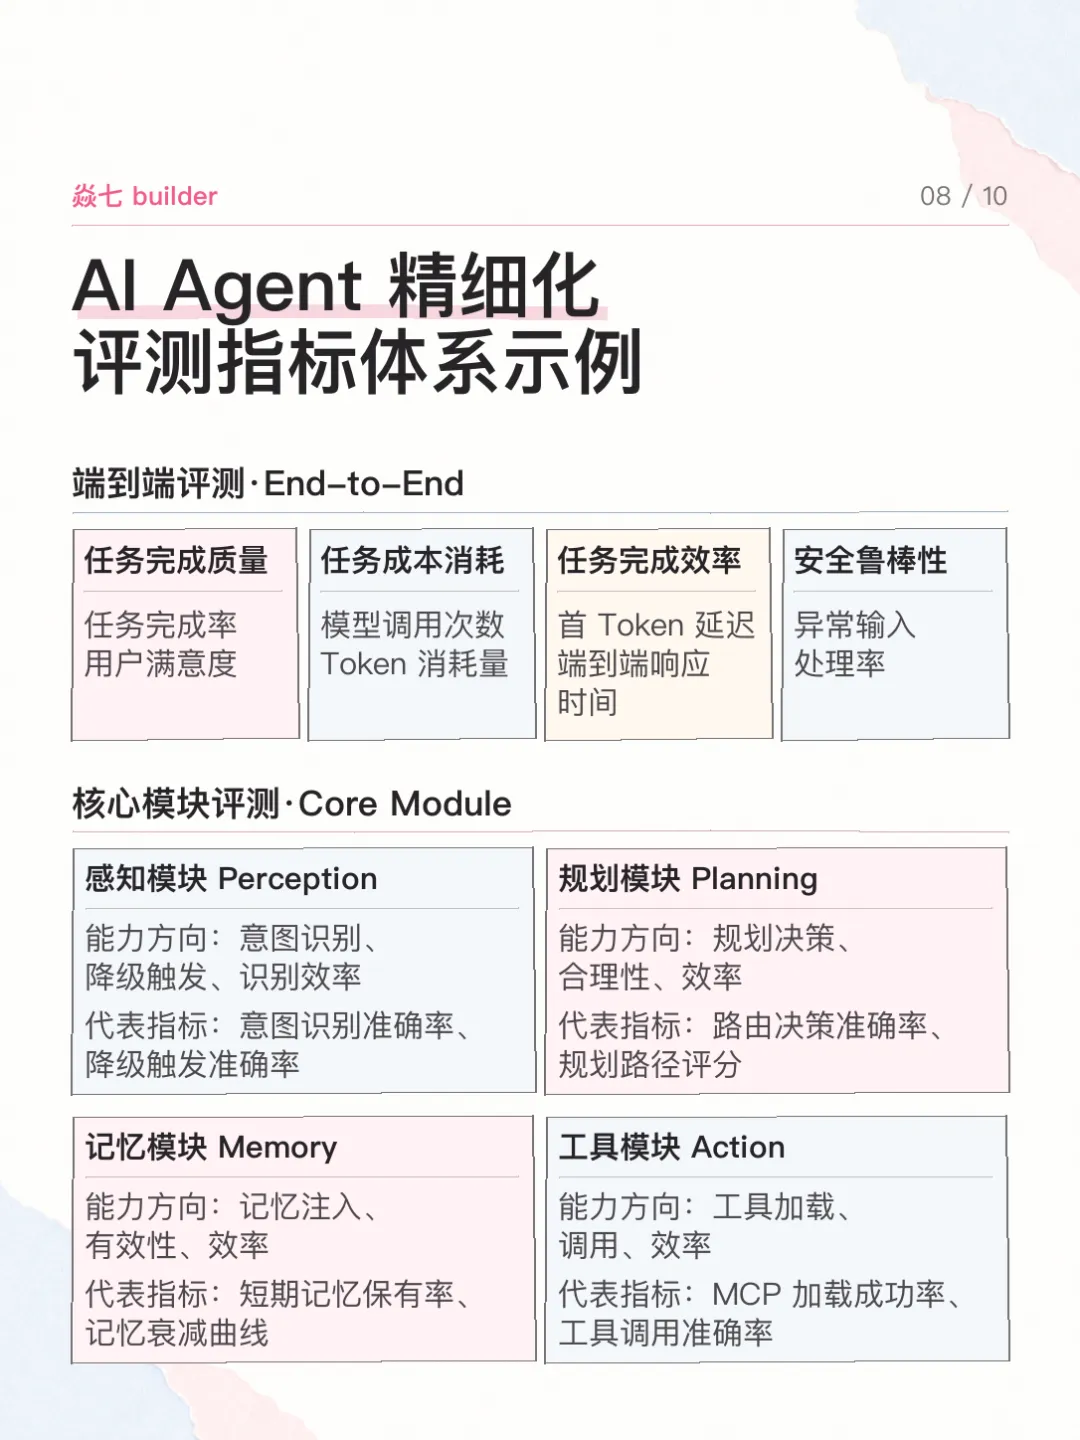
阿里的指标体系,先看整项任务,再拆到核心模块。漫画里选了其中的代表指标,方便先理解结构。
整项任务可以从四个方向看:
质量:用户的任务有没有完成,要求有没有遗漏,答案有没有依据。
成本:调用了几次模型和工具,消耗了多少 Token。真要算钱,还需要结合实际计费。
效率:用户等多久才看到第一个字,多久才拿到完整结果。这是两个不同的等待时间。
安全与稳健性:异常输入能不能处理,遇到失败时能不能合理停止或说明情况。
拿“读数据做 PPT”来说,文件做出来了、内容也对,质量这一项可能过关。但如果每次都要反复读取同一份数据,成本和效率仍然有可改的地方。
发现整项任务表现不好,再往模块里找:意图识别错了,去看感知;执行路径不合理,去看规划;忘了用户前面的要求,去看记忆;调用失败或参数不对,去看工具。
模块指标帮我们缩小排查范围。最后还要回到原来的任务上验证,看看修改后用户的问题是否真的解决了。
7.刚开始,先搭到哪一步?
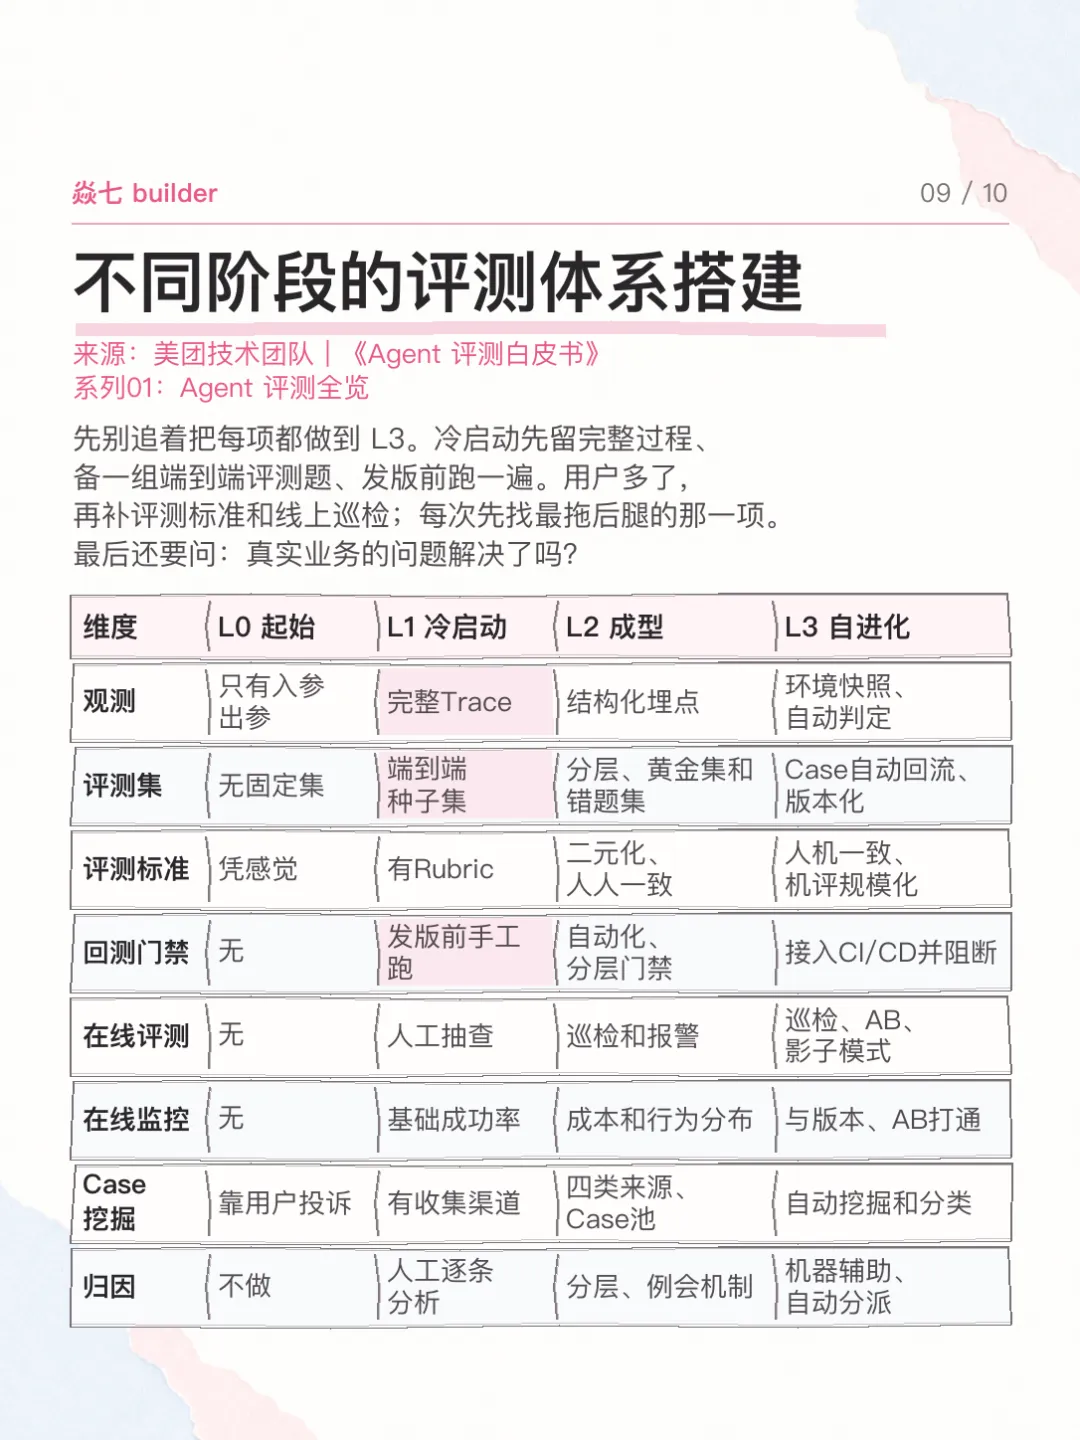
美团的阶段表,把观测、评测集、评测标准、回测、线上检查、案例收集和归因等能力,分成了从 L0 到 L3 的不同阶段。
这张表可以用来对照自己缺什么。刚开始,不需要把每一列都做满。
我理解最先要准备的,是一批真实任务、一份能执行的判断标准,以及能回看过程的记录。每次修改后,先把这批任务重新跑完。
这里的“标准”最好能落到具体检查上。比如数据任务,可以核对订单编号、日期和金额;生成 PPT 的任务,还需要检查内容是否遗漏、结论是否有依据。能用程序核对的部分,就按明确规则检查;涉及表达和判断的部分,可以让人参与。使用模型打分时,也要抽查它的判断是否可靠。
任务逐渐增多后,再增加自动回测、线上抽查和告警。线上遇到的新问题,整理进评测集。下次修复或换版本时,就可以检查它有没有再次出现。
如果只留下监控数字,却没有把具体失败任务收回来,那些问题很容易在下一次修改时被忘掉。
整理完这几页,我对 Agent 评测有了一个大致的轮廓:先说明一件事怎样才算办好,记下它实际怎么做,再用这些任务检查每次改动。
至于什么任务值得优先评、标准定多细、成本和速度能接受到什么程度,都要拿真实业务来试。这也是我接下来还需要花时间学的部分。先留好这份框架,碰到具体问题,再回来看对应的那一块。
参考资料
漫画中的架构图、指标和阶段划分,参考了下面的资料,并做了手绘风格整理。指标图选用了代表项目,完整内容可以继续看原文。
美团技术团队·图灵 Agent 评测
《Agent 评测漫谈——由浅入深讲解 Agent 评测》
《〈Agent 评测白皮书〉系列 01:Agent 评测全览》
Anthropic Engineering
Demystifying evals for AI agents
资料原文
https://www.anthropic.com/engineering/demystifying-evals-for-ai-agents
阿里技术·砚东
《AI Agent 应用精细化评测:评测体系设计与工程实践》
小山学堂
Agent 评测课件
资料原文
https://xueai.miyang.cn/slides/learn.html#10-8.html
我的小程序 · 好事小罐
我用AI做了一个小程序「好事小罐」,可以记录生活里的好事、写显化日记,把已经发生的小美好和想实现的愿望都记下来。