端侧大模型测评:一台2015年的老MacBook,如何被我用参数调优榨出8.7倍性能
端侧模型测评的核心,不是跑分,而是回答一个很实际的问题——在你的设备上,用哪个配置,能跑出最好的效果?
图 1 同一台老 MacBook,只改两个参数,性能从 1.0 提升到 8.7 tok/s
过去几周,我一直在折腾端侧大模型的部署和测评。从RK3576工控板到摩尔线程AIBook,再到一台2015年的老MacBook,我踩遍了从驱动层到应用层的坑。
但今天要分享的,是一个完全没有换硬件的优化故事:同一台MacBook,同一个模型,只改了三个参数,推理速度从1.0 tok/s飙升到8.7 tok/s,提升8.7倍。
这篇文章,我把完整的测评方法和踩坑经验记录下来。专业术语我会尽量用大白话解释。
一、先搞懂几个基本概念
什么是 tok/s?
tok/s 是 tokens per second 的缩写,意思是“每秒生成多少个词”。大模型生成文字是一个词一个词往外蹦的,所以这个数字直接决定了你等它回答要等多久。
•1 tok/s:生成一句话(约25个字)要等25秒,基本没法用
•5 tok/s:生成一句话要等5秒,勉强能用
•30 tok/s:生成一句话不到1秒,体验流畅
什么是推理后端?
模型本身只是一堆权重(数字),真正让它“动起来”的是推理引擎。llama.cpp 是最主流的端侧推理引擎之一,它负责加载模型、分配计算、生成token。
什么是 GPU 层数(n_gpu_layers)?
大语言模型是由很多层堆叠而成的。n_gpu_layers 这个参数决定“把多少层放到 GPU 上跑”。0 表示全部在 CPU 上跑,-1 表示全部卸载到 GPU。
二、测试环境:一台2015年的老MacBook
先交代一下硬件背景:
项目 | 规格 |
设备 | MacBook Air(2015年初款) |
CPU | Intel Core i5-5250U,2核4线程,1.6GHz |
GPU | Intel Iris Graphics 6000(核显) |
内存 | 8GB DDR3 |
模型 | Qwen2.5-0.5B(Q4_K_M量化,491MB) |
推理框架 | llama-cpp-python 0.3.35 |
这台机器已经10年了,性能放在今天属于“古董级”。但正是这种极端受限的环境,反而让参数调优的效果格外明显。
三、第一个测试:GPU 到底能不能加速?
很多人第一反应是“GPU肯定比CPU快”。我一开始也这么想,所以先测了 GPU 加速。
测试方法:扫描 GPU 层数
我写了一个脚本,分别测试把 0层、1层、5层、10层、15层、20层、24层(全部)放到 GPU 上跑的速度。
测试结果
GPU层数 | 速度 (tok/s) | 对比纯CPU |
0(纯CPU) | 5.03 | 基准线 |
1 | 4.06 | ❌ 变慢 |
5 | 2.07 | ❌ 更慢 |
10 | 1.68 | ❌ 更慢 |
15 | 0.81 | ❌ 最慢 |
20 | 1.92 | ❌ 很慢 |
24(全部) | 1.71 | ❌ 很慢 |
-1(Metal) | 1.19 | ❌ 很慢 |
结论:GPU 层数越多,速度越慢。
为什么会这样?
答案藏在 llama.cpp 启动时的硬件检测日志里:
simdgroup matrix mul. = false← 无矩阵乘法加速 has tensor = false← 无张量核心
这块2015年的 Intel 核显,既没有矩阵乘法加速单元,也没有张量核心。这两个东西是现代 GPU 加速 AI 推理的核心硬件。没有它们,GPU 在 AI 推理上就是一个“只会做基础运算的普通单元”。
更关键的是,LLM 推理的瓶颈在于内存带宽。模型权重需要从内存搬到计算单元,这个搬运速度决定了推理快慢。核显共享系统的 DDR3 内存,带宽本来就低,GPU 的计算单元还要和 CPU 抢内存带宽,结果就是越用 GPU 越慢。
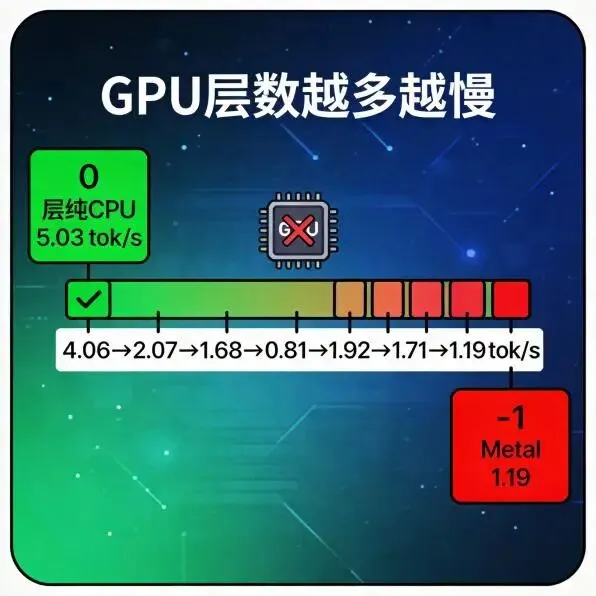
图 2 GPU 层数越多越慢:老核显缺矩阵乘法和张量核心,成为负优化
测评启示:不要迷信“GPU加速”。在老旧硬件或低端 GPU 上,GPU 反而可能成为负优化。判断标准很简单:看硬件是否支持矩阵乘法加速和张量核心。
四、第二个测试:线程数该开多少?
既然 GPU 没用,那就专心优化 CPU。我接着测试了线程数对速度的影响。
测试方法:扫描线程数
i5-5250U 是 2核4线程(物理核心2个,超线程后逻辑核心4个)。我分别测试了 1线程、2线程、4线程。
测试结果
线程数 | 速度 (tok/s) | 对比 |
1 | 7.93 | 基准线 |
2 | 8.70 | 🏆 最优 |
4 | 5.56 | ❌ 变慢 |
结论:2线程最优,4线程反而更慢。
为什么会这样?
i5-5250U 只有 2个物理核心。超线程技术会让操作系统看到4个逻辑核心,但两个逻辑核心共享同一个物理核心的执行资源。
当开4个线程时,两个线程争抢同一个物理核心,频繁的上下文切换和资源竞争反而拖慢了速度。开2个线程,让每个物理核心专心跑一个任务,效率最高。
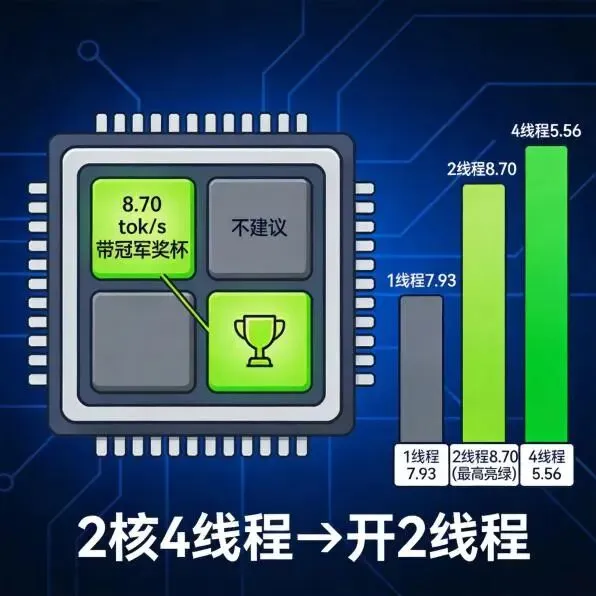
图 3 2 线程最优:线程数应匹配物理核心数,超线程在计算密集任务上是负优化
测评启示:LLM 推理的线程数应该匹配物理核心数,而不是逻辑核心数。超线程在计算密集型任务上往往是负优化。
五、最终优化结果
把两个发现结合起来,我做了最终的配置调整:
配置项 | 默认值 | 优化后 |
GPU层数 | -1(全部GPU) | 0(纯CPU) |
线程数 | 4(逻辑核心数) | 2(物理核心数) |
性能对比
配置 | 速度 | 提升倍数 |
默认(GPU + 4线程) | ~1.0 tok/s | 1.0x |
优化后(CPU + 2线程) | 8.70 tok/s | 8.7x 🚀 |
同一台电脑,同一个模型,只改了两个参数,性能提升8.7倍。
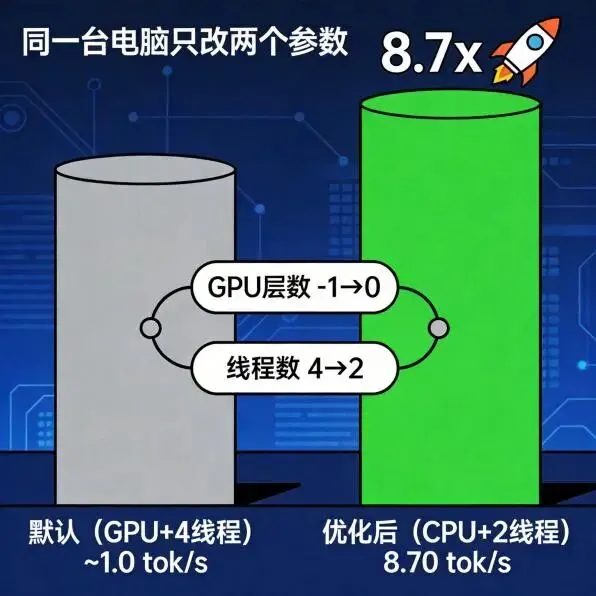
图 4 默认 vs 优化后:GPU层数 -1→0、线程数 4→2,性能提升 8.7 倍
六、这个发现意味着什么?
规律一:匹配物理核心数,不要迷信超线程
这个规律不只适用于 MacBook。在其他平台部署时也可以参考:
平台 | 物理核心 | 建议线程数 | 原因 |
MacBook(i5-5250U) | 2核(4线程) | 2 | 超线程负优化 |
RK3576 | 4×A72 + 4×A53 | 4(只用大核) | A53小核对LLM贡献低 |
AIBook | 12核 A78 | 12(需实测拐点) | 过多线程有调度开销 |
建议:在RK3576 板子上,把 llama-server 的 -t 8 改成 -t 4,只使用4个A72大核,很可能比现在快。
规律二:GPU加速要看硬件能力,不要想当然
判断一块 GPU 能否有效加速 LLM 推理,看两个硬件指标:
•是否支持矩阵乘法加速(simdgroup matrix mul)
•是否有张量核心(tensor core)
如果都没有,GPU 加速大概率是负优化。RK3576 板子上的 Mali GPU 也是同样的情况——之前实测显示 Vulkan 后端比纯 CPU 还慢,原因就在这里。
规律三:端侧测评的核心是“匹配”
端侧部署最忌讳的就是“照搬云端经验”。云端服务器有高带宽内存、有张量核心GPU,参数怎么设都行。但端侧设备资源受限,必须精确匹配硬件能力:
•线程数匹配物理核心
•GPU层数匹配GPU能力
•量化精度匹配内存带宽
匹配,才是端侧部署的第一原则。
七、测评方法论总结
经过这几周的折腾,我把端侧模型测评的要点总结为四个维度:
1. 硬件兼容性测评
•模型架构与推理后端的版本匹配
•库版本一致性(避免ABI不兼容)
•libc环境匹配(musl vs glibc)
2. 性能测评
•生成速度(tok/s)
•Prompt处理速度
•首Token延迟(TTFT)
•内存峰值占用
3. 参数调优测评
•GPU层数扫描(找到最优卸载量)
•线程数扫描(匹配物理核心)
•batch size扫描(找到最优批处理)
4. 工程适配测评
•不同后端的稳定性差异
•环境干扰因素
•系统集成问题
八、给端侧开发者的三个建议
第一,先测基线,再谈优化。不要一上来就开 GPU、开满线程。先用最保守的配置(纯CPU、单线程)跑一个基线,然后逐个参数调整,观察每个参数的实际影响。很多时候,你以为的“加速”其实是“减速”。
第二,用数据说话,不要凭直觉。“GPU肯定比CPU快”“线程越多越好”——这些直觉在端侧往往不成立。写一个扫描脚本,把每个参数的几组取值都测一遍,用数据做决策。
第三,匹配硬件,不要照搬经验。每块设备的内存带宽、核心数、GPU能力都不同。云端的最佳配置,搬到端侧可能是最差配置。端侧部署的核心能力,就是精确匹配硬件。
最后,回到测评本身。
端侧大模型测评,测的从来不只是模型本身。它测的是你对硬件、系统、环境的综合理解。
而这,恰恰是端侧 AI 最有意思的地方。
