VIDEO / 三种生产路线
同样是“用 AI 做视频”,有人让模型直接拍出镜头,有人写代码控制每一帧,还有人把固定流程交给智能体批量执行。工具可以混用,但三种方法解决的问题不同。
这篇给零基础读者做一张路线图。每条路线配一个从素材到成片的示例。先看你要控制什么,再决定打开哪个工具。
本文评测范围是三种常见生产方式和本期三支样片;没有逐一测试全网平台,也不对各家模型做排名。
代码驱动:用 Remotion 或 HyperFrames 写出画面、字幕、时间线与转场,再渲染成视频。它适合可重复修改的知识短片、数据动画和产品演示。
提示词驱动:用文字加参考图片、音频或视频,让模型生成一个镜头。它适合真实摄影难拍到的氛围、动作与想象场景。
智能体驱动:先把选题、分镜、素材、生成、检查与导出写成固定流程,再让智能体按规则调用工具和视频模型。它适合已经验证过的广告、漫剧等系列化生产。
三条路线可以接在一起。一条片子可以由模型拍氛围镜头,代码负责片头和字幕,智能体负责重复执行。分工越明确,返工时越容易找到该改哪一步。
第一个案例做一条 8 秒的知识短片。底图由 imagegen 生成,是一张带剪辑工作台的静态画面。Remotion 把它放进分镜,并让“分镜、排版、节奏”三个词按时间线接力出现。
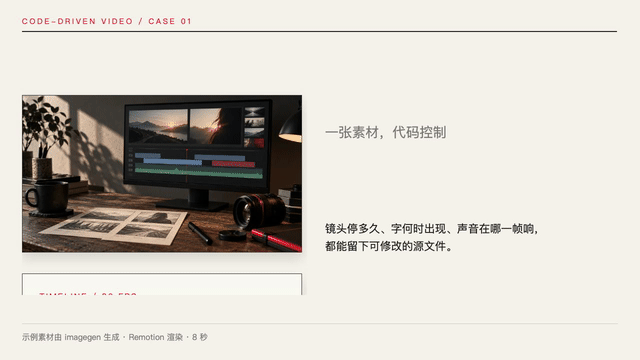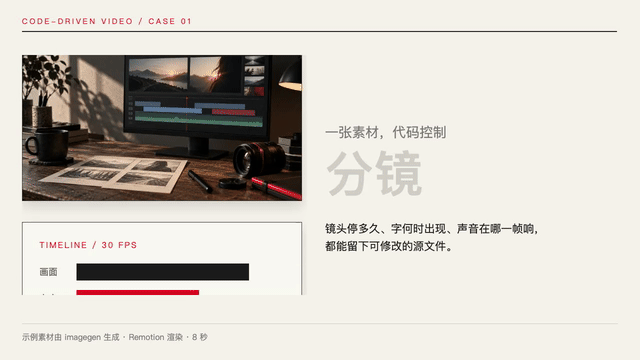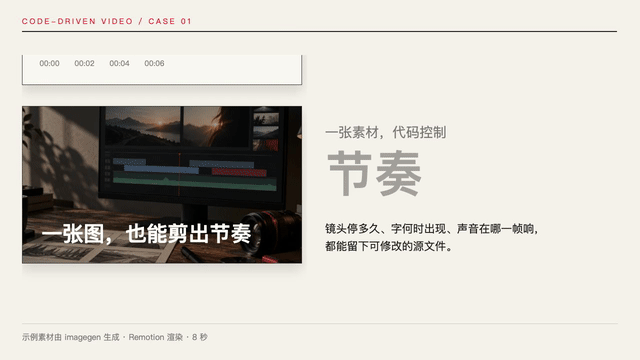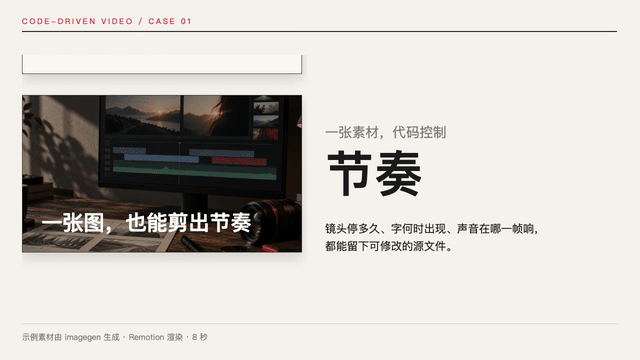
图 1 | 代码控制的短片:一张素材经过分镜、排版与节奏安排
这条片把每个决定写在源文件里:第几帧切换画面,字幕出现多久,素材怎么裁切。想把“排版”延后半秒,改时间线后重新渲染即可。
入门时不必自己逐行写代码。可以把图片、文案和分镜要求交给会写代码的智能体,让它生成 Remotion 或 HyperFrames 工程。
交付时要拿到源文件和素材。只拿到 MP4,就失去了这条路线最大的优势。
实际操作分三步。先给一张有主角的图或一段录屏;再写每个镜头要表达什么、停多久;最后让智能体渲染 MP4 和关键帧,自己检查字幕、切点和结尾停留。
用这张图做 8 秒横屏短片。左侧画面只在右侧文字切换时步进。右侧依次出现“分镜、排版、节奏”,每个词停留至少两秒。字幕能单独修改,图片不要烙字。交付工程源文件、图片和 MP4。
我的判断是:代码给的是可编辑性,不自动给审美。字幕层级、留白、运镜速度和声音位置,仍要有人判断。
提示词里最好写出“主体先出现,停留一秒,再推进;字卡落定后留半秒”,而不只是“高级、电影感”。
想积累这种描述能力,可以看 video-shotcraft 的动态镜头库。先挑一个镜头,拆开看画面怎样进入、停留和退出,再把动作写进自己的分镜。
这个案例参考了其中的词语接力与胶片步进方法,并按本篇素材重新做了版式。
Remotion 用 React 编写视频;HyperFrames 则把 HTML 逐帧渲染成视频。对零基础读者,二选一就够了。
先选顺手的工具,把第一条片做完。
第二个案例选雨夜书店。它需要雨滴在玻璃上滑动、路面反光和暖灯的微妙变化,正是视频模型擅长补足的运动信息。
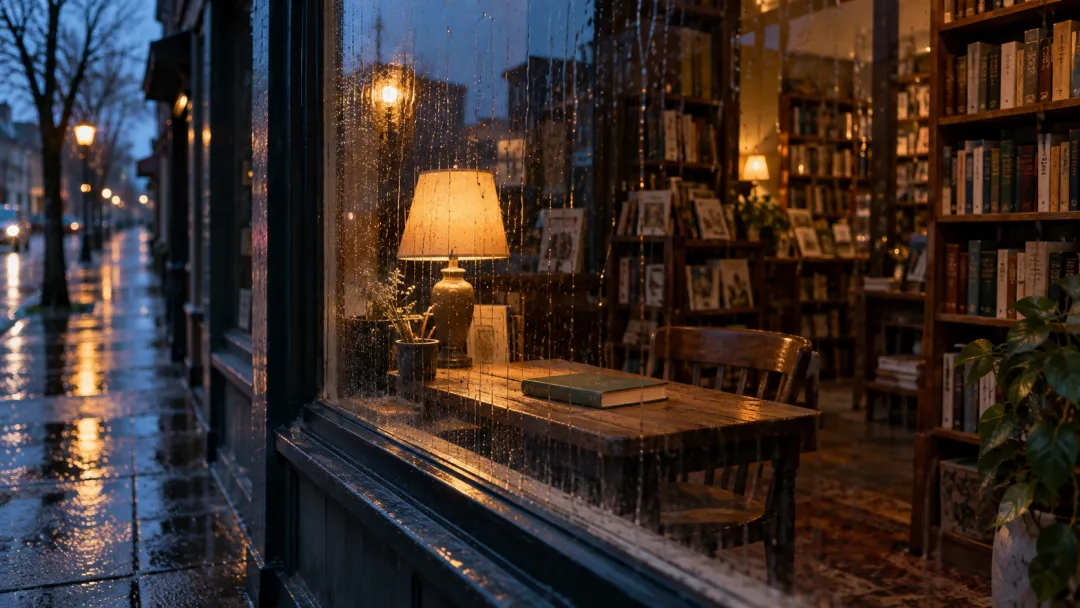
图 2 | 雨夜书店参考图:后续交给视频模型生成镜头
起点是一张 imagegen 生成的参考图。给视频模型的指令尽量描述可看见的动作,并把镜头限制在一个场景里:
以参考图为画面主体。0—2 秒,固定镜头看雨滴沿玻璃缓缓下滑;2—5 秒,镜头轻微向书店内推进,暖灯和书架保持位置稳定。
5—8 秒,焦点落到桌上的合上书本,街面反光仍留在画面左侧。保持黄昏蓝色与室内琥珀色对比。
不出现人物、招牌文字、额外家具或突然的镜头切换。只保留雨声与安静室内环境声。
上面是便于阅读的中文版本。实际接口提交了同内容的英文提示词,并用 [Image1] 指向参考图;在即梦网页端可用 @图片1 绑定素材。
这次生成的 8 秒画面从橱窗外缓缓推向桌上的书。抽查四个时点,暖灯、书架和书本仍可辨,画面没有突然冒出人物;玻璃雨痕与街面反光保留了夜雨气氛。
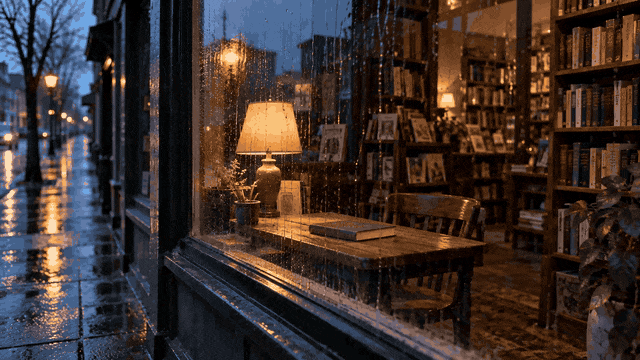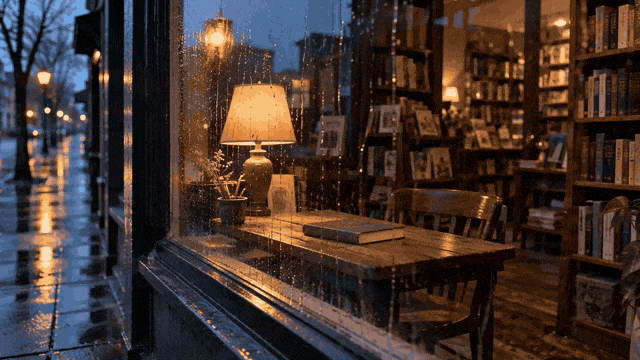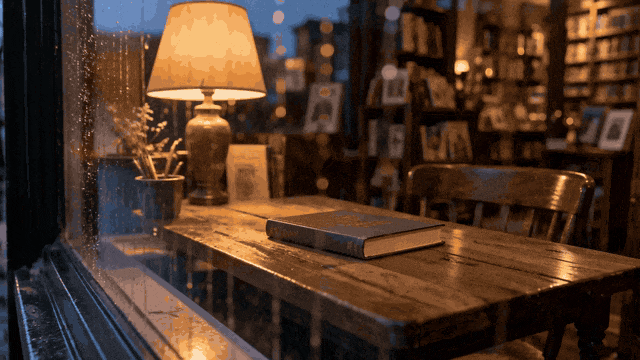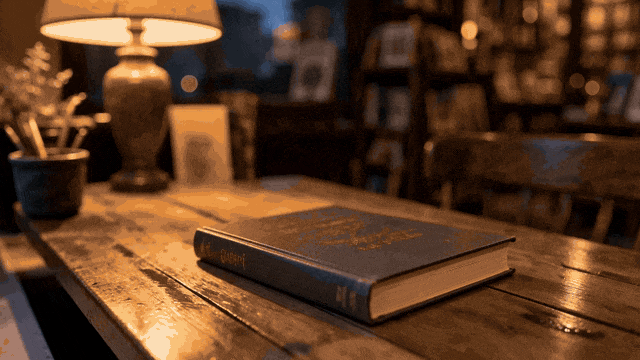
图 3 | Seedance 2.0 生成的雨夜书店镜头动态预览
即梦、可灵都提供文字或图片生成视频的入口;小云雀和TapNow也把创作流程做得更像智能体。
平台越来越会帮人规划镜头,但我仍会把主体、动作、镜头、时长和禁止变化写清楚,再逐镜头检查。
按我现在的使用经验,平台自带 Agent 能较快给出一个可看的版本;镜头里哪处该停、哪处该剪,手动逐段调整通常更贴近想要的质感。这是创作判断,不是对这些平台做过同条件的大样本排名。
照着做时,先上传参考图,再输入上面的时间段指令,只生成一个短镜头。
这里的取舍是:模型能给静态图补运动与光影,也可能把书架、书本或灯的位置改掉。需要准确展示真实商品、真实界面或一段确定的操作时,先拍摄、录屏或用代码排版更稳。
第三个案例做一支虚构茉莉茶广告。茶瓶由 imagegen 生成,没有真实品牌与售价。创意方向和验收标准先由人定好,再由智能体执行固定流程。
先把流程锁成五步:读取产品资料,生成三镜头脚本,准备产品参考图,调用视频模型,检查瓶型与标签区域是否稳定。通过检查才导出;失败就回到有问题的镜头,不整支重做。
给智能体的任务可以这样写:
用同一套 8 秒茶饮广告结构制作本期视频。镜头一,产品静置在石台上;镜头二,微距拍瓶身冷凝水和茉莉花;镜头三,回到完整瓶身并留出文案空间。
产品外形以参考图为准,标签保持无字。每个镜头只做一次清楚的相机动作。
生成后检查瓶型、瓶盖、标签和花朵位置;若变化明显,标记该镜头重做。交付视频、参考图、使用的提示词与检查记录。
这次智能体按固定流程整理参考图与提示词,通过 Seedance 2.0 参考生视频接口提交一次生成,再检查成片关键帧。瓶子从全景到特写又回到全景,瓶盖和无字标签在抽查帧里保持一致。
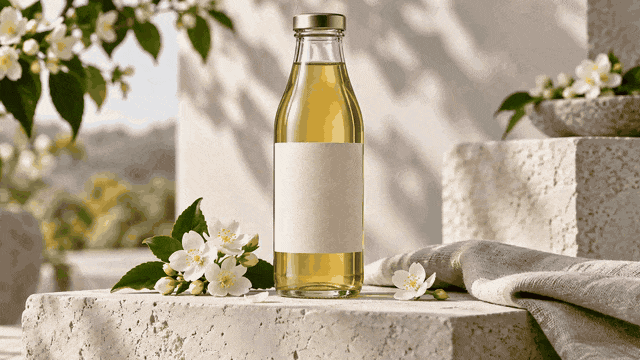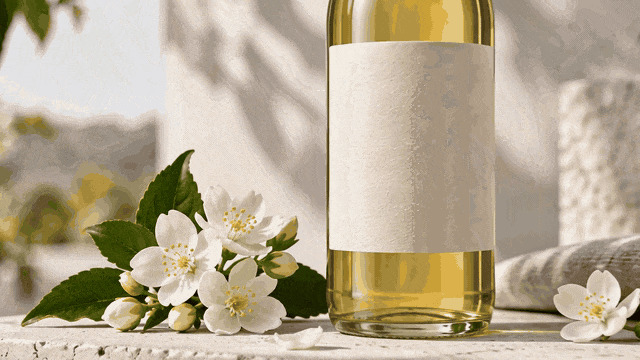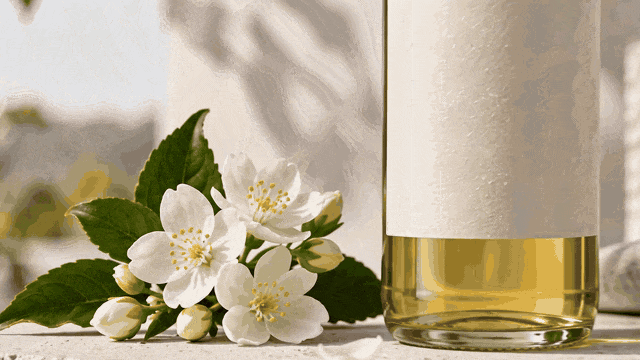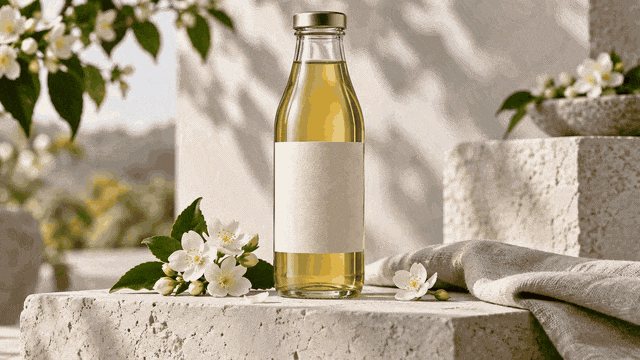
图 4 | 智能体按固定流程制作的虚构茉莉茶广告动态预览
这种方式适合已经跑通的固定生产模式,例如同结构的广告片、角色与场景稳定的系列漫剧。把决定写成模板后,智能体可以替换输入、批量创建任务,也可以按计划定时制作。
初次搭建时,先自己完成一支样片,再把通过的提示词、镜头长度和检查项存为模板。第二次只改产品资料;若改完仍能过检查,才值得接上批量或定时执行。
代价是前期得把“合格”写清楚。若品牌调性、分镜节奏和允许变化的范围都没定,智能体会把含糊之处变成一串自动生成结果。数量多了,返工也会批量放大。
改字和改时间点:代码路线最直接,改源文件再渲染即可。视频模型通常要重新生成或二次编辑。智能体能替你重复操作,但底层镜头若不稳定,自动化无法保证它变稳。
拍出自然运动和光影:视频模型适合雨、风、人物动作这类动态画面。代码可以组合摄影、录屏和模型镜头,但静态图片不会因为“用了 Remotion”就自动出现真实运动。
持续生产同一栏目:智能体的收益来自复用已经通过检查的流程。只做一支片时,先手动完成通常更快;要每周改商品、改文案或批量做系列,再把重复步骤交给它。
最容易开始的是提示词路线。最容易精确返工的是代码路线。最值得批量复制的是模板已经跑通的智能体路线。
先做一条有明确主角和动作的 5—10 秒视频。想要氛围与真实运动,用提示词路线;想改字幕、版式和时序,用代码路线;已经反复做同类型片子,再把通过的步骤交给智能体。
三条路线的共同底线是保留素材、提示词和源文件,并用成片检验。生成成功只说明文件出来了;观众能否在前几秒看懂主体,还得回到画面里判断。
今天就从手头的一张图开始,选上面最合适的一条路线,做一支 8 秒样片。先做完这一支,再考虑同时开几个工具。
想学用 AI 做副业赚钱,来找我
扫码加我微信,聊聊 AI 副业的路子