为什么模型评测是企业AI应用的核心能力,如何进行模型评测?
- 更新时间 2026-09-23 22:25:33
为什么模型评测是企业AI应用的核心能力,如何进行模型评测?模型评测是指通过系统化的方法、指标和场景,对已训练的大模型的功能、性能、安全性、可靠性、伦理合规性等进行全面评估的过程。其核心目标是量化模型的能力边界、发现缺陷、验证有效性,为模型优化、迭代或应用决策提供依据。 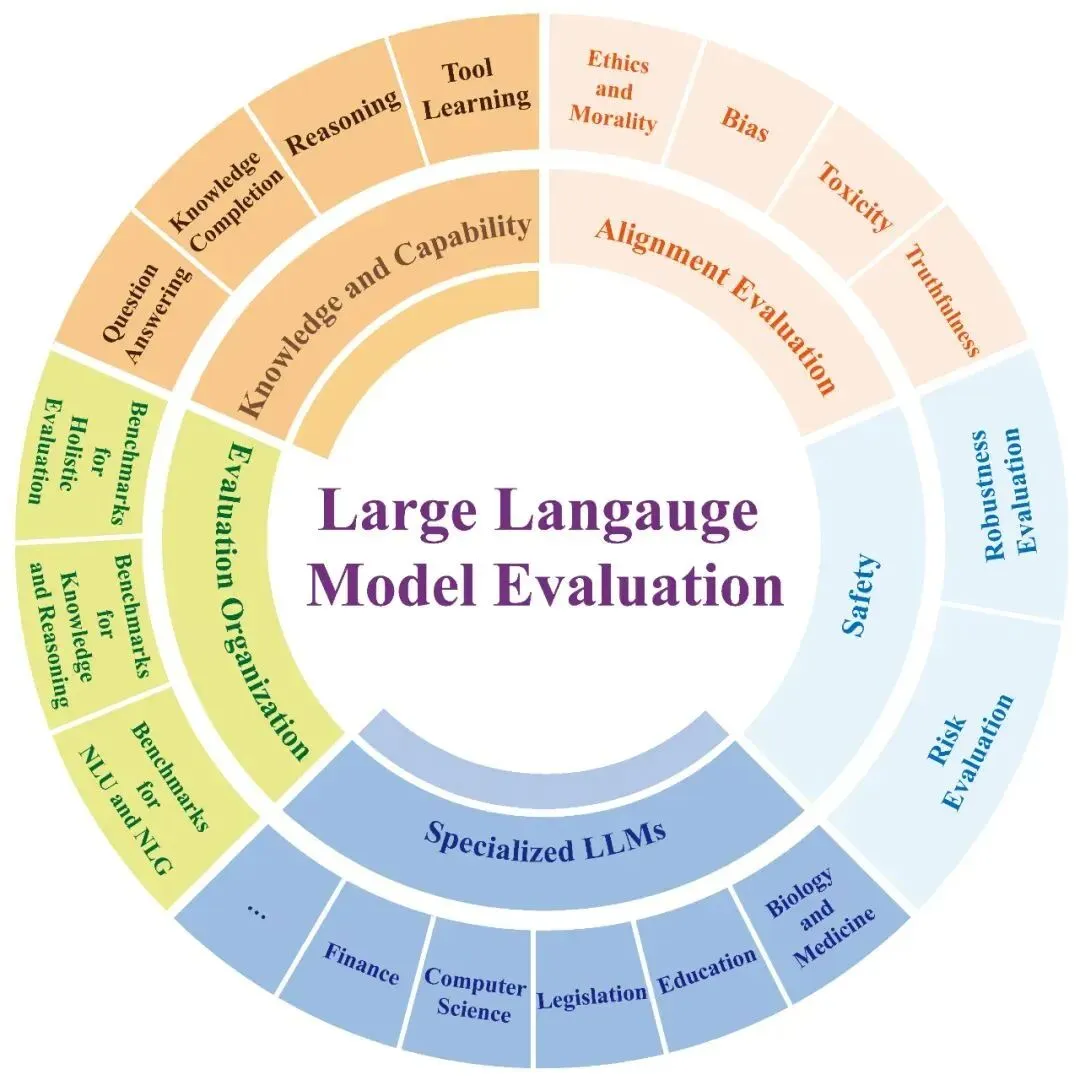
模型评测的价值和作用 从研发视角看: 发布决策:测试大模型的产品质量,验证大模型应用能否解决客户问题,发现缺陷、评估风险、决策能否商用发布 创新改进:度量评估模型能力,为试错创新、训练调优提供改进数据,支撑大模型迭代 从外部视角看: 学术研究:探索和理解大模型能力边界,评估涌现能力及潜在风险 三方测评:benchmark打榜排名 从安全视角看: 安全监管:通过评测确认符合法律法规和社会安全,遵从政府部门监管要求 行业准入:通过大模型行业准入标准测试,得到行业权威机构认证 业界大模型的评估维度 我们对业界大模型的评测框架进行了洞察,包括(HELM-斯坦福、CLEVA-港中大、LLMEVAL-复旦、SuperCLUE-第三方评测机构),总结出他们主要考察如下4个方面: 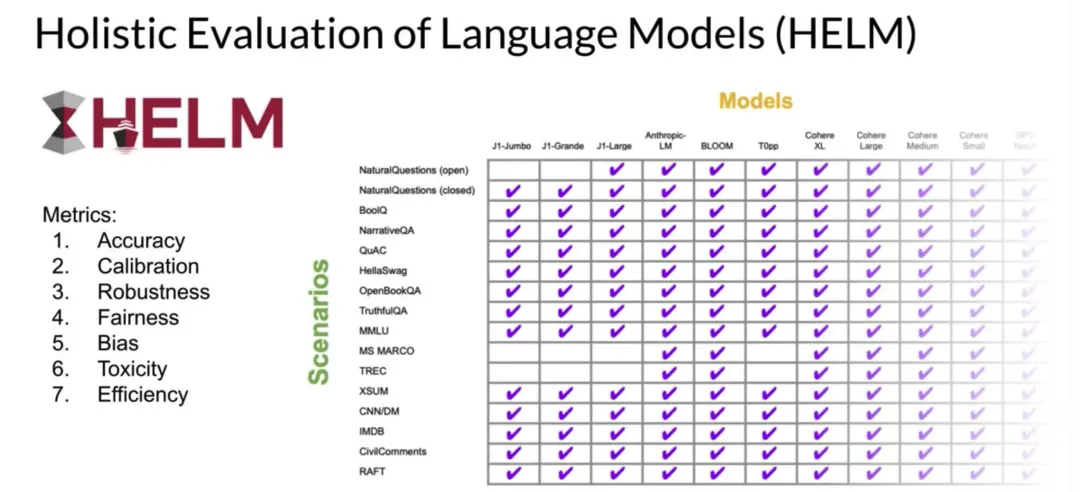
测试数据覆盖什么? 如何定性定量评估? 评测结果如何,采用什么方式排名? 如何给被测模型的推理结果打分? 业界大模型的评估的质量属性 通过对大模型评测框架的调研,我们发现3个业务通用的评估属性\指标,分别为准确性(accuracy)、鲁棒性(robustness)、校准与不确定性(Calibration & Uncertainty)。 准确性(accuracy)是人工智能研究中最广泛的属性,是指所有评估实例中模型的平均正确性(average correctness of model accross all evaluation instances)。如果人工智能系统不够准确,它们就没有用处,这是为什么习惯把准确性等同于基本功能正确性的原因。 鲁棒性(robustness)指的是模型在面对输入的扰动时能保持其性能的能力。例如,一个鲁棒的LLM能够在问题被稍微改写或包含轻微的打字错误、同义词替换等情况下,仍能够正确的回答问题。 校准与不确定性(Calibration&Uncertainty),在高风险的环境中,如决策制定,模型要有能力表达对其预测结果的信心或确定性,模型的不确定性指标可以让人类对可能的错误结果有所预期,并进行适当调整和干预,避免潜在的风险。 大模型评测的底层逻辑 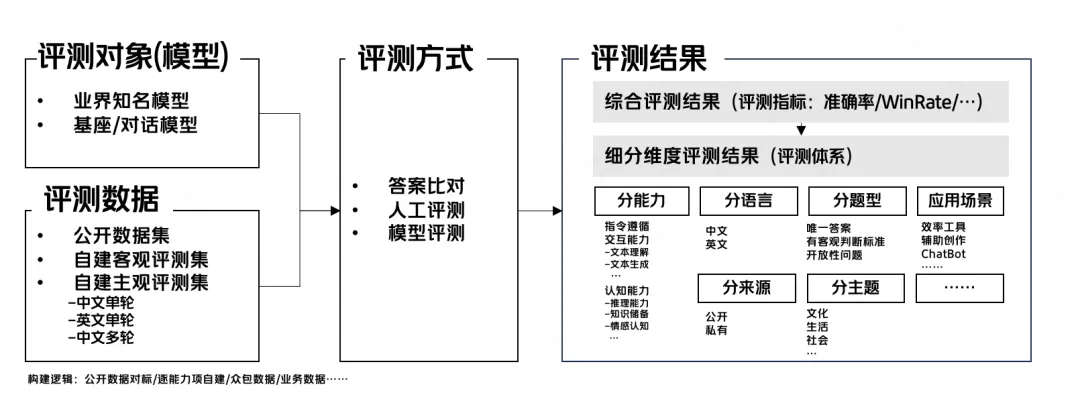
如何进行模型评测,关键在于制定评测标准,也就是评测集。使用标准的测试数据集和度量指标来比较和评估模型。 Benchmarkde的关键你在于“标准”,标准的意义在于统一。没有统一的测试标准,测试结果就没有可比性,更无法基于确定的“基准”评估改进。所以制定好的评测集,是模型评测成功的关键。 如何生成评测集 有确定问答范式的,可以通过脚本批量生成。推荐使用Prompt模版 + 业务场景组合的形式生成问题和答案。 没有固定问答范式的,以人工出题为主。推荐从Agent的回流日志中提取用户问题 + Prompt模版的方式生成问题和答案。 评测类别 绝对评测:对于数据集有参考答案,用模型生成答案与参考答案对比,是一种客观、绝对的评测方式,可以“全自动阅卷”。 度量指标包括正确率/ROUGE/BLEU/EM,Precision/Recall/F1等。 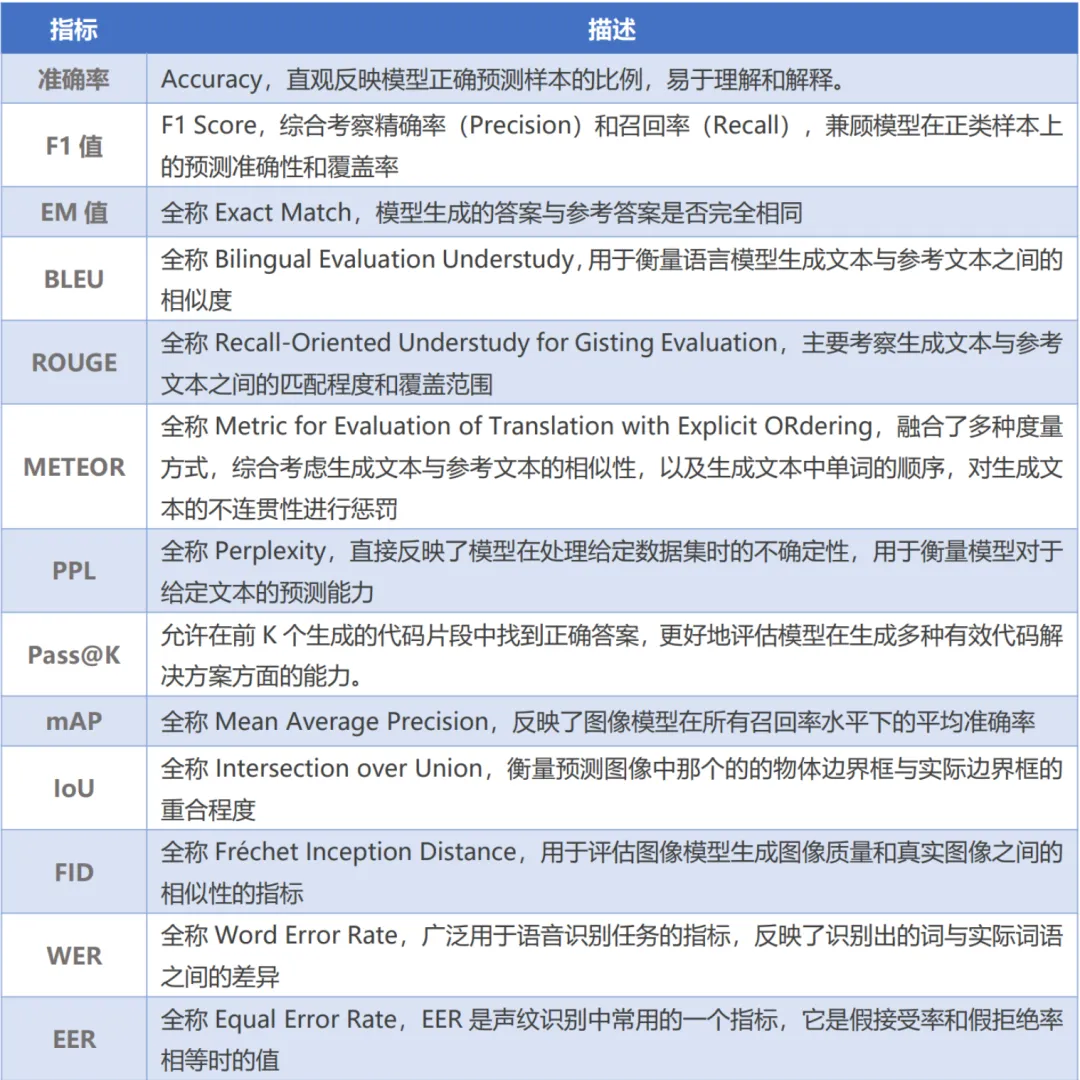
绝对评测用于评估模型在某一特定任务或数据集上的能力表现,使用预定义的标准和指标来量化模型的表现。其目的是提供一个客观的Benchmark标准,评估模型是否达到预期的能力标准。 相对评测:是一种比较不同被测模型的输出,评估模型相对表现的方法。其目的是找出在特定任务或数据集上表现最好的模型,并了解不同模型之间的优劣。例如伯克利LMSYS组织的Charbot Arena。 评测结果分析 评测结果分析是模型评测很重要的一个环节,针对评测出的问题,追溯模型的输出链条,加以修正,是提升模型能力的关键。 除了依靠专家的打分评测外,通常会用到裁判模型(Judged Model),可参考模型评测为什么要使用「LLM-as-a-Judge」?,构建JM自动分析判定被测模型的输出结果,是实现大模型自动化评测的关键技术。
本文来自网友投稿或网络内容,
如有侵犯您的权益请联系我们删除,
联系邮箱:wyl860211@qq.com 。
