AI 画的手指为什么总多一根?56 维评测,这项它只得 20.9 分
- 更新时间 2026-09-23 20:04:21
我在多个略带调侃的讨论群里面,看到越来越多的 AI 生成的六指图片之后,就不禁对这个问题产生了深深的好奇。我一直想找机会搞明白这背后的原因究竟是什么。
毕竟真实世界的数据集里面,六指的比例还是很少的,上次印象深刻的还是 90 年代林青霞主演的老电影六指琴魔。
甚至于早期AI生成的那些图里,手指数量三根、四根、六根、七根都出现过,就是很少见到正好五根。模型能把光影、材质、皮肤纹理都画对,偏偏栽在「数」上。
为什么它连「人一只手五根手指」这种常识都学不会?
画错的那只手,损失更低
我一开始一直以为是他没有从训练人员给他提供的数据里面学会,人类正常只有 5 根手指头这件事,后来仔细一想才发现,它的训练目标里面,就没有一般人认为的常识这两个字,一切还得回到数学上来。
生成模型的训练目标,说到底就是逐像素比差距:把加噪的图还原回原图,每个像素差多少就罚多少,这套算法叫均方误差。
而均方误差的最优解只有一个,叫条件均值。
翻译一下:当模型不确定该画哪一只手指时,它不会挑一个,而是把所有可能答案平均一遍。
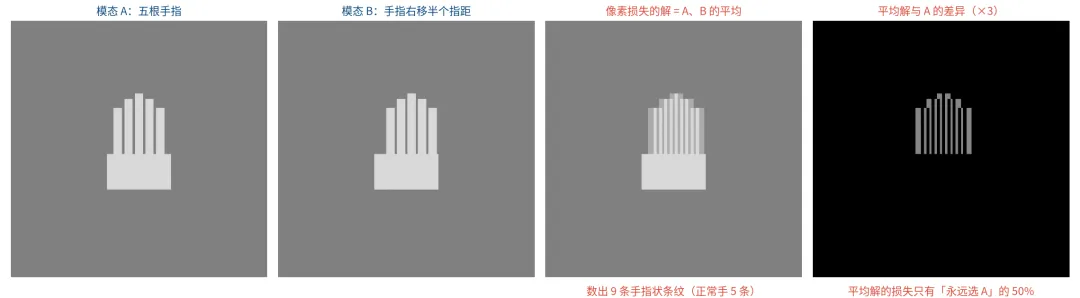
我把这件事做成了一个能看的小实验。同一只手,两种都合理的手指布局,第二种整体右移半个指距(10.56 个像素),各占一半。用均方误差训练一个小模型,再看它在「一半一半」的地方输出什么。
结果它输出的就是两者的平均,与解析平均的差异只有 0.0005。在这个平均解上数手指状条纹,数出 9 条——正常手是 5 条,多出来的 4 条是鬼影。
更关键的是损失:这个平均解的损失,只有「永远画其中一只」的一半(50.0%)。
换句话说,画错的那只手,在损失函数里更划算。所以模型不是学不会数手指,它压根没在数。多出来的手指,是平均出来的“鬼影”。
一根指缝的预算
我之前还只是认为,分辨率仅仅会影响到细节是否足够清晰,真没有想到,它甚至可以决定细节上的第六根指头是否会单独被画出来。
第二笔账是像素预算。手要画对,先得让指缝活到模型能看见它的那一刻。
W 是图宽, 是手占画面的比例, 是指缝占手宽的比例, 是 VAE 的压缩倍数——生成模型不会逐像素作画,它先把图压进一个很小的 latent 空间,画完再解码回像素。
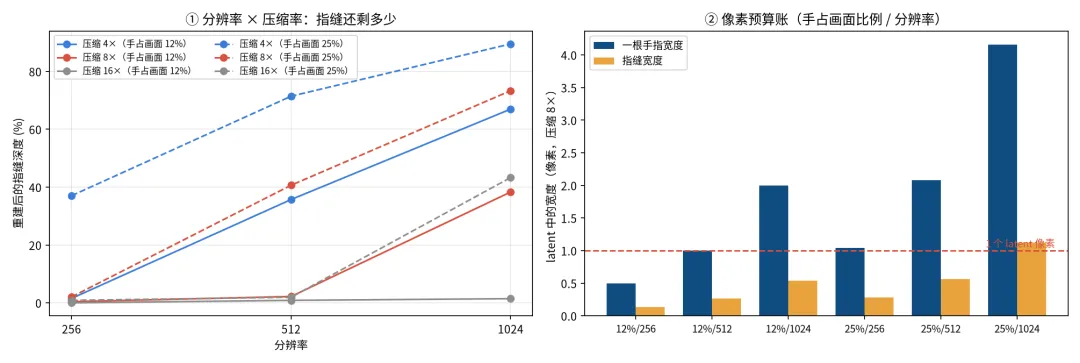
代进数字:512 分辨率、手占画面 25%、指缝占手宽 3.5%、压缩 8 倍,指缝在 latent 里只剩 0.56 个像素。
我在合成的「手」上量了这件事(用块平均加双线性上采样模拟压缩与解码)。指缝在 latent 里不足 0.3 个像素时,重建后的指缝深度只剩 0% 到 2%,100% 的样本缝被填平。
0.54 个像素时深度是 36% 到 41%,92% 的样本被填平。要涨到 1.1 个像素,缝才保住 67% 到 73%。
2026 年的最新情况也在这里。
注意到分辨率从 512 涨到 2048,翻了 4 倍;VAE 压缩从 8 倍提到 16 倍,砍掉一半,净效果是手部的 latent 像素也翻了一倍。
特写里手占画面 25%,指缝有 1.12 个 latent 像素,缝还在。但远景、合影里手只占 12%,指缝只剩 0.54 个像素,92% 的样本缝被填平。六指在特写里少了,在远景里还在。
一打分就现原形
那 2026 年的模型到底怎么样了?
今年 5 月,阿里的 Qwen 团队放出一份面向创作者的生图评测 Qwen-Image-Bench:1000 条提示词、23 个二级能力、56 个可核查维度,由专业标注员训练的打分模型逐项打分。
结果里最扎眼的是,56 个维度里最低的一项叫解剖保真度——最好的模型也只有 20.9 分(满分 100)。
同批崩塌的还有物理逻辑 31.9、物体 41.9、动物 42.6、接触交互 43.3。而总分第一的 GPT Image 2(OpenAI 的生图模型)是 64.7。
论文自己给的结论是:模型擅长复制表面的纹理,却在需要结构、生物、物理这些看不见的内隐知识的地方集体崩塌。
更能说明问题的是厂商自己。
Qwen-Image-2.1(阿里 9 月 20 日刚开源的生图模型)、Seedream 5.0(字节)、GPT-Image 2.5(OpenAI 9 月 8 日发布)是 2026 年三家旗舰,官方能力清单里没有一家强调可以画好「手」。
手部专项评测 HandEval 到 2025 年 10 月才出现,且只覆盖了 10 个 2025 年的模型。至今没有任何一手评测,给过 2026 年旗舰的手部准确率。
经过很多新闻媒体的屡次三番嘲弄,我本来以为做图像生成的模型厂商从正面解决了这个问题。
但是这组数字让我意识到,其实还没有人正儿八经的把它加入到打分体系里面去,也许是这样违背常识的地方太多了点,导致没法加?还是说这个问题本身就没那么容易解决?
行业的答案:给手单独修、单独评
既然通用模型没解决,行业的做法是把手拆出来单独处理。
HandRefiner(2023 年 11 月)是一个专门修手的模型。它把手部区域的 FID 从 158.34 压到 147.52,检测置信度从 0.934 提到 0.944。FID 衡量的是生成图和真实图的分布差距,越低越好。
100 张修补图里 97 张拓扑正确——拓扑对,意思是手指该连的连、该分的分,根数不再错乱。
用户调研里,70/100 更偏好修补版。论文里点题的一句是:没经过手部数据微调的模型,生成的手会多出手指。
RHanDS(2024 年 4 月)走得更远:手部区域的 FID 从 33.84 降到 22.18,关节位置误差从 12.02 降到 9.86,单次修手大约 3 秒、4 GB 显存。
HandEval(2025 年 10 月)则是第一个专门给手打分的评测。
它用了 24,066 对样本,六类缺陷里第二类就是结构冗余,也就是多指。有意思的是,它构造坏样本的办法,是用 HandRefiner 反向退化。
所以答案很清楚:不是通用模型学会了画手,而是行业把「手」拆成了一个专门的子问题,单独修、单独评。
写在最后
下次看到 AI 生成的不符合生活常识的图片,先不要急着用人类的朴素直觉来指责。
因为它根本就不是靠人类的理解来生成图片的。
一句话总结:AI 画错手指,不是它不会数数。训练目标在算平均,像素预算又不够,而它到今天还没被认真打过分。
你最近一次生成的人像,手部出的是什么错?有没有感觉这方面视觉模型有进步了?
觉得这篇把「六指」这笔账算清楚了,点个赞 👍、收藏 ⭐ 备用。关注「数解AI」,AI 的原理慢慢拆解。
📖 视觉生成:生成 30 秒视频要画 900 张图,AI 视频为什么这么贵? → AI 生图好看能到 91.87 分,为什么招牌上的字还是错的? → AI 视频里的字,为什么一帧一个样?10 个模型考下来最高 37% → GAN 一步就能出图,为什么输给了要跑 50 步的扩散? → AI 出图要跑 50 步,为什么砍到 10 步还清晰,砍到 1 步就糊了? → AI 画的手指为什么总多一根?56 维评测,这项它只得 20.9 分(本篇)
🔥 热门文章:
KV缓存存进SSD:慢50倍的硬盘,为什么反而更快?高维空间为什么全是壳?内积才是那把尺子高斯为什么二阶就够?非线性去哪了学习率怎么自动调?Adam 优化器拆给你看DeepSeek-V4为何不用MLA?随机变量为什么不是变量?它其实是个函数生成 30 秒视频要画 900 张图,AI 视频为什么这么贵?AI 生图好看能到 91.87 分,为什么招牌上的字还是错的?AI 视频里的字,为什么一帧一个样?10 个模型考下来最高 37%GAN 一步就能出图,为什么输给了要跑 50 步的扩散?AI 出图要跑 50 步,为什么砍到 10 步还清晰,砍到 1 步就糊了?
参考资料
1. Li, N. et al. (2026). Qwen-Image-Bench: From Generation to Creation in Text-to-Image Evaluation. arXiv:2605.28091(v2,2026-06-25). 1000 条提示词、23 个二级能力、56 个可核查维度;解剖保真度最好成绩 20.9,物理逻辑 31.9、物体 41.9、动物 42.6、接触交互 43.3;总分第一为 64.7。 2. Qwen Team (2026-09). Qwen-Image-2.1(GitHub)与 HuggingFace 权重. 2026-09-20 开源;视觉生成组件 7B(32 层单流 DiT),文本编码器 Qwen3-VL 8B;VAE 为 16 倍空间压缩。 3. Wang, Z. et al. (2025). HandEval: Taking the First Step Towards Hand Quality Evaluation in Generated Images. arXiv:2510.08978(2025-10-10). 首个手部质量评测;HandPair 24,066 对样本;六类缺陷含结构冗余(多指)。 4. HandRefiner: Refining Malformed Hands in Generated Images. arXiv:2311.17957(2023-11). 手部区域 FID 158.34→147.52、检测置信度 0.934→0.944、97/100 拓扑正确、70/100 偏好。 5. Wang, C. et al. (2024). RHanDS: Refining Malformed Hands for Generated Images with Decoupled Structure and Style Guidance. arXiv:2404.13984(v1 2024-04-22 / v2 2025-04-14). 手部区域 FID 33.84→22.18、关节位置误差 12.02→9.86。 6. 本文玩具实验:合成的「手」(掌心加五根手指条),seed 20260923。实验一:两个模态各半时的条件平均(模型输出与解析平均差异 0.0005;条纹数 5→9;损失比 0.50)。实验二:指缝预算(块平均加双线性上采样模拟压缩与解码)。代码 run_experiment.py,数字results.json。
