理解 GEO 的关键,在于理解大语言模型判断“什么值得引用”的底层机制。
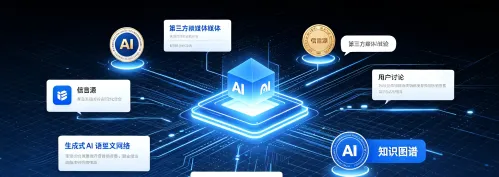
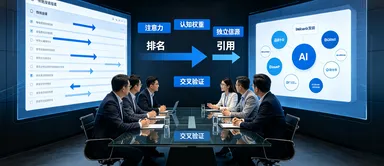
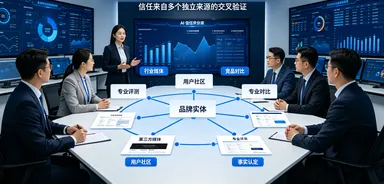
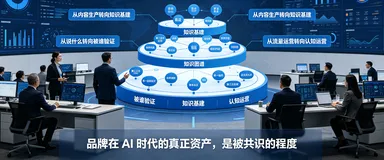
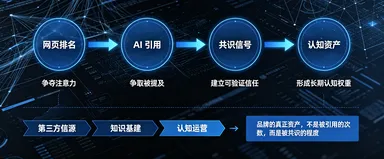
大语言模型在生成答案时,并非在“评判”品牌的好坏。它做的是一个更朴素的动作:在训练语料和实时检索结果中,寻找那些被多个独立来源反复交叉验证的信号。 当 AI 在互联网上看到来自数千个受信任的人类声音围绕一个品牌达成共识,并捕捉到这些高参与度、带有“人类特征编码”的信号时,它对品牌的认知才会从“营销说辞”转变为“事实认定”。
这意味着一个被大多数品牌忽略的事实:AI 的“信任”本质上是一种共识信号,而非品牌自证的权威。
品牌官网写得再漂亮,Slogan 打磨得再精妙,如果这些内容只存在于品牌自有的传播渠道中,在 AI 的认知框架里,它们的权重极低。AI 更看重的是品牌“走出去”之后,在第三方语境中留下的痕迹:行业媒体如何描述你,用户在社区中如何讨论你,专业评测如何将你与竞品对比,甚至竞争对手的客户在比较时如何评价你。
这也解释了为什么 GEO 领域出现了一个反直觉的现象:一些在传统搜索中排名并不靠前的品牌,反而更容易被 AI Overviews 频繁引用。宠物食品品牌 Freshpet 就是一个典型案例——它的产品在相关查询中并未占据自然搜索的头部位置,但 AI Overviews 却持续以品牌名称进行引用。原因在于 Freshpet 在内容结构、权威信号、用户参与度等多个维度上构建了 AI 可以验证的“信任信号”,而非依赖单一渠道的排名优势。