AI评测框架 |「AI * 传播」读书会第二季第十二期
- 更新时间 2026-09-23 17:05:14
导语
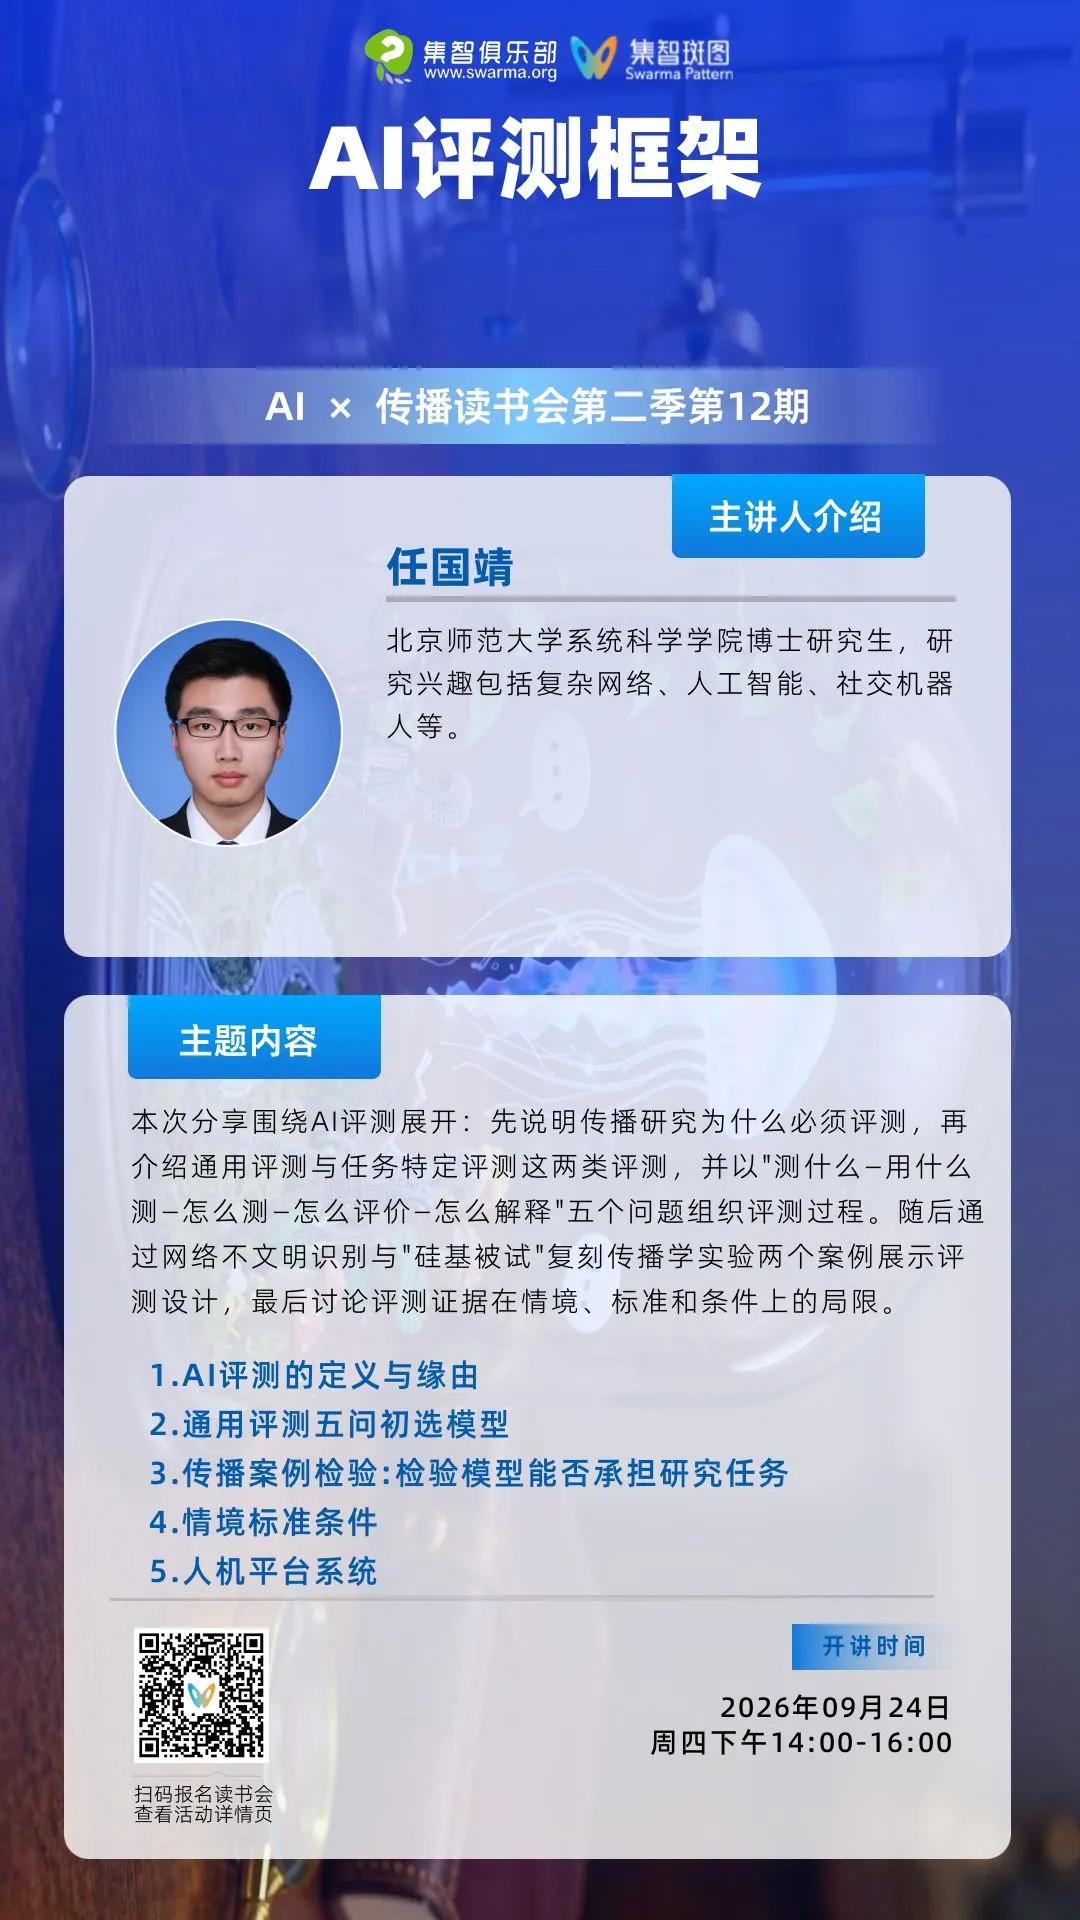
本期「AI × 传播」读书会第二季第十二期,北京师范大学在读博士研究生任国靖将聚焦“AI评测框架”这一主题进行分享。本期读书会聚焦大语言模型深入传播研究后的问题:其输出随提示词、参数与版本波动,“模型很强”不等于“测量可靠”。读书会以“测什么—用什么测—怎么测—怎么评价—怎么解释”五问组织AI评测,并结合案例讨论其证据局限。
集智俱乐部联合北京师范大学新闻传播学院许小可教授、北师大珠海校区计算传播学研究中心周晓禹老师共同发起「AI 传播」读书会第二季。读书会立足工具—对象—范式三重核心维度,完整搭建AI与传播交叉领域学习体系:拆解AI作为传播研究工具的实操方法、剖析AI作为新型传播主体的社会影响、探索人机协同驱动的传播学全新研究范式,一站式理清三大核心议题:如何借助AI开展传播研究、如何将AI本身作为传播研究对象、如何把握人机协同带来的学科变革。

报告简介
报告简介
大语言模型和多模态模型已广泛用于内容编码、文本分析和实验模拟,也成为传播研究的对象。但模型输出会随任务定义、提示词、运行参数和模型版本变化,其误差还可能传递到变量测量、群体比较和研究结论。因此,"模型看起来很强"不能等同于"研究测量可靠"。 本报告围绕AI评测展开:先说明传播研究为什么必须评测,再介绍通用评测与任务特定评测这两类评测,并以"测什么—用什么测—怎么测—怎么评价—怎么解释"五个问题组织评测过程。随后通过网络不文明识别与"硅基被试"复刻传播学实验两个案例展示评测设计,最后讨论评测证据在情境、标准和条件上的局限。
分享大纲
分享大纲
问题引入:AI评测的定义 为什么评测:AI准确和稳定吗?测到构念了吗?误差会影响结论吗? 通用能力评测:以常用基准说明“测什么-用什么测-怎么测-怎么评价-怎么解释”,怎么初步选择模型? 任务特定评测:以传播学案例说明“构念操作化-分析单位与抽样-编码执行-性信度与效度检验-分析与解释”,模型能否承担研究任务? 评测局限性:情境局限(外部效度)、标准局限(构念与评分的选择)、条件局限(数据污染、模型配置与时效) 小结与展望:传播学理论与评测结合,评测对象扩展到"人—AI—平台"传播系统
核心概念
核心概念
主讲人介绍
主讲人介绍
参考文献
参考文献
时间信息
时间信息
2026年9月24日周四14:00-16:00,腾讯会议线上进行。
感兴趣的朋友下滑扫描二维码报名,加入「AI × 传播」读书会第二季后,可进入学员群进行交流。
报名读书会:
「AI × 传播」读书会第二季
传播学从现象出发。今天,AI 已经深度进入信息生产、内容分发、社会互动、公共判断和知识生产过程。它既是工具,也是媒介;既是研究对象,也是协作者;既提升效率,也制造新的偏见、信任和责任问题。AI × 传播成为一个新的领域。2025年8月至12月,集智俱乐部联合许小可、张子柯、王成军、廖好四位老师发起第一季“AI × 传播学”读书会,吸引了225人报名参与。由来自北京师范大学、南京大学、复旦大学、浙江大学、香港城市大学、深圳大学等高校的15位主讲人,围绕计算叙事、智能传播、人机传播、传播拟真四个方向,绘制了 AI × 传播领域的前沿地图。
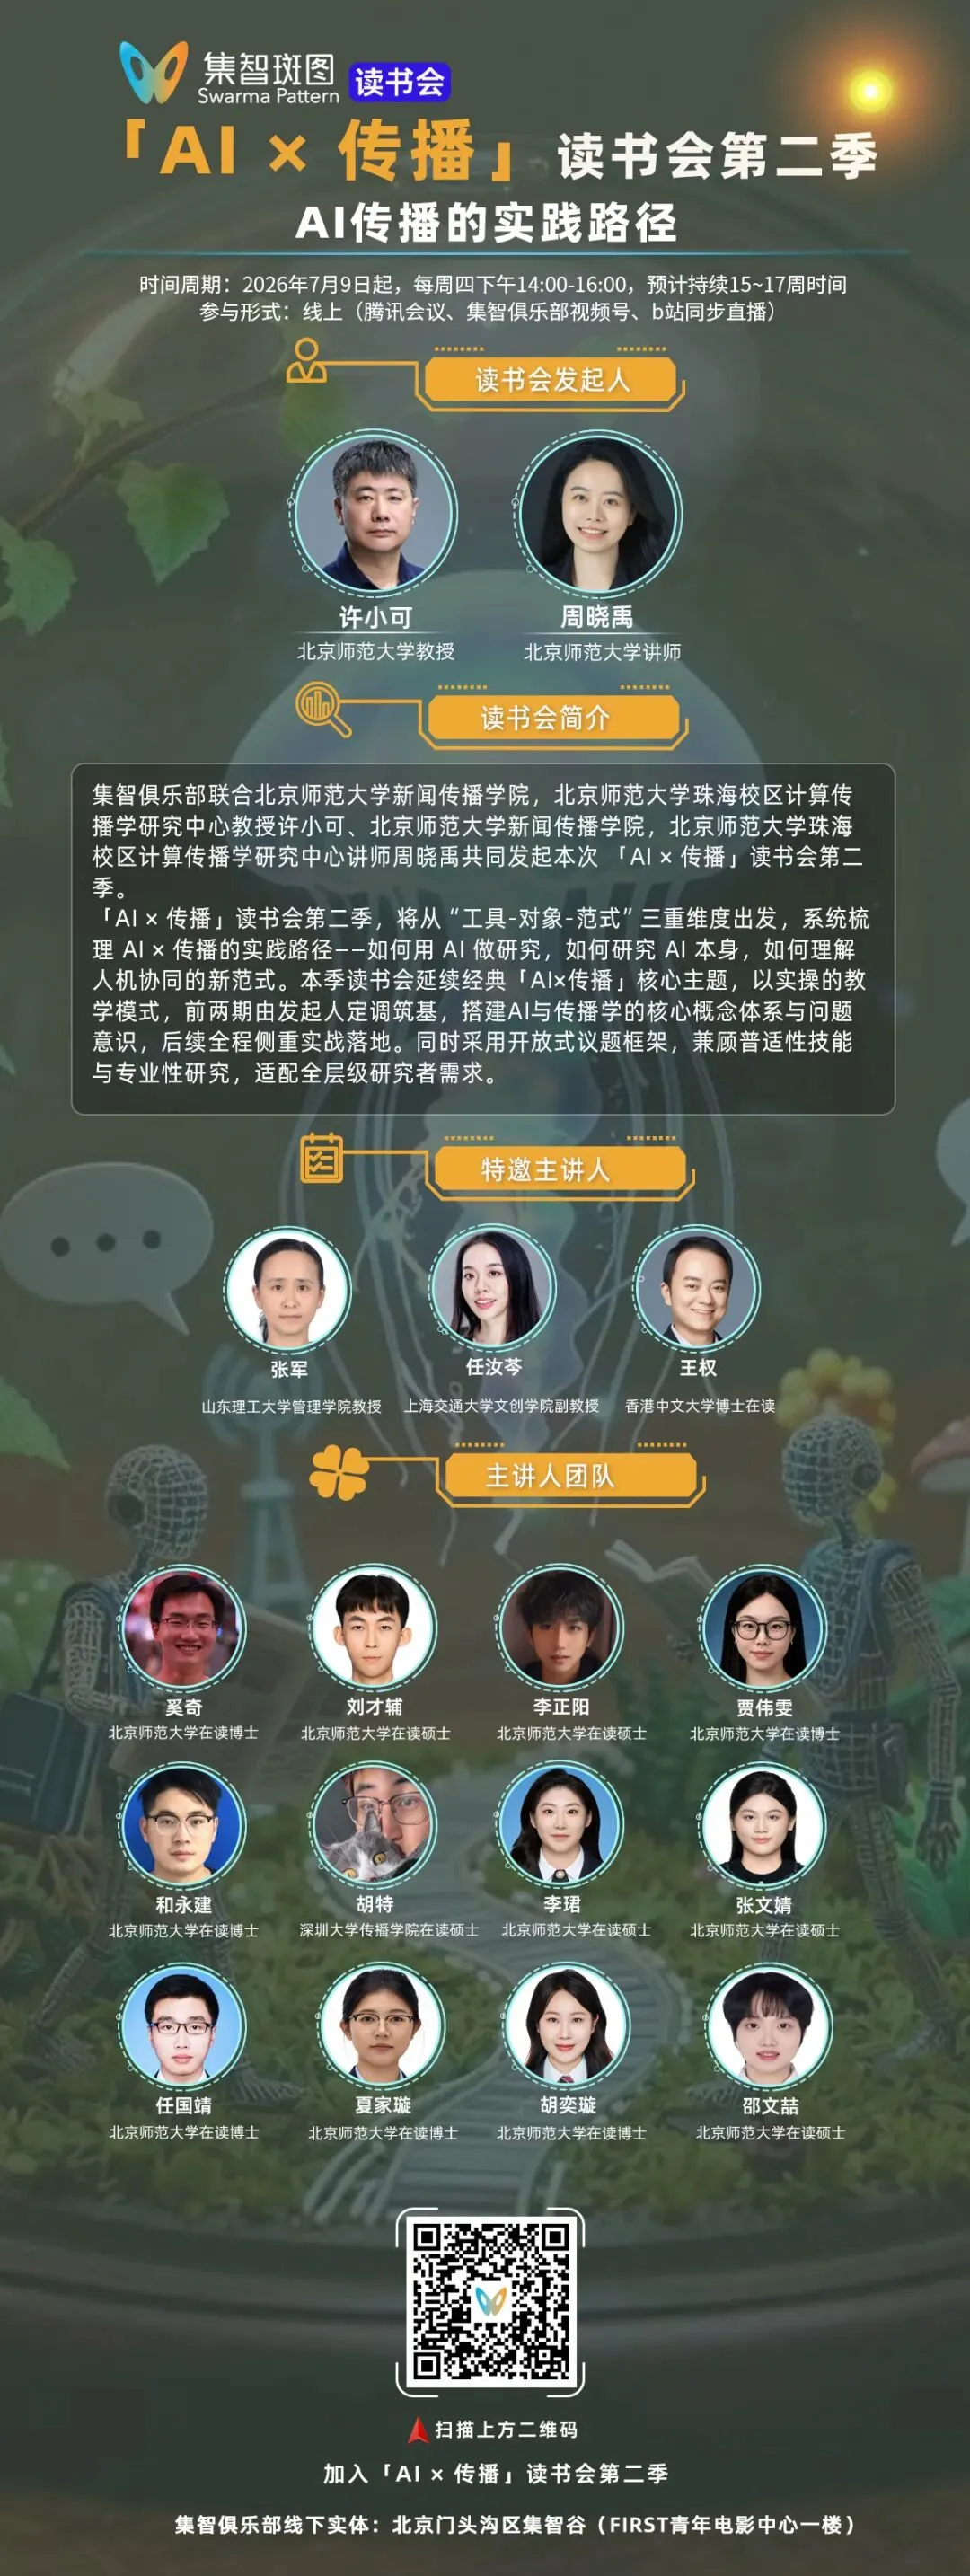
「AI × 传播」读书会第二季由集智俱乐部联合北京师范大学新闻传播学院,北京师范大学珠海校区计算传播学研究中心许小可教授、周晓禹讲师共同发起,我们将从“工具-对象-范式”三重维度出发,系统梳理 AI × 传播的实践路径——如何用 AI 做研究,如何研究 AI 本身,如何理解人机协同的新范式。
扫描海报中二维码报名参加读书会
报名方式:
第一步:微信扫码填写报名信息。
(扫码报名)
第二步:填写信息后,付费报名。如需用支付宝支付,请在PC端进入读书会页面报名支付:
第三步:添加运营助理微信,拉入对应主题的读书会社区(微信群)。
PS:我们鼓励围绕传播学、人工智能及相关具体问题的深入探讨。为保证讨论质量,请避免发表脱离本期读书会主题、缺乏实证基础或过于空泛的哲学思辨类内容。
若讨论内容明显偏离主题,经主持人提醒后仍未调整,为维护整体学习环境,我们将不得不将该成员请出讨论群,并根据其实际参与进度,对未参与部分按比例办理退费。
感谢您的理解与配合,让我们共同营造一个专注、深入、有收获的共学空间。
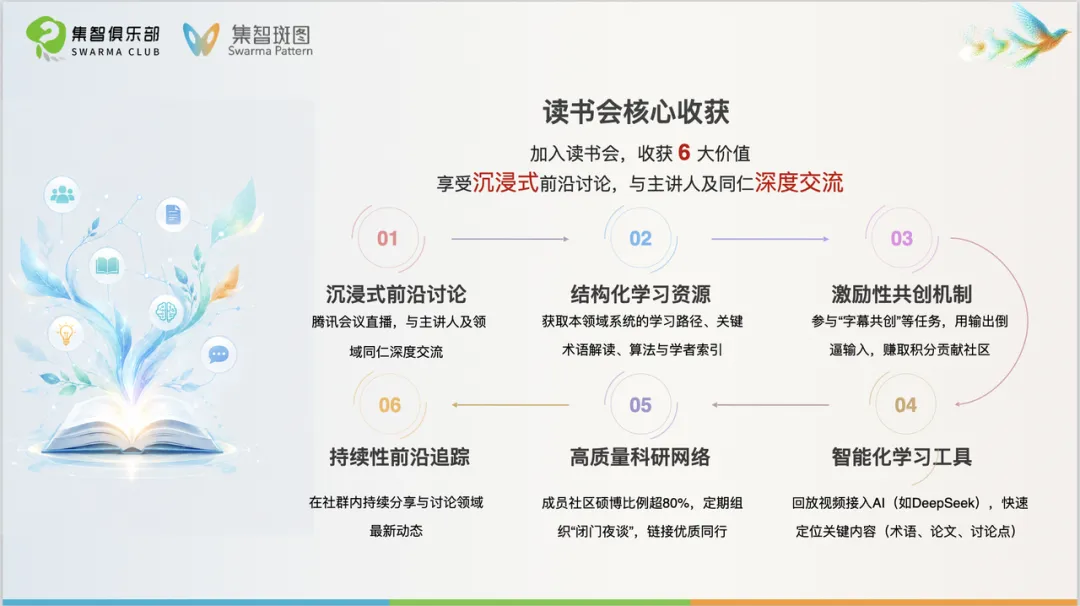
加入社区后可获得的资源
完整权限包括:线上问答、录播回看、资料共享、社群交流、信息同步、共创任务获取积分等。
特色退费与激励机制
我们提供以下两种途径,让您的投入获得实际回馈:
任务达标退费路径
认领并合格完成任意两期字幕任务,即可退还全额报名费,并额外获得集智专属周边奖励。
运营成长激励路径
合格完成一个字幕任务后,可申请成为运营助理。在读书会项目顺利结项后,将退还学费。表现优异者,还有机会获得额外的奖学金。
相关内容推荐
相关内容推荐
1.读书会推荐阅读材料
扫描下方二维码可跳转至集智斑图网站阅读文章:「AI × 传播」读书会第二季读书会推荐阅读材料。
2.往期公众号相关内容推荐
