医学人工智能测评验证联合实验室于2025 年 12 月发布 MedAIBench 初版;2026 年 9 月 17 日,在人工智能促进健康全球倡议 2026 年会(GI-AI4H)上,该实验室进一步发布 MedAIBench 2.0 升级版,连同覆盖 15 大专科专病的测评体系、多模态测评共建计划与公开高质量测评集,2.0 对外公开测评集的学术技术底稿为《MLB: AScenario-Driven Benchmark for Evaluating Large Language Models in Clinical Applications》的论文(arXiv:2601.06193 ,KDD 2026)。另一套同样有代表性的中国医疗 AI 评测体系,是上海人工智能实验室的 MedBench(v4 系统论文 arXiv:2511.14439 与最新 v5 arXiv:2606.24155 同属一条演化链)。
背景:为什么要评测--"知识-实践鸿沟"
要读懂两套基准的差异,先看清它们共同要解决的问题。医学 AI 评测最核心的悖论,可以用一个数字反差概括:在 BRIDGE 基准(哈佛团队构建,arXiv:2504.19467 ;真实电子病历、病例报告、医患对话构建,覆盖 14 专科、9 种语言)上,表现最好的大语言模型得分仅 44.8%(零样本综合分);而同一级别模型在标准化医学执业考试(USMLE 风格)上多处于 84%–90% 区间(部分前沿模型可超 90%)。约 45 分的鸿沟,正是"知识-实践鸿沟"。
一篇纳入 39 个医学 LLM 基准、超 230 万道题、45 种语言、172 个专科的系统综述(Journal of Medical Internet Research, 2025;DOI: 10.2196/84120;PROSPERO 注册号 CRD420251139729)给出量化结论:知识型基准(USMLE 风格)前沿模型准确率 84%–90%,实践型基准成功率仅 45%–69%,安全评估准确率 40%–50%)。该综述明确:自主部署目前缺乏正当性,落地必须强制"实践导向验证 + 强人机协同监督"。
医疗 AI 评测之难,是一连串结构性矛盾:知识-实践鸿沟、选择题饱和与背题假象、数据泄漏与评测污染、幻觉检测的评测者盲区、真实世界分布错配、安全与伦理系统性低分、评测标准碎片化与不可比、静态基准漂移与投机奖励、专科专病覆盖不足。两套基准,正是冲着这些难点从不同路径给出的回答。
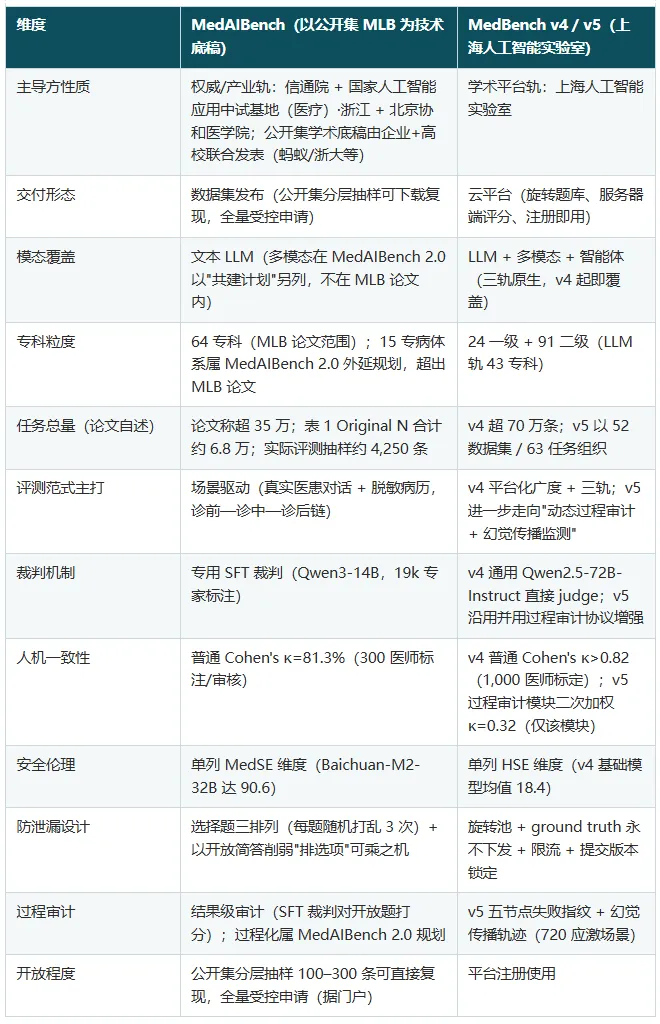
一、两套测评体系速览
二、各自是什么
2.1 MedAIBench
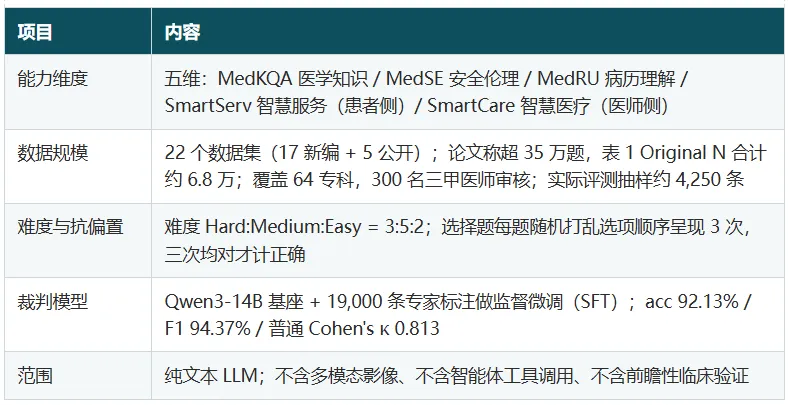
MedAIBench 是由中国信通院、国家人工智能应用中试基地(医疗)·浙江、北京协和医学院共建的权威测评体系(2025-12 初版,2026-09-17 发布 2.0 升级)。其对外公开测评集的学术技术底稿是 MLB 论文(arXiv:2601.06193 ,已收录 ACM KDD 2026,DOI 10.1145/3770855.3817448)。据发布材料,MLB 即 MedAIBench 公开集的底座;但 2.0 与专科/多模态规划是其上的工程化与生态化扩展,论文并不同于整个 MedAIBench 体系。
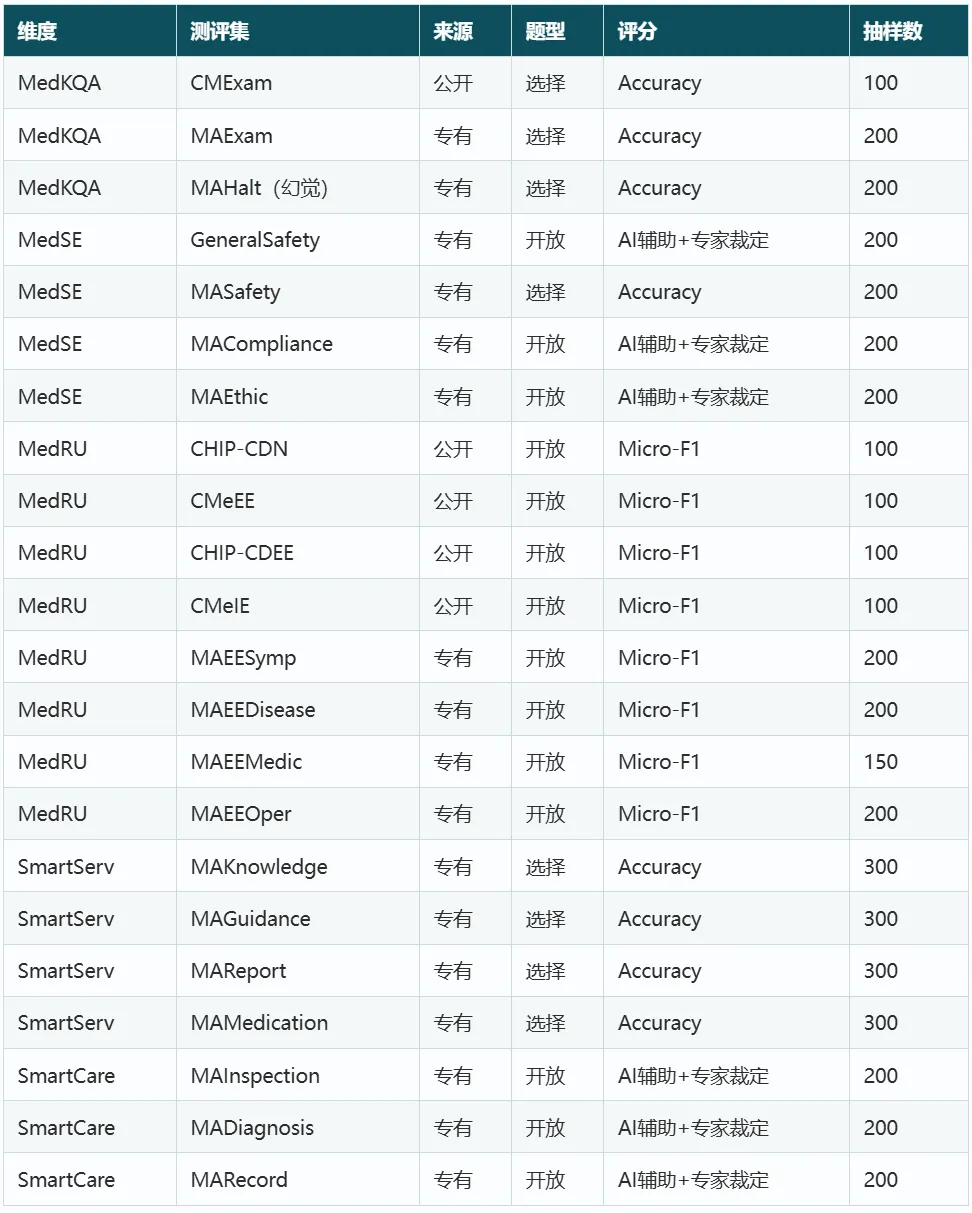
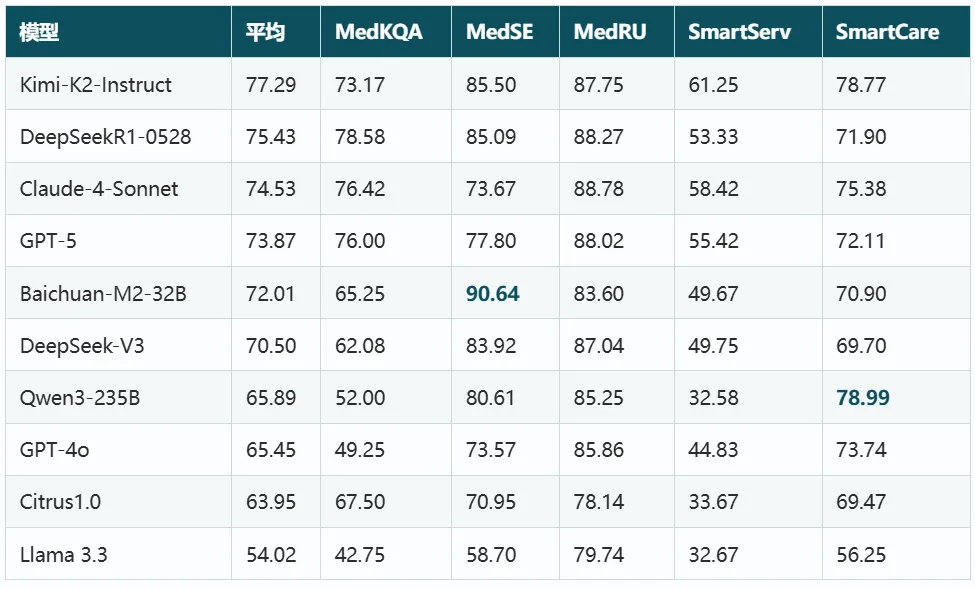
MLB 的 22 个测评集完整清单、10 个模型的五维表现,见文末附录。其关键发现:① 患者侧场景 SmartServ 普遍塌陷(榜首仅 61.25,多低于 55),但 4 个集全为选择题,该鸿沟部分可能来自题型设计,非纯互动失败,不应过度外推为模型不会与人交流;② 病历理解 MedRU 普遍成熟(头部 85–88);③ 安全对齐与规模解耦(Baichuan-M2-32B 仅 32B 在 MedSE 达 90.64);④ 架构特长可分解(如 Qwen3-235B 居 SmartCare 首、DeepSeekR1 居 MedKQA 首);⑤ GPT-5 较 GPT-4o 为四维升、一维(SmartCare)降,均分提升,非全面;DeepSeekR1 对 DeepSeek-V3 五维全升。
2.2 MedBench (v4 → v5)
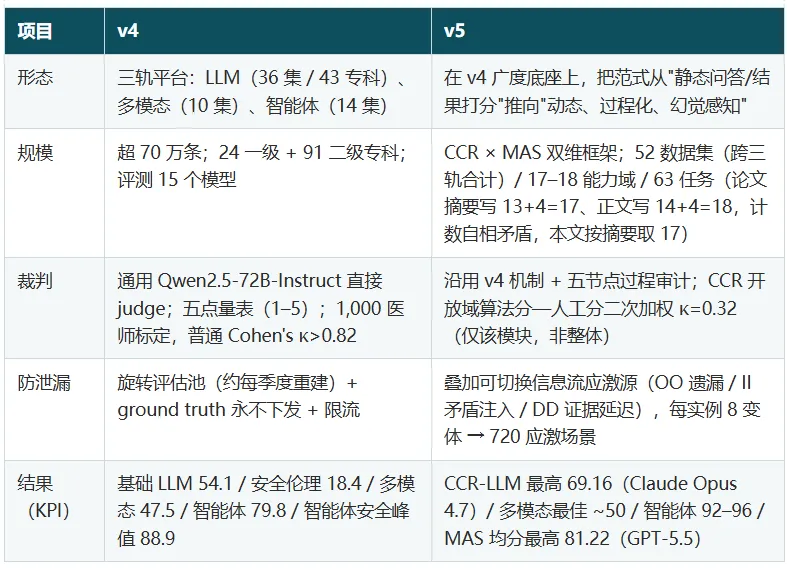
MedBench 由上海人工智能实验室同一团队持续迭代:2024 系统版(arXiv:2407.10990 ,平台化)→ v4(arXiv:2511.14439,三轨 70 万题)→ v5(arXiv:2606.24155,2026-06,动态过程审计)。它是一条平台化、广度优先、原生覆盖多模态与智能体的演化链。
v5 五节点过程审计把推理链拆为:信息缺口检测 → 追问策略 → 矛盾检测 → 诊断更新 → 证据落地;并沿多轮轨迹监测幻觉传播(4 维 8 指标)。核心发现:应激源造成节点特异性退化,矛盾检测与诊断更新最敏感,证据落地多数条件下"表层稳定"(终点有据不代表过程未被污染);且错误多在"矛盾检测的修正失败"处演化为锚定诊断错误。
三、七维逐项对比
3.1 裁判范式:通用 judge vs 专用 SFT judge
这是两份基准在方法学上最值得咀嚼的差异。
- MedBench(v4)直接调用通用大模型
Qwen2.5-72B-Instruct 当裁判,配任务专属 meta-prompt 与五点量表锚点,再用 1,000 名医师抽样标定,报告普通 Cohen's κ>0.82。优势是实现简单、可随底座升级;风险是通用模型可能携带分布偏置,用通用模型评专业输出的循环验证问题未被专门消除。 - MedAIBench(MLB)先用 19,000 条专家标注对
Qwen3-14B基座做监督微调(SFT),得到领域对齐的专用裁判模型,再报普通 Cohen's κ=81.3%、acc 92.13%、F1 94.37%。优势是裁判被"训"向专家分布,更贴合医学评分语义;代价是需维护训练流水线、标注成本高。
两者 κ 水平相当(0.82 vs 0.813,均为普通 Cohen's κ),说明"通用 judge + 大规模人类标定"与"专用 SFT judge"在一致性上都能站住脚。选择哪条路取决于资源与可复现性诉求,MedBench 路更轻量、易跟随底座进化;MLB 路更可审计裁判本身。两份都报告了 κ,这比裸用 GPT 当 judge 更值得行业借鉴。
3.2 覆盖广度 vs 专科深度
MedBench 以广度见长:70 万+ 题、三轨、91 二级专科,且把多模态与智能体作为一等公民。MedAIBench(MLB)以场景深度见长:五维能力直接对应真实诊疗链(病历理解 MedRU、患者侧 SmartServ、医师侧 SmartCare);其"15 专病全链条"属 MedAIBench 2.0 外延规划,超出单篇 MLB 论文范围。两者互补:要"一个模型在语言/视觉/智能体三形态下的全景体检",MedBench 更合适;要"某专科专病在真实诊疗链路上的细粒度能力画像",MedAIBench 更合适。
3.3 平台化 vs 数据集化
MedBench 是活平台:旋转题库缓解静态基准漂移,模型方无法持久缓存答案;ground truth 永不下发,从机制上降低泄漏。MedAIBench(MLB)是数据集:公开集分层抽样 100–300 条可直接下载复现,全量受控申请,更利于学术圈独立审计与二次开发,但静态分片存在被污染的潜在风险(论文已意识到并提示)。
一个细节差异:MedBench 用"旋转池 + 服务器端评分"对抗 reward hacking(治"跨周期记忆");MedAIBench(MLB)用"选择题占比约 45%、开放简答约 55% + 选择题三排列"对抗"排选项作答"(据论文表 1:选择题抽样 1,900 / 4,250 ≈ 44.7%,开放题 2,350 / 4,250 ≈ 55.3%)。思路不同,可叠加。
3.4 静态结果 vs 过程审计
v5 的出现恰好把两条线索连起来:MedAIBench 2.0 强调动态化、过程化、真实临床场景,但 2.0 是一个体系规划;MedBench v5 则用可计算的工程协议,把过程化具体落地为五节点失败指纹 + 幻觉传播轨迹。三者关系可概括为:
- MedAIBench文本 LLM 专项基准 + 专用 SFT 裁判(κ=0.813),强在可复现的结果级审计;
- MedBench v4 / v5平台化、多模态 + 智能体原生,v5 新增动态过程审计与幻觉传播监测,强在广度 + 过程可见性;
- MedAIBench 2.0权威背书 + 证书闭环 + 专科/多模态规划,是工程化与生态化外层。
v5 的核心发现也与 MLB 呼应:都证明"终点分数稳定 ≠ 过程可靠"。v5 更精确地指出,应激源主要冲击矛盾检测与诊断更新两节点,而证据落地在多数条件下仍表面稳定,一个最终答案看似有据,推理链却可能已在中间被错误的矛盾处理污染。这正是静态评测永远看不到的盲区,也是 MedAIBench 2.0 提出过程化想解决、却尚未在工程上完全落地的部分。
3.5 安全伦理
两份基准独立得出同一结论:当前通用大模型的事实/推理能力已不弱,但安全与伦理合规是系统性短板。
- MedBench v4:基础 LLM 安全伦理均值仅 18.4/100,远低于知识/生成/推理的约 58–60。
- MedAIBench(MLB):把 MedSE 单列为能力域;且发现"定向训练比堆参数更关键,Baichuan-M2-32B 在 MedSE 达 90.6%,说明安全可通过专门对齐显著提升。
MedBench 的智能体轨安全均值升至 73.4,提示治理感知的编排(安全护栏 + 工具治理 + 多步决策)可能改善安全表现,但需结合提醒:该轨任务形态对 agent 架构更友好,此分数高不代表模型内在安全已解决,仍待前瞻验证。
3.6 分数不可直接比较
尽管两篇都给出 0–100 的总分,但任务集合、抽样、打分 rubric、模型集合均不同,因此:
- MedBench 基础 LLM 均值 54.1 ≠ "比 MedAIBench(MLB)上 Kimi-K2 的 77.3 更低/更难";
- 两基准的"安全伦理"维度(18.4 vs 90.6)来自不同模型与不同任务,不能互相折算。
任何"谁更难"的结论都是误读。可比的是结构性发现,而非绝对分。
3.7 一致性度量对照:κ 的三种口径不可直比
关键一致性度量对照:MedBench v4 的 κ>0.82、MedAIBench(MLB)的 κ=0.813 为普通 Cohen's κ;MedBench v5 过程审计模块的裁判-人工一致性为二次加权 Cohen's κ=0.32("fair")。需说明:三种 κ 口径不同(v5 为二次加权、v4/MLB 为普通),此处仅作定性参考,不可直接折算比大小。v5 的 0.32 来自 CCR 开放域 440 样本的自动评分可靠性(ICC=0.74、Spearman ρ=0.26),并非五节点过程审计 / 720 应激场景的裁判可靠性(后者论文未单独验证)。这一落差不是 v5 的失误,而是客观事实,过程级行为评分比结果级评分更难与人工达成一致。它提示行业:当我们从"判答案对不对"走向"判推理链哪一步断",评测本身的可信度校准将成为新难题,v5 诚实地把它写在了论文里。
四、共同暴露的评测天花板
- ground truth 危机未被根除两者都用专家标注作金标准,但医学真理本就演进且常嵌于共识;裁判模型(无论通用还是 SFT)仍是对"专家分布"的近似,而非对"客观真理"的度量。
- 静态/半静态基准终会漂移MedBench 用旋转池缓解,MedAIBench(MLB)用题型组合缓解,但都未做到"持续对抗优化"的闭环。
- 真实世界外推性不足MedBench 自陈"主要来自三甲医院",MedAIBench(MLB)数据源自中文临床真实数据但受控访问,两者都未充分覆盖基层、欠发达地区、方言与文化变异。
- 临床结局缺位两基准测的是"能力/行为",不是死亡率、再入院率、误诊率等硬结局。评测是入场券,RCT 与前瞻性验证才是合格证,这一点两篇论文都诚实地点到了。
- 过程审计的可信度校准是新难题MedBench v5 用五节点审计暴露推理断点,但其过程审计模块的裁判—人工一致性仅(二次加权)Cohen's κ=0.32(fair),远低于结果级评分的 0.82(v4)/0.813(MLB)。该 0.32 仅针对 v5 新增的过程审计模块,不代表 MedBench 整体一致性差。说明"评过程"比"评结果"更难标准化,行业需为过程级评测开发专门的一致性协议与 rubric。
对医工交叉者的可操作启示
- 裁判模型务必报告一致性无论走 MedBench 的"通用 judge + 千医标定"还是 MedAIBench 的"SFT 专用 judge",都应像两篇论文一样给出 Cohen's κ 或 ICC,否则分数缺乏可信锚点。
- 安全伦理必须单维呈现把安全并入总分只会掩盖风险;两份基准都证明,安全维的塌陷与知识维的高分可以并存。
- 构建专科集是稀缺机会MedBench 广度见长但任务未单列中医科;MedAIBench 2.0 规划的 15 专病体系含中医科专病(属外延规划,非 MLB 论文范围),MLB 论文 22 个数据集未单列中医任务集。对于有知识积累的团队,中医辨证逻辑、古籍术语-现代临床术语归一(类比 CHIP-CDN)等正是稀缺的方法学资产。
- 多模态/智能体是下一战场MedBench 已证明"跨模态推理、影像-临床纵向整合"是模型短板;MedAIBench(MLB)的多模态仍在共建。具备 CT/X线/DR/MRI/超声/病理/眼底数据或算法的团队,应优先参与共建计划,把自有数据转化为标准集。
4.4 一个值得警惕的叙事
MedBench 智能体轨分数(79.8)远高于基础 LLM(54.1),容易被解读为"上 agent 就安全了"。论文本身已澄清:该轨任务形态对 agent 架构更友好,分数高不代表内在安全,仍需前瞻验证。同样,MedAIBench(MLB)中"患者侧 SmartServ 骤降到 61.3"易被外推为"模型不会与人交流",但需注意该维度四个集仍为选择题,鸿沟部分来自题型设计,而非纯能力。读两份基准时,都应剥离任务形态带来的分数偏移,只看能力本身的相对信号。MedBench v5 进一步提醒:即便终点"证据落地"分数稳定,推理链中间的矛盾检测与诊断更新仍可能在应激下崩溃,所以"最终答案正确"不能等价于"过程可信",这正是过程审计范式要补上的盲区。
附录:数据备查
▸ 附录 A:MedAIBench(MLB)二十二个测评集清单(据论文表 1)▸ 附录 B:MedAIBench(MLB)十个模型五维表现(据论文表 4)▸ 附录 C:MedBench v4 / v5 关键明细v4 三轨架构:
LLM 轨五维(MLU 医学语言理解 / MLG 医学语言生成 / MKQA 医学知识问答 / CMR 复杂医学推理 / HSE 医疗安全伦理),36 自建集、43 专科;
多模态轨三轴:
视觉感知与文本抽取 MedDetect / MedClass / MedOCR;
跨模态语义推理 MedVQA / MedGen / MedQC / MedSeqIm;
图像感知临床决策 MedDiffDx / MedTherapy / MedCourse)共 10 集;
智能体轨六维(目标分解 MedDecomp / MedPathPlan / MedCOT / MedReflect;工具 API MedRetAPI / MedCallAPI / MedDBOps;意图识别 MedIntentID / MedRoleAdapt;长上下文 MedLongConv / MedLongQA;多智能体 MedCollab;安全对抗 MedShield/MedDefend)共 14 集。
v4 指标体系:Accuracy(严格匹配,选项随机打乱)/ Micro-F1(多标签、结构化抽取)/ Macro Recall(开放问答,按归一化医学关键点覆盖率)/ IoU(检测分割)/ 1-N.E.D(字符串级抽取);统一重标定 0–100,macro 平均。论文明确:"差异仅作描述性呈现,不做统计显著性检验。"
v5 双维框架:CCR(14 能力维度、52 数据集,跨三轨合计)覆盖广度;MAS 四个可执行环境——DataAgent(自然语言转 SQL/多轮查询)、RAGAgent(检索增强 QA)、DeepResearch(长程文献研究综合)、SafetyAgent(红队对抗鲁棒性,基于 OpenRT 框架)。应激源 OO/II/DD,每实例 8 变体,过程审计子集 90 实例 → 720 应激场景。五节点审计指标:GDR/IR(信息缺口)、PIR/RIR(追问)、CDR/CIR(矛盾检测)、RUR/PCR/SMR(诊断更新)、EF/FCR(证据落地);幻觉传播 4 维 8 指标(NFR/UFR/HPR/HCCR/DHDR/CHO/CIHSR/CIHGR)。
v5 结果(客观呈现):CCR-LLM 最高 Claude Opus 4.7 69.16(头部密集 65–69);CCR-多模态最佳约 50(Doubao-Seed-2.0-pro 51.65、Gemini-3.5-Flash 50.68);CCR-智能体 92–96;MAS 均分最高 GPT-5.5 81.22(RAGAgent 94.27、SafetyAgent 96.00),Qwen3.7-Max-Preview 78.13,Kimi-K2.6 74.49(DeepResearch 仅 41.16)。过程审计核心发现:应激源造成节点特异性退化,矛盾检测(CDR/CIR)与诊断更新(RUR/PCR/SMR)最敏感;证据落地(EF)多数条件下"表层稳定";O+D(遗漏+延迟)最具破坏性。
仅做个人学习笔记,欢迎技术交流。
转载注明出处。
原论文作者若有异议联系删除。