Jev 模型评测与工程化落地:一份独立跑分 、100+真实项目的全景盘点
- 更新时间 2026-09-23 14:04:57
不写字的 Jev 到底行不行?发布仅一周,大家把它的标签贴在「0 幻觉、便宜 444 倍、反 chat」上。但判断一个决策模型该不该进生产,不能只看厂商自测。我们之前也进行了Jev的深度拆解:Jev「System One」万字拆解:不写字、0幻觉、成本仅1/400?。这篇我们把两件事扒开看:一份目前最完整的独立基准(AY Automate,2026-09-19,3,955 次调用、$1.53),和一份真实落地清单(jevusers.com Top 100 项目 + GitHub 核验数据)。
❝先说结论: Jev 不是「更便宜的 GPT」,而是一个「更便宜的判断」。独立基准显示它比最快的 LLM 快约 2.0–3.6×、比前沿便宜 40–49×,但意图路由准确率落后 GPT-5.6 Terra 约 5–6 个点——它像个好用的小模型,不是前沿模型。真正值钱的是它的校准概率:设一道门限,不确定的甩给大模型,就能用 26–28% 的成本摸到前沿准确率。落地侧已经长出 100+ 开源项目,但清一色在做「决策」,没有一个是「生成」。
点关注 不迷路
一、这份评测为什么值得看
市面上的 Jev 数字,九成来自 TypeSafe 自家 workflow eval(参考答案是两个前沿模型高 thinking 输出的平均,且由 TypeSafe 自写,需打折读)。AY Automate 这份是少有的独立、可复现、方法透明的基准:
独立:第三方机构,不与 TypeSafe 关联; 可复现:单一 Python 文件(仅标准库)、固定随机种子,脚本含 fetch / run / report,完整数据results.jsonl公开;透明:附 95% Wilson 置信区间、exact McNemar 配对检验,并明确列出「这个测试不能告诉你的事」。
❝评测对象为 Jev 1.13(标识
typesafe/jev-1.13-20260917),通过 OpenRouter 的 alpha decisions 端点调用;5 个系统同跑,总花费 $1.53。
二、测试怎么搭的(Methodology)
三个任务、五个模型、一台笔记本,全部用相同的指令和相同的答案选项(仅标签,无描述):
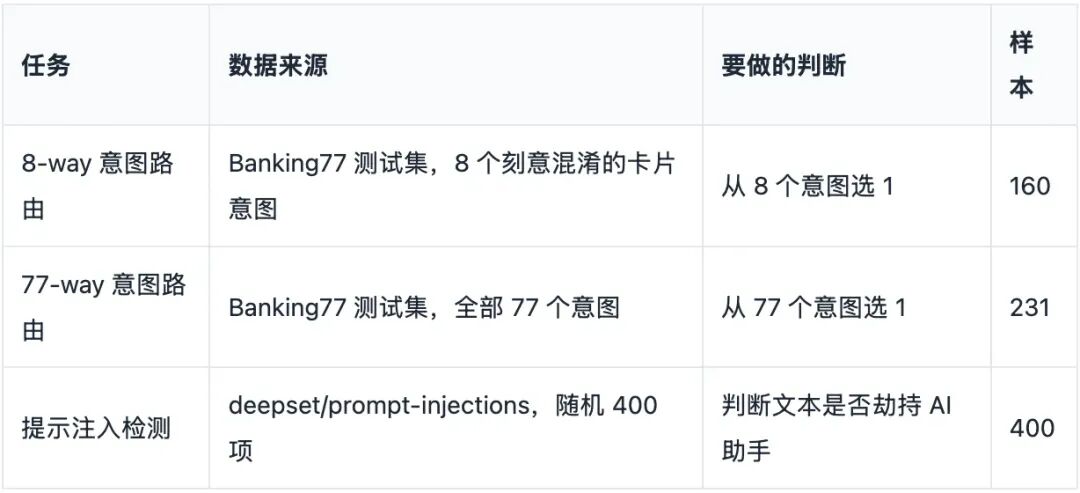
对比模型:GPT-5.4 nano、Gemini 3.5 Flash-Lite、Claude Haiku 4.5(小模型组)+ GPT-5.6 Terra(前沿基线)。LLM 运行参数 temperature=0、严格 JSON schema、reasoning=minimal;Jev 走 decisions 端点。硬件:一台笔记本经 OpenRouter,每系统 4 个并行请求,5 个系统同时跑。
三、准确率:像个好用的小模型,不是前沿(图1)
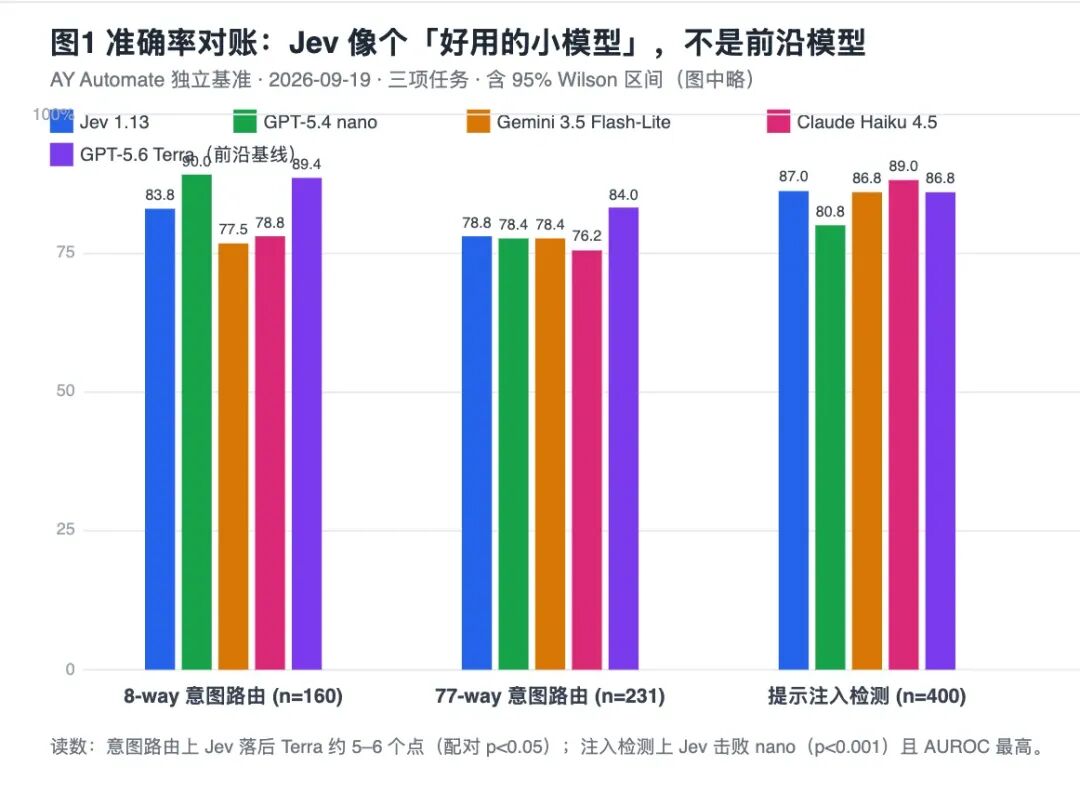
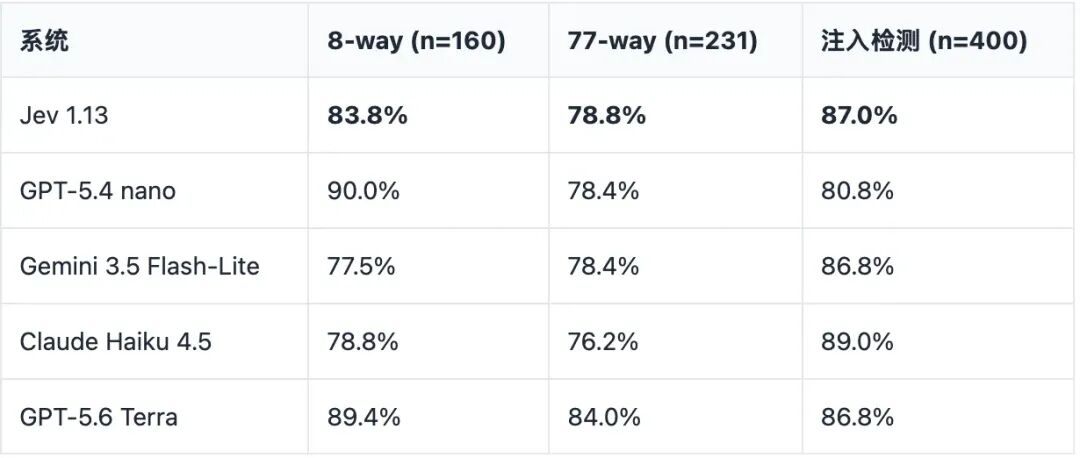
配对检验(同一批样本,exact McNemar):
8-way:Jev 落后 nano(仅 Jev 对 2 项、nano 对 12 项,p=0.013)和 Terra(2 vs 11,p=0.022);与 Flash-Lite、Haiku 无显著差异; 77-way:仅 Terra 可靠优于 Jev(7 vs 19,p=0.029); 注入检测:Jev 击败 nano(28 vs 3,p<0.001),与其余持平。
❝AY Automate 原文的原话:*"Jev behaved like a good small model, not like a frontier model."* 这恰恰是选型标尺——它替代不了前沿模型做难判断,但能替代小模型做高频判断。
四、速度与成本:核心甜点,但 193×/444× 没出现(图2)
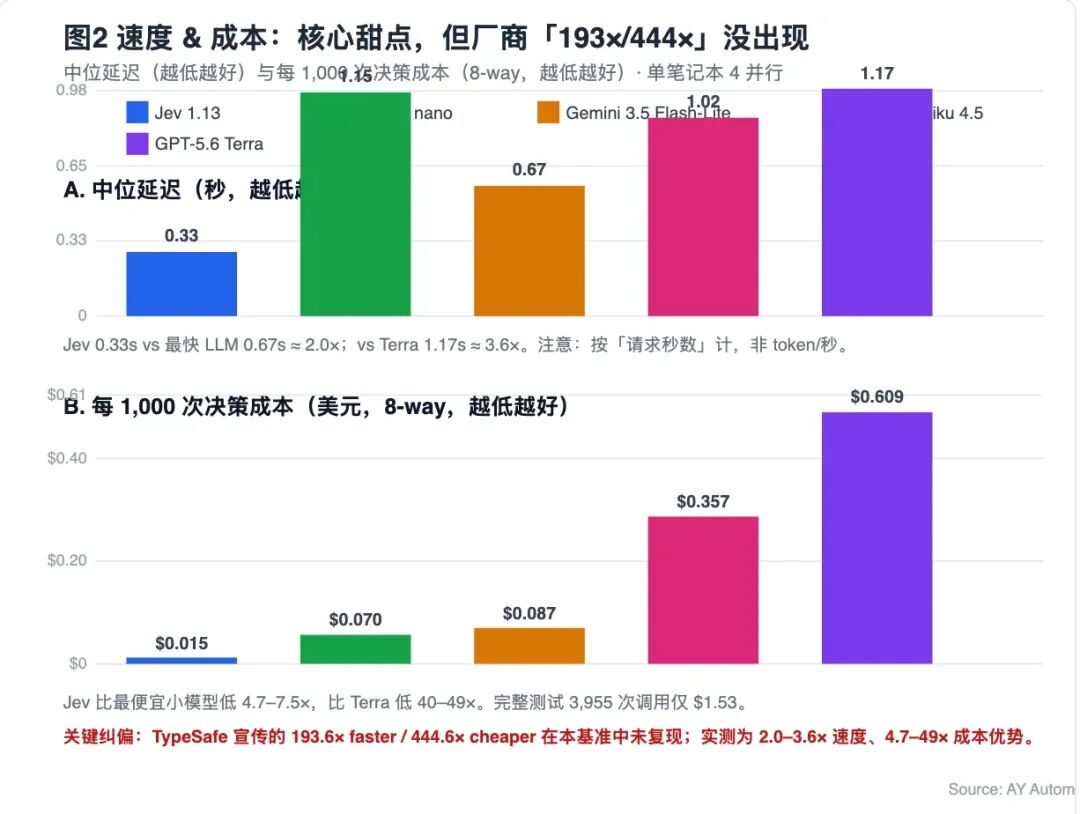
速度:Jev 中位延迟 0.33s(95 分位 0.44s),最快 LLM 是 Gemini 0.67s,Terra 是 1.17s。即比最快 LLM 快约 2.0×、比 Terra 快约 3.6×。注意这是「每请求秒数」,不是 token/秒。
成本(每 1,000 次决策,8-way):Jev $0.015,nano 0.087,Haiku 0.609。即比最便宜小模型低 4.7–7.5×,比 Terra 低 40–49×。
❝关键纠偏:TypeSafe 宣传的 193.6× faster / 444.6× cheaper,在本基准中没有复现。实测为 2.0–3.6× 速度、4.7–49× 成本优势。凡是引用倍数,请一律按「自家最优条件 / 独立复现缩水」两层口径来读。
五、置信度是真正的护城河:可调的概率旋钮(图3)
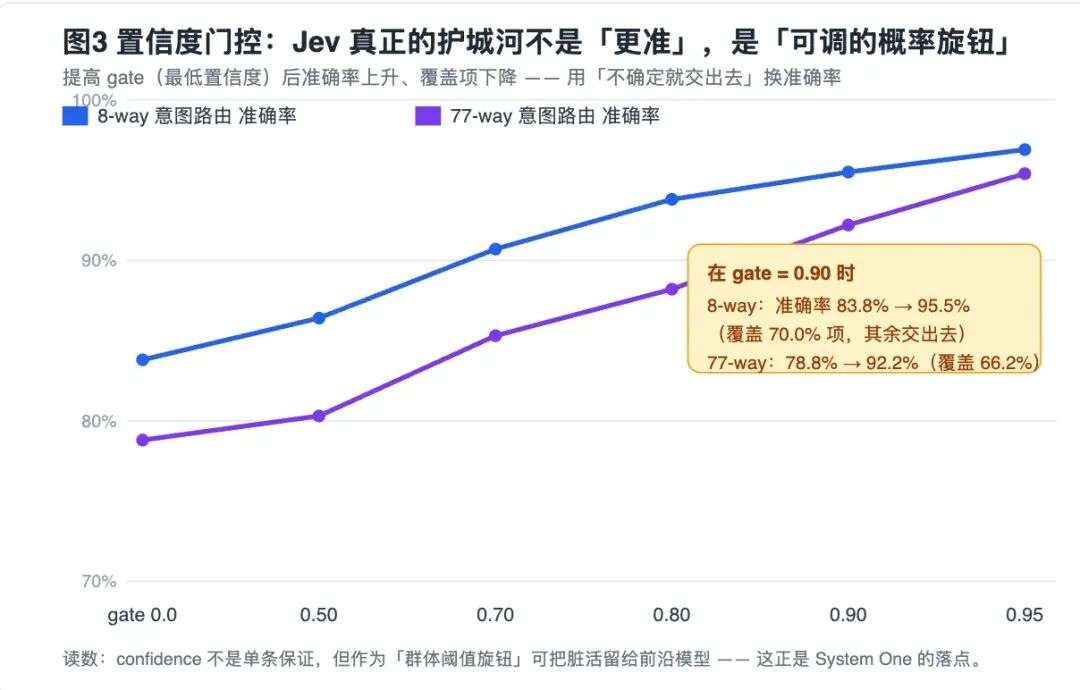
Jev 给每个选项一个概率与整体置信度。把最低置信度门限(gate)抬高,准确率上升、覆盖项下降——这是它区别于「死板分类器」的地方:
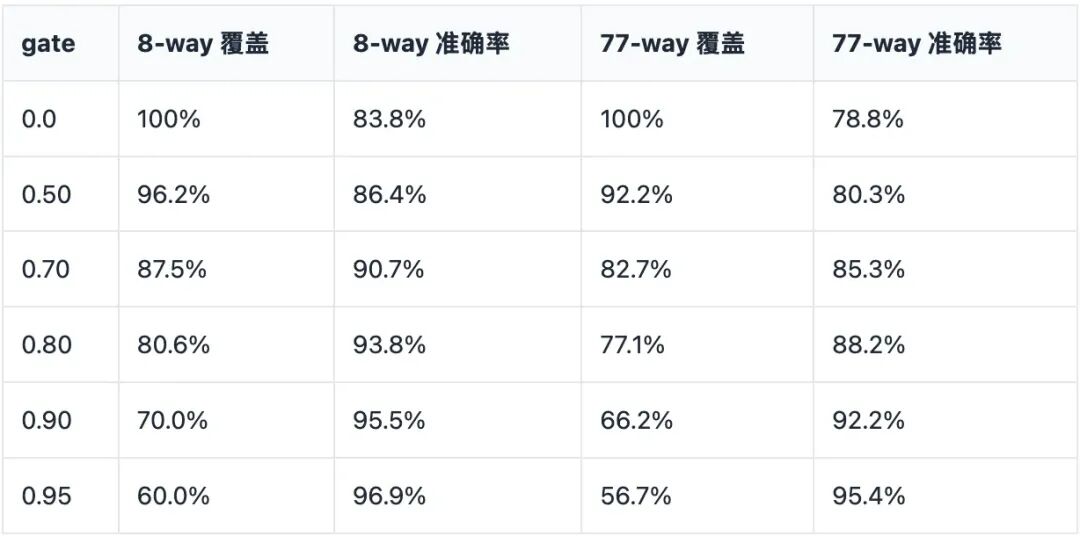
在 gate=0.90 时,8-way 准确率从 83.8% 升到 **95.5%**(覆盖 70% 项),77-way 从 78.8% 升到 **92.2%**(覆盖 66.2% 项)。注入检测任务是另一个范例:Jev 的 AUROC 高达 0.990(五者最高),把阈值从 0.50 降到 0.10,召回从 0.69 拉到 0.96、精度仍 0.92。
❝校准不是单条保证,但作为「群体阈值旋钮」极其好用:凡是不确定的一律交出去。这正是 System One 模型的落点——不是更会选,是更会承认自己不确定。
六、级联:Jev 做门卫、前沿做兜底,黄金组合(图4)
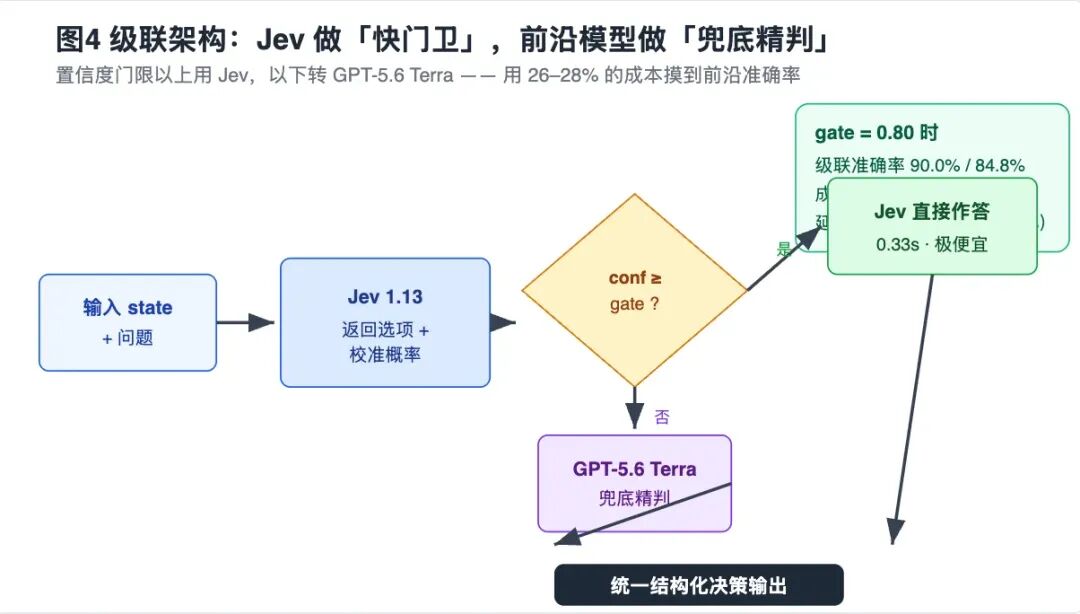
把上面的门控工程化,就是生产里最稳的模式:置信度门限以上用 Jev,以下转 GPT-5.6 Terra。
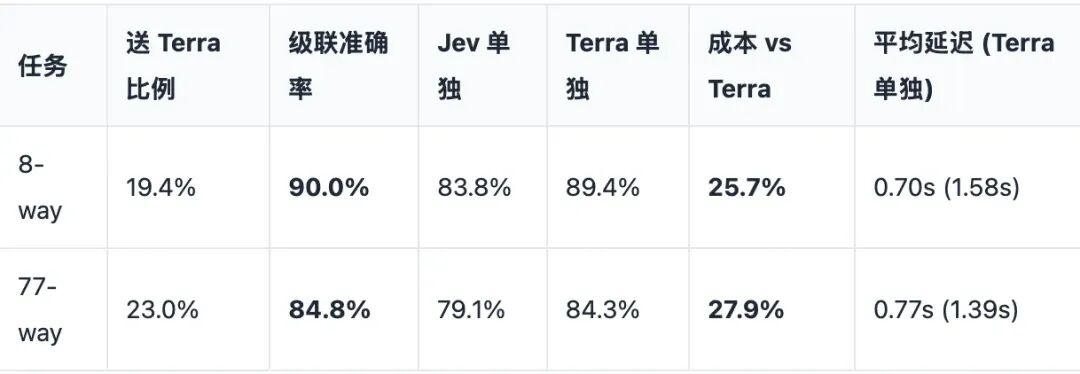
在 gate=0.80 下,级联用 26–28% 的 Terra 成本和约一半延迟,就把准确率拉到与前沿单独跑几乎持平。需要解释、长推理、多模态的活,照常交给 LLM——Jev 只接走那些「规则写不完、又不值得每次调大模型」的小判断。
七、赢在哪、输在哪:一张选型标尺
赢(Wins)
速度:中位 0.33s,比最快 LLM 快 2.0×、比 Terra 快 3.6×; 成本:比最小模型便宜 4.7–7.5×,比 Terra 便宜 40–49×; 注入检测:击败 nano(p<0.001),AUROC 0.990 全场最高; 级联价值:置信度门限 + Terra 兜底,26–28% 成本摸到前沿准确率; 小模型平级:行为像优质小模型,却自带校准概率与并行决策。
输(Loses)
准确率不及前沿:两项意图任务落后 Terra 5–6 个点(配对 p<0.05); 重叠标签盲区:置信度无法告知标签集本身重叠(5 个高置信错误源于标签混淆); 厂商夸张未证实:193.6×/444.6× 没出现,实测 3.6× 速度、40–49× 成本。
八、这个测试不能告诉你的事(老刘体护栏)
AY Automate 自己列了「What this test cannot tell you」,逐条值得贴在工作流评审会上:
单次运行:每个系统只跑一遍公开数据;Banking77 和注入集可能已在 LLM 训练数据里,且无法核查 Jev 的训练数据; 仅标签无描述:选项只给标签,补上每个选项的说明可能改变全部五个结果; LLM 最小推理:LLM 用了 minimal reasoning + 严格 JSON(偏利于其速度/成本),未测更高推理档位; 延迟环境:来自一台笔记本经 OpenRouter、4 并行、五系统同跑; Alpha 端点:Jev 走 OpenRouter alpha 端点,TypeSafe 自家访问仍 waitlist,行为/限制可能变; 置信区间宽:95% 区间有 6–13 个点宽,更小的差异需更多数据; 非客户负载:AY Automate 未在客户项目上用过 Jev。
❝附加警惕:厂商自测常用「其它大模型输出」当评分标准而非真值,会夸大一致性(Jev 与 Terra 一致率 90.0%/87.4%/93.8%,比真值准确率高 6–8 个点)。看一致率时先问一句:一致的对象是谁?
九、工程化落地:100+ 项目在干什么(图5)
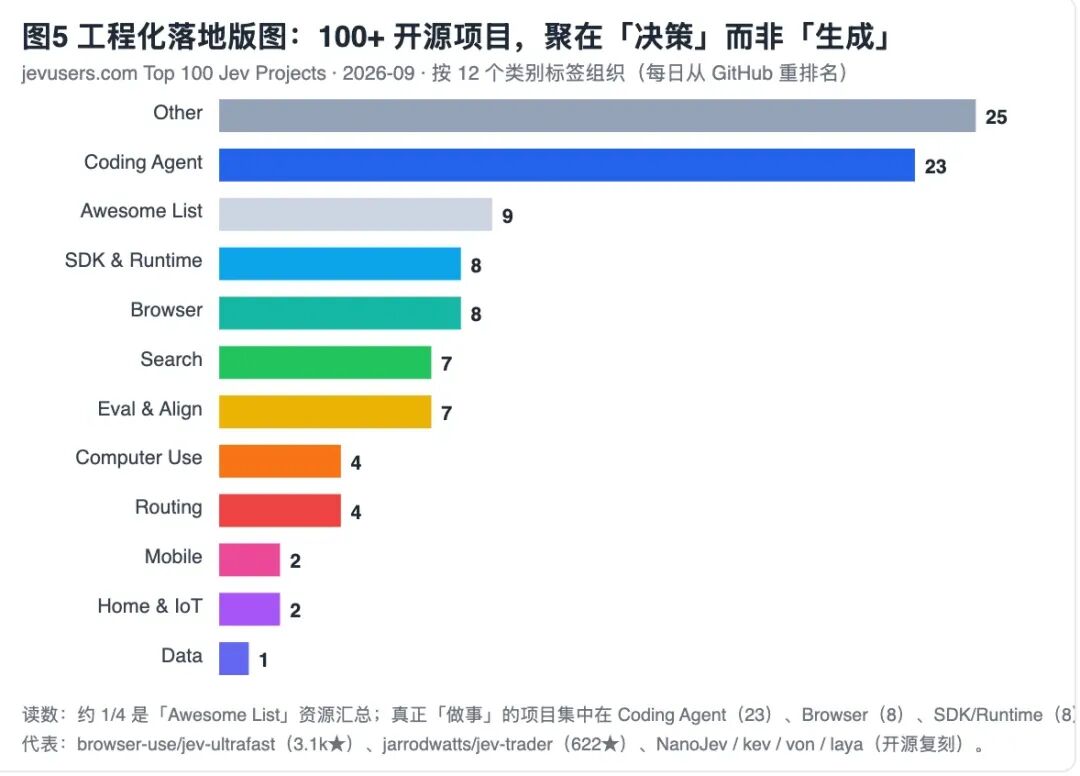
jevusers.com 的 Top 100 Jev Projects 每日从 GitHub 发现、过滤、重排名,按 12 个类别组织。把「Awesome List」这种纯资源汇总(25 个)剔除后,真正做事的项目高度集中在三类:
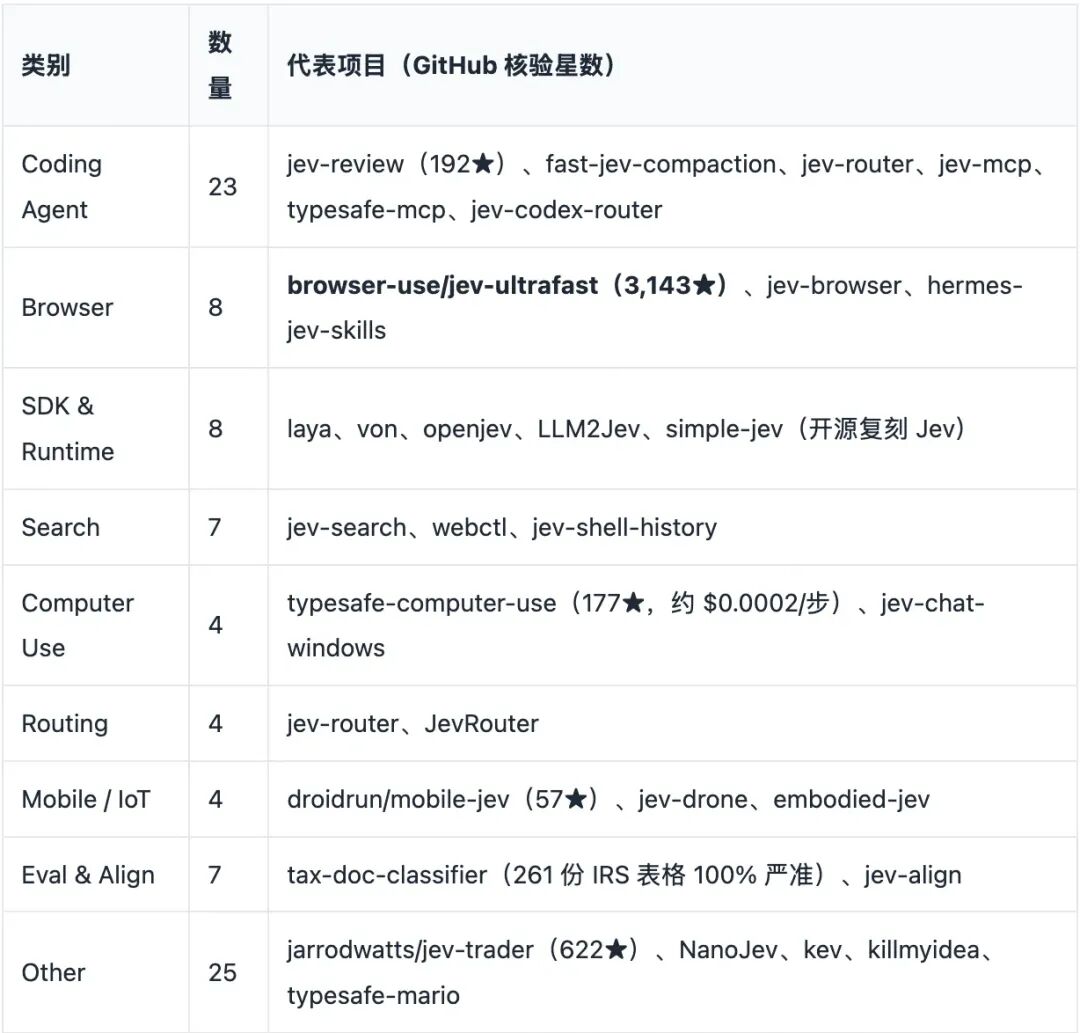
❝星数来自 iadecider.com 2026-09-18 的 GitHub API 核验;所有仓库均在发布后数日内创建,尚无一个经历过生产部署。star 衡量的是注意力,不是质量——接进重要系统前请先读代码。
十、落地里的真问题:从项目与实测读出的三个模式与三个坑
三个高频模式(最具价值的工作流)
「贵代理做开放活,Jev 做频繁的有界判断,确定性代码掌 policy」:上下文压缩(fast-jev-compaction 删过时工具调用)、模型/工具路由(jev-router、jev-codex-router 报告省约 60% 模型成本)、代码审查分诊(jev-review)、技能检索(skillranker)。这比「浏览器自动驾驶」更可能是 Jev 最强落地。 浏览器/电脑操作:Jev 只挑动作和 DOM 元素,小模型才负责填字。jev-ultrafast 在 Google Flights 上 7.1s 订完苏黎世→伦敦机票;computer-use 每步约 $0.0002。 开源复刻潮:NanoJev / kev / von / laya / openjev / LLM2Jev 把「System One 决策」本地化、可私有化——路线与 NanoJev 一致。
三个必须正视的坑(来自真实评测,非臆测)
概率不能直接当业务门槛:CharlyPoly 用 Banking77 测,Jev 声称 80–95% 把握的样本实际仅 64% 正确,还有 6.6% 样本把正确标签打成零概率;ECE 落后 ModernBERT。jevcal 用 Platt 校准把 Brier 从 0.0837 降到 0.0248——校准只能重标概率刻度,不能让它更会选。务必先在自己数据上重新校准。 复杂任务要先拆原子问题:反钓鱼直接判整封邮件准确率仅 62.6%(低于 Haiku 81.3%);拆成 5 个具体信号再汇总,Jev 升到 95.0%,且费用约为 Haiku 的 1/27、快 5×。Pricogni 把 9,081 组低置信商品用 Jev 只答「是否同一件 + 差异类别」,49% 否定、21% 确认、30% 留人——Jev 只筛易判的,疑难留人。 「加了 Jev 不一定更好」:TokenTrim 对照显示,去掉 Jev、只保留相似问题检索,准确率仍是 62.4% 且成本略低——真正带来提升的是检索,Jev 的难度判断没增值。另有工作流因 Jev 返回空结果、智能体误当「更安全选择」而整条停摆。多一层判断就多一个故障点,超时/空结果/降级方案必须提前写。
十一、冷思考:决策模型的正确心智模型
Jev 代表一种新工具类:不卷 chat、不卷推理,卷「软件能依赖的智能接口」。第一性原理上,机器-机器交互终将占主导,这个判断有道理。但 ROI 要看三件事:真实生产负载下的稳定性、校准在自己域的表现、是否真能替代大量 JSON-mode LLM 调用。现在下定论太早。
❝可迁移结论: 未来 AI 落地的单位不是「更会聊的模型」,而是「能嵌入软件控制流、可被观测与测试的决策单元」。Jev 是这一范式的早期代表——把它放在前沿模型周围(决定它看什么、何时跑、跑哪个版本、活儿干完没、何时交人),而不是替代它,才是正确心智模型。一句话:当工作流里出现高频、有界、可校准概率的结构化判断,且不需要生成文字时,Jev 是甜点区;解释、生成、长推理、多模态,仍回 LLM。
参考文献
AY Automate《Jev vs LLM: An Independent Benchmark》— https://www.ayautomate.com/blog/jev-vs-llm-benchmark (含 jev_benchmark.py / analyze.py / results.jsonl) jevusers.com Top 100 Jev Projects — https://jevusers.com iadecider.com《TypeSafe AI Review 2026》— GitHub API 核验的 7 个代表仓库与星数 digitalstrategy-ai.com《What Is Jev?》— 20 个落地项目模式盘点 网易科技《Jev突然火了:大模型负责回答,它负责判断》— Banking77 / jevcal / Pricogni / TokenTrim 实测 TypeSafe AI 官方博客《Introducing System One Models & Jev》— https://typesafe.ai/blog/introducing-system-one-models-and-jev TypeSafe AI 文档(System One / Confidence / RLCD)— https://docs.typesafe.ai
本文为「老贾探AI」技术解读系列。对 System One / 决策模型 / RAG·Agent 落地感兴趣,欢迎后台私信 — 加入社区交流。
点关注 不迷路
