提示:本文是为“大语言模型语言能力评测数据集”系列文章(共28篇)补写的一篇。提示:文中信息均由ChatGPT整理,不保证准确,仅供参考。摘要:
本文以FLORES、WMT和ACES为主线,围绕机器翻译的三项目标——信息保真、目标语自然、跨句语境与文体适切——以及一项测量前提——自动评分是否可靠,说明评测任务如何设计、数据集如何制作、不同分数怎样产生,并结合真实样例和WMT25模型—人工结果解释机器翻译评测为何仍需继续。
一、机器翻译评测要测什么
“福尔摩斯这样描述莫里亚蒂”如果被译成“Moriarty described Holmes”,人名一个没少,英文也很通顺,描述者和被描述者却交换了。这个真实案例说明:译文好读,只回答了翻译能力的一部分。
机器翻译(Machine Translation,MT)要求模型用目标语言重新表达源文。评测它,需要回答三个问题:信息是否保真,目标语是否自然,跨句语境和文体是否处理得当。此外还有一个测量前提:自动评分工具能否识别这些优劣。前三项是模型的翻译能力,第四项检验“尺子”是否可靠。
表1 机器翻译评测的“三项目标+一项前提”
| 类型 | 评测目标 | 可观察证据 |
|---|
| 翻译能力1 | 信息忠实:人物关系、否定、数字、专名和事实不改变 | 与源文相比,译文是否出现错译、漏译或增译 |
| 翻译能力2 | 目标语质量:语法正确、措辞自然、表达流畅 | 母语评审是否发现语法、搭配或表达问题 |
| 翻译能力3 | 语境与文体适切:指称、术语、衔接和风格在篇章中保持 | 跨句关系是否一致,译文是否适合领域和体裁 |
| 测量前提 | 评分可信:自动指标能够把较好译文排在较差译文之前 | 指标在已知优劣的候选对上是否给出正确排序 |
三条研究路线并非各自只对应一个问题。第一条和第二条共同检查翻译能力,第三条检查评分工具;具体关系如下。
多语种固定题库路线——FLORES。 Guzmán等在Facebook AI于2019年推出FLORES低资源翻译评测集,Goyal等随后发布FLORES-101。这条路线主要对应问题1“信息是否保真”:让系统翻译内容对齐的多语种句子,再与经过质量控制的人工译文比较,从而观察人物、事实和语义是否改变。[1–2]
年度新题与专业人工评审路线——WMT。 机器翻译研讨会及其后的机器翻译会议(Workshop/Conference on Machine Translation,WMT)自2006年起组织年度共享任务,本文采用Kocmi等的WMT25报告。这条路线直接对应问题2“目标语是否自然”和问题3“语境与文体是否适切”,同时再次检查问题1:专业评审在当年新收集的多领域文档中标出错译、语法问题和篇章问题。[3]
评分指标诊断路线——ACES。 苏黎世大学与爱丁堡大学的Amrhein等于2022年提出ACES(Translation Accuracy ChallengE Set,翻译准确性挑战集)。这条路线对应问题4“评分工具是否可靠”:把已知优劣的两个候选译文交给自动指标,看它能否把较好译文排在前面。[4]
第二节将这三条路线进一步展开为四类任务。WMT所代表的真实文本评测被分成“年度盲测”和“篇章与专门体裁评测”,后者由GuoFeng、DiscoX和PoetMT等资源补充。
二、四类任务怎样对应评测目标
四项目标需要四类任务。每类任务都必须说明输入是什么、谁作答、输出什么,以及怎样判定结果。
表2 从评测目标到任务设计
| 任务 | 谁作答、怎样作答 | 主要判断 | 代表资源 |
|---|
| 多语言平行翻译 | 系统把同一内容从一种语言译到另一种语言 | 信息是否保持;不同语言方向能否统一比较 | FLORES系列 |
| 年度盲测翻译 | 系统翻译当年新收集的多领域文档,专业评审检查译文 | 当前系统在接近实际使用的文本上表现怎样 | WMT年度任务 |
| 篇章与专门体裁翻译 | 系统翻译小说、专业长文或古典诗词 | 跨句一致、领域知识和文学风格能否保持 | GuoFeng、DiscoX、PoetMT |
| 指标诊断 | 自动指标分别给已知优劣的两个译文打分 | 评分工具能否识别指定错误 | ACES |
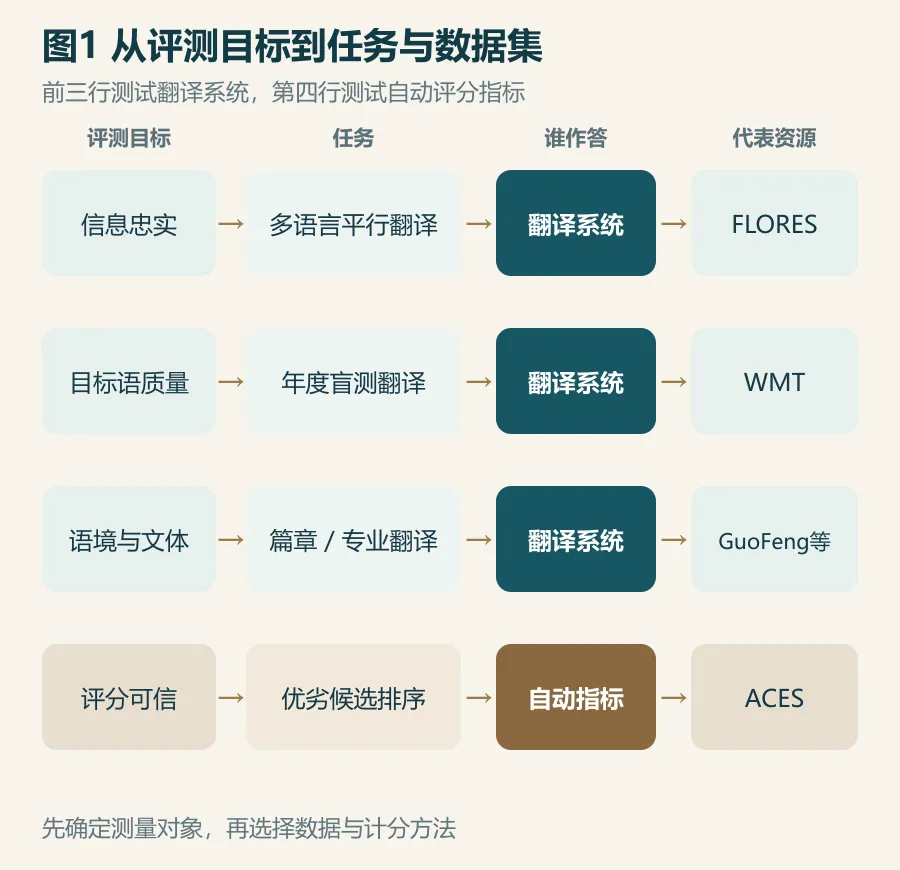
图1 评测目标、任务与数据集的对应关系。 前三行由翻译系统提交译文,研究者再评价译文;第四行由自动评分指标“作答”,答案是两个候选译文的分数或排序。图1放在这里,是为了先分清“测翻译系统”和“测评分工具”,再进入各数据集的制作方法。
这四类任务互补。
固定平行句便于横向比较,却难以代表长篇和新文本;
年度盲测更接近当前系统,却不适合跨年直接比较;
专业体裁能暴露特定困难,但覆盖面较窄;
指标诊断能检查评分失灵,却不直接给出模型的翻译能力分数。
三、数据集怎样制作、彼此是什么关系
这些资源中,只有FLORES-101、FLORES-200和FLORES+构成明确的扩展链。WMT是逐年重建测试材料的共享任务;ACES部分复用FLORES等资源来制造诊断题;GuoFeng、DiscoX和PoetMT则是面向特定体裁的独立数据集。
表3 主要数据集的来源、规模与用途
| 数据集 | 数据怎样获得 | 规模与对应目标 |
|---|
| FLORES-101 | 从842篇Wikinews、Wikijunior和Wikivoyage文章抽取英文句子,再由专业译者翻译、复核 | 每种语言3,001句,101种语言;主要测多语言信息保持 |
| FLORES-200/FLORES+ | “不让任何语言掉队”(No Language Left Behind,NLLB)团队在2022年扩展语言覆盖;开放语言数据倡议自2024年维护和修订FLORES+ | FLORES-200覆盖200种语言;FLORES+继续增加语言变体 |
| WMT25测试集 | 从新闻、社交、语音、文学、教育等来源收集较新文档,用难度采样挑选材料,并制作人工参考译文 | 30个受邀翻译方向;其中部分方向进入人工评审;综合测忠实、流畅与篇章表现 |
| ACES | 通过程序扰动、改造已有挑战集和人工构造,给每项配较好译文、错误译文和错误类别 | 36,476项、146个翻译方向、68种现象;测评分指标的错误识别能力 |
| 专门体裁资源 | GuoFeng取网络小说章节;DiscoX由领域专家整理英汉长文;PoetMT筛选中国古典诗词及人工英译 | 分别突出小说篇章、专业长文和诗词的文化与风格要求 |
FLORES的模型输入是源句,模型自行生成译文;它没有选择题选项。ACES的输入对象不同:评分指标看到源文、参考译文和两个候选译文,应当给较好候选更高的分数。下面三项来自ACES官方数据。[4]
表4 ACES真实样例与诊断逻辑
| 现象 | 较好译文与错误译文 | 为什么能诊断 |
|---|
| 人物关系 | Holmes describes Moriarty…/Moriarty described Holmes… | 检查指标是否发现施事者和受事者交换,而非只看词汇重合 |
| 数字保持 | “卡茨1947年出生……”/“卡茨197年出生……” | 两项的关键差异是年份,检查指标是否对事实数字敏感 |
| 语篇连接 | whereas/when,对应“利润上涨,工资停滞” | 检查指标能否依据源文区分转折和时间关系;孤立句仍可能存在解释空间 |
最小对比对通过控制候选差异来定位错误,但并非每项都只改变一个因素。人物关系样例还存在时态和措辞差异;连接词样例也受语境影响。因此,数据集标签本身仍需要语言学复核。详细版本、制作流程和样例字段见文末附录。
四、分数怎样产生,模型和人类表现如何
同一份系统译文可以由自动程序打分,也可以交给人类评审。前者便宜、能够覆盖全部测试文本;后者成本较高,却能指出具体错误并校准自动指标。下面五种方法因此分属两个层级,而不是五把可以任意互换的“尺子”。
表5 五种常见评价方法的层级与作用
| 层级 | 方法及完整名称 | 怎样产生结果 |
|---|
| 自动指标 | BLEU(Bilingual Evaluation Understudy) | 比较系统译文与参考译文的词语片段重合率,并惩罚过短译文;输出一个自动分数 |
| 自动指标 | chrF(character n-gram F-score,字符n元组F分数) | 比较字符片段的精确率和召回率;对不依赖空格分词的语言尤其方便 |
| 自动指标 | COMET(Crosslingual Optimized Metric for Evaluation of Translation) | 用人工质量判断训练神经网络,再依据源文、系统译文和参考译文预测质量 |
| 人工评审协议 | MQM(Multidimensional Quality Metrics,多维质量指标) | 评审标出错误类别与严重程度,组织者按预设权重汇总错误分 |
| 人工评审协议 | ESA(Error Span Annotation,错误片段标注) | 评审标出主要或次要错误,并直接给当前片段0—100分 |
一次评测不必把五种结果全部报告。组织者会根据目标、语言覆盖和人工成本选择其中一部分:FLORES系列通常用BLEU、chrF家族的自动指标大规模比较语言方向;WMT25先在全部测试数据上计算多种自动指标,再对约一半语言方向做人工评审;ACES不评价哪个翻译系统最好,而是检查自动指标能否把已知较好的译文排在前面。[2–8]
MQM和ESA处在同一层级,都是人工评审协议,具体任务通常择一使用。ESA借鉴MQM“先定位错误、再判断严重程度”的思路,但不要求完整的MQM错误分类,并由评审直接给0—100分;MQM则按错误类别和严重程度加权汇总。两者的原始分数不能直接混排。
BLEU、chrF和COMET的数值也不能彼此换算;它们主要用于在同一数据、同一指标设置下比较系统。多种自动指标可以并列报告,人工评审则常用于关键子集、最终排名或指标校准。
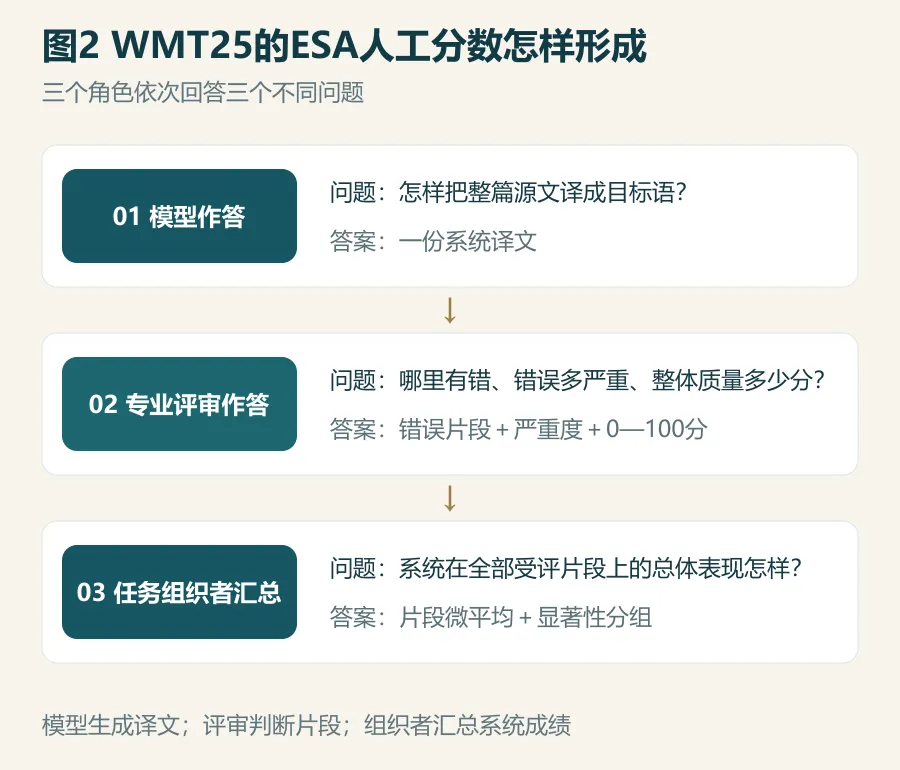
图2只呈现WMT25的ESA流程,因为后面的三组模型—人工结果都采用ESA。自动指标由程序直接计算,不存在图中的人工作答步骤;WMT25仅在英译韩和日译中使用MQM,其分数与ESA的0—100分不可混入同一张成绩表;ACES的指标排序任务已在第三节说明。因此,图2是对随后成绩表计分过程的解释,不是全部机器翻译评价方法的总览。
图2 WMT25的ESA人工评分形成过程。 第一问由模型回答:“怎样把整篇源文译成目标语?”答案是系统译文。第二问由专业评审回答:“哪里有错、错误多严重、整体质量多少分?”答案是错误片段、严重度和0—100分。第三问由任务组织者回答:“一个系统在全部受评片段上的总体表现怎样?”答案是片段分数的微平均及显著性分组。图2放在成绩表之前,是为了说明表中ESA分数的作答者、评分单位和汇总方式。依据WMT25第4.2、6和7.1节重绘。[3]
在WMT25中,组织者从官方测试集里选择译文差异较大的片段进行人工评审。模型采用零样本提示,优先接收整篇文档;如果模型不能保持段落结构,组织者才改为逐段翻译。每个受评片段由两名评审标注。英译中、英译日和英译冰岛语分别有39、40和5名评审。[3]
表6 WMT25同一年度、同一ESA协议下的三组结果
| 翻译方向 | Gemini 2.5 Pro | 本次人工参考译文 | 这组比较能说明什么 |
|---|
| 英→中 | 83.8 | 82.1 | 模型数值略高,但不是该方向最高分系统,也不能据此宣称普遍“超过人类” |
| 英→日 | 85.8 | 89.2 | 本次人工参考译文数值更高 |
| 英→冰岛语 | 77.6 | 87.5 | 本次人工参考译文优势更明显 |
这些分数是受评片段的微平均,越高表示评审判断的质量越好。不同语言方向使用不同文本和评审群体,分数不能用来判断哪种语言“更难”。“人工参考译文”也只代表本次收集的一组译文,不代表所有专业译者。
自动评分指标的可靠性仍是一个独立问题。BLEU、chrF、COMET等方法都不能保证识别每一种翻译错误。ACES初版发现,没有一种受测指标在所有错误类别上都表现最好;不少指标对增译、过度概括、现实知识和错误语言不够敏感。Kocmi与Federmann在2023年提出GEMBA-MQM,其中GEMBA是“基于GPT估计指标的评估”(GPT Estimation Metric Based Assessment),后缀MQM表示它沿用多维质量指标的错误分类体系;GPT-4参考三个示例后完成评分,因此属于少样本自动评审。Zouhar等在2026年提出对比式错误片段标注(Contrastive Error Span Annotation,cESA),让人类评审同时比较同一文档的多个译文;这项研究改进的是人工评审协议,不是新的模型排行榜。[4,9,10]
五、机器翻译题库的使命是否结束
结论是:通用场景中的目标语流畅度已明显提高,机器翻译评测的排行使命和诊断使命都没有结束。
对于信息忠实度的评测,人物关系、数字和否定等错误仍需要专项诊断;对于目标语自然度的评测,人工评价仍是校准自动指标的关键依据;对于篇章与文体,长文本、专业领域和文学翻译,尚缺统一且可比的证据;对于评分可信度的评测,ACES等研究已经证明,强指标也会在特定错误上失灵。
下一代评测应在同一批隐藏材料上依次检查关键事实、跨句关系和整篇适用性,并记录文本采样时间、模型提示、上下文范围、评审资格和汇总方法。FLORES式共同题库、WMT式年度新题、专业体裁数据和ACES式指标诊断都需要保留,因为它们分别回答不同问题。
参考资料
[1] Guzmán等. The FLORES Evaluation Datasets for Low-Resource Machine Translation (2019). https://aclanthology.org/D19-1632/
[2] Goyal等. The FLORES-101 Evaluation Benchmark (2022). https://aclanthology.org/2022.tacl-1.30/
[3] Kocmi等. Findings of the WMT25 General Machine Translation Shared Task (2025). https://aclanthology.org/2025.wmt-1.22/
[4] Amrhein、Moghe与Guillou. ACES (2022). https://aclanthology.org/2022.wmt-1.44/
[5] Papineni等. BLEU (2002). https://aclanthology.org/P02-1040/
[6] Popović. chrF (2015). https://aclanthology.org/W15-3049/
[7] Rei等. COMET (2020). https://aclanthology.org/2020.emnlp-main.213/
[8] Lommel、Uszkoreit与Burchardt. Multidimensional Quality Metrics (2014). https://doi.org/10.5565/rev/tradumatica.77
[9] Kocmi与Federmann. GEMBA-MQM (2023). https://arxiv.org/abs/2310.13988
[10] Zouhar等. Contrastive ESA (2026). https://arxiv.org/abs/2607.26640
请点击文末阅读原文查看:
机器翻译评测术语、数据集版本与详细资料