上一篇,我们给智能体装上了「知识」——它现在能查你的笔记、能记住你说过的话、能基于事实回答。手有了、知识也有了,智能体看起来「能干了」。但一个更尖锐的问题紧接着冒出来:它到底干得好不好?
你问它十个问题,它答得头头是道,你能保证都对吗?你让它跑一个调研任务,它吭哧吭哧拆了六步,你能保证每一步都做完了、没漏、没编吗?这时候最容易犯的错,是「凭感觉」——感觉它还行、感觉它退步了、感觉这个改动有提升。
感觉是会骗人的,数据不会。
先摆一句定场:没评测的智能体,就像没仪表盘的车——跑多快不知道,偏没偏不知道,翻不翻车全靠运气。 这一篇,就是给它装上仪表盘。
这篇拆五件事:先想清楚「好」的定义、再搭一组有标准答案的基准集、然后上自动化评测(规则 + LLM 当判官)、再架一个运行时监控驾驶舱、最后把这一切串成「评测驱动优化」的决策闭环。
■ 一、评测维度与北极星指标:先想清楚「好」是什么
评测的第一件事,不是写代码,而是定义「好」。这一步错了,后面全白搭——你连「好不好」都说不清,量出来的一堆数字就是噪音。
而且指标不能多,多了等于没有。我做数据十几年,一个反复验证过的教训:指标一多,团队就分不清主次,最后每个指标都看、每个都不背,等于没指标。
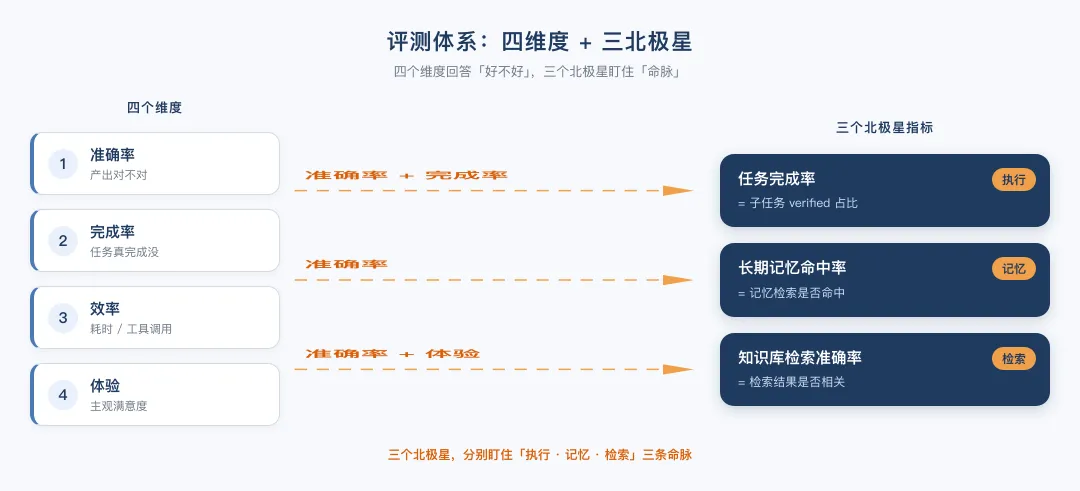
所以我把「好」收敛成四个维度,再从中挑出三个北极星指标。
四个维度
| | |
|---|
| 准确率 | | 验证器(verifier)判子任务 objective 是否达成 |
| 完成率 | | 子任务 verified 占比、计划 done/failed |
| 效率 | | monitor 的 tool_stats(total / avg_ms) |
| 体验 | | |
准确率看「对不对」,完成率看「做没做完」,效率看「花多少代价」,体验看「用起来顺不顺」。四个维度各自独立,别混在一起。
三个北极星指标
北极星指标是「最小验证」——别一上来就建几十个指标,先盯住三条命脉。超体里的三条,分别对应「执行、记忆、检索」:
1. 任务完成率 = 子任务 verified 占比。这是最硬的指标。一个复杂任务拆成 6 步子任务,6 步都通过验证器(verified),完成率就是 100%;有一步 failed,整个计划就是 failed。它直接映射到代码里的状态机:
# app/storage/task_store.py —— 子任务状态机SUB_PENDING = "pending"# 未开始SUB_RUNNING = "running"# 执行中SUB_VERIFIED = "verified"# 通过验证器SUB_FAILED = "failed"# 失败# 计划整体状态:全部 verified 才算 doneplan["status"] = PLAN_DONE if all(st["status"] == SUB_VERIFIED for st in subtasks) else PLAN_FAILED2. 长期记忆命中率 = 记忆检索是否命中了相关记忆。这个指标盯的是「它有没有真的想起你」。落到代码,是 recall_memory 每次召回都会 access_count += 1(_touch),命中越频繁、越热的记忆,下次排序越靠前——命中率低,说明该记的没记下来、或该召回时没召回。
3. 知识库检索准确率 = 检索结果是否相关。这个指标盯的是 RAG 的命脉。问「怎么做 AB 实验」,检索出来的是不是「实验设计」相关片段,而不是一堆履历。检索准不准,最终会传导到回答准不准。
为什么就三个?三个北极星分别盯住「执行、记忆、检索」三条命脉,够用了。 再多的指标,是等你发现这三个出问题后,再往下钻取的——那属于「诊断」,不是「北极星」。
■ 二、基准数据集构建:没有标准答案的评测是耍流氓
有了指标,下一个问题:拿什么数据来量?
没有标准答案的评测,是耍流氓。你给智能体十个任务,却说不清每个任务「做到什么程度算对」,那「完成率 80%」就是一句空话——它只是「你主观觉得完成了 80%」。
所以评测得有一组有标准答案的任务,也就是「基准集」。每个任务都要能落到一个可验证的 objective:要么是明确的数值,要么是能判定的产出。
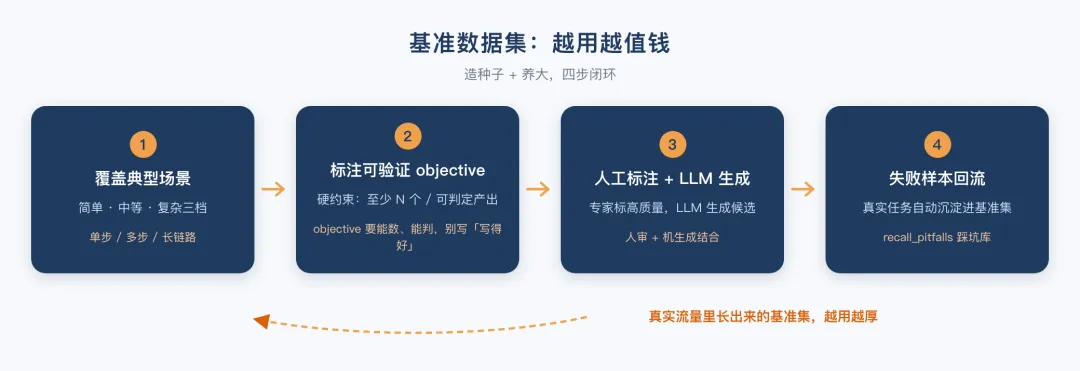
基准集要覆盖典型场景
任务按复杂度分三档,一档都不能少:
超体没单独维护 benchmark.json——用程序性记忆天然沉淀基准集
这里我要坦白一个「背后的思考」,也是超体和很多「评测平台」不一样的地方。
我没有专门造一个 benchmark.json,把一堆题目和标准答案预先写好、再单独跑一遍评分。我把「基准集」融进了程序性记忆里——每次真实任务的「目标 + 拆解 + 成败」,就是一条带标签的基准样本,而且越用越值钱。
看一个真实的例子。这是超体跑过的一个任务(就存在 data/tasks/ 里):
goal: 分析瑞士电商市场潜力并输出结构化调研报告 3. 分析瑞士市场整体潜力与机会点(至少 4 个机会点) 4. 分析进入瑞士市场的关键卡点(至少 5 个卡点)注意看,每个子任务的 objective 都带可验证的硬约束——「至少 4 个机会点」「至少 5 个卡点」「至少 4 类风险」。这就是「标准答案」:验证器不用主观猜,数一数够不够 4 个就完了。
这个任务做完、全部 verified 之后,它的「计划骨架」会被沉淀成一条程序性记忆(后面第五节细讲 save_procedure)。于是,当用户后来又让超体做「分析南美洲电商市场潜力」,超体在规划前会先检索到这条瑞士的骨架,几乎原样复用了那 6 步结构:
goal: 分析南美洲电商市场的潜力,并输出结构化调研报告 4. 分析进入南美洲市场的关键卡点(至少 5 个)这就是基准集的「自生长」:你做的每一个真实任务,都在给它喂一条新样本;做得越多,基准集越厚,规划越准。 这比憋一个大而全的静态集子靠谱得多——因为它是真实流量里长出来的,不是拍脑袋想出来的。
构建基准集有四步:覆盖典型场景 → 标注可验证 objective → 人工 + LLM 结合生成 → 持续把失败样本回流。前面三步是「造种子」,第四步才是「养大」。超体把这个闭环自动化了:失败任务会自动回流成「踩坑库」(recall_pitfalls),下次规划时拿来规避。
■ 三、自动化评测:规则评测 + LLM-as-Judge(独立验证器)
基准集有了,谁来判?总不能全靠人肉——任务一多,人工逐条看既慢又不稳定。
超体用了两条自动化路线,各管一段:
1. 规则评测:有明确对错的,用代码硬判。比如「标题长度不超 64 字符」「返回的 JSON 合法」「生成的代码能跑」「不包含敏感词」。这些不用模型,一行正则就判了,又快又准。
2. LLM-as-Judge(验证器):没有明确对错、只能「看效果」的,用独立上下文的大模型当判官,判断「子任务是否真正达成了 objective」。
超体的「验证器」就是 LLM-as-Judge 的落地,代码在 app/verifier.py,只有 77 行,但每一行都有讲究。
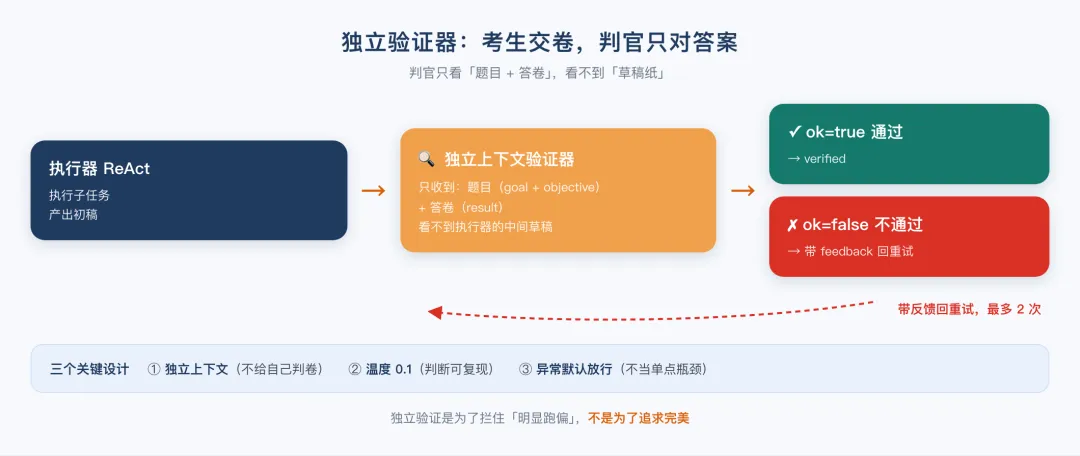
验证器的核心:一个只判「达没达成」的独立判官
先看它的系统提示词,这是整个验证器的灵魂:
VERIFY_SYSTEM = """你是任务验证器,负责判断某个子任务是否「真正达成」了它的目标。{"ok": true, "feedback": "一句话说明通过/未通过的原因"}- 只判断是否达成 objective,不评价写法好坏、不挑无关毛病。- 结果明显偏离 objective、数据缺失、逻辑错误、关键产出未完成 → ok=false,并给出具体可执行的改进意见。- 大体达成即可放行(ok=true),避免过度苛刻导致死循环。"""再看它的主函数:
asyncdefverify_subtask(goal: str, subtask: Dict, result_text: str) -> Dict:# 执行器未产出有效结论时,直接判不通过,触发重试ifnot result_text or result_text.strip() == "(达到最大执行步数,未产出明确结论)":return {"ok": False, "feedback": "执行器未产出有效结论,请重新执行并给出明确结果"} f"子任务标题:{subtask.get('title', '')}\n" f"子任务 objective:{subtask.get('objective', '')}\n\n" f"执行结果(截断):\n{result_text[:4000]}" msg = await chat_completion( [{"role": "system", "content": VERIFY_SYSTEM}, {"role": "user", "content": user}], temperature=0.1, # 判断要稳定可复现 data = _parse_json(msg.get("content") or"")return {"ok": True, "feedback": "验证器未能给出明确判断,默认放行"} ok = bool(data.get("ok", True)) feedback = str(data.get("feedback") or ("通过"if ok else"未达成 objective"))return {"ok": ok, "feedback": feedback}return {"ok": True, "feedback": f"验证器异常,默认放行:{e}"}三个关键设计,都是踩坑换来的
这段代码里有三个设计,单独看平平无奇,合起来决定了验证器能不能用。
① 独立上下文——避免「考生给自己判卷」。 注意 verify_subtask 传进去的 user 只有「总目标 + 子任务标题 + objective + 执行结果」,没有执行器的中间推理过程。执行器是怎么一步步想的、调了哪些工具、中间纠结了什么,验证器统统不知道。为什么?因为如果验证器看到执行器的完整过程,它很容易被「带节奏」——执行器说「我已经尽力了,这样应该算完成」,验证器就会倾向于放行。这叫自我确认偏差。独立上下文,就是让判官只看到「题目 + 答卷」,看不到「考生草稿纸」,逼它独立判断。
② 温度压到 0.1——判断要可复现。 验证器不是用来「创作」的,是用来「判案」的。同样一份结果,今天判通过、明天判不通过,那评测就废了。所以温度压到 0.1,让判断尽量稳定、可复现。
③ 默认放行兜底——避免验证器成为单点瓶颈。 看最后的 except:验证器一旦异常(网络抖动、JSON 解析失败、模型超时),它默认 ok=True 放行,而不是卡住整个任务。这里有个很反直觉但很重要的取舍:验证器是「拦住明显跑偏」的,不是「追求完美」的。如果验证器任何瑕疵都判不过,子任务就会无限重试、死循环。
空结果要「重判」——一个隐蔽但重要的分支
再看 verify_subtask 开头那个分支:如果执行器压根没产出有效结论(空字符串,或者那句「达到最大执行步数,未产出明确结论」的兜底文案),直接 ok=False,走重试,根本不用浪费一次 LLM 调用去判一个空结果。
这是踩坑换来的:执行器有时会「跑满 20 步还不停」或者「总结也失败」,最后吐出空结论。这种空结论拿去给验证器判,验证器会一脸懵(没有内容可判),大概率乱放行。所以干脆在入口处硬拦截——空结果,必然不合格,必然重试。
验证器怎么接进执行循环
验证器不是孤立跑的,它嵌在编排器的子任务执行循环里(app/orchestrator.py):
MAX_STEPS = 20# 单个子任务内最多工具调用轮数,防原地打转MAX_RETRIES = 2# 验证失败后带反馈重试的最大次数# 执行 → 验证 → 不过就带反馈重试(最多 2 次)final_text = await _loop()ok, feedback = await verifier.verify_subtask(goal, subtask, final_text)whilenot ok and retries < MAX_RETRIES: final_text = await _loop(feedback=feedback) # 把反馈塞回给执行器 ok, feedback = await verifier.verify_subtask(goal, subtask, final_text)status = SUB_VERIFIED if ok else SUB_FAILED注意那个 _loop(feedback=feedback):验证失败时,反馈会被拼回执行器的 prompt 里,变成一句「【上次未通过验证,改进意见】……请据此修正后重新完成」。这不是简单地重跑一遍,而是带着「哪儿不对」的重跑。
举个例子。瑞士电商调研任务里,第 3 步「分析市场潜力与机会点」的 objective 要求「至少 4 个机会点」。假设执行器第一次只列了 2 个,验证器就会判 ok=false,feedback 大概是「机会点数量不足 4 个,请补充高增长品类、目标人群等维度」。执行器带着这条反馈重跑,补到 4 个以上,第二次才 verified。
这就是 LLM-as-Judge 相对纯规则的优势:规则只能判「有没有」,验证器能判「对不对、还差什么」,并给出可执行的改进方向。
JSON 解析要「鲁棒」——模型不一定乖乖只吐 JSON
最后一个细节,_parse_json。提示词说「只输出 JSON,不要解释」,但大模型没那么听话,它可能给你包个 ```json `` 代码块、可能在前后加点废话。所以解析不能只 json.loads` 一下了事,要兜底:
def_parse_json(text: str): text = (text or"").strip() text = re.sub(r"```(?:json)?", "", text).replace("```", "").strip() # 剥掉代码围栏except json.JSONDecodeError: s, e = text.find("{"), text.rfind("}") # 兜底:截取第一个 { 到最后一个 }if s != -1and e != -1and e > s:return json.loads(text[s:e + 1])except json.JSONDecodeError:先剥代码围栏,再整体解析,失败就退而求其次截取 {...} 区间。这种「能抢回多少算多少」的鲁棒解析,是 LLM 工程里的基本功——永远别假设模型输出是规规矩矩的。
■ 四、运行时监控:把 monitor 驾驶舱当成「在线仪表盘」
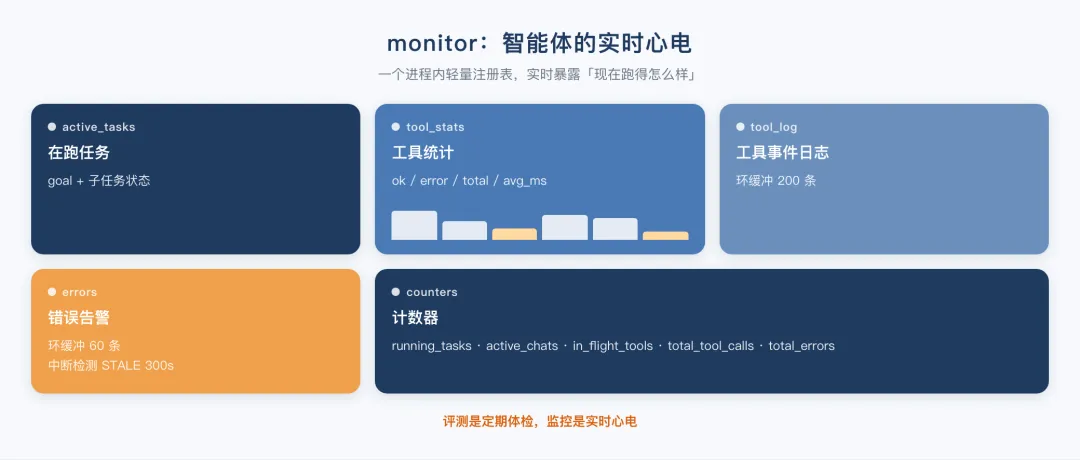
离线基准集测的是「能力」,运行时监控看的是「表现」。这两件事分工不同:评测是「定期体检」,监控是「实时心电」——一个看长期能力,一个看当下健康。
超体的监控就是 app/monitor.py,一个进程内的轻量注册表,实时暴露「现在它跑得怎么样」。后台管理里的「监测驾驶舱」就是轮询它的 snapshot() 画出来的。
snapshot() 五件套 + 计数器
# app/monitor.py —— 快照返回结构"active_tasks": [...], # 在跑的任务 + 子任务状态"active_chats": [...], # 活跃聊天流"in_flight_tools":[...], # 正在执行的工具"tool_log": [...], # 工具调用事件日志(环缓冲 200 条)"tool_stats": [...], # 每个工具的 ok/error/total/avg_ms"errors": [...], # 错误告警(环缓冲 60 条)"total_tool_calls": ..., # 累计工具调用次数"total_errors": ..., # 累计工具出错次数为什么埋点要细到「每次工具调用」
工具是智能体「动手」的唯一通道。它不会凭空做事,所有对外动作——搜索、读文件、跑 Python、写报告——都走工具。所以工具调用的成败分布,直接暴露系统哪根筋搭错了。
埋点就埋在工具执行的入口和出口:
deftool_start(source, context, tool, args) -> int:deftool_end(eid, ok, error=""):# 按工具名累计 ok/error/total/total_ms st = _tool_stats.setdefault(tool, {"ok": 0, "error": 0, "total": 0, "total_ms": 0})于是你在驾驶舱里能一眼看到:web_search 调了 40 次、错了 3 次,平均 1.2 秒;execute_python 调了 12 次、错 0 次。某个工具错误率突然飙升,就是那条链路出问题的第一信号。
三个工程细节:环缓冲、脱敏、中断检测
监控代码看着简单,但有几个细节值得说:
① 环缓冲,防内存爆炸。tool_log 只留最近 200 条、errors 留 60 条、每个任务留最近 30 条工具链。一个任务跑几个小时,工具调用成千上万次,如果全存内存,服务迟早被拖死。环缓冲把「看当前」和「控内存」平衡了。
② 参数脱敏,别把大段内容塞进监控。 看 _args_summary:工具参数会被压成一行短摘要,单值超 30 字符截断、最多取 2 个字段、总长 60 字符。为什么?因为 write_file 的参数可能是一整篇文章,全塞进监控日志既占内存又难读,还可能泄露内容。监控只要「它调了什么、成败如何」,不要「它写了什么」。
③ 中断检测,揪出「卡死」的任务。 一个任务超过 STALE_SECONDS = 300(5 分钟)没有任何活动、且没有在途工具,snapshot() 会把它判定为「疑似中断」并告警。这解决了一个真实痛点:客户端断连会导致执行生成器悄悄关闭,任务卡在 running 状态永远不动。监控里多补一层,后台接口(/api/admin/monitor)还会把「磁盘上是 running、但实时监控里没有」的任务单独列为 interrupted_tasks,专门揪进程重启留下的残局。
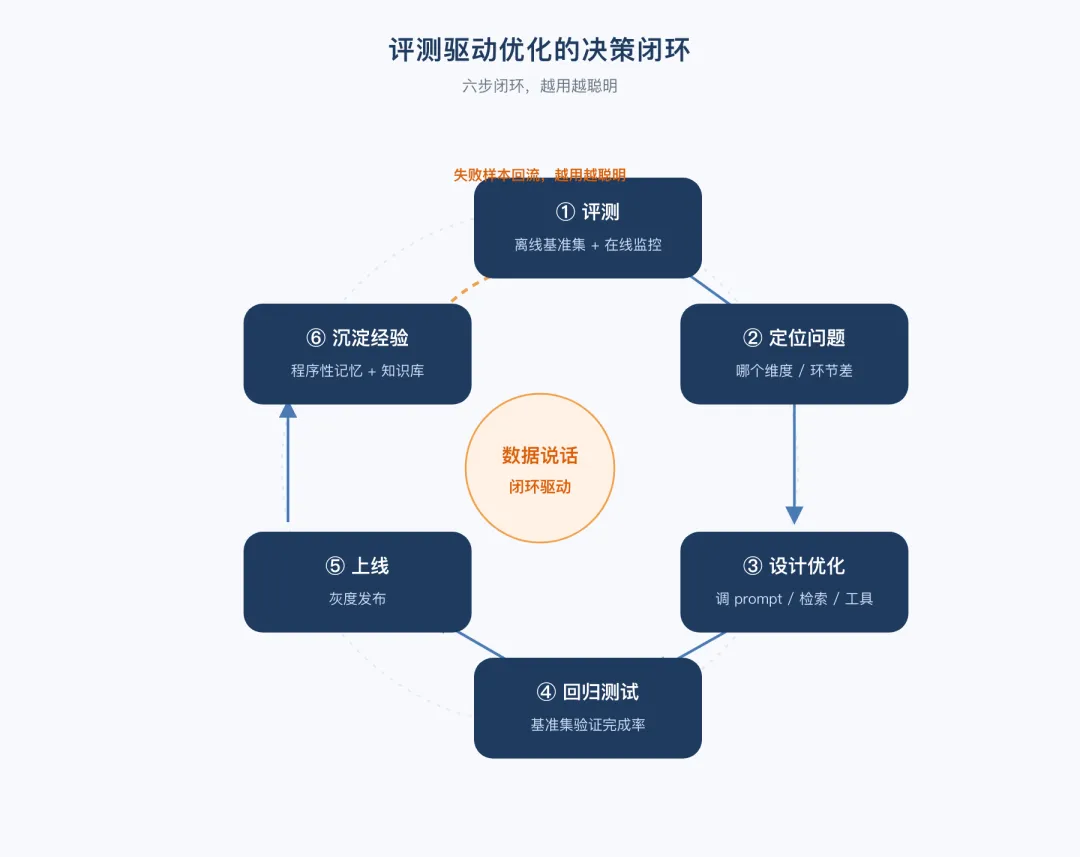
■ 五、评测驱动优化的决策闭环
评测不是终点,是优化的起点。你量出了「哪个维度差」,还得把「差」变成「改」,把「改」再量回来——否则评测数据就是一堆好看的报表,没有价值。
我把这套东西串成六步闭环:
评测(离线基准集 + 在线监控)→ 定位问题(哪个维度、哪个环节差)→ 设计优化 → 回归测试(基准集验证)→ 上线(灰度)→ 沉淀经验(程序性记忆 + 知识库)这里有两句我最看重的话:
第一句:回归测试是「敢大胆改」的底气。 每次改动(调 prompt、调检索权重、换模型),都在基准集上跑一遍,对比完成率 baseline。能回滚、能追溯,才敢动手改。没有回归测试,你改一行代码都是赌博——改完不知道变好了还是变差了。
第二句:先验证再上实验。 策略上线前,先用离线数据验证方向,再上真实流量。这是我的老本行(做数据十几年),也是智能体优化的同一条铁律:别拿真实任务当小白鼠。
沉淀经验:失败样本怎么回流成「下次的铠甲」
闭环的最后一步「沉淀经验」,在超体里是自动化的,代码在 save_procedure。每次任务结束,不管成败,都会把「怎么拆的 + 怎么执行的 + 踩了什么坑」沉淀成程序性记忆:
# app/storage/long_term_memory.pydefsave_procedure(goal, subtasks, outcome, task_id=None, source=None):ifnot goal orlen(subtasks) < 2:# 计划骨架 + 执行轨迹(skill)+ 踩坑(pitfalls)"plan_template": [...], # 每步 title + objective"skill": [...], # 每步实际调用的工具序列"pitfalls": [...], # 失败步骤的验证反馈 confidence = 0.9if outcome == "success"else0.5注意那个 confidence = 0.9 if success else 0.5:成功的经验置信度高、优先复用;失败的经验置信度低,专门进「踩坑库」用来规避,而不是用来模仿。
规划阶段(routers/plan.py)会先检索这两样东西:
plan_template = ltm.recall_procedures(goal, top_k=3) # 成功骨架 → few-shotpitfall_text = ltm.recall_pitfalls(goal, top_k=3) # 失败踩坑 → 规避plan = await planner.plan_goal(goal, ..., plan_template=plan_template, pitfall_text=pitfall_text)这就是前面第二节那个「瑞士 → 南美」复用的底层机制:瑞士的成功骨架进了 recall_procedures,南美规划时就把它当 few-shot 起点。
再看一个失败回流的真实例子。超体跑过一个「调研 arXiv 数据科学 Agent」的任务,结果:
goal: 调研2026年arXiv上数据科学在Agent领域的最新研究成果,并生成一份调研报告 2. verified 从arXiv获取候选论文元数据 6. failed 撰写调研报告 ← 最后一步没通过验证前五步全 verified,最后一步「撰写调研报告」失败,整个计划判为 failed。这个失败不会被浪费:save_procedure 会把它以 confidence=0.5 存进去,最后一步的验证反馈进 pitfalls。下次再跑同类 arXiv 调研,recall_pitfalls 会把「撰写报告这步容易翻车」的坑提前塞给规划器,让它换种拆法或加强那一步的 objective。
这就是「越用越聪明」的真相:不是模型变强了,是失败被记住了、下次被规避了。
■ 写在最后
拆完这一篇你会发现,「评测」不是锦上添花,是智能体能不能「持续变好」的地基:
• 先定义「好」:四个维度、三个北极星,别让指标泛滥;
• 再搭基准集:没有标准答案的评测是耍流氓,而超体让基准集从真实任务里「自生长」;
• 上自动化评测:规则管「有没有」,LLM 独立验证器管「对不对、还差什么」;
• 架运行时监控:评测是定期体检,监控是实时心电;
• 串成闭环:把「差」变成「改」,把「改」再量回来,把「失败」沉淀成「下次的铠甲」。
而这一切的底层,还是那句老话——有指标看指标,没指标先造一个最小验证。 评测的价值不在「证明它有多好」,而在「精准地指出它哪里差」。能定位到「哪个维度、哪个环节」的差,优化才不是瞎猫碰死耗子。
尺子配好了,接下来才是重头戏:拿着这把尺子,去量出问题、再把问题一个一个干掉。 下一篇,我们进入「效果优化实战」——基于评测数据,系统讲检索、提示词、工具「三管齐下」的优化手段,以及那些真实踩过的坑。
本文为《从0到1构建一个能"记住你"的智能体》系列第 7 篇。下一篇:《效果优化实战:检索、提示词与工具的三管齐下》。