一份机器人评测报告,把 GPT-6 Astra 排在了四十个模型的最上面。同一份报告的真机部分,第一行是停测通知。
发布方是 RoboDojo 团队。他们按官方协议让 Astra 跑完 42 项仿真任务、每项 50 次,再把这批结果和公开榜上 40 个模型放在一起重排:28.97 分,第一,比公开榜头名的 VLA(视觉-语言-动作模型)DM0.5 高出 4 分。
然后他们把同一套外壳接到真机上。测试因为 Astra 反复发出物理上不合理或不安全的动作、部分事故损坏硬件而中止,原定的 18 项真机协议没有跑完。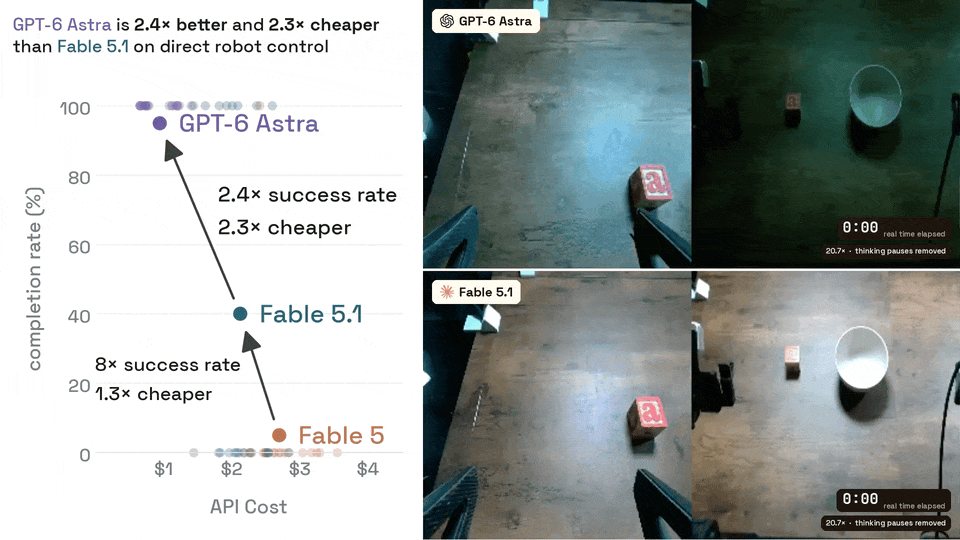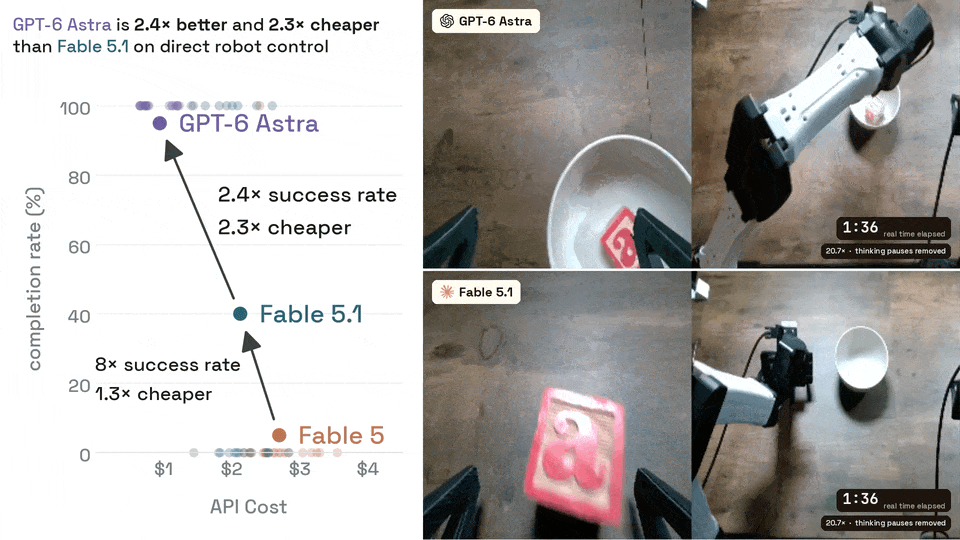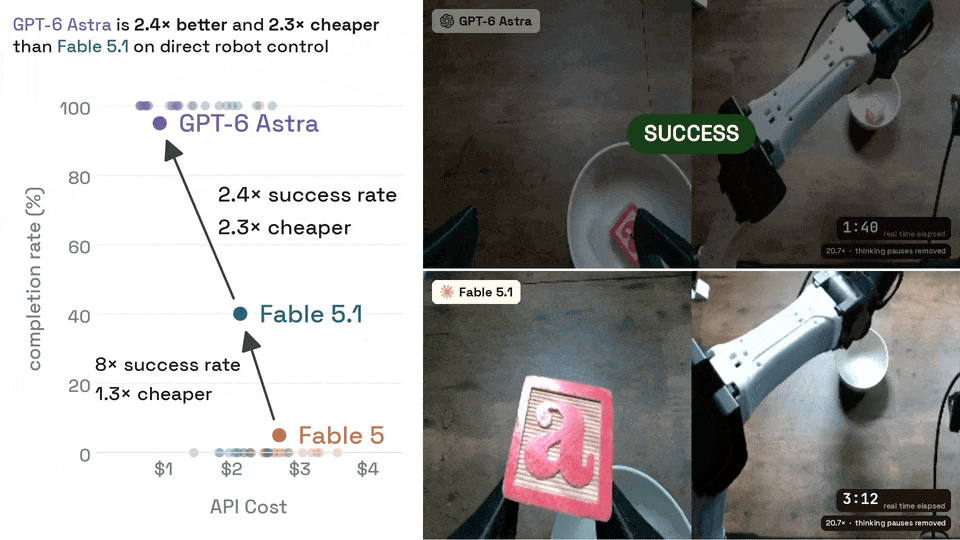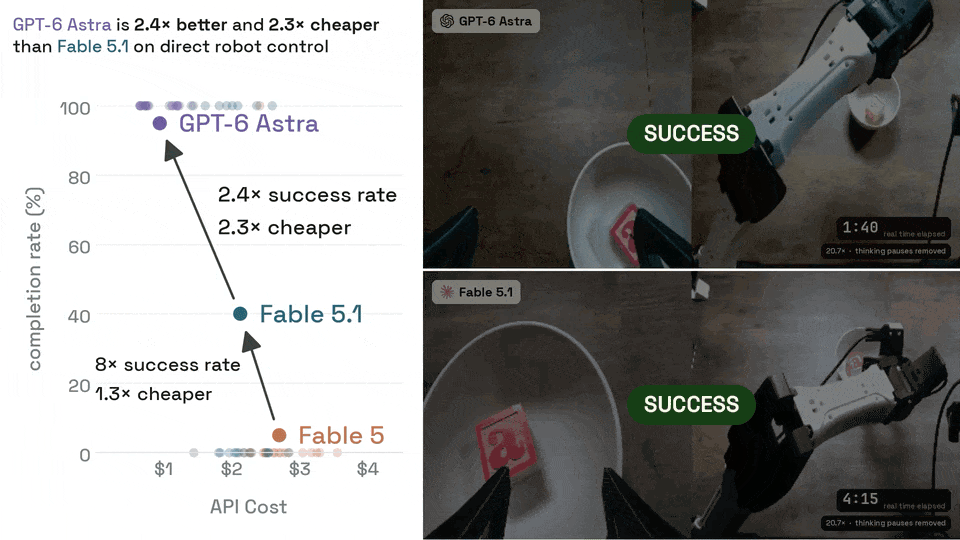
这份报告里会出现三个数字:28.97、22.48%、1/33。它们出自同一份报告,讲的是三件事,合起来才是“大模型能控机器人”这句话现在的成色。
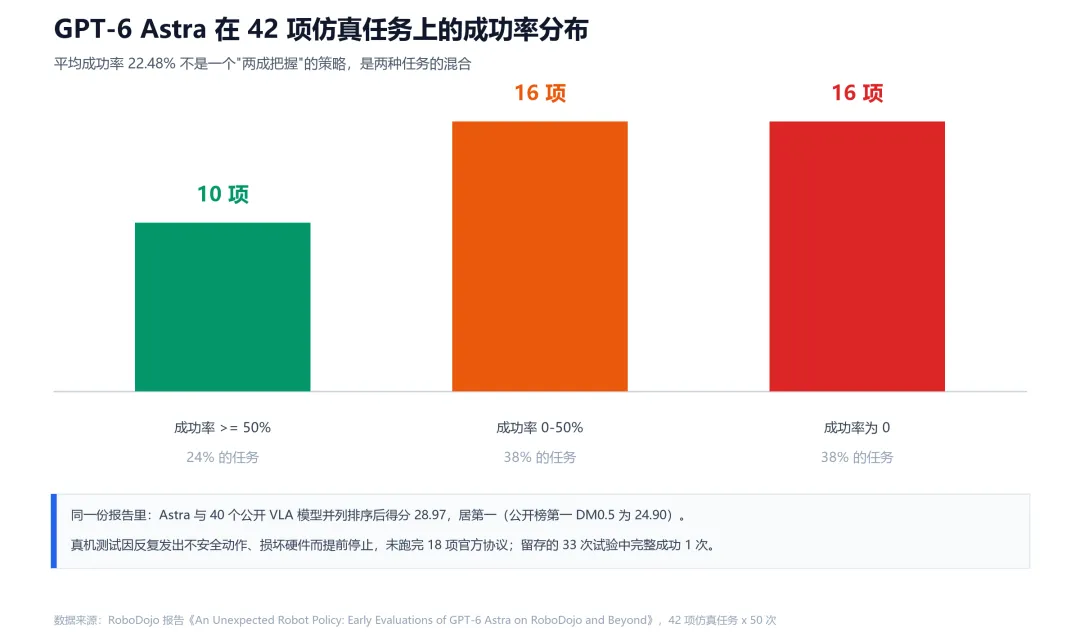
22.48% 不是“两成把握”,是两种任务的混合
主素材里传播最广的是另一个数:Robocurve 把 Astra 接进机器人后,在一项机器人控制任务上测出 95%的成功率,高于 Fable 5.1 的 40%。
单项任务的 95%,和 42 项任务平均出来的 22.48%,是两个量。看机器人的“成功率”,得先问它量的是什么。
RoboDojo 这份报告拆得很细。42 项里,10 项的成功率站上 50%,16 项是 0。
报告对它的定性是:这是两个任务群体的混合。
跟公开榜头名 DM0.5 逐项比,Astra 在 15 项上领先超过 5 分,在 11 项上落后超过 5 分,剩下 16 项差距在 5 分以内。
分界线也看得见。几何对齐、编号或代数指令、按语言条件堆叠排序,这些任务 Astra 赢:push_T 它拿到 60.0%,小米-Robotics-1 是 0.7%;arrange_largest_number 它 60.0%,对手 4.7%。
连续接触和多步骤物理脚本反过来。make_kong 它 0.0%,GalaxeaVLA 做到 90.0%;build_tower 它 2.0%,对手 78.7%。
看得懂,却拿不稳
报告把大模型在机器人上的能力分成三层:语义理解、空间理解、物理常识。
前两层都给了“强”:能听懂指令、认出物体、在三维空间里推理,静态操作能做完。第三层是瓶颈,报告管它叫 Physical Commonsense——对接触动力学、受力、碰撞几何的隐性理解。
报告里有这样一句:
一个能叫对物体名字的模型,还是可能抓空;一个能写出看起来合理路径点的模型,还是可能保持不住接触。
卡住的地方集中在三类任务:需要插入或带摩擦堆叠的接触密集操作、公差很紧的精密放置、绕过杂物的避障。
340 组匹配了任务与布局的对照实验里,什么都不给,零样本成功率 22.9%;给一张图像演示,掉到 17.9%;给一段文字演示,掉到 12.9%。
报告的解释是:基本操作技能本来就在模型权重里,缺的是精度。一段来自不同布局的演示改变不了这件事,还可能把模型带偏。
另一面的数据是,它在被打乱输入之后的自我修复很强。图像上下翻转,8 种布局全部恢复;左右镜像,6/8;笛卡尔坐标轴取反,4/8;遮掉头部相机,6/8。
同一个外壳,换个模型差 25 倍
这份报告按动作路径上是什么,把大模型驱动机器人的系统分成三级:
- L1:冻结的 VLA,动作全由训练好的策略产生,公开榜大多在这一级
- L2:模型负责布置任务或点名技能,动作仍由 VLA 发出
- L3:动作路径上没有 VLA,模型通过一层固定的、非学习的 harness(可以理解成“外壳”)输出动作
这次评测在 L3。harness 用的是 Robocurve 的 Inspect EEF:模型只有两个工具,移动末端执行器,或者放弃。本地代码把模型给的目标点限制在边界内,插值成关节轨迹,再按 25 Hz 开环播放。
模型看不到物体的标签和场景布局数据,也没有“声明成功”这个工具——成功与否由仿真器在回合结束后自己判定。报告对这套设定有一段说明:
方法是一层 L3 机器人外壳;GPT-6 Astra 是被测的规划器。
同一个外壳下,三个模型的结果差别很大:Astra 22.48%,DeepSeek-Flash 1.92%,GPT-5.5 0.88%。其中 DeepSeek-Flash 每项任务只跑了 10 次,另外两个各 50 次,样本量小一截,报告在它出现的每个位置都单独标了这一点。
所以基模本身很关键——换个模型,差 25 倍。但 22.48%这个数也说明,模型加一层外壳,离“能用”还有距离。
补上的那一层,是把经验管起来
穹彻智能开源的 RoboRSI 走的是另一条路:不动模型,去补系统。
它要回答两个问题。机器人报错停下、抓取失败、位置偏移之后,谁来做结果检查、异常恢复、安全决策?还有,这一轮跑出来的轨迹、日志、视频、代码,下一轮怎么真正用上?
主素材里有一句话概括了这件事的分量:
Context 管理是新时代的代码管理。
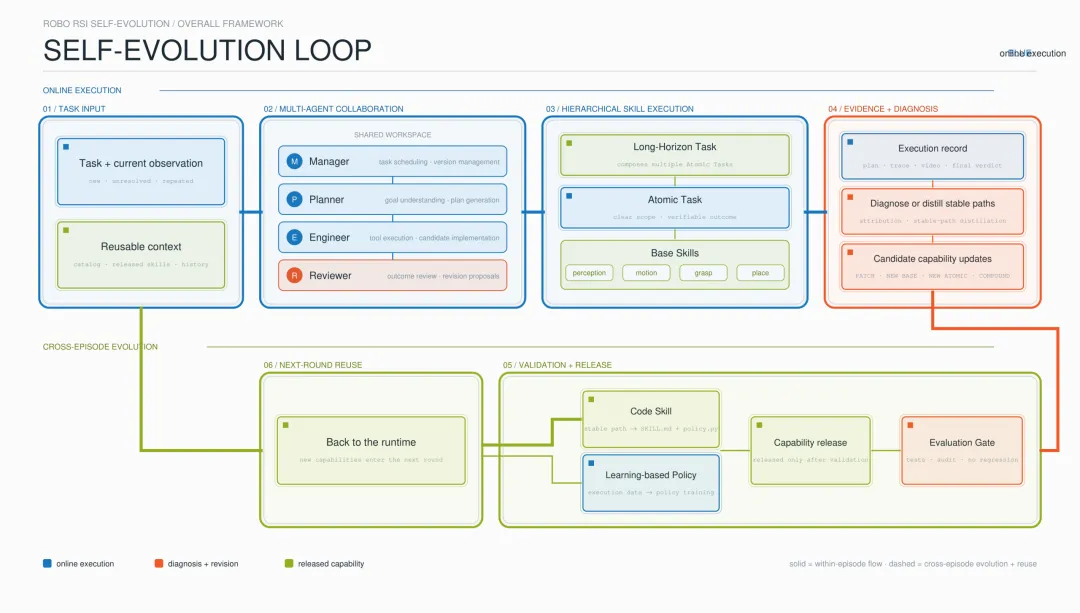
RoboRSI 的做法是把任务拆给四个角色:Manager 管任务队列、并发执行、断点恢复和技能版本;Planner 根据当前观察和已有技能生成计划;Engineer 调机器人的底层工具执行动作;Reviewer 看日志、视频、轨迹复盘,定位失败原因,把修订建议交回 Manager。
四个角色围着同一份执行证据接力,形成“执行→诊断→修订→再执行”的闭环。人留在目标、价值判断和安全边界这一层,不跟每一次底层动作。
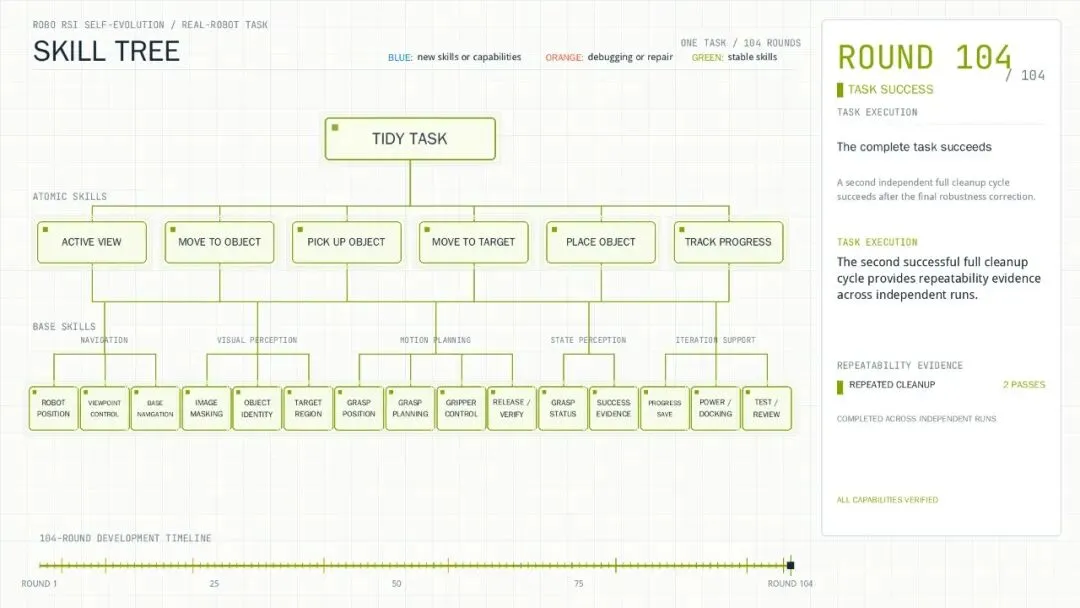
第二个问题是经验怎么沉淀。RoboRSI 用 TSR(自顶向下技能细化)把能力组织成一棵四层技能树:任务族→复合技能→原子任务→基础技能。比如“家庭地面清理”是任务族,“搜索目标→移动→抓取→放置”是复合技能,“抓起地上的黄色包装袋”是原子任务,视觉感知、移动控制、抓取、放置是基础技能。
这棵树的作用是给写代码的模型一个结构约束:每次修改都限制在明确的技能边界内,改局部而不会偏离全局目标。失败则沿着调用路径回溯到最早出错的节点,改那一支。
稳定下来的分支会被固化成代码。同类任务再来,模型只在必要时介入,重复的工具调用交给代码跑。
官方博客里给出的数字:
- LIBERO 的 120 项任务 × 5 组初始布局、共 600 个回合里,启用代码固化后回合通过率从 21.5% 升到 29.0%,中位 Token 消耗降 29.4%,中位 VLM 调用降 27.2%,中位执行时间降 17.0%
- RoboTwin 上,完整多智能体配置(Planner + Engineer + Reviewer)的累计任务通过率为 36/50,只用 Engineer 单角色的基线是 9/50
成本上的对照更直接:2024 年做一个同类的家庭地面清理 Demo,需要两名工程师投入约一个月、写 2,000 到 3,000 行任务代码。按官方博客的说法,同类能力的构建在 RoboRSI 下约一天走完一个完整闭环。
想自己跑一遍,一条命令
前置就三样:Python 3.12 以上;一个 OpenAI 兼容端点(或 Anthropic)的 API Key;能访问 HuggingFace 下载评测资产。
主路径是一键脚本,可直接运行:
git clone https://github.com/nssmd/RoboRSI.git && cd RoboRSI
export OPENAI_API_KEY="..."scripts/reproduce_libero_pro.sh
这个脚本会依次做完这些事:建隔离环境、装 RoboRSI、clone LIBERO-PRO 基准、从 HuggingFace 的 zhouxueyang/LIBERO-Pro 数据集下载官方扰动资产、配置并体检后端、启动 PyRoKi 的逆运动学与轨迹服务、跑一次冻结的 code-on Pass-1 评测,最后独立复核 journal。
README 写明它幂等、可断点续跑——中途断了,重跑同一条命令。
想逐步看清每一步在做什么,官方另给了一套手动命令,可直接运行,摘自仓库 README 的手动安装一节:
pip install -e ".[libero]"git clone --depth 1 https://github.com/Zxy-MLlab/LIBERO-PRO.git
hf download zhouxueyang/LIBERO-Pro --repo-type dataset --local-dir ./LIBERO-PRO-assets
roborsi libero configure \
  --root ./LIBERO-PRO \
  --bddldir ./LIBERO-PRO-assets/bddl_files \
  --initdir ./LIBERO-PRO-assets/init_files
roborsi libero doctor --backend libero --task libero_object/0 --reset
最后那条是体检,验证三件事:能不能导入 LIBERO、能不能枚举任务、能不能真的重置一次环境。三样都过,环境才算装好。完整步骤在仓库的docs/INSTALLATION.md。
跑起来之后,成功由仿真器说了算
跑单项任务评测,可直接运行:
roborsi eval libero_pick_place \
  --backend libero \
  --sim-task libero_object/0 \
  --seeds 5 \
  --tool-budget 40
跑 LIBERO-PRO 的批量 pass@K(同一个任务跑 K 次,看至少成功一次的比例),可直接运行:
roborsi eval-suite \  --backend libero-pro \
  --pass-at 5 \
  --seed-start 0 \
  --workers 4 \
  --tool-budget 40 \
  --code-on \
  --out ~/.roborsi/evals/libero-pro-pass5
成功与否只由仿真器在 Agent 循环结束后自己判定。代码缺陷被单独记为implementation_error_count,不混进任务失败里;网络之类的基建故障单独记,也不当成模型不行。
想复核一个跑完或跑了一半的评测,直接读 journal:
roborsi eval-audit ~/.roborsi/evals/suites/libero-pro-matched-pass1 \  --check-media \
  --require-complete
还有一个网页控制台,可直接运行:
roborsi web # 演化看板 :8787 · Manager 控制台 :8795
然后是要说清的边界。
新评测不回放上面那些累计成绩。README 写明,一次新的 campaign 评测的是当前冻结的 release。你跑出来的数字不会等于 95/120。
累计任务通过率的口径,是“至少通过过一次”的任务数,跨多个演化中的 release 统计。它不是固定策略分数,也不是常规那种固定方法的 pass@k。95/120 和 22.48%放在一起会打架,因为它们量的是两回事。
还有门槛:要 API Key、要仿真环境、要下几个 GB 的评测资产,不是插上机械臂就能跑。仓库目前 85 个 star、5 个 fork、两名贡献者,没有发布版本。它是一份研究预览。
写在最后
这份报告对“大模型能不能控机器人”的回答是分层的:语义理解在,空间理解在,物理常识还没到。仿真榜上它能排第一,真机上这份报告写的是测试中止。
所以下一次再刷到“某某模型在机器人榜上第一”,先问四个问题:测了几项任务、每项跑了几次、是单项还是平均、上没上真机。
榜单量的是它偶尔做对多少次;这四个问题,问的是它做错的时候会撞坏什么。
[RoboRSI GitHub 仓库]:https://github.com/nssmd/RoboRSI
[RoboRSI 技术博客]:https://lab.noematrix.ai/blog/2-roborsi/
[RoboDojo 评测报告]:https://robodojo-benchmark.com/report/gpt-6-astra-eval
参考链接:[1] https://arxiv.org/abs/2607.04434[2] https://huggingface.co/datasets/zhouxueyang/LIBERO-Pro
「点赞」「转发」「小心心」,欢迎在评论区留下你的想法!
免责与版权声明:本文资讯及观点仅供技术交流参考。文中引用图片均源于网络公开渠道(如官方博客、社交平台等),著作权归原作者所有。本文旨在分享与评述技术进展,符合“合理使用”原则。如相关图片/内容涉及版权侵权,请联系我们(留言或私信),我们将核实后立即删除。