你的公司要选一个大模型部署。市场上候选至少 5 个——GPT-5、Claude Sonnet 4.5、DeepSeek V4、Qwen3、GLM-5。
你怎么选?
如果看各家自己报的分数,每一个都"业界第一"。GPT-5 说 AIME 2024 解了 94.6%,Claude 说 SWE-bench Verified 74.2%,DeepSeek 说它的 GSM8K 是 96.4%。全是自己的数字,全没有统一基线。
这就是大模型评测的根本问题:评测自己设计,等于学生出题给自己做。
这篇把评测这件事聊清楚——为什么要独立基准、主流评测集(MMLU、HumanEval、GSM8K、AGIEval)怎么测、OpenCompass 这种工具链怎么用、以及怎么识破"刷榜"的游戏。
一、为什么不能只看厂商宣称
大模型战场,分数是营销的弹药。每家发布新模型都要发"我们 MMLU 跑分 XX.X%",但仔细一看:
- MMLU 是指哪个版本?是原始 5-shot 还是零样本?是 chain-of-thought 还是直接输出?
- 细节变体数不清:正式 MMLU vs MMLU-Pro vs MMLU-Redux vs MMLU-CF,一个比一个难
这种"数字不说明方法"的宣称,和"我百米 12 秒"不说风速、不说场地、不说电子计时还是手动没区别。
更糟的是数据泄漏:如果模型在训练时"刷过" MMLU 的题目,它跑 MMLU 就是"考试带了答案",这个分数毫无意义。
业界对这件事已经失去了耐心,所以OpenCompass、lm-eval-harness、HuggingFace Leaderboard这种"第三方独立基准"变成了刚需。
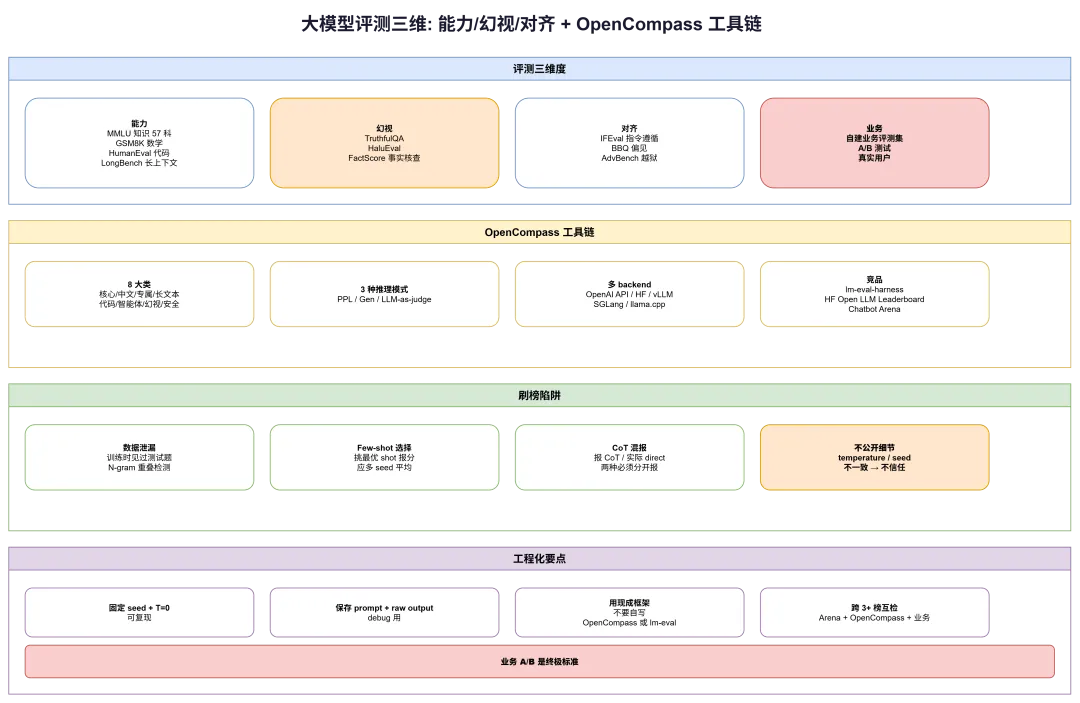
二、评测三大目标:能力 / 幻视 / 对齐
大模型评测不是单一维度,分三类:
1. 能力评测(Capability)
最直观:模型会不会某件事。
- 数学推理: GSM8K(小学数学应用题)、MATH(高中数学)、AIME(竞赛)
- 代码生成: HumanEval(Python 编程)、MBPP、SWE-bench(真实 GitHub issue 修复)
- 常识推理: HellaSwag、ARC、PIQA、SIQA
- 知识问答: MMLU、TriviaQA、Natural Questions
- 长上下文: NIAH(大海捞针)、LongBench、RULER
这类基准的变化趋势是越来越专业——从"通用理解"测到"前沿数学"再到"软件工程"。
2. 幻视评测(Hallucination)
模型说假话的程度。
大模型有时会"编造"看起来像事实的内容——你说"巴黎铁塔高多少米",它说"300 米"(实际 330 米),或者直接说"巴黎铁塔在法国里昂"。
- TruthfulQA: 故意出"容易答错"的题,看模型会不会被诱导说假话
- FactScore: 把长回答拆成原子事实,逐条核对
幻视率在很多场景比能力更重要——医疗、法律、金融场景你宁可模型说"我不知道",也不能乱答。
3. 对齐评测(Alignment / Safety)
模型符不符合人类价值观。
- 偏见: BBQ、StereoSet、RealToxicityPrompts
- 隐私: Enron 邮件泄漏测试——模型是否会"背出"训练数据里的真实 email
- 越狱: AdvBench、JailbreakBench——测有多大比例你能通过 prompt 工程让模型说违禁内容
- 指令遵循: IFEval——模型是否严格听从格式要求
对齐评测决定了模型能不能真的生产化。
三、主流基准详解
MMLU: 曾经的核心基准
MMLU (Massive Multitask Language Understanding) 是 2020 年推出的基准,57 个科目:从数学到法律到医学到历史到哲学,每个 100 道题。
大概 1.4 万题,靠 4 选 1 做多选题。
它曾经的意义: GPT-3 在 MMLU 拿了 43%,被认为是"接近随机"(25%)的水平;GPT-4 是 86%,被认为突破。这个分数差定义了一个时代。
它的问题:
- 太老。2020 年设计,那时候大模型才起步,很多题目对今天模型过于简单
- 数据泄漏风险。一旦题目进了 GPT-4 的预训练集,就跑分没有参考意义
- 区分度低。今天 90% 以上的模型都能跑 75+,大家都挤在一起,无法区分谁更好
业界逐步转向MMLU-Pro(更难、更多题目)和MMLU-Redux(剔除错误题目重新打分)。
HumanEval: 代码生成的标准
HumanEval 是 OpenAI 2021 年推出的基准,164 道 Python 编程题,测"看注释写代码"能力。
每道题给一段函数签名 + 中文注释,让模型补全函数体,然后跑测试用例。
评价指标是 pass@1 / pass@10:模型生成 1 个解答能通过测试用例的比例(或生成 10 个中有无任何一个通过)。
现状:GPT-4 时代是 67%,DeepSeek-Coder V2 是 90%+,Claude Sonnet 4/4.5 是 92%——已经接近饱和。
新的更难基准是 SWE-bench——用真实 GitHub issue 作为测试,难度远超 HumanEval。
GSM8K 和 MATH: 数学推理
GSM8K 是 8500 道小学数学应用题。题目不难但需要多步推理,比如"小明有 10 个苹果,吃了 3 个,又买了 5 个,分给 4 个朋友每人 2 个,还剩几个?"
MATH 是更难的高中数学:竞赛级几何、代数、几何、数论。
这两个基准都在被数据泄漏或刷榜污染。今天主流模型都跑到 90%+,区分度已经不够。
业界逐步转向AIME(美国数学邀请赛真题),难度更高。
AGIEval 和 BIG-Bench
AGIEval 是 2023 年推出的基准,用真题+标准化考试:SAT、GRE、GMAT、LSAT、高考、公务员考试、法考、注会……
它是用人写的真实考试题作为"通用智能级别"的检验。中国背景特别强(高考、公务员)。
BIG-Bench(Google 2022)是一个超大集合,任务类型千奇百怪:从语言学到物理学到逻辑谜题到软件工程——算总库 200+ 任务,考察"非常规能力"。
四、OpenCompass: 评测界的"集成框架"
定位
OpenCompass 是上海 AI Lab 主导的评测工具链——它不是一个"基准",而是一个"框架",让你可以用同样的接口跑 100+ 个基准。
它做三件事:
- 统一评测接口: 不管你测 MMLU 还是 HumanEval,用同一份配置文件
- 支持多种推理 backend: OpenAI API / HuggingFace transformers / vLLM / SGLang / Llama.cpp
- 官方维护排行榜: 跑完的分数上报,自动和业界其他模型对比
架构
OpenCompass 的核心是**"数据集 + 模型 + 评估器"三件套配置**:
datasets: [mmlu, gsm8k, humaneval, truthful_qa]models: [my-llama-3-70b]evaluator: gen | ppl | llm-as-judgesummarizer: default
三种推理方式:
- PPL(perplexity)评估:测模型对候选答案的概率排序,不需要真的生成 token
- Gen(generative):让模型自由生成再 parse 答案,更真实但解析难
- LLM-as-judge:让另一个大模型(GPT-4)打分判断"这个回答好不好"
主要数据集分组
OpenCompass 把所有数据集分成8 大类:
- 核心基准:MMLU / C-Eval / GSM8K / HumanEval / BBH
- 中文基准:CMMLU / C-EVAL / GAOKAO-Bench / Xiezhi
- 专属语言:CHID / WPLC / WSC Winograd
- 长文本:LongBench / L-Eval / NIAH
- 代码:HumanEval / MBPP / DS-1000 / SWE-bench
- 智能体:ToolBench / AgentBench / API-Bank
- 安全:AdvBench / RealToxicityPrompts / BBQ
- 主观:MT-Bench / AlpacaEval / AlignBench
这种分组反映了评测的"全面性": 不能只看一个基准,要看 8 维度的综合表现。
竞品: lm-eval-harness 和 HuggingFace Leaderboard
OpenCompass 不是唯一:
- lm-eval-harness(EleutherAI)是另一个开源评测框架,2021 年起步,社区极活跃
- HuggingFace Open LLM Leaderboard 早期是最大的排行榜,靠 Arc/HellaSwag/MMLU/TruthfulQA/Winogrande/GSM8K 六个基准平均分排名
- Chatbot Arena(LMSYS)用 ELO 评分——真人盲评两个匿名模型输出哪个好
每个工具/榜单有自己的侧重,用过的人都学会交叉对比,不只看一个。
五、刷榜游戏:分数能造假
回到最初的疑问:为什么很多厂商报分你看不懂?
数据泄漏
模型在预训练或 SFT 阶段接触了测试数据。比如 GPT-4 被怀疑在训练时看过大量 GSM8K/GPQA 题目(OpenAI 没证实没否认)。
检测方法:
- N-gram 重叠: 检查模型生成是否与测试题目有大量 n-gram 重合
- 核心题换新: 业界逐步用"每月新出考题"替代固定数据集
- 零样本/多样本对比: 训练含的题在零样本下也应该能做出来,可以估计 contamination 程度
Few-shot 选择偏差
有的厂商报 5-shot 结果,但 shot 选的是"能让模型最好发挥"的 5 个样本。业界标准应该用"跨多个随机种子的平均值"才能避免这种 sampling bias。
Chain-of-thought 选择性使用
CoT 能显著提升推理基准(GSM8K、AIME),但有些厂商 "report CoT, 实际跑 direct" 或反之。要分清楚。
Temperature 和 Seed
- Temperature=0 是确定性的——同样 prompt 每次输出完全一样
- Temperature=0.7 是随机的——不同种子有不同输出
跑评测报告 temperature 设置和 seed 是基础礼仪,但很多发布会不说。
六、自建评测: 为什么你也需要
通用基准替代不了业务评测
通用基准(MMLU、HumanEval)考察通用能力,但不一定反映你的业务场景。
举例:
- 医疗问诊: 需要测 "formed medical knowledge + conversational care"
- 电商客服: 需要测 "product QA + complaint handling + upsell"
- 法律助手: 需要测 "contract analysis + statute citation + reasoning"
这些都没有现成的 benchmark——必须自建。
自建评测的方法
- 抽样量: 200-1000 个真实业务案例,覆盖高频场景
- 打分标准: 用 LLM-as-judge + 人工抽检混合
- 变更追踪: 每次模型升级都跑一遍,追踪 drift
- A/B 对比: 同时跑线上 10% 流量,观察真实业务指标
这是 OpenAI、Google、字节内部真正的做法——外部基准只用于初筛, 最终用的是业务 metrics。
七、评测工程化的要点
1. 固定 seed + temperature=0
结果才能 reproducible
2. 记录完整 prompt + raw output
后续 debug 用得上
3. 用 OpenCompass 或 lm-eval-harness 而非自写
节约半年工程时间
4. 分数报告要注明:
5. 交叉对比 3+ 榜单
Chatbot Arena + OpenCompass + 行业专用 benchmark,防止单一基准的 bias
结语:评测是 AI 健康度的体检
你不能拒绝体检,但你也不能只看一份体检报告。
同样,一个模型的"MMLU 89%" 不能作为你选它的唯一理由。它只是一个指标,不是完整的真相。
真正决定模型好不好用的是:
评测是 AI 时代的科学方法——它要求你:
OpenCompass 和 MMLU 给你的是通用的标尺。最终衡量你的模型好不好用,还是得回到你的真实用户。
原创声明:本文基于公开产业资料整理分析,转载请注明出处。
