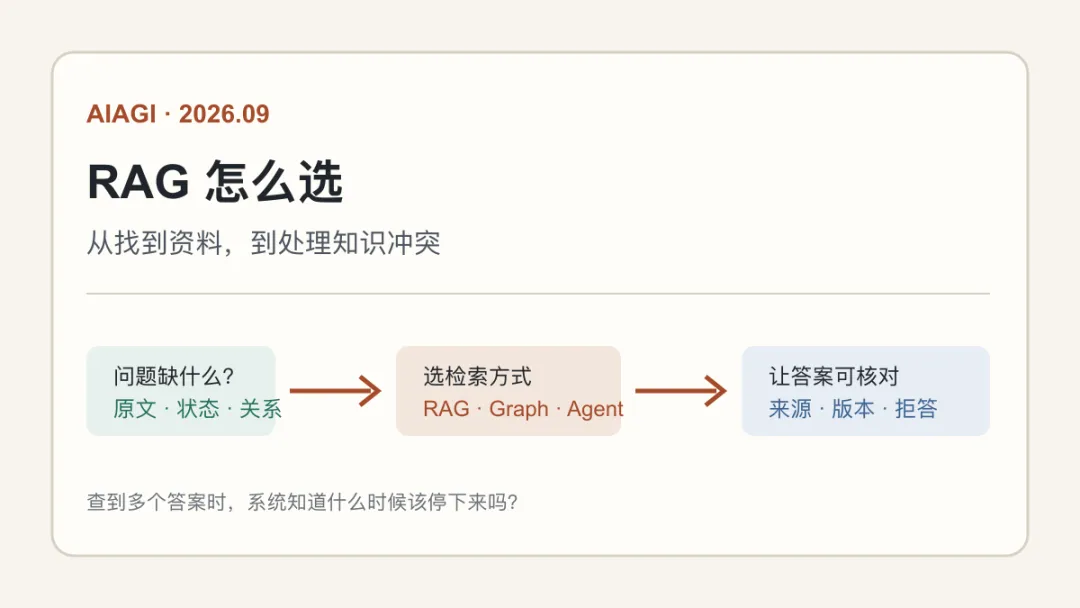
RAG怎么选:从找到资料到处理知识冲突
- 更新时间 2026-09-22 22:33:54
关注 AI 技能,开启智能生活!
加个星标,快人一步Get AI技能!
早上刚上班,客服收到一个问题:
客户去年买的设备,现在还能不能退?如果能退,需要谁审批?
搜索结果里出现了四份资料:总部的售后政策、上个月的新通知、华东区的例外规则,还有一篇培训 FAQ。它们都和问题有关,内容却没有完全对上。
模型把几段话拼成了一段语气很确定的回答。客服反而停住了:到底哪一份有效?这个客户属于哪个区域?“去年购买”按下单时间算,还是按签收时间算?
这种时候,比“系统没找到资料”更麻烦。查不到,大家知道要补资料;查到多个答案,系统却没有把冲突说出来,错误就可能顺着一段漂亮的文字进入退款、发货和客户沟通。
RAG(检索增强生成)做的事情很朴素:回答问题前,先把外部资料找出来交给模型。项目做下去,大家很快会碰到另一个问题:资料找到了,为什么还是不敢用?
我会先问一句:模型缺的到底是哪一类信息?
是一段原文,还是当前状态?是对象之间的关系,还是需要继续搜索、换工具和反复确认的一段工作过程?这一步没分清,后面选什么方案都容易偏。
RAG像一个会翻资料的助手
可以先把 RAG 理解成一个熟悉资料库的助手:它先找出可能相关的内容,再把原文交给模型组织回答。
员工问“差旅报销标准是什么”,它可以从制度里找到条款;家里查“这台电器的保修期多长”,也可以从说明书和售后政策里找到依据。模型本身未必记得这些内容,检索给它补上了资料。
但翻到一页纸,不等于事情已经办完。
一段文字可能没有带上标题、日期和适用地区;表格里的金额可能是上个月的;两个系统里的“华东客户”可能不是同一批对象。模型如果只看到相似文字,很容易把差异抹平。
很多 RAG 项目会在这里反复调参:切块长度换了,向量模型换了,Top-K 调了,某几道题变好,另一批题又出错。参数影响“找回哪些片段”,却不能替系统决定哪一份资料当前有效。
Andrej Karpathy 用 context engineering 来描述更大的问题:给模型准备下一步真正需要的上下文。上下文不只是提示词,也包括资料、工具、状态、历史和验证结果;太少,模型无法完成任务,太多或无关内容,又会增加成本、干扰判断。
选型时,先回到工作现场,比先背产品名词有用。
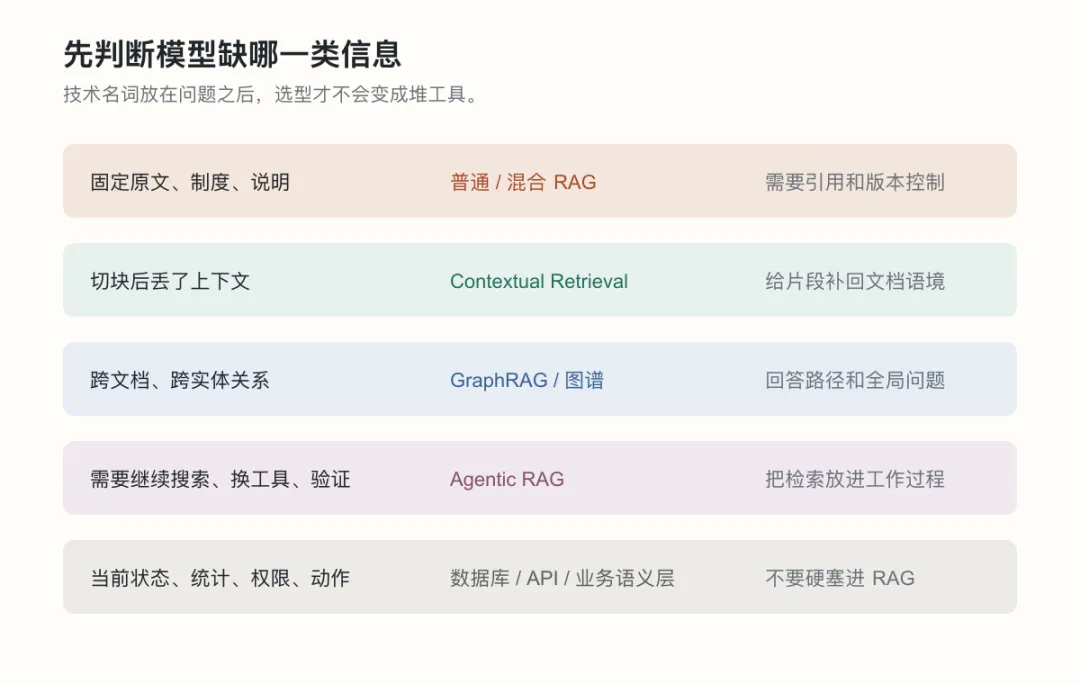
先判断:模型缺哪一块信息
1. 答案就在一份固定文档里
报销标准、产品说明、值班手册、家电保修条款,都属于这一类。普通 RAG 或混合检索通常就能起步:把文档读对、切好,再做关键词与向量检索、重排,最后把引用带回原文。
这里最容易漏掉的是版本。回答旁边至少要能看到文档名称、发布日期和适用范围。对员工来说,“系统说有依据”不如“我能点回现在有效的那一条”有用。
2. 片段被切碎以后,读不懂自己属于哪里
制度切成小块后,片段可能只剩一句“超过 30 天不予受理”,却不知道这是哪个产品、哪个地区、哪一版政策。
Anthropic 的 Contextual Retrieval 会在建立索引前,把文档级信息补回每个片段,再把关键词和向量检索结合起来。它先解决“片段为什么相关”,不能替代实时数据、权限和业务关系。
3. 答案散在多个对象和文档之间
“这次仓库异常会影响哪些客户?”表面上像查资料,实际要沿着一条关系走:
仓库 → 库存 → 订单 → 客户 → 承诺时间 → 处理动作。
单个片段很难把这条链讲完整。GraphRAG 或知识图谱适合处理跨文档、跨实体和全局性问题。Microsoft 的 GraphRAG 通过图结构和社区摘要,帮助模型回答局部关系和整批材料的主题。
代价在建设和维护:要抽取实体和关系,要跟着业务变化更新,还要处理同名对象和错误关联。如果只是查一条制度,建一张大图反而会让系统变重。先找一项确实需要关系推理的工作,再考虑图结构,通常更稳。
4. 查到 A 以后,才知道要去哪里查 B
比如销售问:“这个客户为什么还没续约?”
系统可能先查到合同到期日,再去 CRM 查最近沟通,接着查看报价单和未解决工单;中途发现客户名称不一致,还要回头确认客户编号。它不是“一次检索、一次回答”,而是一段需要不断补证据的过程。
Agentic RAG 把检索放进 Agent 工作流,让系统根据中间结果决定要不要拆问题、换数据源、再查一次或交给人确认。Google 的相关方案也把“当前信息够不够回答”单独拿出来判断。
如果工作流程本来很固定,先把步骤写成 workflow 更容易控制。只有当路径确实会随问题变化,动态搜索才值得增加复杂度。
5. 问的是此刻的数字、状态、权限或动作
“客户现在还有几笔未完成订单?”“本周退款金额是多少?”“我能不能看到这个客户的合同金额?”这些问题需要数据库、API、业务规则和权限系统参与。
知识库可以解释指标口径,数据库提供当前事实,程序完成确定性计算,权限系统决定谁能看到什么。把实时数字写进文档,再期待 RAG 找到它,早晚会遇到过期和口径不一致。
家里遇到的查询也有同样区别:快递现在到哪一步、银行卡余额是多少、保险今天是否到期,答案都在实时系统里,不在一篇静态说明中。
这也是企业“双库”的分工:知识库保存“公司怎么说、事情怎么做”,数据库提供“此刻发生了什么”。模型负责理解和表达,系统负责事实、关系、规则和动作。
把一个售后问题走完,选型就清楚了
回到开头的退货问题。一个较稳的处理过程,大致是这样:
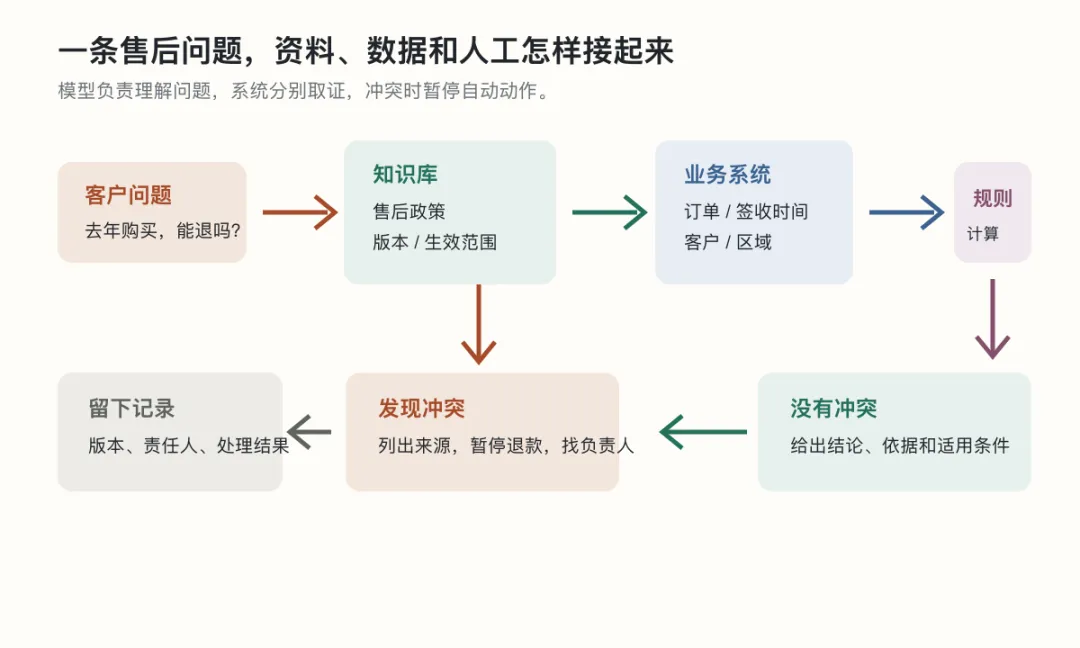
1. 先从当前有效的售后政策中找出退货条件,并保留原文位置。
2. 查订单系统,确认购买时间、签收时间、产品型号和客户所属区域。
3. 如果命中了区域例外规则,再核对它的生效时间和适用范围。
4. 按规则计算是否满足条件,不能让模型凭文字相似度自行判断。
5. 如果总部政策和区域规则仍然冲突,列出冲突来源,暂停自动退款,转给负责人确认。
这条链里可能同时用了普通 RAG、混合检索、数据库查询和确定性规则。它们各自补一块证据,不能互相代替。选型不是在五种 RAG 里投票,而是把工作拆开,看每一步缺什么。
知识冲突要留下“身份信息”
多个来源同时命中时,每条事实都要带上来源、时间和适用对象。最低限度可以记录:
source来自哪份原文、哪个系统或哪次人工确认; version资料版本或数据快照; valid_from/ valid_to:什么时候生效、什么时候失效;scope适用地区、产品、客户类型或业务条件; authority谁有权定义这条规则; owner/ status:谁负责维护,当前是否仍可用。
这些字段不是为了把系统做得复杂,而是为了回答一句很朴素的话:为什么这次采用了这条事实?
TruthfulRAG 论文把问题拆成图构建、图检索和冲突处理三个模块,并讨论了用 entropy-based filtering 识别不确定信息。这个方向值得关注,但论文的效果属于它自己的数据集和实验设置,不能直接换算成每家企业的收益。
落到系统行为上,可以只保留三种处理:
1. 能按版本、范围和权威级别裁决,就给结论,同时附上依据和适用条件。
2. 不能裁决,就说明冲突来自哪里、还缺什么条件,暂时不给确定答案。
3. 如果可能触发退款、发货、付款或客户通知,把结果转成人工确认任务。
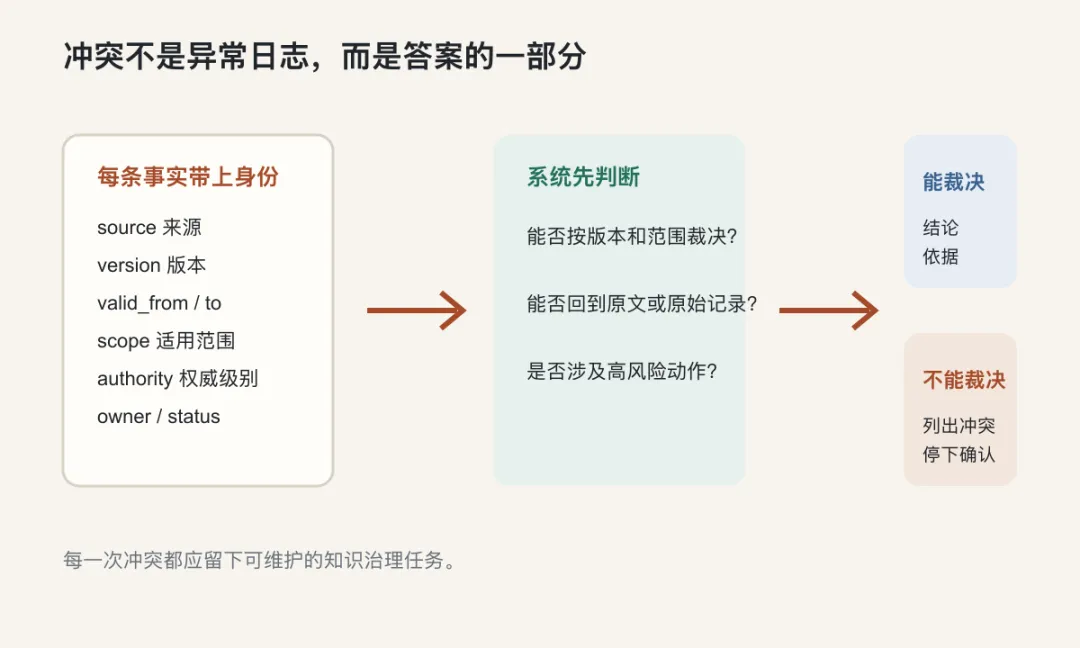
冲突处理完后,最好留下一条治理任务:是旧制度没有下线?是区域规则没有标注?是两个系统的客户编号没有对齐?还是指标本来就没有负责人?只在回答末尾加一句“请人工核实”,下次仍然会遇到同一个坑。
一套能直接拿来用的评测题
几道“答案看起来不错”的题,不足以判断效果。评测集可以先覆盖六类问题,哪怕每类只有两三道:
1. 固定事实:能否找到正确条款,并回到原文?
2. 版本变化:旧制度和新通知同时存在时,是否选对当前版本?
3. 范围例外:总部规则和地区、产品或客户级规则冲突时,是否说明适用范围?
4. 实时状态:订单、库存、余额等数字是否来自正确的接口,而不是文档?
5. 跨对象关系:能否从仓库找到受影响订单和客户,而不是只列出几个相似片段?
6. 不可回答:资料不足或权限不够时,是否会停下来说明缺口?
每次调整切块、Embedding、检索器、重排或 Agent 流程,都用同一批题重新跑一遍。起步时记四项:答案、引用、版本是否正确、遇到不确定时有没有停下。
再往后,可以分别看检索层的 Context Precision、Context Recall,生成层的 Faithfulness、Answer Relevancy,以及业务层的错误动作、人工返工和追溯时间。
真正影响能不能用的,通常是最后这一层。
先把一项小工作做稳
“把全公司的资料都接进来”听起来很完整,边界却太大。资料越堆越多,团队越难说清楚哪一条答案算对。
更稳的起点,是选一项高频、知识密集、结果容易核对的工作:一类售后问题、一份经营周报,或者仓库异常后的影响范围判断。
第一版先把四件事写在纸上:
1. 哪些内容来自文档,哪些必须实时查询;
2. 哪些判断可以写成规则,哪些地方需要人确认;
3. 冲突时谁负责裁决,系统如何记录;
4. 交付前怎样核对数字、口径和来源。
等这条工作链跑稳,再看是否需要混合检索、Contextual Retrieval、GraphRAG、Agent 或业务语义层。这样加进来的每一层,都能对应一个已经出现的问题。
RAG 依然是企业 AI 的基本功。只是它负责把资料带进上下文,不能替企业定义当前事实、业务关系、权限边界和责任人。
可靠的系统也不一定每次都给出一句漂亮答案。它更像一个靠谱的同事:知道依据在哪里,知道这条规则适用于谁,发现几份资料对不上时,会把问题摆出来,等确认以后再往下做。
先判断模型缺哪类信息,再选择检索方式;先把冲突说清楚,再谈答案有多流畅。
参考资料
Lewis et al.,Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks(https://arxiv.org/abs/2005.11401) Gao et al.,Retrieval-Augmented Generation for Large Language Models: A Survey(https://arxiv.org/abs/2312.10997) Microsoft Research,From Local to Global: A Graph RAG Approach to Query-Focused Summarization(https://arxiv.org/abs/2404.16130) Liu et al.,TruthfulRAG: Resolving Factual-level Conflicts in Retrieval-Augmented Generation with Knowledge Graphs(https://arxiv.org/abs/2511.10375) Anthropic,Introducing Contextual Retrieval(https://www.anthropic.com/engineering/contextual-retrieval) Google Research,Unlocking Dependable Responses with Gemini Enterprise Agent Platform's Agentic RAG(https://research.google/blog/unlocking-dependable-responses-with-gemini-enterprise-agent-platforms-agentic-rag/) Andrej Karpathy,Context engineering(https://x.com/karpathy/status/1937902205765607626) Andrej Karpathy,LLM Wiki(https://gist.githubusercontent.com/karpathy/442a6bf555914893e9891c11519de94f/raw)
推荐阅读:
如何给本地部署的 DeepSeek-R1 投喂数据 DeepSeek创始人梁文锋个人履历 哪些经济任务由AI执行?来自400万次Claude对话的报告揭秘 DeepSeek 技术全解析:从入门到精通 分享:满血版DeepSeek R1推理模型三方服务整理 DeepSeek实习经历及大模型择业思考 白话DeepSeek-R1论文(一) | DeepSeek-R1:通过强化学习提升推理能力 Spring AI + Ollama 实现 DeepSeek-R1 API 服务和调用
如喜欢本文,请点击右上角,把文章分享到朋友圈如有想了解学习的技术点,请留言给若飞安排分享
·END·
因公众号更改推送规则,请点“在看”并加“星标”第一时间获取精彩技术分享
进ChatGPT群请加若飞,暗号 “gpt”