Jev 深度测评:它能颠覆 Agent 搜索吗?
- 更新时间 2026-09-22 19:13:07
Jev 深度测评:它能颠覆 Agent 搜索吗?
最近几天,Jev 几乎在社交网络刷屏了。 相比传统完整输入-完整输出的大模型,它的特殊之处在于:给它上下文,再告诉它要判断什么,它会直接返回选择、分数或者真假判断。省掉长篇生成后,判断可以快到毫秒级,token 价格也更低。 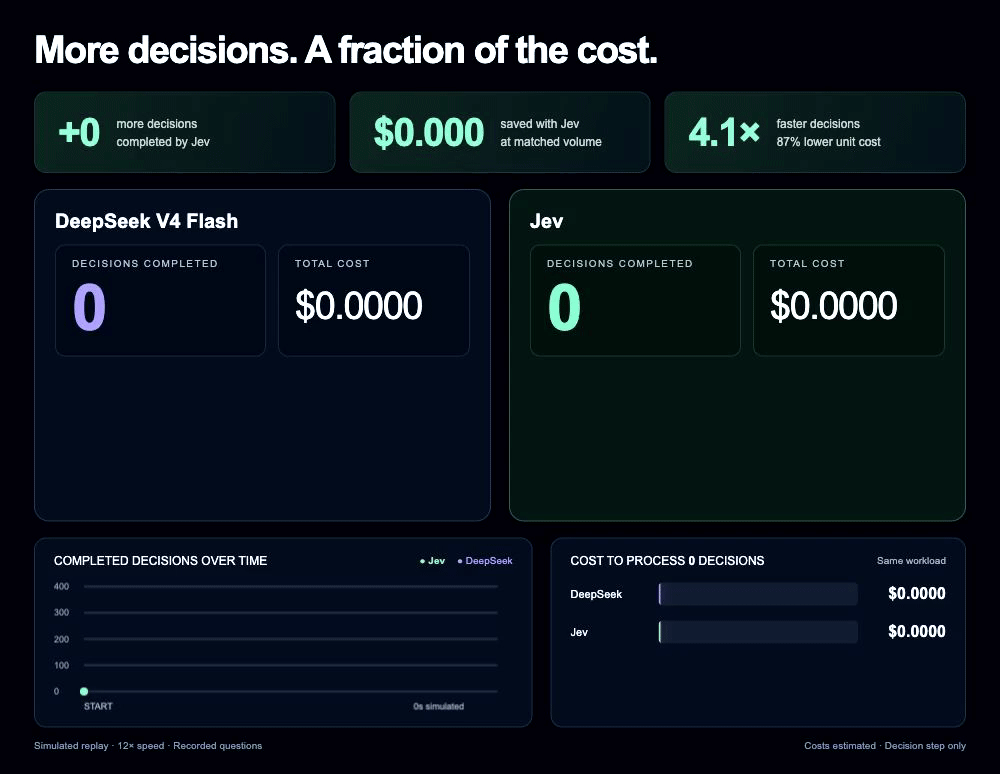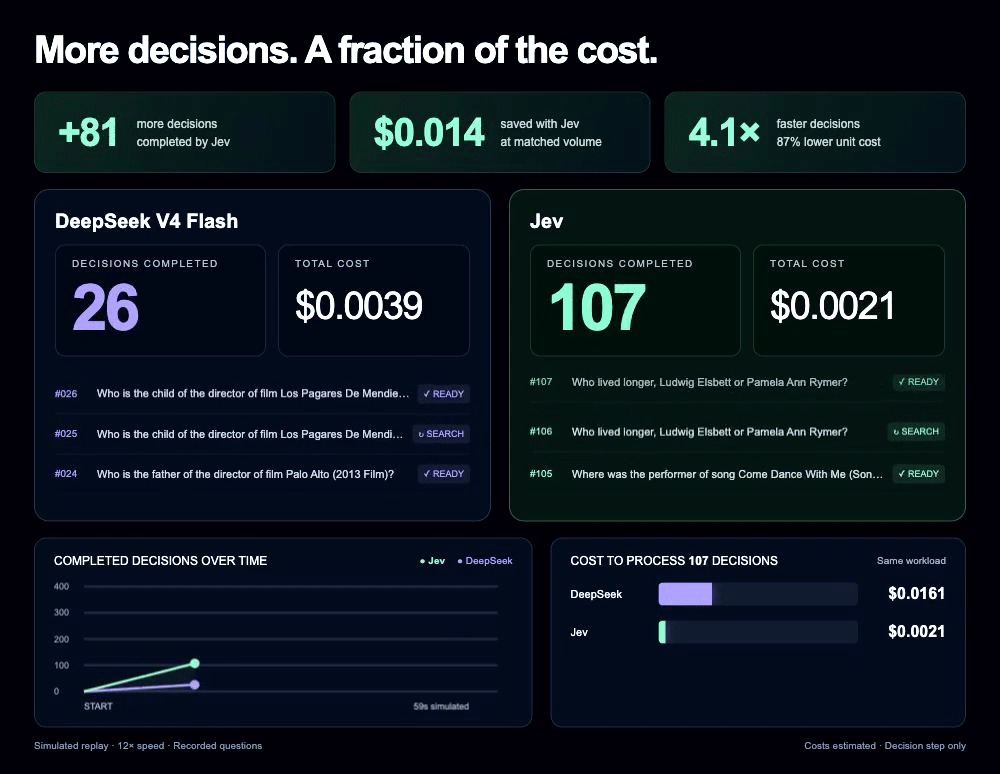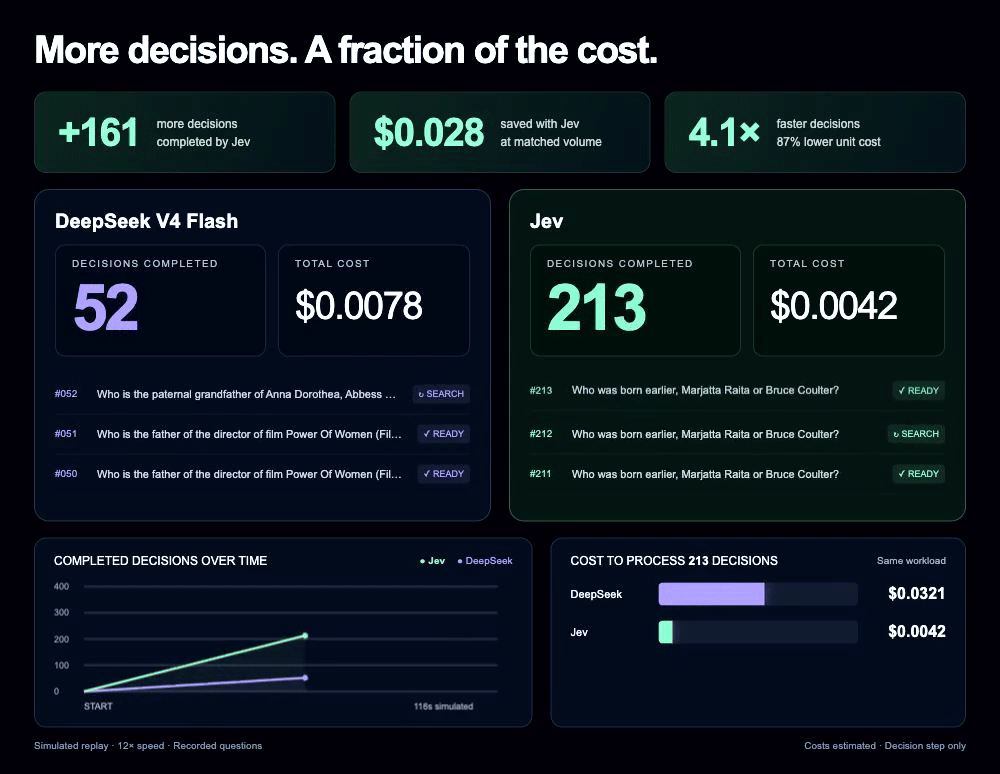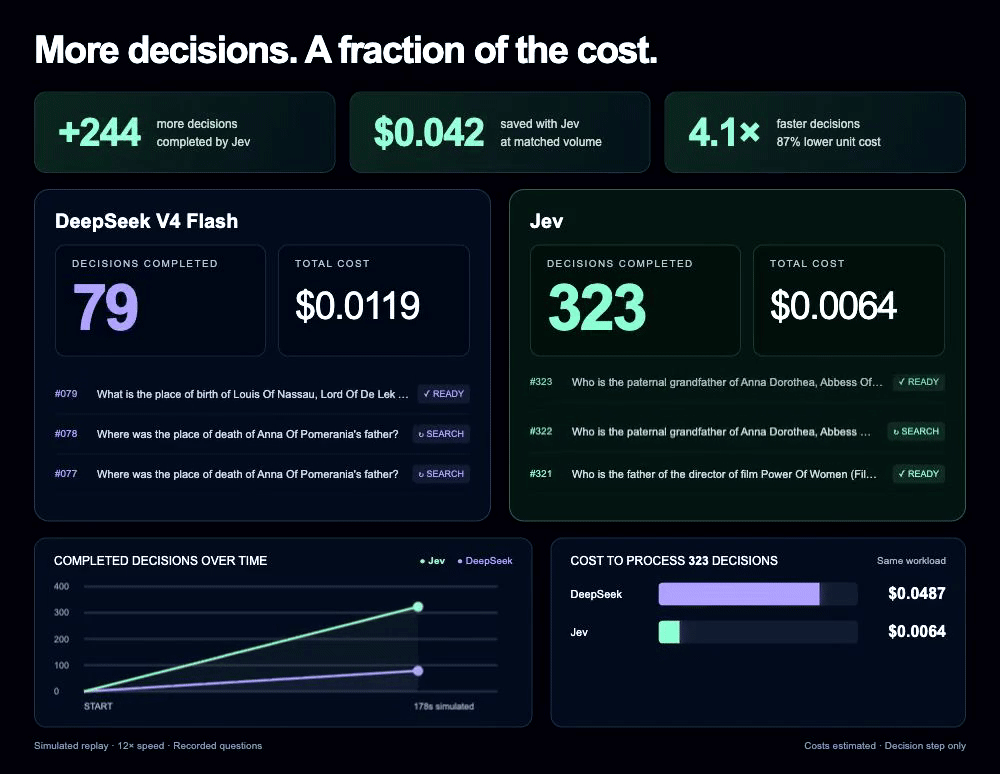
我首先想到的是Agent场景的搜索。在线搜索对延迟和成本都很敏感,而现在的搜索系统里,不管是搜文档、给搜索结果做排序,都要直接调用大模型。如果这些判断能更快完成,Agent的在线搜索的设计也会有更多空间。 那么,Jev 能在多大程度上改变搜索里的模型调用? 基于我们的几个开源项目,我把 Jev 接进三个项目,做了一轮深度、定量测评。 2025 年,OpenAI 的 Deep Research 带火了「Agentic Search」,既 Agent 一边搜索,一边根据已经拿到的信息决定下一步。 借鉴这个概念,我们当时也推出了开源项目DeepSearcher,让 Agent 围绕私有数据反复搜索、整理信息,再回答复杂问题。 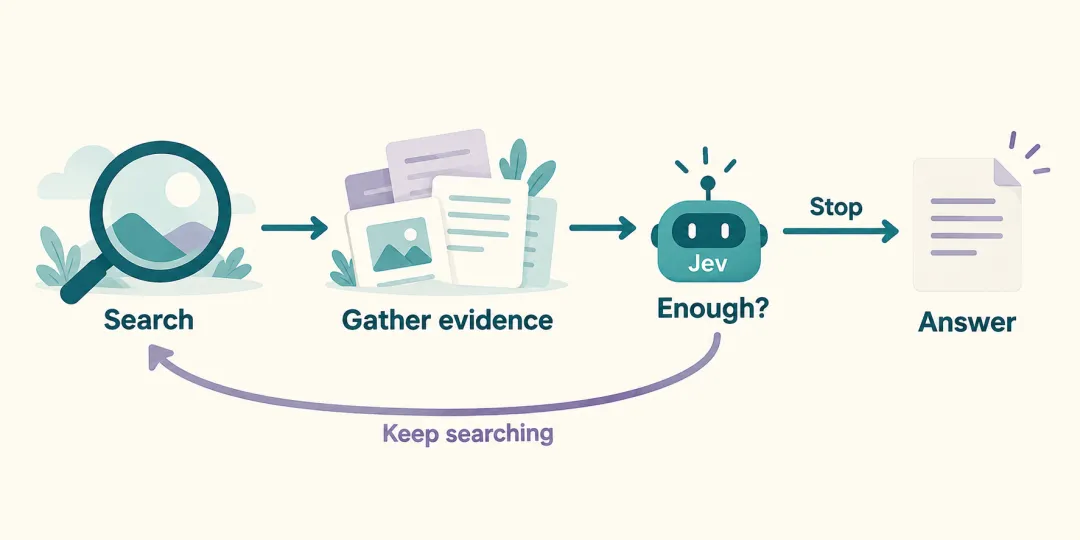
这次,我们直接沿用它的测试数据,拿 100 道多跳问题,让 Jev 和 DeepSeek V4 Flash 看完全相同的搜索记录,再判断是否继续搜索。 结果是:两边最终证据召回的 Recall@5 都是 93.25%,平均搜索轮数也几乎相同。也就是说,在这个任务上,把负责停止判断的 DeepSeek V4 Flash 换成 Jev,没有影响最终的搜索质量。 但判断耗时从平均2.23 秒降到了 0.55 秒,API 响应速度大约提高了 4 倍;按本次实验的调用量估算,费用大约降到原来的七分之一。 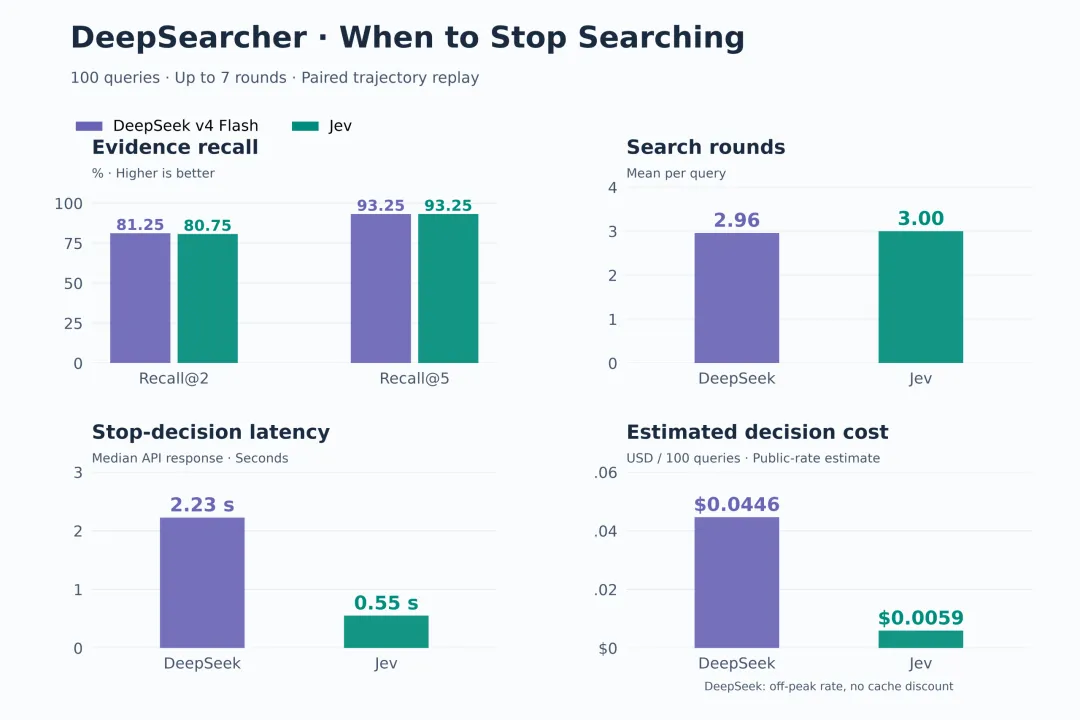
不难发现,在这类任务上,Jev 可以直接替换负责 decision routing 的通用 LLM。 因为系统不是让模型回答用户问题,也不需要它生成分析过程。每轮要判断的事情始终很固定:根据当前已经拿到的证据,现在应该继续搜索,还是停止?我们只要给定搜索状态,再返回一个结构化判断就够了。 不过,停止还是继续,本质上仍然是一个相对简单的判断。 接下来我们把任务变难。 我们之前在公开检索数据集上测过 Jev,它和专用 reranker 的表现很接近,甚至超过它。详见: 实验对比|爆火的Jev能替代Rerank模型吗? 但公开 benchmark 的结果有一个问题:它不一定能代表模型进入真实私有业务数据后的表现。 所以第二组实验,我们没有继续使用公开通用检索数据,而是换成了 Coding Agent 的记忆搜索。 我们做的开源项目MemSearch,可以给 Claude Code、Codex 这类 Coding Agent 提供持久记忆。在这个项目中,用户的开发对话和经验保存在 Markdown 文件里,换一次会话,也能找回之前的上下文。 比如用户问: 初始召回出来的记忆里,可能同时包含测试命令、数据库配置、过去的报错记录,以及真正解决过这个问题的排障记录。 这些内容都可能出现“数据库”“测试”等关键词。 但真正应该排在最前面的,是包含某一次故障原因和有效解决方案的那段记忆。 这次我们使用 MemSearch 原有的2,172 道问题,中英文一起测试。前面的候选召回完全相同,都使用 BGE M3 dense embedding;重排阶段分别测试不重排、Jev,以及专用 reranker Voyage rerank-3。 结果是: 不做重排时 Recall@5 为 74.71%,Jev 把它提高到了 79.41%,Voyage rerank-3 则达到了 81.87%。 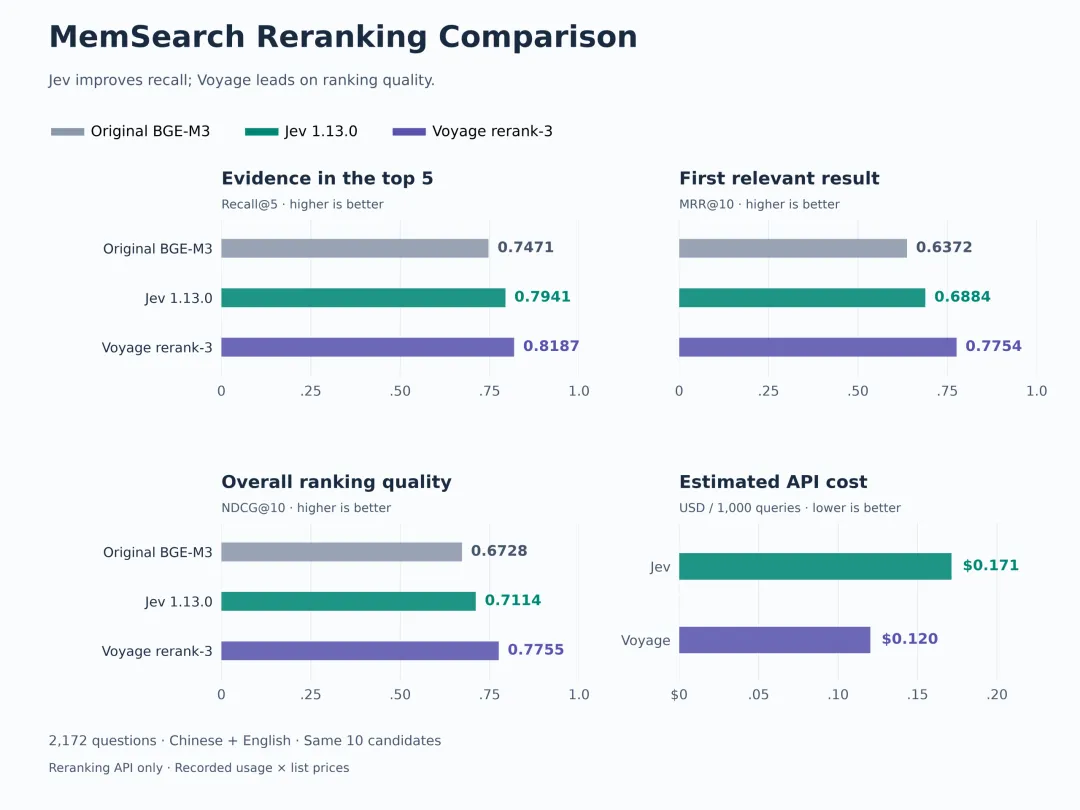
也就是说,在特殊专用领域,Jev 确实能把更相关的记忆往前排,而且提升并不小;但无论整体结果还是把正确结果推到最前面的能力,都还没有追上 Voyage rerank-3。 这个差距在中英文数据里都存在。更重要的是,这一组实验里 Jev 也没有表现出明显的任务成本优势。 背后的原因可能在于,有些 rerank 问题需要一定的推理,里面有一些复杂的隐藏过程。Jev 对这类问题的处理和训练可能还不够。这个问题我们可以看接下来的实验,更能展现出来。 第三个是我们之前做的开源项目Vector Graph RAG。它把向量检索和实体关系图结合起来,让搜索能沿着线索多走几步,找到一篇文档里凑不齐的答案。 关系重排要做的,就是把有用的关系排到前面。用这个简化例子来看: 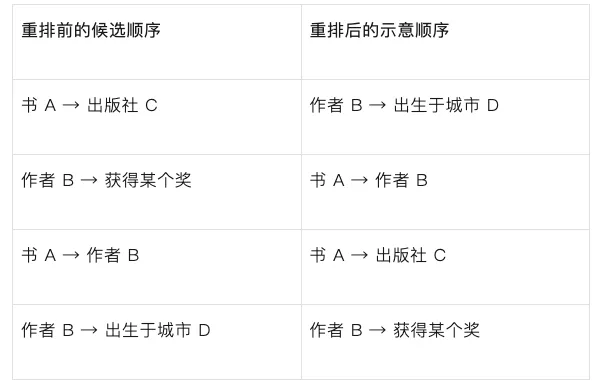
出生地关系直接提供答案,书与作者的关系负责把问题连接到正确的人,两条都应该靠前。出版、获奖这些关系则可以靠后,或在筛选时去掉。 系统再按排好的关系找回关联原文,把更有用的证据放到前面。这次让 Jev 接手的,就是原来由大模型完成的关系重排与筛选。 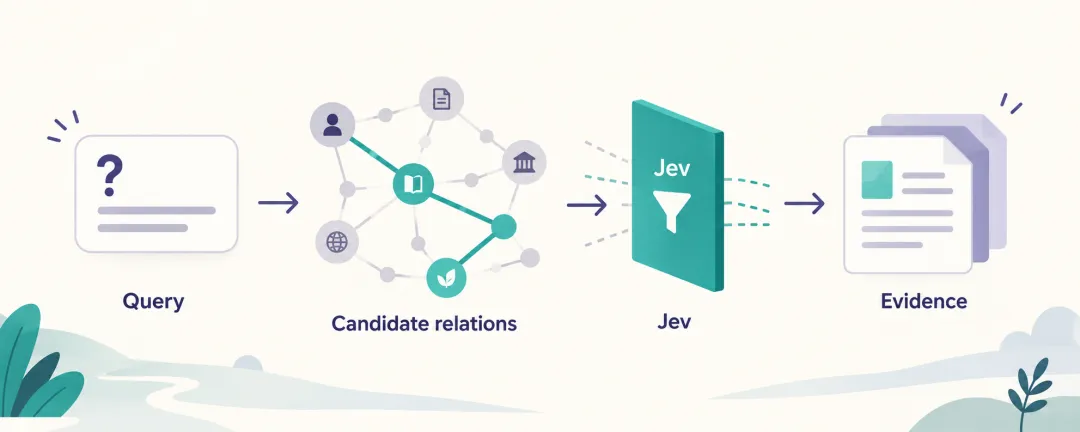
关系筛选一直是我们这个项目里,搜索流程中较慢的一步:候选多,输入长,还要等待大模型生成结果。这也是我们想要尝试用 Jev 替换它的原因。 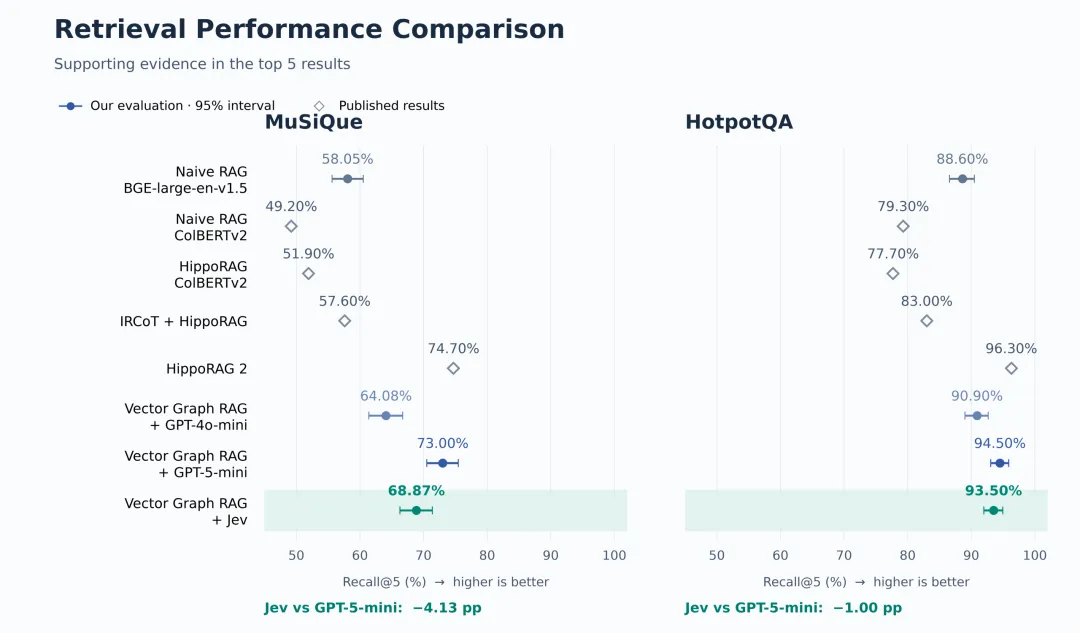
在MuSiQue 和 HotpotQA 上各跑 500 道问题后,Jev 的结果都超过了经典的 GPT-4o-mini,但没有追平上一代的 GPT-5-mini。 在 HotpotQA 上,它离 GPT-5-mini 只差1 个百分点;到了更难的 MuSiQue,差距拉到了4.13 个百分点。HippoRAG 2 的历史成绩也更高。 因此,我的判断是:Jev 已经能承担关系筛选,但复杂多跳的情况,我仍会选更强的生成模型。或者直接放弃 Vector Graph RAG 方案,转向 Agentic Search + Jev 方案。 因为这次测试的是复杂的关系的重排序。这里召回的候选关系会有时候会很多,而且里边的关系错综复杂。大语言模型处理的好,是因为它有思考的过程。而 Jev 模型的架构天然不支持它的这种思考的方式。在这种复杂的场景下,落后也是正常。 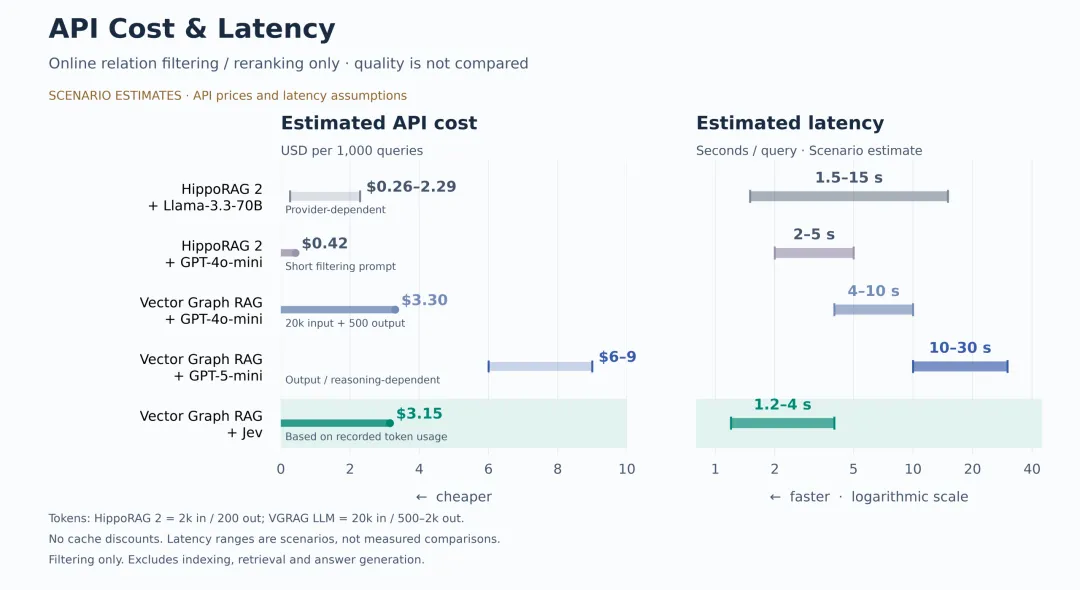
成本算下来,Jev 每千题约3.15 美元,接近 GPT-4o-mini 的估算成本,低于 GPT-5-mini 的6 到 9 美元。HippoRAG 2 的 API 方案还可能更便宜。 当然,本场景下,Jev 的也有一些优势,Jev 这个请求的时延响应是几个方案里最快的,如果你追求极致的速度,可以接受一定的损失,它也是一个可以接受的方案。 总而言之,Jev并不擅长负责推理,但比较擅长把频繁、输出简短的语义判断做得更快。除了这次测的场景,数据筛选、质量评估、语义缓存、查询路由,以及带业务条件的重排场景,都是Jev的优势场景。 过去,要实现这种低成本、高效率,我们需要为不同任务分别训练、维护专用小模型;现在,工具选择、Skill 调用、浏览器操作等决策,都能交给同一个模型,通过上下文和判断标准适配,从而简化系统的架构。
DeepSearcher:停止判断实验、代码与记录: https://github.com/zc277584121/deepsearcher/tree/experiment/jevsearch-stopping/evaluation/jev_stopping MemSearch:Jev 重排集成与评测: https://github.com/zilliztech/memsearch/pull/758 Vector Graph RAG:Jev 关系筛选、实验与成本估算: https://github.com/zilliztech/vector-graph-rag/pull/48 Jev 官方介绍: https://typesafe.ai/blog/introducing-system-one-models-and-jev Jev 接口文档: https://docs.typesafe.ai/introduction 用 Jev 驱动浏览器的社区项目: https://github.com/browser-use/jev-ultrafast
那么,Jev 的场景落地甜蜜点在哪里?
01
Agentic Search:效果持平 LLM,决策更快
比如问:某部电影的导演出生在哪座城市? 第一轮只查到导演是谁,还得继续搜。找到出生地以后,就可以停了。
02
Agent记忆重排:Jev 有明显提升,但还没追上专用 reranker
上次这个项目的集成测试连不上数据库,最后是怎么修好的?
03
多跳图检索:超过 GPT-4o-mini,但落后于GPT-5-mini
比如问:《书 A》的作者出生在哪儿? 搜索先召回一批候选关系:书 A 由出版社 C 出版、作者 B 获过某个奖、书 A 的作者是 B、作者 B 出生于城市 D。它们都与书或作者有关,但对回答这个问题的价值不同。
04
更多思考
实验细节和相关链接
作者介绍
张晨
Algorithm Engineer at Zilliz
阅读推荐官宣开源|Milvus 3.0 正式发布Aquila语义去重精读:训练数据里的语义重复,白白烧掉了多少 GPU 时?从条件匹配到相似检索:同程旅行慧行搜索的火车换乘方案向量化实践19 万 Star 之后,我给 DeepSeek Harness 接入了Milvus我们给DeepSeek Harness接入了MemSearch ,自动把Memory提炼成Skill深度教程|毕昇如何用Milvus实现千人千权的企业级 RAG 检索
本文来自网友投稿或网络内容,
如有侵犯您的权益请联系我们删除,
联系邮箱:wyl860211@qq.com 。
