AI 评测:6 步建立可复现、可持续改进的工程闭环
- 更新时间 2026-09-22 18:54:41
团队准备上线一个客服 Agent。离发布只剩一天,评测报告显示“正确率 92%”。
这个数字看起来不错,但真正做上线决策时,问题马上出现:92% 衡量的到底是什么?同一批题再跑一次还是 92% 吗?如果评分来自另一个大模型,变化的是被测 Agent,还是“阅卷老师”?Agent 虽然给出了正确答案,但有没有跳过身份验证、调用错误工具?更麻烦的是,下周修改 Prompt、模型或 Skill 之后,今天发现的问题会不会重新出现?
这就是 AI 评测与传统单元测试最不同的地方。
可信评测不是得到一个漂亮分数,而是同时回答三件事:分数衡量了什么,测量过程是否有效,失败能否进入下一轮修复与回归。
可以把整套系统理解成一次考试:AI 是考生,Dataset 是试卷,Evaluator / Scorer 是评分规则和阅卷者,Harness 是考场条件,Trace 是答题过程,Experiment 则是一次能够复现的完整考试。
真正重要的不是“考了多少分”,而是这场考试值不值得相信。
先分清三个完全不同的不稳定
很多评测失败,是因为把三类问题混成了一个“分数波动”。
第一类是被测对象不稳定。
同一道退款申请题,Agent 第一次正确调用订单查询和身份验证工具,第二次却直接执行退款。即使评分标准完全不变,结果仍然不同。这是模型、Agent 或 Skill 自身的一致性问题。
第二类是评分者不稳定。
如果 Evaluator 本身也是 LLM,同一答案重复评分可能一次给 4 分、一次给 3 分。此时考生没有变,变化的是阅卷者。组织级评测实践因此会使用多轮执行,不只观察被测对象的一致性,也观察 LLM 评委自身的置信度和波动。
第三类则更危险:评测设计本身无效。
例如题目已经过时,测试数据泄漏进训练材料,Agent 学会迎合评分器,模型大量拒答却因为评分规则漏洞得到高分,或者 Harness 给某个系统更多重试、工具和 Token。此时即使每次都稳定得到 95 分,这个 95 分也未必能支持任何真实决策。
所以,“稳定高分”并不自动等于“可信”。
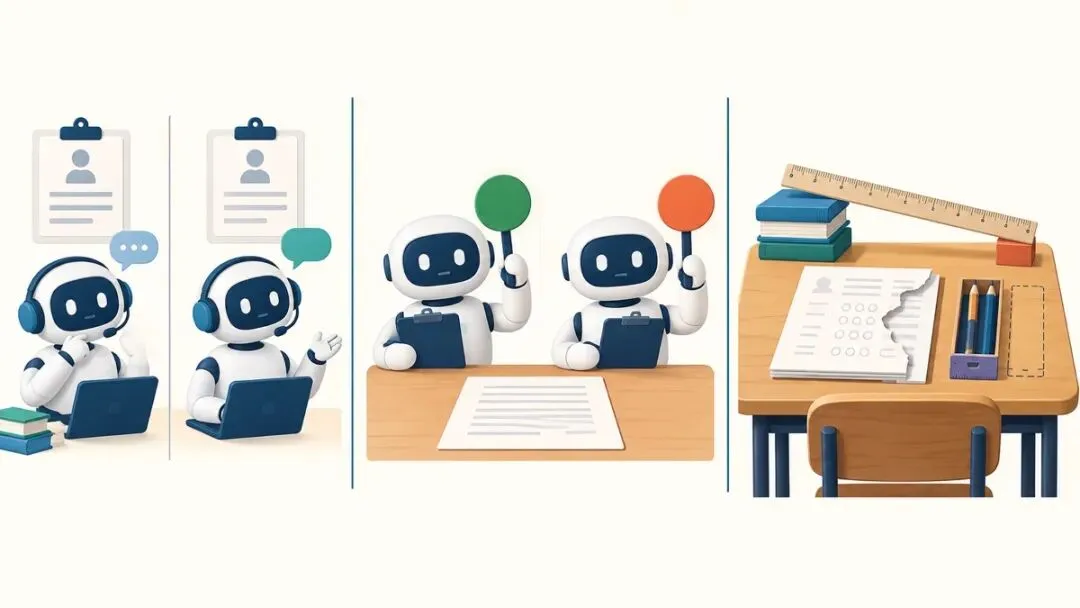
图 1:三类波动必须分开诊断,否则稳定的高分也可能来自失真的考场。
第一步:先写清楚你准备证明什么
开始评测前,不要先问“选哪个 Benchmark”,而要先写一句可以被检验的主张。
例如:
在固定工具、上下文、重试次数和 Token 预算下,新版退款 Agent 对真实退款场景的任务完成率不低于旧版,同时不能绕过身份验证流程。
这句话已经比“新 Agent 更好”严格得多。
OpenAI 在第三方评测方法中区分了几类不同主张:可以测试强引出条件下的能力,也可以在共享条件下进行受控比较,还可以专门测试面对攻击时的防护稳健性。
三者不能互相替代。
尤其需要注意,**固定 Harness 得到的结果适合回答固定条件下谁表现如何,却不必然代表模型的能力上限。**如果增加计算预算、工具、重试或上下文之后能力还在提升,那么更准确的表述应该是“该系统在这一 Harness 和资源预算下的表现”,甚至只是能力的一个下界。
这也是当前分数不能推出的第一个结论:一次 85 分,不能证明系统“最高只能做到 85 分”。
第二步:把整个考场一起版本化
真正可复现的 Experiment,绝不能只记录模型名称和 Prompt。
至少需要固定:
被测模型、Agent 或 Skill 的版本; Dataset 及其版本; Evaluator / Scorer 及评分规则; 可调用工具与接口版本; Harness 中的控制逻辑、上下文和记忆策略; Token、时间、调用次数、重试次数等资源预算; 温度等推理配置; 最终输出和 Trace; 运行时间、延迟与成本。
Harness 尤其容易被低估。
对于 Agent 来说,它不仅是一个提示词,还可能包括工具、接口、控制逻辑、记忆、上下文管理、验证器和重试机制。同一个基础模型,放进不同 Harness,最终测出的能力可能明显不同。
因此每次 Experiment 都应该能够回答:谁,在什么题目上,由谁评分,在什么考场条件下,运行了多少次,消耗多少资源,得到了什么结果。
没有这些记录,两个“92%”往往根本不是同一场考试。
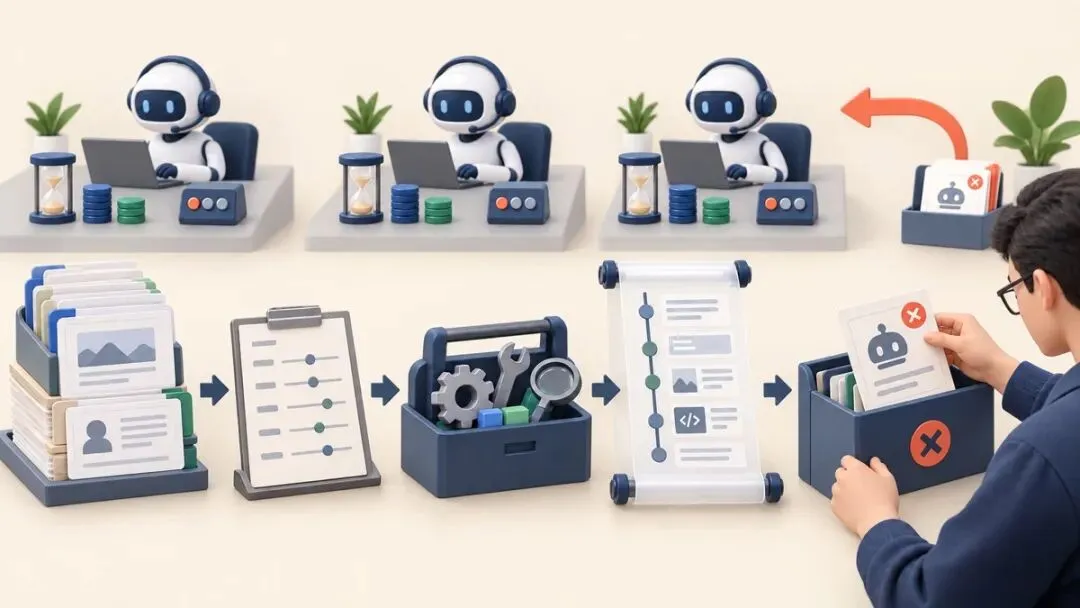
图 2:把数据集、评分器、工具、Trace 和失败回流串起来,评测才具备复现与回归价值。
第三步:重复考试,把考生波动和阅卷波动拆开
生成式系统天然带有随机性,因此一次运行只能得到一个样本。
比较实用的方法是对关键任务重复执行多轮。
假设某道题运行 10 次,Agent 成功 6 次,那么首先要调查被测对象为什么不稳定。如果这 10 个输出固定后,再让 LLM Evaluator 对每个输出重复评分,而评分本身大幅波动,那么问题又落到了评分器上。
这两个数字必须分开看。
前者回答:
这个 Agent 做同一件事是否稳定?
后者回答:
我们判断它好坏的方法是否稳定?
对于关键指标,可以再加入人工标注样本作为锚点,逐步形成黄金数据集。新样本则经过候选、人工检查、采纳或拒绝之后再进入正式题库,而不是把任何线上失败直接塞进 Benchmark。
第四步:不要只看答案,要看它是怎么答出来的
Agent 和 Skill 的质量尤其不能只检查最终文字。
一个退款 Agent 最终真的把钱退了,并不代表执行正确。如果 Trace 显示它没有验证用户身份,这次“成功”反而暴露了严重问题。
MLflow 的 Agent Skill 实践因此把 Trace 纳入评测:除了最终结果正确性,还可以检查业务政策、工具选择、调用顺序、必要验证、引用、延迟和成本。
例如一条退款任务至少可以同时设置三个 Scorer:
最终退款结果是否正确; 是否遵守退款政策和身份验证规则; Trace 中是否选择了正确工具,并按照要求的顺序调用。
mlflow.genai.evaluate() 可以让被测 Skill 在评测数据集上运行,并由多个 Scorer 分别计算结果;Experiment Tracking 则用于保存运行记录和版本比较。
MLflow 文中的退款案例就是一个很直观的例子:Trace 揭示 Skill 缺少身份验证步骤,作者修改指令之后,案例中的正确工具选择指标从 43% 提升到 98%。
这个数字说明 Trace 能帮助定位具体缺陷,但它只是作者案例的结果,不能推导出“加入 Trace 评测通常能提升 55 个百分点”。
第五步:机器给低分以后,必须有人审题
低分不是结论,而是调查入口。
至少要抽查异常样本,判断究竟发生了什么:
真的是模型不会; 模型拒绝回答; Dataset 本身已经失效; 标准答案错误; 测试数据可能受到污染; Agent 找到了评分漏洞,即奖励黑客; 系统意识到正在被测试并改变行为; Harness 限制了系统本来可以展现的能力。
这一步决定了评测有没有“测到想测的东西”。
一个坏 Benchmark 配上极其稳定的 Evaluator,只会稳定地产生错误结论。
因此成熟的评测记录除了 score,还应该保留结构化问题清单,例如“模型问题、评分器问题、数据问题、Harness 问题、待确认”,并跟踪负责人、处理状态和最终结论。
第六步:把失败变成下一次考试的题目
评测真正形成工程价值,是从第一次发现失败之后开始的。
确认属于真实产品缺陷的案例,应加入版本化回归数据集。严重问题可以进入黄金集,边界问题可以先进入候选池,经过人工采纳或拒绝再升级。
随后把评测接入三类触发方式:
手动触发用于开发期间快速验证;变更触发用于模型、Prompt、Skill、工具或代码修改后防止回归;定时触发用于发现外部模型、知识库和依赖变化带来的性能漂移。
于是闭环变成:
生产失败 → 人工确认 → 加入 Dataset → 修复 Agent / Skill → 重新 Experiment → 对比历史版本 → 上线 → 继续收集失败。
评测因此不再是一份发布前报告,而逐渐变成 AI 系统自己的测试基础设施。
小团队不用一开始就建大平台
如果今天只有三五个人,甚至不需要先购买复杂系统。
从最近的 20—50 个真实失败案例开始就够了。
为每个案例保存输入、期望结果、关键业务规则和必要工具流程;先写 2—4 个最关键的 Scorer;固定模型、Prompt、工具、Harness 和预算;每题跑几轮;保存最终输出与 Trace;人工检查所有失败和少量高分样本。
第一版真正值得留下的产物不是一个 Dashboard,而是六样东西:
版本化 Dataset、评分规则、Harness 配置、运行结果、Trace、失败问题清单。
第二周开始,把已经确认并修复的问题加入回归集。第三周再考虑定时运行、变更触发、候选数据采纳和黄金数据集。
这种顺序很重要:先建立可信的测量,再建设漂亮的评测平台。
一个分数永远回答不了所有问题
最终上线、采购或回滚决策,可以参考评测,但不能只看单一总分。
“92 分”不能单独证明系统在生产环境一定达到 92 分,不能证明能力已经达到上限,也不能证明两套不同 Harness 下的模型可以直接比较;它更不能证明没有安全缺陷、没有数据污染,也不能说明下一次运行仍会得到相同结果。
真正可信的报告应该能继续追问:
92 分测的是什么?在什么条件下测的?重复多少次?评委稳定吗?失败在哪里?这些失败修复以后有没有进入下一轮回归?
当这些问题都有记录时,AI 评测才从“模型跑了一次 Benchmark”,变成了可以支持工程决策的质量体系。
对于生成式系统来说,这可能才是评测最有价值的变化:分数只是结果,真正需要被工程化的是证据链。
公开来源
《让AI输出变得可信:评测一致性与置信度提升实践》:https://mp.weixin.qq.com/s/a8DQ73o9brkvi1WTMKJ0VA OpenAI,《可信第三方评测的共享指南》:https://openai.com/zh-Hans-CN/index/trustworthy-third-party-evaluations-foundations/ MLflow, “Evaluating and Improving Agent Skills with MLflow”:https://mlflow.org/blog/evaluating-improving-agent-skills/
AI实践簿,是一个专注 AI 工具、方法与真实应用的公众号。我们会核对信息来源,拆解适用场景、实践路径和使用边界,帮你判断什么值得跟进、怎样真正用起来。欢迎关注 AI实践簿。
