“
画质这一关,模型已经过了。真正难的是让产品参与因果。
—— AI·王陈说
拿 AI 生成一条 30 秒品牌广告片,画面很少让人失望。光线、材质、皮肤质感,都够用了。
可把它交给品牌方,问题立刻冒头。前三秒是城市航拍,产品到第 24 秒才出现,旁白把同一句 slogan 念了两遍,液体倒到一半镜头就切走了。
这些毛病跟画质无关。
GitHub 上有个叫 seedance-tvc-director 的开源项目,把这类判断写成了规则文档。作者 nutllwhy,MIT 许可,当前版本 0.20.0,最近一次提交在 2026 年 9 月 3 日,主题是模型与节奏规则。读完它的 SKILL.md 和十余份规则文档,我对 AI 广告片这件事的看法变了。
这个项目的 README 开头有一段话,说得相当克制。
「视频模型会生成漂亮画面,但商业广告还需要回答更多问题。」
它列了六个问题。前三秒有没有真正抓住注意力。30 秒有没有增加新场景和新信息,有没有把 15 秒的动作简单拉长。产品有没有参与故事因果,还是在结尾突然贴片。旁白是否只说一次,并与镜头节奏正确配合。包装、手部、人物身份和物理动作是否连续。生成失败后,能否只修证据指向的那一层,不推翻已经成功的部分。
这六个问题有一个共同点。它们都跟画质没关系。它们考验的是一个人会不会讲商业故事,知不知道注意力在哪一秒会掉。
过去三年,视频模型把「能不能生成」这一关过了。现在卡住大家的是「生成出来的东西凭什么能用」。这是两件不同的事,前一件靠算力,后一件靠判断。
02THE SYSTEM
它做的事,是把导演判断编译成规则
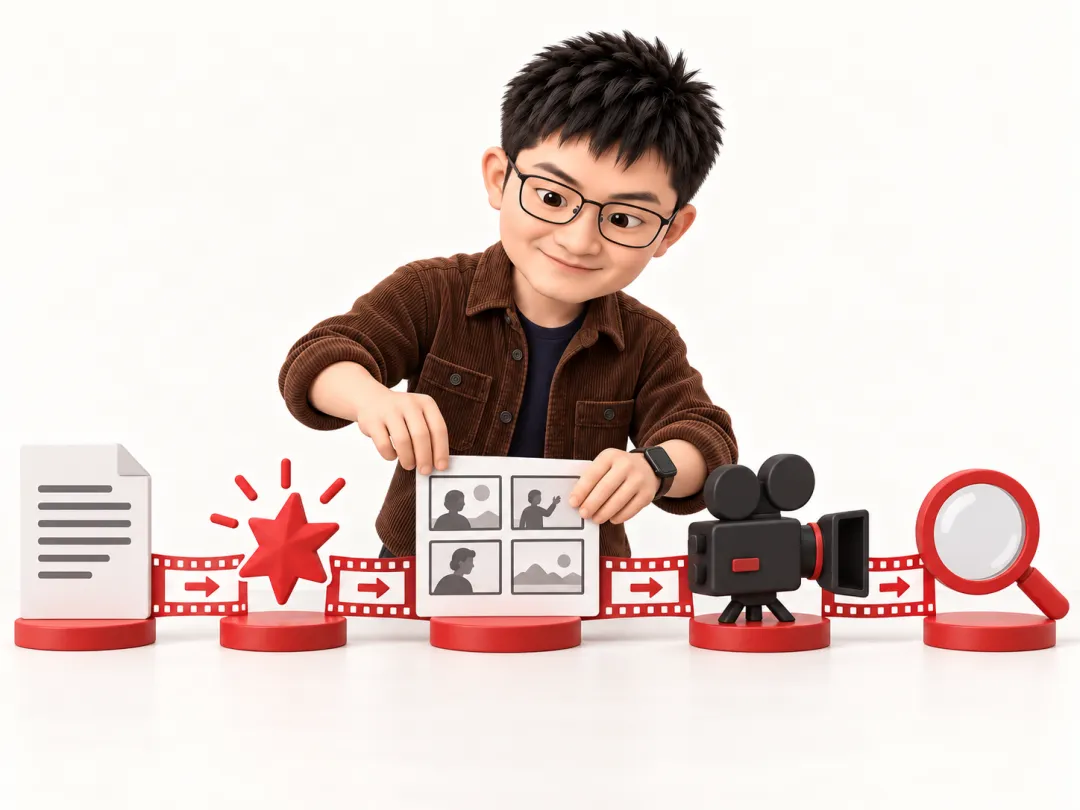
这份 Skill 的设计结构是一条流水线。
brief 与事实边界 → 六个独立生成配置 → 单一核心主张 → 前三秒广告钩子 → 15/30/自定义时长结构 → 人物、产品、声音和场景锁 → 场景锚、镜头交接与声音桥 → Seedance 2.5 提示词编译 → 交付前 QC → 成片抽帧、切点与转写复盘 → 局部重试与回归用例
前四步是判断,中间三步是约束,最后三步是纠错。注意最后三步里的一个词,局部重试。
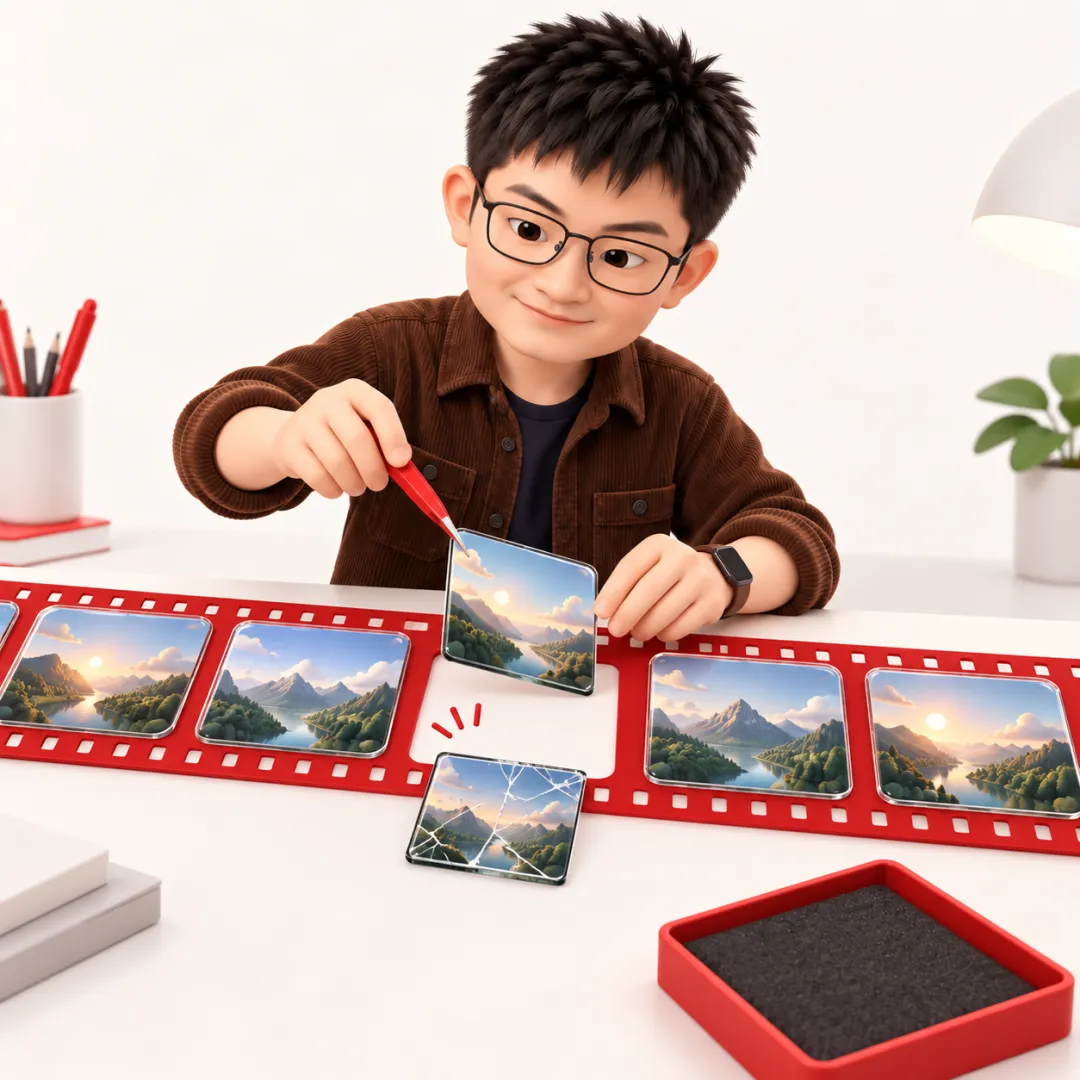
这条链路里最值得学的地方在这里。它把「创作」和「纠错」当成两个独立环节来处理,并且明确要求纠错时必须先分区,把已经成功的人物、产品、旁白保护起来,只动证据指向的那一层。
多数人做 AI 视频卡住,卡在把这两件事混在一起。一条片子出来不满意,直接推翻重写,重写一遍把对的部分也丢掉了。
03SIX OPTIONS
第一个信息差,六个选项必须拆开
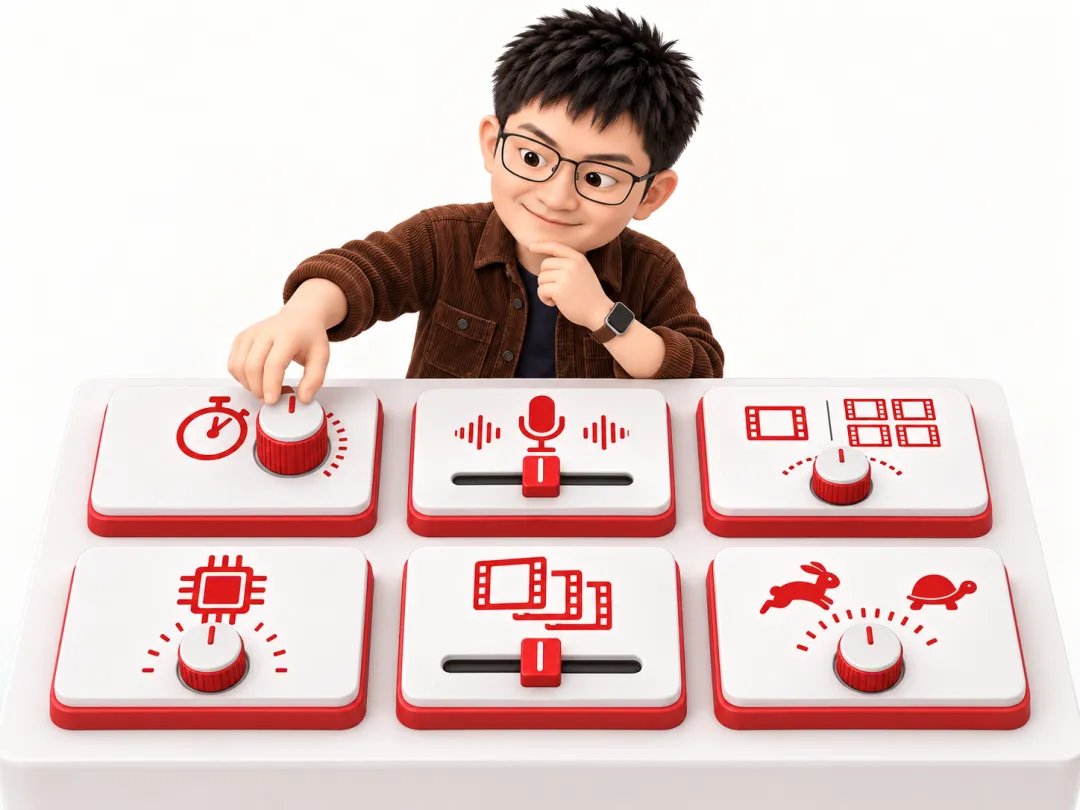
如果你没给配置,这份 Skill 会一次性确认六个互不绑定的选项。
5生成段数:单段完整生成、多段生成后剪辑,或按平台能力自动选择
6节奏与镜头密度:快节奏商业版、标准商业节奏、克制电影节奏,或自定义镜头数
它的原文写得很直白。模型与段数不会互相偷换,叙事模块、实际镜头和生成段数也不会混用。
这句话点到了多数提示词的病灶。我们把六个独立变量压进一句话,模型只能自己猜,猜错的方向每次都不同。有时候它给你两段拼起来,有时候它把 30 秒的故事塞进 15 秒的骨架,有时候它觉得你说的「快节奏」是镜头短一点,实际上你要的是信息密一点。
💡 写提示词前先做一件事,把这六件事逐条写成明确取值。这一条能省掉的返工次数,比换任何一个模型都多。
04FOUR NUMBERS
第二个信息差,四个数字不能混用
这是全篇最有价值的一段,我建议截图。
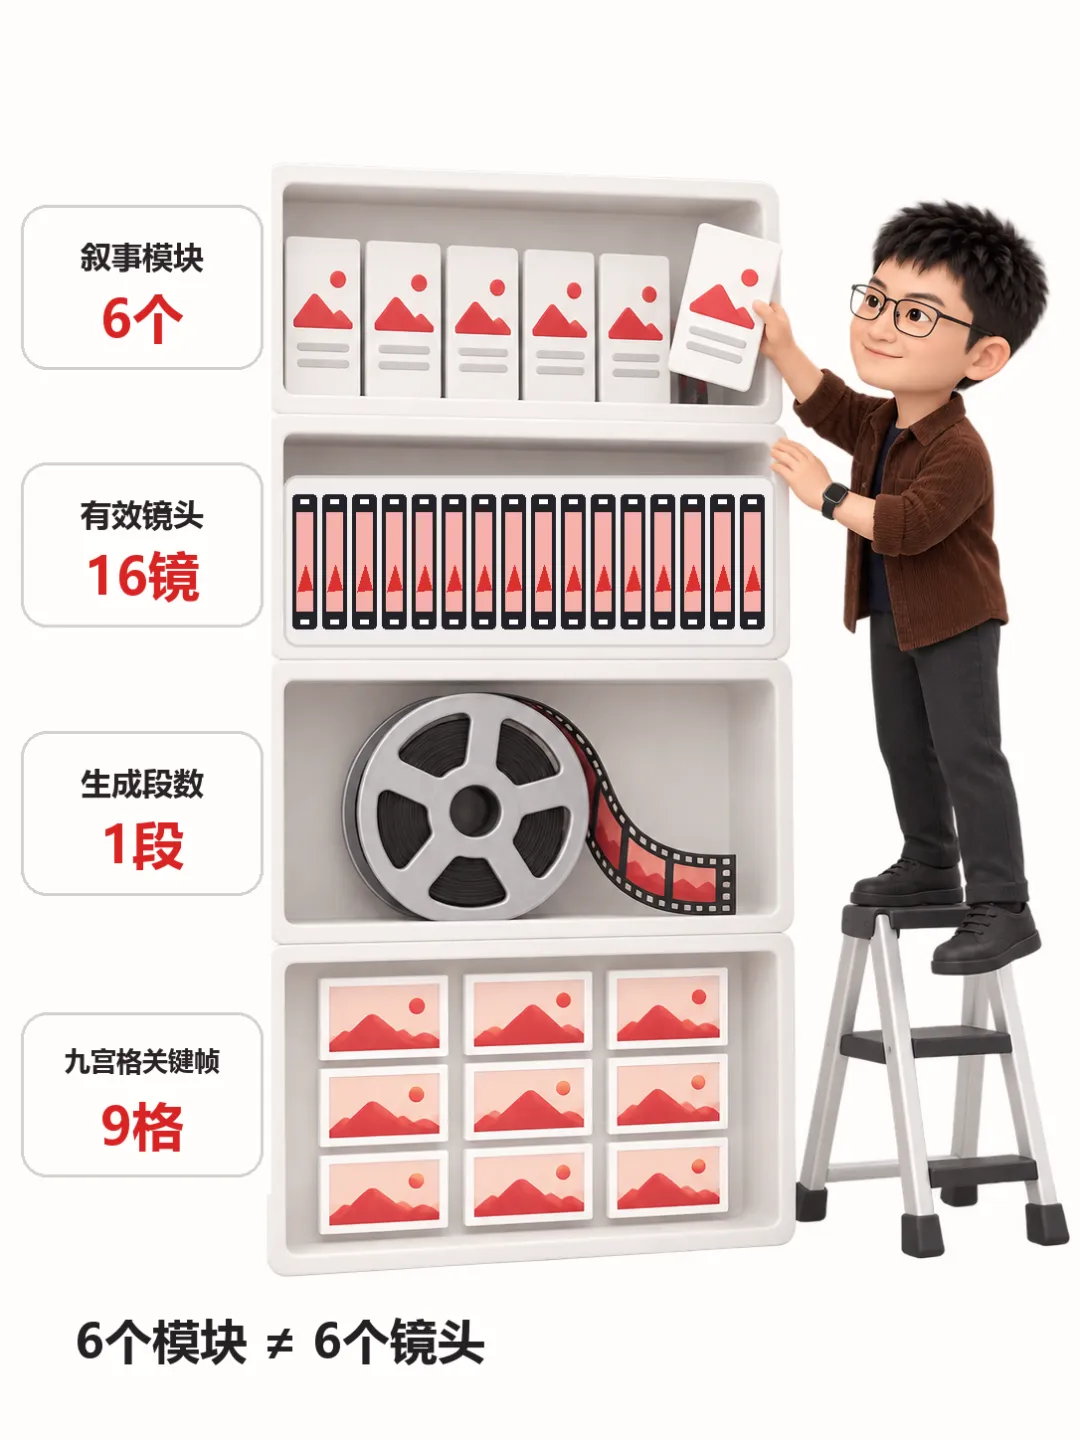
四个数字,四层完全不同的含义。
这份文档反复强调一句话,6 个叙事模块不等于 6 个镜头。30 秒可以由 6 个叙事模块组织 16 个有效镜头,并由 Seedance 2.5 一次生成完整成片。九宫格只有 9 格,也不等于成片只能有 9 镜。
它还专门给了「16 镜 + 1 个 30 秒生成段」这个组合,标注为合法。
节奏档位也有明确区间。15 秒片,克制 3 至 5 镜、标准 5 至 7 镜、快节奏 7 至 10 镜。30 秒片,快节奏 14 至 18 镜、标准 11 至 14 镜、克制 8 至 10 镜。普通快节奏镜头多为 1.2 至 2.2 秒,标准节奏 1.8 至 3 秒,转场通常控制在 0.2 至 0.8 秒。
对比一下自己的提示词。如果里面写的是「节奏快、快切、电影感」,那就等于什么都没说。要把计划镜头数和每个模块的镜头数写进去。
文档里还有一句提醒,快节奏 30 秒片每 4 至 6 秒必须增加新的故事或商业信息。镜头多不等于节奏一定快,如果两个镜头承担相同的动作和相同的商业任务,合并它们。
关于开场,这份文档有一整套硬门槛,也是我认为写给甲方看都会认同的部分。
常规前三秒必须完成四件事。
1第一帧已经处于动作、决定、反应或冲突之中,并提供最低限度的情境锚点
2前 0.7 秒发生触发,前 2 秒发生决定性事件,三秒内形成明显不同的结束状态
4这个事件直接由产品、质地、声音、使用结果或核心主张触发
它还列了一份「禁止的伪钩子」清单。
5先放 Logo 或 slogan,却没有视觉问题和变化
判断钩子是否成立,文档给了一个填空句。
第一帧看到____;三秒内____发生;这件事让人想知道____,并指向产品的____。
如果填不完,重新设计。它还补了一句更狠的,去掉品牌名后仍然能用于任何产品的通用「高级画面」,不算有效钩子。
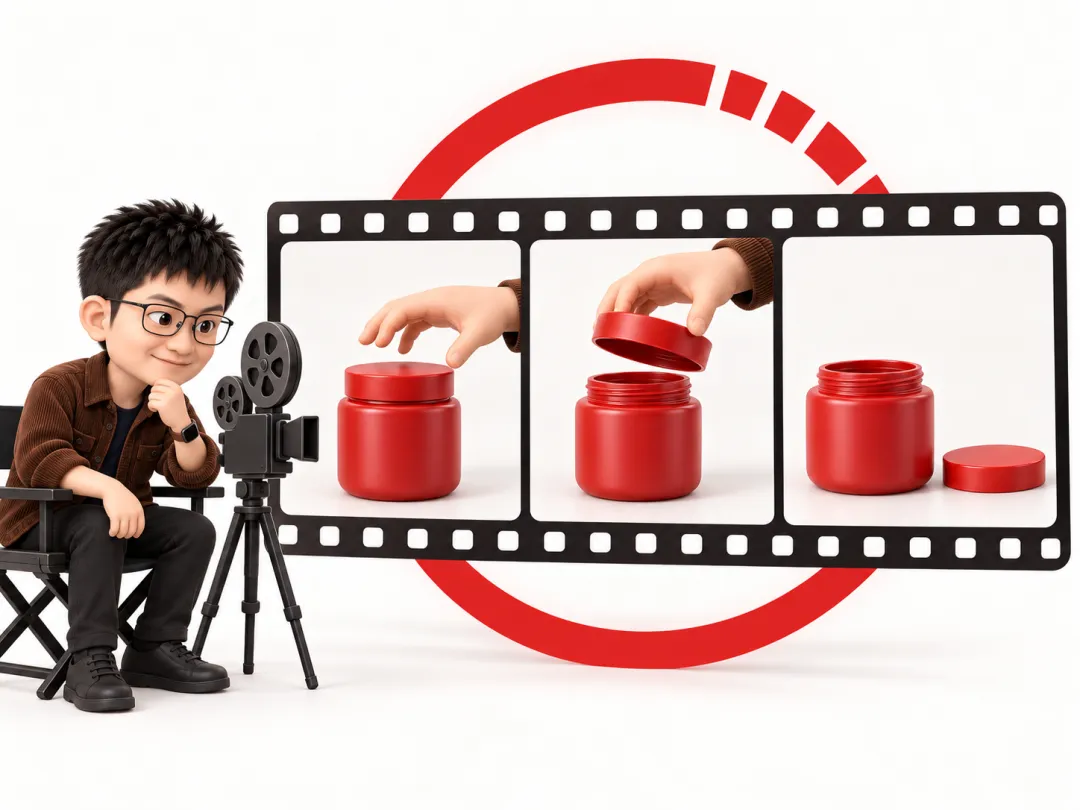
还有一个容易被忽略的细节,叫完成态检查。快切不能在观众尚未看见结果时离开动作。关电脑要短暂看见屏幕熄灭,开盖要看见盖子脱离,触碰要看见接触已经发生。要把结束状态保留大约 0.15 至 0.35 秒,或者让下一镜的第一帧继承这个结果。
「镜头数量达标,但观众看不见动作完成,仍然算失败。」
这句话值得所有做短视频的人抄在本子上。
06VOICE & MIDDLE
被忽视的两段时间,旁白和中段
先说旁白
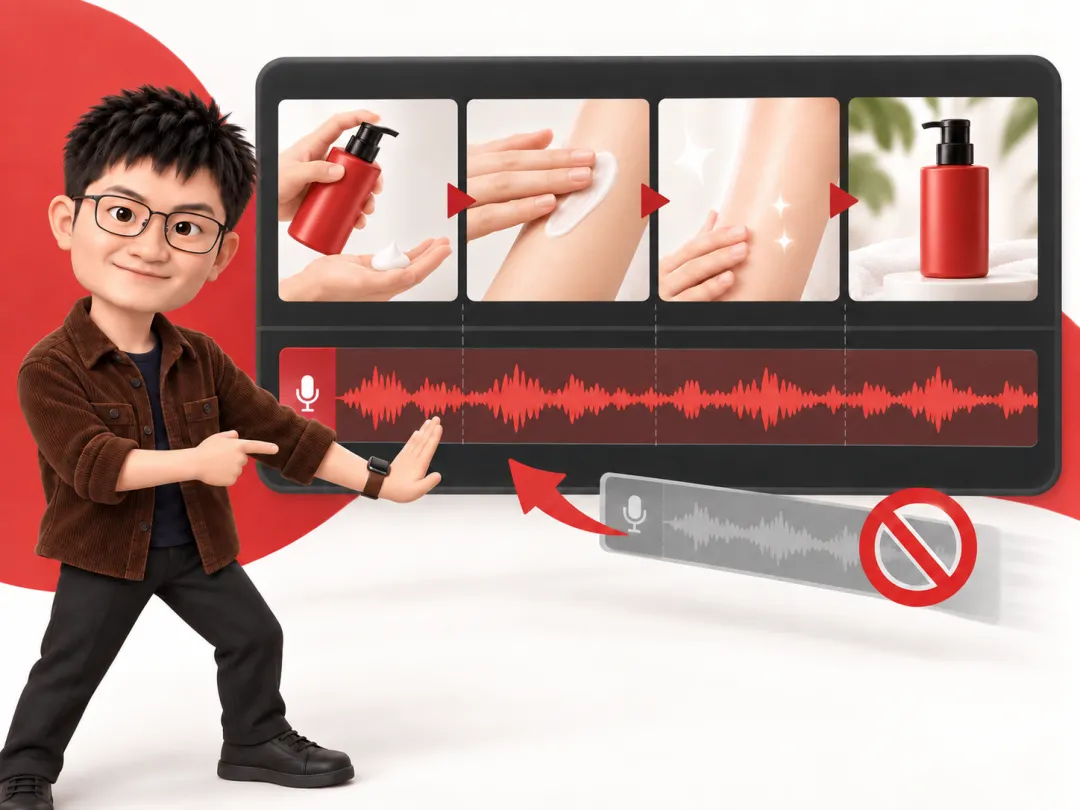
这份文档用一整套数据结构来解决旁白被重复念的问题。
它要求先建立全片单一的主旁白清单,每句分配一个编号,标注唯一原文、开始时间、硬停止时间、说话者和重复次数。重复次数默认为 1。镜头时间轴里只写编号,不重复粘贴原句。
原因写在文档里。如果在每个场景内都写一遍同一句话,模型会理解成一次新的发声请求,于是它念两遍、三遍,或者一句念完重新起头。
还有一条经验值得记住。30 秒片的最后一句旁白,要在 29 秒前硬停止,留出大约 1 秒的纯音乐或产品尾音,避免在生成边界出现截断和尾句回声。
再说中段
这是很少有人量化的一段时间。
文档要求,30 秒有旁白的商业片要单独审计4 到 23 秒这一段。计算没有信息性旁白正在发声的最长连续区间。任何超过大约 2.5 秒的空窗,必须写明由哪一个强事件接管注意力。如果某一区间连续超过 4 秒,既没有人声也没有强接管事件,判定为中段注意力断层。
它同时列了什么不算接管。普通硬切、持续不变的背景音乐、第二个人重复同样的入口和微笑、无因果的凝视、轻微推轨。
还有一个物理层面的护栏。最终产品镜头之外,低运动画面若超过大约 2 秒,必须出现第二个可见状态、有效主体运动或新的商业信息。两个承担相同任务的人物氛围镜头,不允许连续出现。
💡 判断片子中段为什么塌,可以用这两个数字自查,2.5 秒和 4 秒。
07RETRY LOGIC
复盘的正确姿势,先分层再动手
生成完不满意,多数人的处理方式是重新写一版提示词,从头抽卡。
这份 Skill 处理复盘的方式不同。它要求先用全片等间隔抽帧建立镜头地图,对失败动作高频抽帧,并测量实际的硬切与转场边界。然后区分成功层与失败层,输出三样东西。
举例来说,第二个人物不符合品牌调性。它只要求修改选角、造型、表演、空间或灯光当中被证据指向的那一层,不允许自动推翻产品外观、时长结构和旁白,也不允许推翻已经成功的镜头。
它还给了「计划 16 镜但实际只生成 6 至 8 镜」的五个排查点。
这五条几乎覆盖了我见过的所有「AI 视频不够看」的现场。
写到这里要泼一盆水。
这份文档的边界写得很清楚,我如实转述。
它是导演与提示词编译 Skill,不保证任何平台的生成效果、参数上限或商业可投放性。精确的 Logo、包装小字、价格、行动号召和免责声明,应该由后期使用获批资产完成。未经验证的功效、数据、认证和绝对化表达,必须保留为待补项。模型的实际能力可能因入口和时间变化,使用前以当前平台为准。
它的规则文档里也不包含任何可执行脚本,不联网,不读取外部账号,不请求任何权限。
还有一点值得所有做 AI 商业内容的人记住。这份文档明确要求,不得把「约 30 岁女性」当作选角指导。数字年龄必须与可见的年龄感、现代造型、表演能量、空间美术和灯光共同定义。
它还说,描述质感要用可见动作、物理反馈、机位关系、光源和声音,少用「高级、震撼、大片感、8K」这类空词。
这些词被点名,原因很简单。它们背后只有形容词,看不到具体判断。
安装很简单。如果是豆包直接调用即梦大模型,那直接跟豆包说
帮我安装这个skill技能:nutllwhy/seedance-tvc-director
以 Codex 为例,克隆仓库后把 Skill 文件夹放进 Skills 目录。
git clone https://github.com/nutllwhy/seedance-tvc-director.git
cp -R seedance-tvc-director/seedance-tvc-director ~/.codex/skills/
其他支持 Skill 机制的 Agent 客户端,把 seedance-tvc-director 文件夹放进各自的 skills 目录即可。调用时把六项配置一次写清。
使用 $seedance-tvc-director,为这个产品做一支 30 秒 TVC。
声音选择有旁白,生成方式选择直出。
这是产品图和卖点,请先给我完整提示词。
生成完成之后,还可以把片子重新交给它做复盘。
使用 $seedance-tvc-director 复盘这支成片。
请保留已经成功的产品、人物和旁白,只根据时间码修最主要的问题。
如果你手头没有商业 brief,也没关系。这份文档本身就是一份广告片自检清单,把 0 到 3 秒、4 到 23 秒、完成态、衔接接口这几组规则拿出来,对照自己已有的视频或提示词逐条打勾,价值就已经到位。
我看完这份文档之后有一个挺深的感触。
它做的这件事,表面上是在给 AI 视频写提示词模板,实际上是在把一位广告导演几十年积累的直觉,拆成可以逐条核对的判断。哪一秒观众会走神,哪个动作必须让观众看见结束,哪句话不该说第二遍,这些原本靠经验的东西,现在有了数字。
但它同时也在提醒一件事。规则写得再细,判断的核心仍然在人这边。它给的是检查表和边界,往里面填什么故事、主张什么价值,还是得自己拿主意。
模型把画质这一关过了,剩下的考题交还回来了。
镜头数量达标,但观众看不见动作完成,仍然算失败
你做 AI 视频时,被打回次数最多的问题是哪一个?前三秒不够抓人,还是中段太拖?评论区聊聊,我挑几个具体案例出一版诊断。
我是 AI·王陈说,把 AI 用法讲给普通人听。
如果你觉得今天这篇有收获,欢迎点赞、在看、转发三连,我们下篇见。