论文信息:超越结果:用于高效智能体评测的双视图关系学习(Beyond Outcomes: Dual-View Relational Learning for Efficient Agent Benchmarking)
发表平台:arXiv:2609.18909
提出单位:腾讯混元团队 联合 清华大学;一作 Xinshuai Guo(腾讯混元/清华),通讯 Junjie Wu、Hai-Tao Zheng、Maxm Pan
给一个 Agent 做全量评测,究竟要花多少钱?论文在 APEX-Agents 基准上算了一笔账:评一次 Claude Opus 4.8 要烧掉约 1.09 万美元,Gemini 3.5 Flash 即便开十路并行也要跑上 2.7 天。
更麻烦的是,这些成本不是一次性的,模型每改一版、每上一个新模型,账单就得重来一遍。Agent 评测比普通大模型评测贵得多,已经成为高频评测的最大拦路虎。
压缩基准是省钱的自然思路,但现有方法几乎都是为静态大模型基准设计的,而且只盯着「最终得分」做筛选。
论文一针见血地指出:在 Agent 评测里,同样的结果可能来自完全不同的行为,只看结果、不管过程,压缩出来的子集天然是残缺的。腾讯混元联合清华提出 DualViewEval,把「结果关系」和「过程关系」两个视角同时喂进一个端到端框架,只挑 20 个任务就能近似全榜 480 个任务的表现,误差相比最强对手最高降 28.2%。
阅读提示,本文将回答三个问题:
① Agent 评测为什么比大模型评测贵这么多,只压结果为什么不够?
② 论文从海量轨迹里提炼出的六维「过程信号」各是什么,凭什么能区分模型能力?
③ DualViewEval 如何用一个「直通 Top-K 门」同时学出任务子集和分数预测器?
DualViewEval 的核心思路可以一句话概括:给每个任务同时建两张「关系网」,一张看结果、一张看过程,再把两张网融合成一个 Agent 核,用它同时学出一个精确大小的任务子集和一个分数预测器。
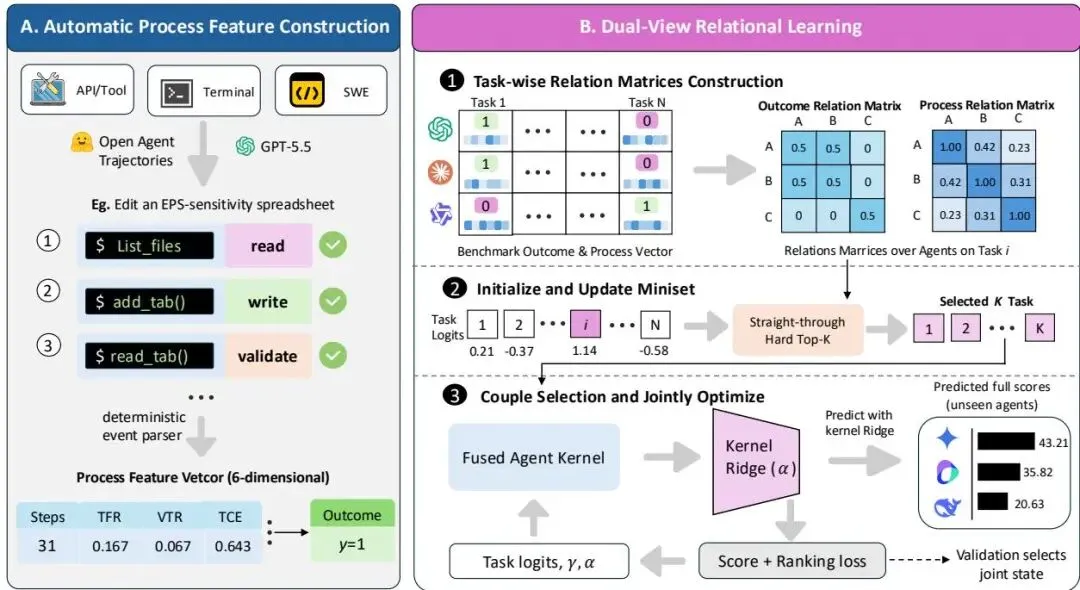
图1 DualViewEval 整体框架(论文 Figure 4):双视图关系矩阵融合后,联合优化精确大小的 Top-K 子集与 Kernel Ridge 预测器
整个框架端到端可微。任务的选择不是预先定死的,而是每个任务持一个可训练 logit,由直通 Top-K 门在训练中动态决定进出;预测器用 Kernel Ridge 线性头,容量低、在小样本配置下更稳。选择与预测形成同一个反馈回路,每一步梯度更新都会改写任务排序、产出下一个精确大小的子集。
Agent 评测的成本结构,和传统 LLM 评测有本质区别。静态基准是「给一段话、出一个答案」,而 Agent 基准要长程推理、反复调用工具、与有状态的环境持续交互。每跑一个任务,就要消耗几十上百轮的模型推理和工具往返,时间与算力都被放大了一个量级。
全量评测的成本具体有多高,论文给出了直观的数字:Claude Opus 4.8 在 APEX-Agents 上约 1.09 万美元,Gemini 3.5 Flash 约 2.7 天。这些开销会随每一次模型修订、每一个新模型的引入而复现,让「频繁、全面」的评测在工程上几乎不可行。
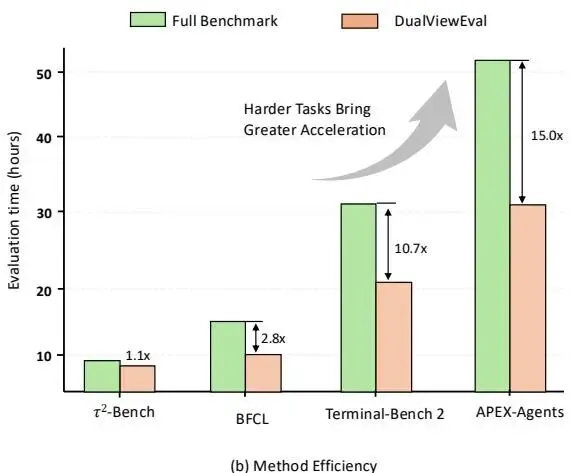
图2 评测成本与压缩效果(论文 Figure 1):全量评测耗时耗钱,压缩后的 miniset 显著加速
现有压缩方法的问题在于两处。其一,它们多为非 Agent 基准设计。其二,进阶方法如 SparseEval,只在任务响应向量之间建模冗余,关注的是结果矩阵的列间关系,忽略了 Agent 之间的共享结构以及每个结果背后的执行过程。但 Agent 场景里,同样的失败可能源于工具选错、参数填错、还是验证缺失,这些过程信息在结果里根本看不到。
论文的核心洞察是:轨迹行为能可靠地区分模型能力,即便它们的最终结果相似。团队分析了五个开放轨迹的 Agent 基准,从十二个候选统计量中筛选出六个互补、可自动提取、语义冗余有限的测量:
| |
|---|
| 智能体步数,决策/动作轮次,反映轨迹长度与执行投入 |
| |
| |
| |
| 必需写入执行,需外部状态变更时是否真的执行了写操作 |
| Read-write-validate closure | |
这六维测量与最终得分之间存在系统性的关联。论文用跨基准的 Spearman 相关性证明:低、中、高三档得分的模型,其过程分布呈现出明显分化。换句话说,一个模型「怎么干活」,本身就是一条独立于「干成没有」的能力线索。
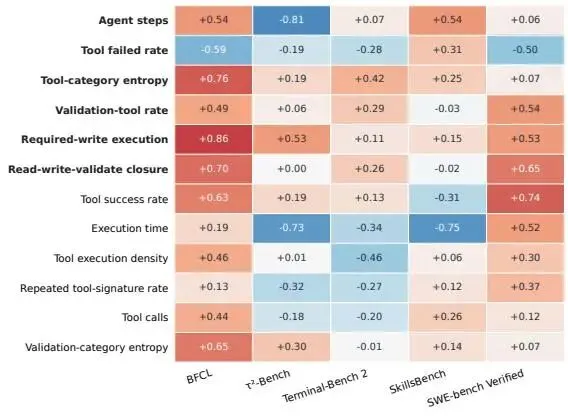
图3 过程信号与性能的关联(论文 Figure 2):六维过程测量与最终得分系统性相关
Agent 基准的轨迹格式五花八门,有对话、API、Shell、环境日志。论文的做法是给每个基准写一个适配器,把各类格式统一映射成共享的事件序列,保留 assistant 轮次、工具调用与观察结果。随后在事件序列上套统一规则,得到六维测量向量。
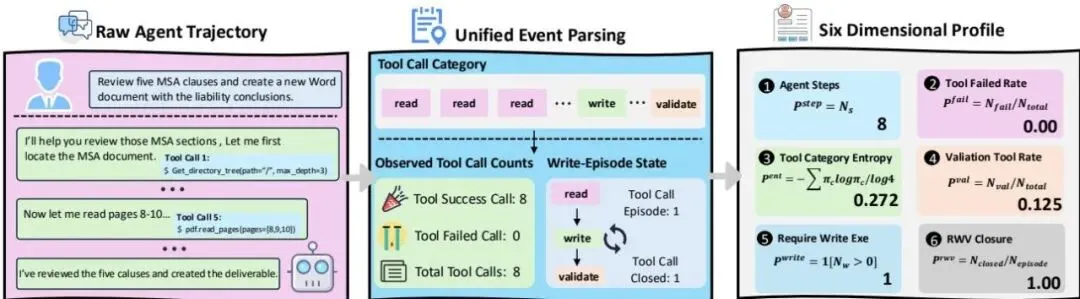
图4 六维过程测量的自动构建(论文 Figure 3):异质轨迹经适配器映射为统一事件序列
以一条 APEX-Agents 轨迹为例:八次 assistant 步、八次成功的工具调用、一次完整的写加核验闭环,产出原始向量 [8, 0, 0.272, 0.125, 1, 1]。这六个数字,就是该模型在这条任务上的「行为指纹」。
DualViewEval 把「挑任务」和「预测分数」耦合成一个端到端优化问题,分四步完成。
第一步,构建任务级双视图关系矩阵。对每个任务,分别建两个以相同 Agent 为索引的对称矩阵。结果视图把每个 Agent 的得分编码为二通道向量,内积刻画 Agent 对的成败一致性;过程视图把标准化后的过程画像与其观测掩码拼接,只对共同可观测的维度计算相似度,同时显式暴露「哪些测量真正可获取」。两个矩阵都是半正定 Gram 矩阵,预计算一次即可复用。
第二步,维护精确大小的任务子集。每个任务持有一个可训练 logit,每轮取 Top-K 形成当前子集。关键在直通门设计:
g = h + q - sg(q) // 前向用硬掩码 h,反向继承 softmax 梯度q = K * softmax(theta / tau) // tau 随训练退火
前向传播用硬掩码保证恰好 K 个任务,反向传播借道 softmax 传递梯度。任务进出子集完全由 logit 是否越过 Top-K 边界决定,全程不预设任何一对一替换规则。
第三步,把选择与预测耦合进一个核。选中的关系矩阵融合成 Agent 核:
K = (1/K) * sum( g_i * (R_i^y + gamma^2 * R_i^p) )
其中 gamma 控制过程关系对结果的补充强度。用 Kernel Ridge 从参考 Agent 预测查询 Agent 的全榜分数。选线性预测头,是因为 Agent 基准的观测配置数远少于任务数,低容量反而更稳。训练 Agent 被分成五折交叉拟合,防止子集靠「自我预测」骗分。
第四步,按 MAE 排名加排序误差排名选最终状态。每轮产物都在验证集上打分,取两项排名之和最小的那轮,得到最终的子集与预测器。
实验覆盖五个 Agent 基准(BFCL、τ²-Bench、Terminal-Bench 2、SWE-bench Verified、APEX-Agents),对齐出 1,983 个任务、262 个配置、13 万条结果对,与五个代表性压缩基线(Anchor Points、gp-IRT、TailoredBench、EssenceBench、SparseEval)对比,每个配置按 60/20/20 划分、十次随机切分取均值。
在 BFCL 上,20 个任务时 DualViewEval 的 MAE 为 4.202%、Kendall's τ 为 0.843,全面优于所有基线;40 个任务时 MAE 降到 3.230%、τ 升到 0.901,继续拉开差距:
整体来看,DualViewEval 在全部五个基准、全部三个子集规模上均取得最优。相对最直接的竞争基线 SparseEval,平均 MAE 降低 30.5% 到 45.1%,平均 Kendall's τ 提升 0.089 到 0.115。仅用 20 个任务,就在 APEX-Agents 与 BFCL 上实现 24 倍到 40 倍压缩;相对最强对手,MAE 降低 14.5% 到 28.2%;在 SWE-bench Verified 上,τ 相对 EssenceBench 最高提升 7.2%。优势不随子集扩大而消失,说明过程关系提供的是额外信息,而非小预算下的权宜补偿。
双视图缺一不可。消融显示,结果关系矩阵提供主要的分数重建信号,过程关系矩阵则补充二值结果里不存在的行为结构。去掉过程视图,MAE 明显上升;去掉结果视图,则在终端基准上近乎失效。两者相加才拿到最均衡的误差与排序。
直通门优于其他选择器。对比稠密 Softmax 门与 DSelect-k,直通硬 Top-K 在紧预算下最强,前向始终精确匹配部署预算,也避开了 DSelect-k 的二次近似。
核岭回归优于 MLP。在全部子集规模下,Kernel Ridge 的 MAE 更低、τ 更高,且子集越大优势越明显,印证了低容量预测头在小样本配置下更稳的判断。
过程关系在紧预算下最值钱。把子集规模从 20 拉到 500,DualViewEval 在 K=80 时相对 MAE 降幅达 22%,随子集覆盖基准的更多部分,差距逐步收敛,说明过程关系正是在「必须用极少任务保住信息量」时发挥关键作用。
跨模型族泛化更值得注意。APEX-Agents 上把七个 Qwen 系配置全部留作测试,训练完全不含 Qwen,DualViewEval 的平均 MAE 为 2.020,远低于 SparseEval 的 5.897,并在七个留出配置中的五个上取得最小误差。学到的关系结构并不依赖特定模型族。
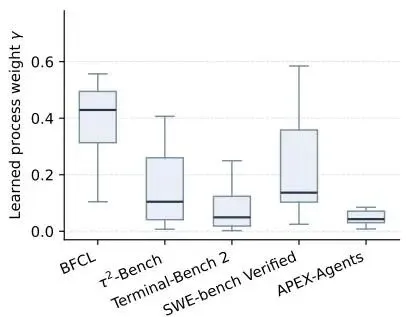
图5 学到的过程权重 γ 分布(论文 Figure 8):不同基准对过程关系的依赖程度不同
过程权重 γ 是自适应学出来的。图5 显示它在不同基准上分布各异:有的基准给过程关系更大、更宽的角色,有的则集中在较小权重附近。固定 γ 的灵敏度实验印证了同一结论,说明「结果与过程如何配比」这件事,本身就该交给数据去学,而不是拍脑袋定一个常数。
DualViewEval 选出的子集还有一个被低估的副产品:过程画像。它放大了模型间的执行差异。以 APEX-Agents 的六个模型为例,Gemini 3.5 Flash 的工具使用与验证频率明显高于 Qwen 3.7 Max,但步数与失败调用画像更差;这些差异在 20 或 40 个任务的子集上被凸显,随子集扩大逐步回归全榜分布。
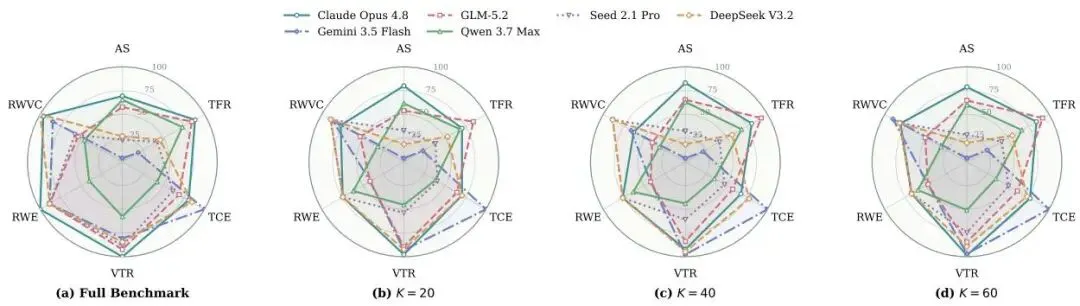
图6 六模型的完整与压缩过程画像(论文 Figure 11):miniset 保留并放大了行为差异
这意味着压缩子集不只是「便宜的替代品」,而是一份紧凑的诊断报告。聚合分数看不见的能力差异,在过程画像里一目了然。训练成本同样占优,相对 SparseEval 训练提速约 4.2 倍到 8.3 倍。
论文的局限在于两点。其一,过程信号依赖开放的、可解析的轨迹,轨迹缺失的基准难以受益。其二,六维信号是人工设计的统计量,覆盖的是「可观测行为」而非「内在推理」,仍可能漏掉关键信息。
把视野拉远,这项工作指向几个更深远的方向。
第一,Agent 评测将从「抽样估分」走向「过程诊断」。当二十个任务既能估准全榜分数、又能暴露过程差异,评测就具备了诊断能力。未来的模型迭代不再只看排名涨跌,而是能定位到具体哪一类行为退化,是验证变少了,还是工具失败率上去了。这正是 AI 工程化所缺的那块拼图。
第二,压缩基准会成为 Agent 持续集成的基础设施。评测提速 4 到 8 倍、20 题近似全榜,意味着每次代码改动都能跑一次「迷你评测」。配合过程画像,可以搭出一条类似软件 CI 的 Agent 回归测试管线,在模型或 harness 变更后自动拦截能力回退。
第三,过程视角将重写评测的经济学。论文揭示了一个被长期忽略的事实:过程数据比结果数据信息密度更高。压缩的本质是挑选「信息密度最高」的任务,而过程视角提供了全新的信息密度度量。这会让评测资源的配置方式发生根本改变,从「跑更多题」转向「跑更有信息量的题」。
第四,跨模型族泛化暗示「评测结构的预训练」。留出 Qwen 族的成功泛化,说明关系结构可以跨模型族迁移。这为一种新形态铺路:在大规模轨迹上预训练关系结构,对任何新模型近乎零成本地压缩评测,评测本身成为可迁移的知识。
第五,静态子集终将让位于自适应评测。直通门本质上是一个可学习的采样策略,与主动评测采集天然同源。两者一旦合流,评测就会从「固定挑 20 题」演化为「根据前几题的作答动态决定下一题」,在更小预算下逼近全榜,并针对性地探测未知模型的能力边界。
从「结果」到「结果加过程」,看似只是加了一个视角,实则把评测从一个打分工具升级为一台诊断仪器。当 Agent 评测成本不再是瓶颈,高频、全面、可诊断的评测才真正成为可能。