AI WORKFLOW
2026 Mac 本地大模型怎么选
从 16GB 到 512GB:先算模型容量、再看带宽和速度,按长期任务选对 Mac。
WORKFLOW · 01
先别比芯片,先算你的模型要什么
想在 Mac 上跑本地模型,先别急着问哪颗芯片更强。真正要先确定的是:目标模型能不能装下、装下后回答会不会慢,以及长文档、图像或微调任务会不会把体验拖垮。
这里说的本地运行,是把模型文件放进电脑,让它直接使用本机芯片和内存推理。好处是数据可留在本地;代价是模型体积、速度和软件兼容性都要自己负责。
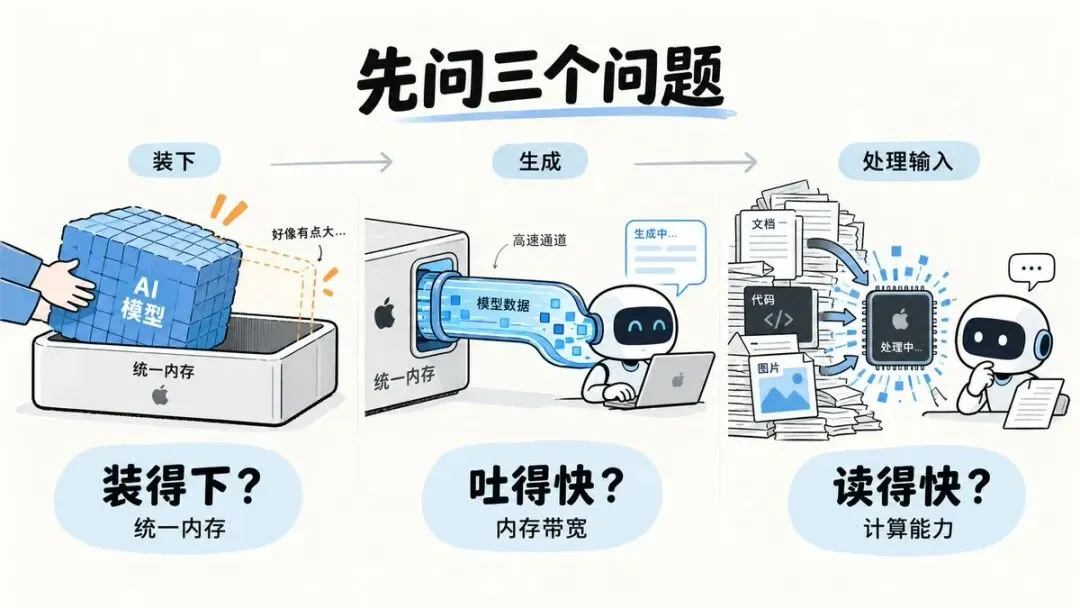
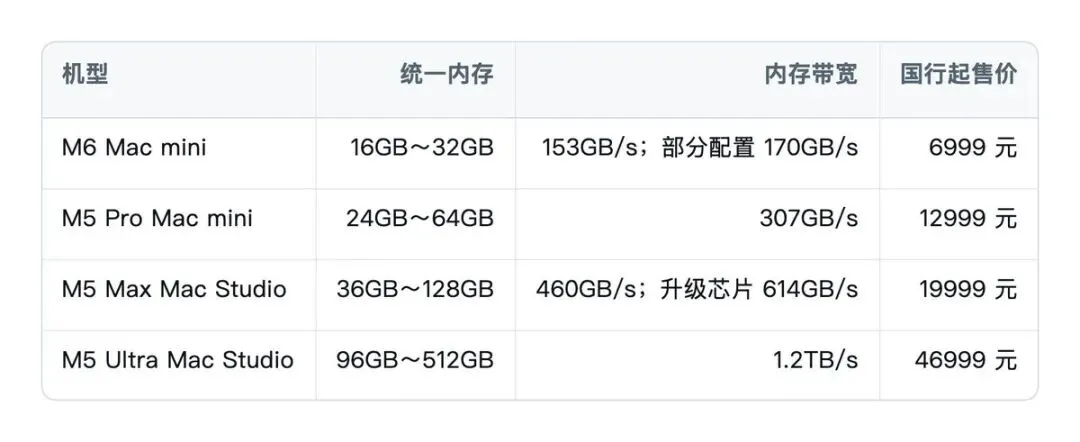
选机器时抓住三个硬指标就够了:统一内存决定能否装下模型,内存带宽影响模型持续生成的速度,计算能力影响长提示词、图像和训练类工作。
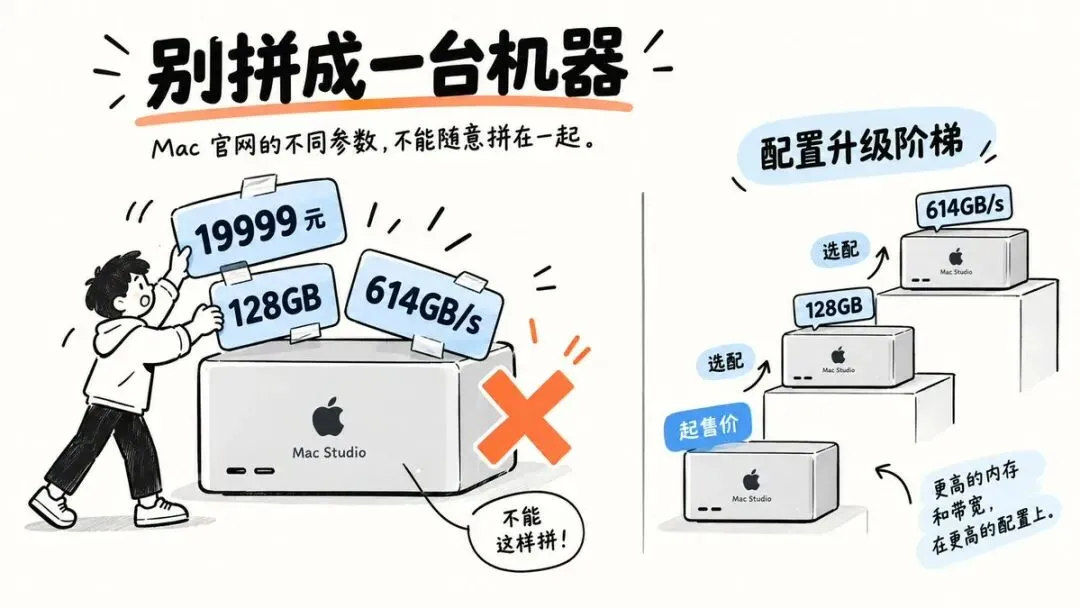
尤其别把起售价、最大内存和最高带宽拼成一台想象中的“顶配低价机”。预算应该按自己要买的具体配置算,而不是看官网起步价。
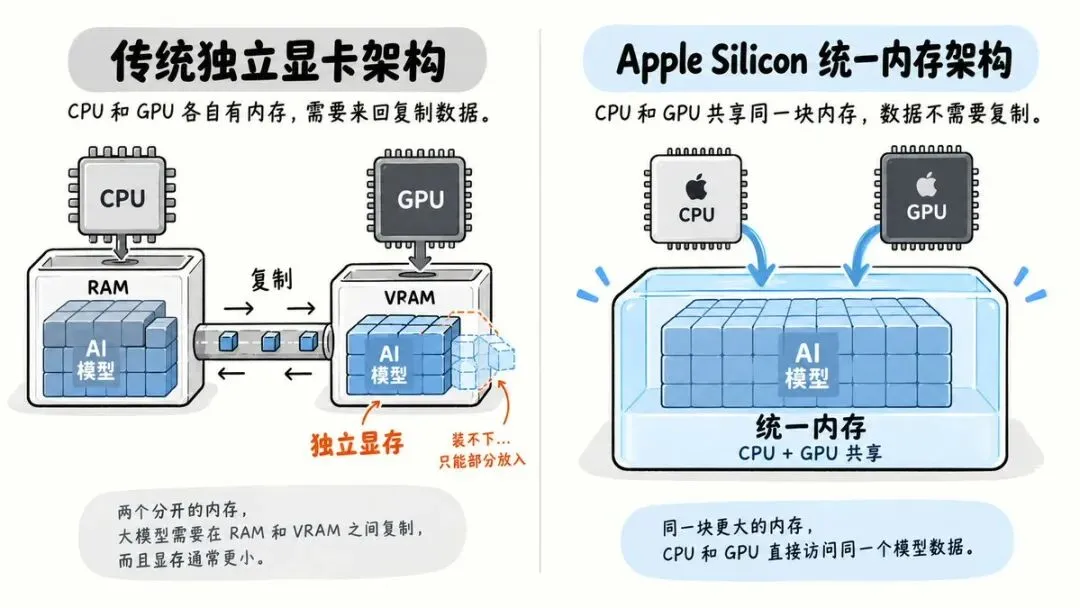
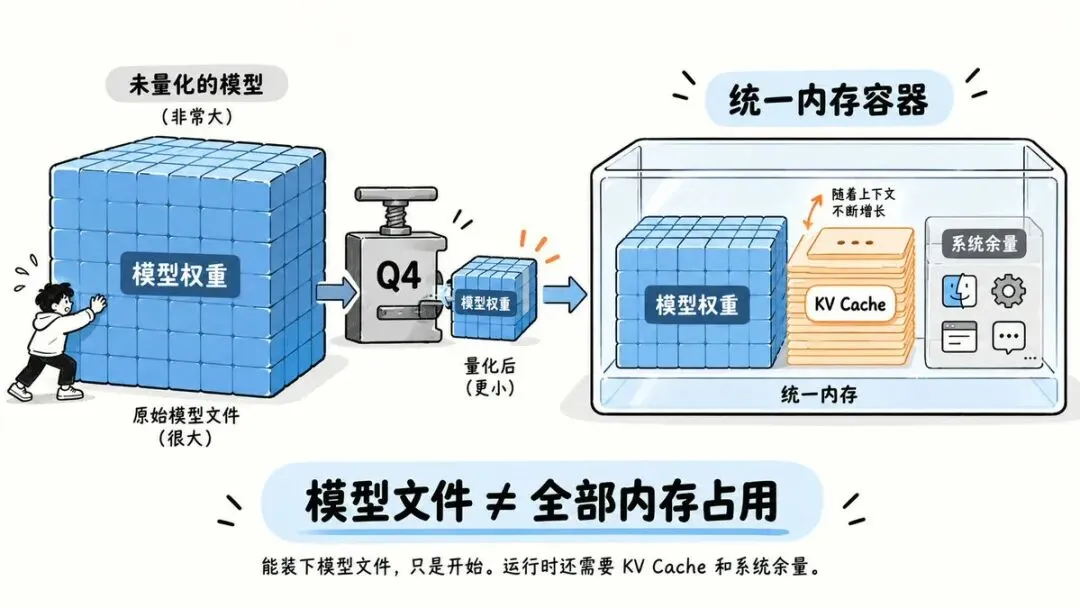
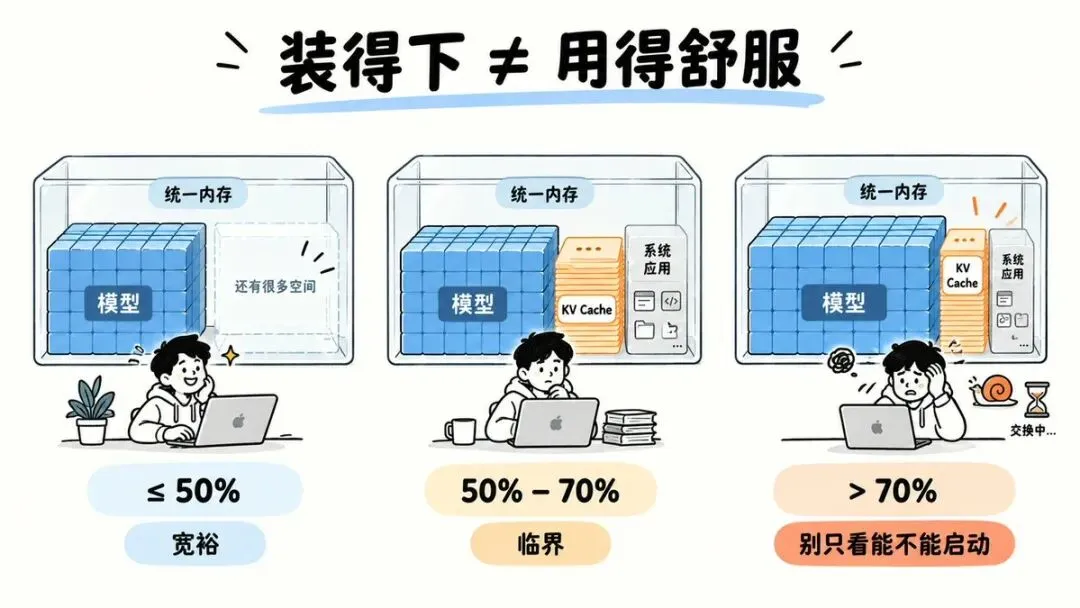
本地推理的第一道门槛是容量。模型权重、系统、推理框架、上下文缓存和其他应用都会占统一内存;Apple 芯片的优势是 CPU 与 GPU 共用一套大内存,不用在两套内存间反复搬运。
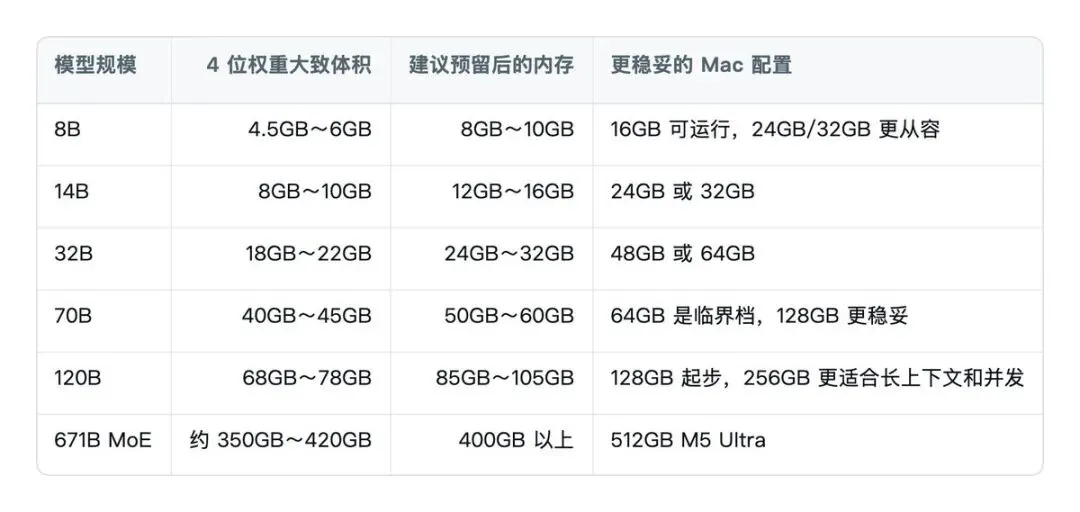
模型常用量化来缩小体积。4 位量化是本地部署里很常见的一档,但购机时不能只看纯权重,仍要给系统和 KV Cache 预留空间。
4 位量化权重 ≈ 参数量 × 0.5GB / 10 亿参数
购机估算 ≈ 权重体积 × 1.2~1.4
这只是选机器的粗算,不是具体模型文件的替代品。真正购买前,仍应核对目标量化版本的文件大小、上下文长度和推理框架需求;“能启动”也不等于适合每天稳定使用。
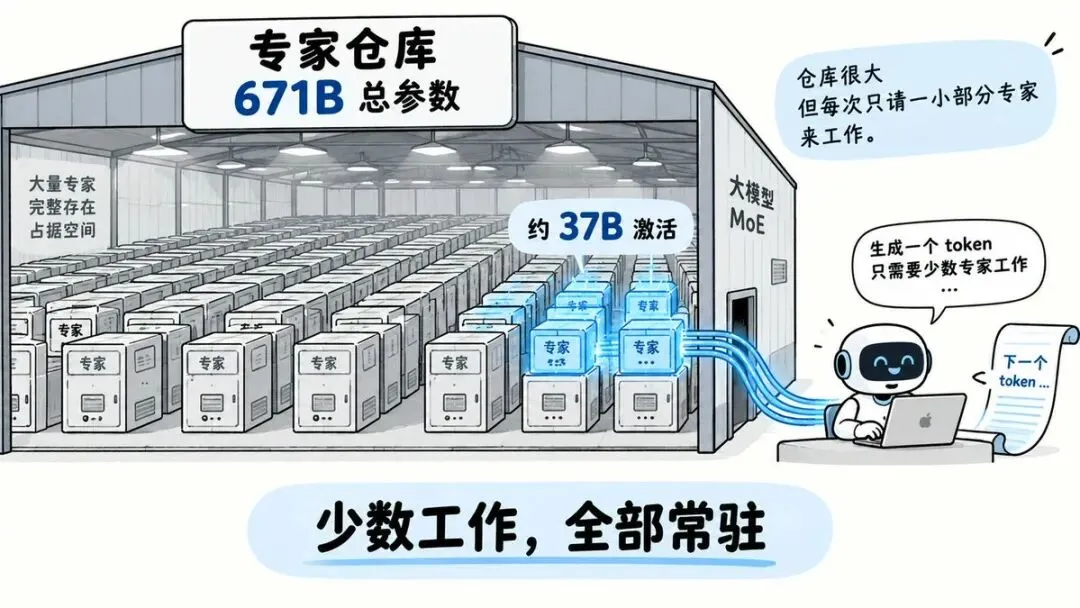
MoE 模型尤其容易被误解。它可能每次只激活一部分参数,但完整权重仍要常驻内存,所以容量要按完整模型准备,不能把总参数量直接当成激活参数量。
另外,“GPU 默认能用 75% 统一内存”只能算经验说法。系统版本、机器容量与框架不同,结果都可能变化;把调高 `iogpu.wired_limit_mb` 当购机前提更不稳妥,预留空间才是正路。
WORKFLOW · 03
第二笔账:装下以后能跑多快
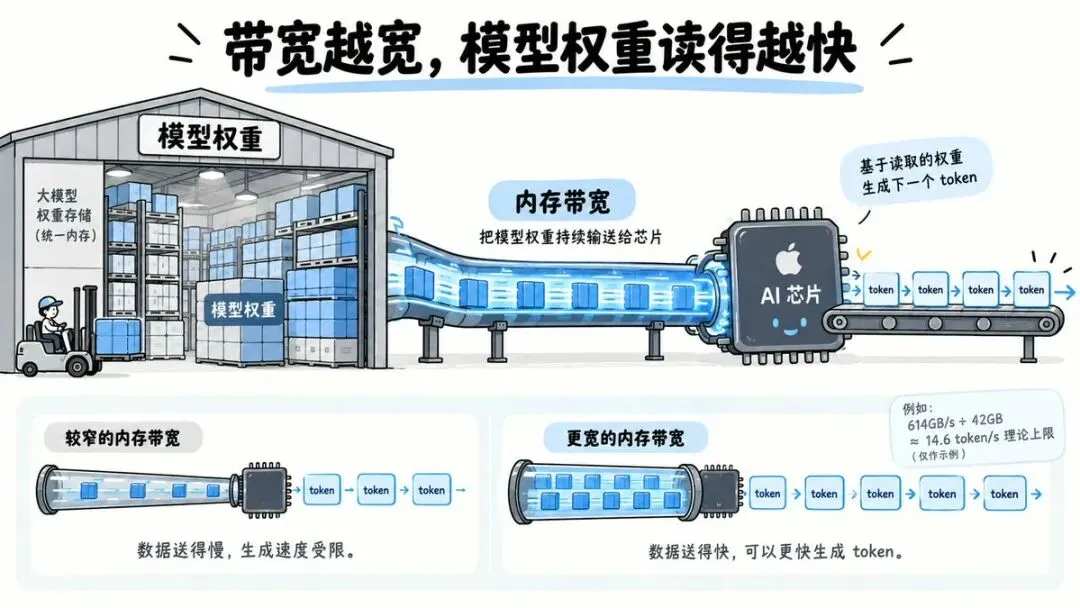
单用户逐词生成时,模型反复读取权重,速度常常受内存带宽限制。下面这个式子只适合估算理论上限,不能替代相同模型、量化和上下文下的实测。
理论生成速度 ≈ 内存带宽 ÷ 每生成一个词元需要读取的数据量
以文中的 70B 四位量化组合为例,带宽除以约 42GB 权重,得到的是理想状态下的上限:
实际速度还会被框架、量化、上下文长度、内存利用率与采样参数拉低。把理论上限打五到七五折,更适合拿来做保守预算。Mac 的优势是单机可装下更大的模型,并不意味着同一个小模型一定比高端独显更快。
框架也别迷信固定百分比。MLX、llama.cpp、Ollama 与 LM Studio 各有适配场景,最可靠的方法是在同一模型、同一量化、同一上下文下实测比较。
WORKFLOW · 04
第三笔账:首词速度和吐字速度不是一回事
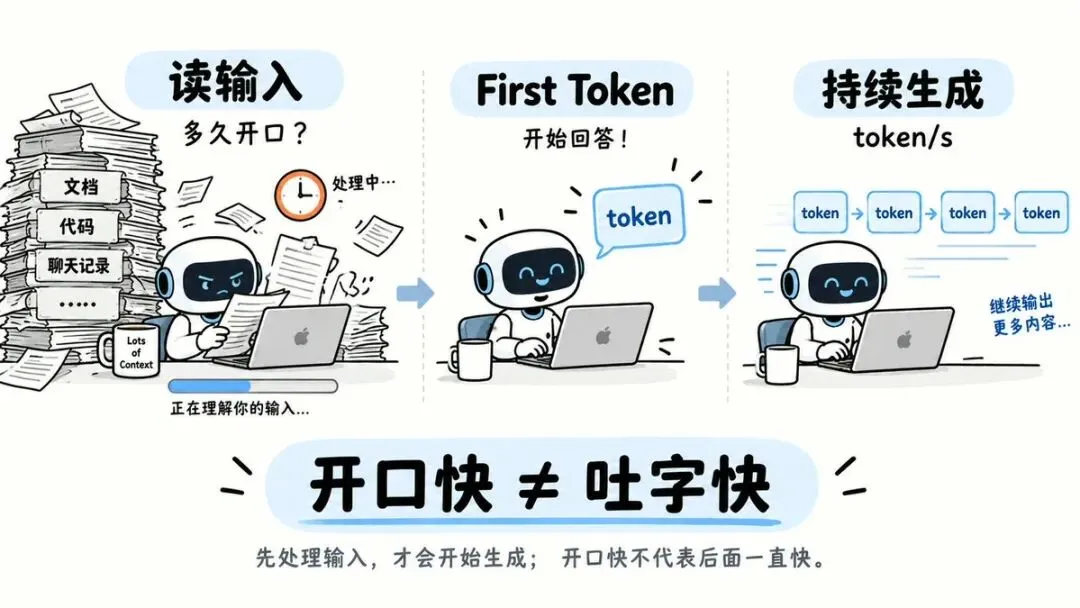
模型速度至少要分两段看:先读完输入的提示词,才会开始逐词生成。短问题更容易感知吐字速度;把长合同、完整代码库或超长对话塞进去时,决定体感的往往是前半段的提示词处理速度。
提示词处理更依赖并行计算与软件生态,不能只看带宽。对官方发布页上的性能倍数、上市节奏或具体 token/s,最好核对测试日期、模型、量化版本与上下文长度,不要把宣传口径当成第三方实测。
WORKFLOW · 05
四档配置,按长期主力模型倒推
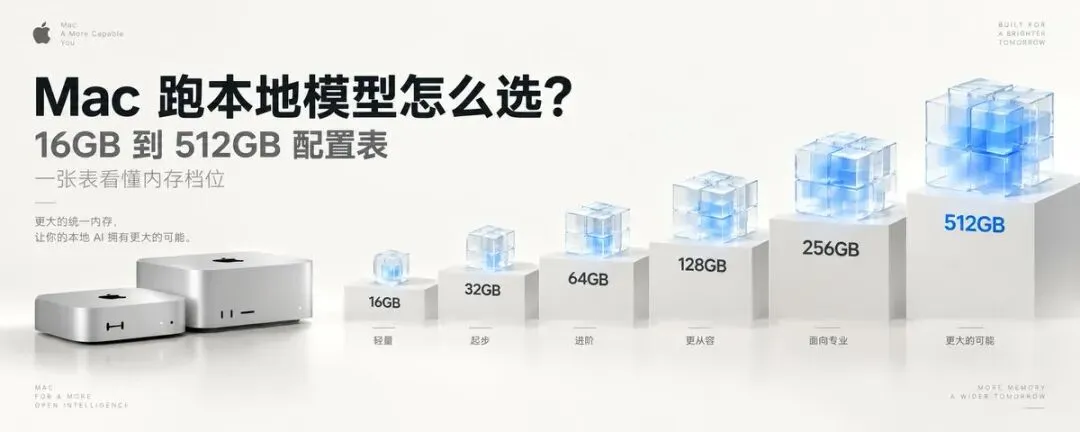
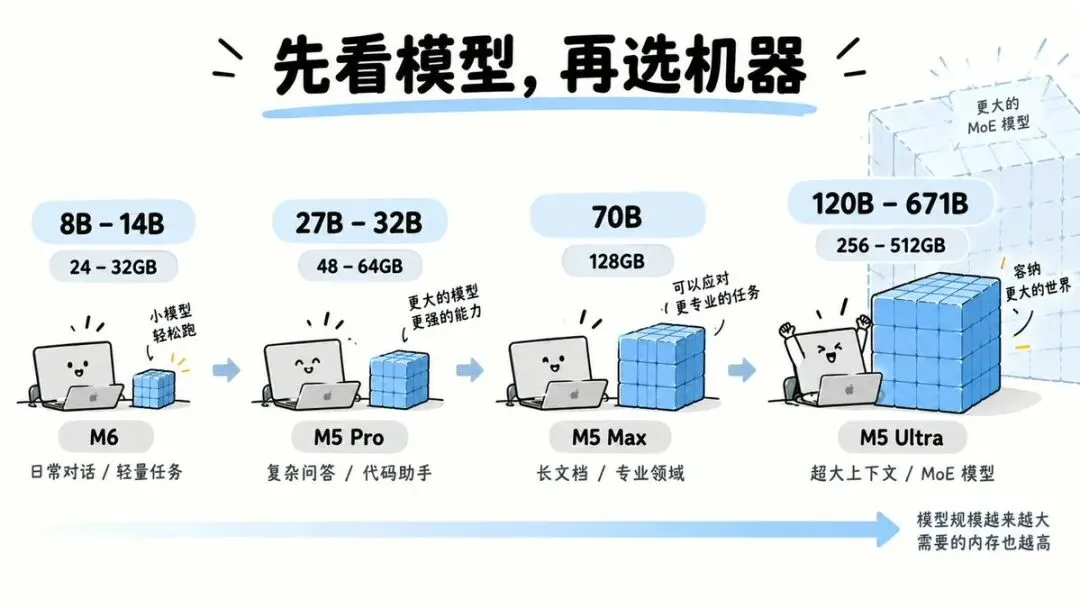
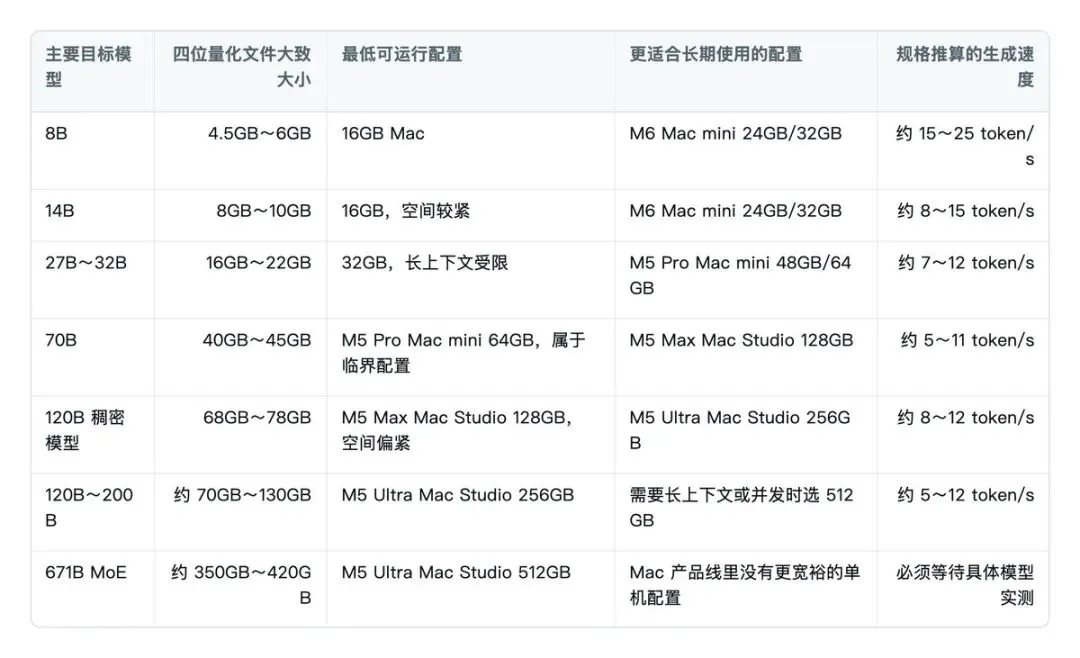
8B~14B:优先考虑 24GB 或 32GB 的 Mac mini,适合问答、翻译、摘要、笔记整理和轻量代码补全。16GB 虽能启动不少小模型,但很容易被系统和日常应用挤满。
32B:64GB 的 M5 Pro Mac mini 是更均衡的长期档。若只跑一个模型,48GB 也许能用;同时开开发工具、知识库服务或更长上下文时,64GB 会从容很多。
70B 为主、偶尔尝试 120B:128GB 的 M5 Max Mac Studio 更合理。70B 放进 64GB 往往只是临界可用,128GB 才能给模型、KV Cache 和系统留出空间;买时还要核对不同 GPU 配置带来的带宽差异。
200B 以上或完整 671B MoE:考虑 256GB/512GB 的 M5 Ultra。这一档解决的核心是容量,而不是一台“更快的普通电脑”;目标框架、首词延迟、长上下文占用和持续负载仍要看真实测试。
WORKFLOW · 06
哪些情况不值得为本地模型买 Mac
如果你主要想用最强闭源模型、要做大规模训练/复杂微调、每天处理极长文档且要求几乎立即响应、只是偶尔问几句,或者要做高并发对外服务,云端 API 或 NVIDIA 工作站往往更合适。
本地运行的价值主要落在三种场景:数据不能出门、调用量长期很高,或者必须离线运行。其他情况下,最贵的配置未必是最划算的生产力。
先确定准备长期使用的模型和量化版本,再倒推统一内存容量、内存带宽、可接受的生成速度,最后才计算完整选配价格。容量、速度与软件生态是三件独立的事,别用一项掩盖另外两项。
实际权重文件 + KV Cache + 系统余量
↓
先选统一内存容量
↓
再看内存带宽和目标生成速度
↓
最后计算完整选配价格
大内存 Mac 真正解决的是“能否把更大模型留在单机里”。先算清模型与余量,再谈芯片与价格,才不会为一台看似能跑、实际难用的机器买单。