提示:文中信息均由ChatGPT整理,不保证准确,仅供参考。摘要:
大模型语言评测已经从综合总分推进到语言现象诊断、内部表征和因果干预。本文总结不同方向的证据成熟度,分析近义词、构词、汉语句法语义、构式、动态语境和修辞解释等缺口,并提出由公开锚点、隐藏同构题、动态挑战、人类参照和机制配对组成、以跨版本等值连接尺度的下一代评测体系。
一套题目可以告诉我们模型答对了多少,却不一定说明它为什么答对,也无法保证几年后仍能区分模型。大模型进步速度快,公开Benchmark又可能进入训练语料;同一个“高分”还会混合语言知识、世界知识、提示理解、格式适应和答案记忆。语言能力评测因此需要从一次性的题库建设,走向能够定义能力、验证测量、解释错误并持续更新的研究体系。这不是取消排行榜。排行榜仍适合记录同一协议下的比较结果;需要改变的是结论方式:总分是观察起点,语言现象、数据版本、行为证据和机制证据共同决定它能说明什么。
一、现有语言能力评测完成了什么
语言学驱动的Benchmark已经把“模型会不会语言”分解为一批可以重复研究的问题。
词汇评测区分相似、相关、多义、近义、搭配和构词;
句法与语义评测用可接受度、最小对比、增量概率、自然语言推理和逻辑形式观察结构与意义;
构式、语用和修辞评测进一步加入共同知识、说话者意图、非字面意义和表达效果。
Holmes与稀疏自编码器(Sparse Autoencoder,SAE)研究则开始检查模型内部信息及其因果作用。[1] [2]
表1 现有评测的覆盖状态与可支持结论
| 研究状态 | 代表性方向 | 已经获得的证据 | 当前不能直接推出的结论 |
|---|
| 固定题库部分饱和 | BLiMP总体、经典WSC、专门COGS解析器 | 头部模型能稳定完成大量公开题 | 同类新题、改写题和汉语现象也同样稳定 |
| 诊断仍有区分力 | 汉语最小对比、HANS、SyntaxGym、FraCaS式推理 | 可定位量词、长距离依存、捷径等具体弱项 | 一个总分代表完整句法或语义能力 |
| 资源已有、统一标尺不足 | 近义词、形态生产力、搭配、构式、语用、修辞 | 已找到可行题型,并观察到模型间差异 | 当前头部模型与同协议人类的统一水平 |
| 机制评测处于早期 | Holmes探针、SAE特征与干预 | 多类语言信息可从向量中读出,部分特征可被操控 | 模型形成了与人相同的语言知识或计算机制 |
“部分饱和”描述的是固定题库在特定协议下的区分力,不等于相应语言能力整体完成。例如,经典英语指称题已经记录了从接近随机到接近人类参照的进步;新题、等义改写和汉语零形指称仍可能出现明显下降。反过来,某个挑战集低分也不自动证明模型缺少整项能力:题目不自然、标签争议和提示失配同样会造成错误。
二、真正困难的评测问题在哪里
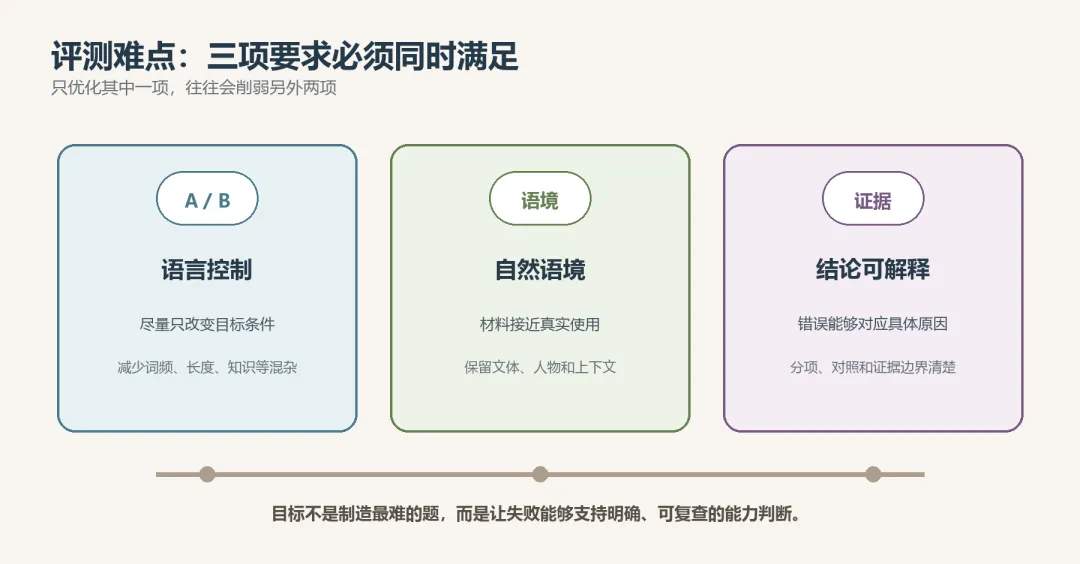
当前缺口主要集中在“规则与语境相互作用”的位置。词义需要搭配、语体和语义韵;句法判断会受到意义合理性和加工难度影响;预设、会话含义和反语又依赖说话者、共同知识及前后文。控制条件太少,错误原因无法定位;控制过度,题目可能失去自然语言的使用条件。
表2 下一阶段值得优先建设的英汉评测方向
| 能力方向 | 现有不足 | 优先加入的诊断条件 |
|---|
| 近义词与搭配 | 资源分散,少有“选择+理由+使用”统一评测 | 程度、褒贬、语体、配价、语义韵和跨领域新语境 |
| 构词生产力 | 识别已有词多,汉语新造词测试少 | 伪词、时间切分新词、词素多义和母语者可接受度 |
| 汉语句法语义 | 量词、体貌、照应和省略的系统覆盖不足 | 辖域读法、长距离“自己”、零形论元、把/被字句 |
| 构式网络 | 多数研究只覆盖少量英语构式 | 构式多义、继承、同形异义、陌生词填槽和篇章功能 |
| 动态语境 | 单句和短对话多,长期状态跟踪少 | 人物换位、私有信息、QUD转换、误解修复和多轮更新 |
| 修辞解释 | 分类多,效果解释和语境生成少 | 识别、定位、释义、表达效果、改写和后续使用 |
评测最难的地方,是证明模型答错确实源于目标能力不足。Bowman和Dahl早在2021年的立场论文中提出,自然语言理解Benchmark应当满足四项要求:题目成绩能够反映模型在目标任务中的稳健表现;标注准确并妥善处理歧义;具备足够的统计功效;揭示并避免助长有害的社会偏差。[3] 这套原则提出于大语言模型广泛应用之前,讨论的却是Benchmark如何成为可信的测量工具,至今仍然适用。他们还明确指出,专门收集当前模型答错的对抗样例,既不是建立有用Benchmark的必要条件,也不是充分条件。题目能难倒模型,只说明它具有短期挑战性;研究者还须排除冷知识、歧义和反常表达等其他成因。
近期的新资源则在扩展语言现象的覆盖面。2026年8月28日,Zhao等发布预印本CNeo-Bench: Diagnosing Large Language Models on Chinese Neologisms(面向汉语新词的大语言模型诊断基准)。该基准收录截至2026年1月采集的4,759个汉语新词,按5个大类、9个小类组织。第一层要求模型生成新词释义;第二层按照新词类别,要求模型还原来源形式,或完成填空、词义辨别、情景匹配和来源识别,从而区分“能解释意义”与“能运用新词形成机制完成任务”两种表现。CNeo-Bench加强了汉语新词及其形成机制的诊断,但没有按新词首次出现时间划分数据,不能直接检验模型能否从较早出现的新词迁移到较晚出现的新词。论文目前仍标为“Work in progress”,并注明数据和代码将在论文接收后发布;因此,它已经提供了新的设计与实验结果,只是尚未成为可独立复现的公开标尺。[7]
三、从静态题库转向可持续评测系统
静态题库的优点是可复现、可追踪历史;缺点是公开后会逐渐暴露,模型也可能学会固定模板。动态评测通过新题生成、时间切分或人机协作持续补题。Dynabench在2021年提出让标注者针对当前模型创造反例,首批覆盖4项自然语言处理任务;2025年的综述则显示,动态方案已成为降低污染风险的重要路线,但不同方案仍缺少统一的质量标准。[4] [5]
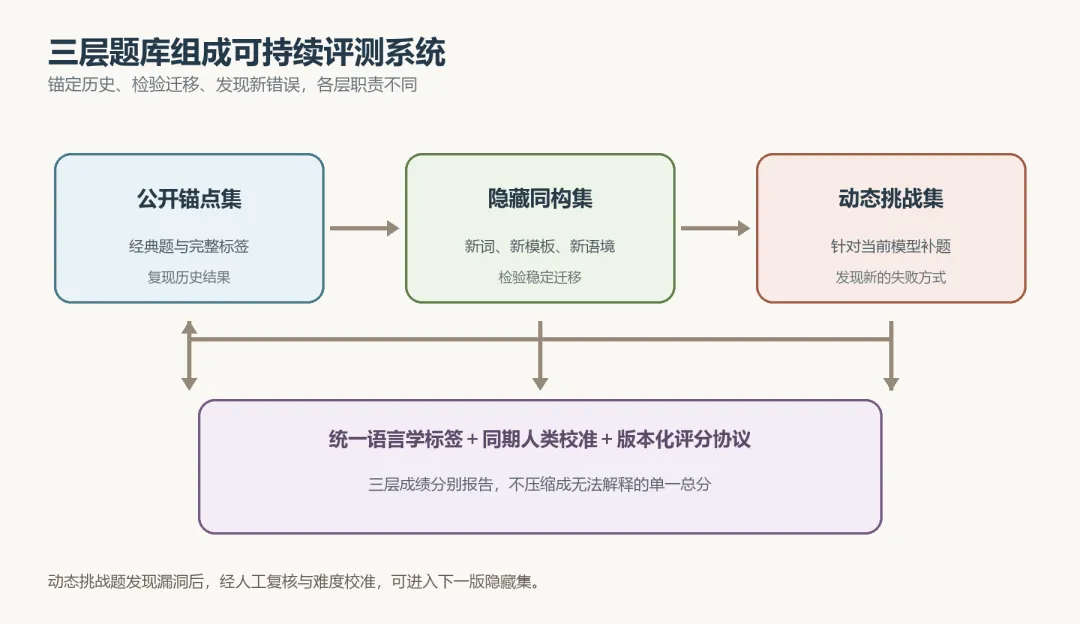
下一代系统不应把旧题一次性丢弃,而应实行三层题库:
公开锚点题记录历史;
隐藏同构题检验同一语言现象;
动态新题检查迁移和新漏洞。
三层共享语言学标签和评分方法,并通过共同锚题或其他等值设计连接尺度。
表3 可持续语言能力评测的数据结构
| 数据层 | 内容 | 更新方式 | 主要功能 |
|---|
| 公开锚点集 | 经典题、完整标签、构建脚本 | 少量修订并保留版本 | 复现历史结果、教学和误差分析 |
| 隐藏同构集 | 相同现象的新词、新模板、新语境 | 定期轮换,测试题与标签均受控保密 | 检查题目记忆和模板迁移 |
| 动态挑战集 | 根据新模型错误生成并由人复核 | 每轮模型后追加 | 发现新型失败,不承担长期尺度锚定 |
| 人类参照集 | 与模型同界面的目标人群作答 | 随版本同步抽样 | 估计题目难度、分歧和清楚限定的人类参照范围 |
| 机制配对集 | 行为题对应的内部读取与干预材料 | 随开放模型和工具更新 | 检查表征相关性与因果作用 |
题库更新之后,原始正确率不再天然可比:新一轮变难,分数下降未必表示模型退步。应保留共同锚题,检查题目区分度和异常项目,并用等值或项目反应理论把各版本连接到同一尺度,同时报告测量误差。人类结果也只能代表明确抽样的人群和协议,不能笼统称为“人类上限”。心理测量框架PATCH表明,题目质量和参照人群的定义会实质改变模型—人类比较的结论。[8]
四、下一代测试题怎样证明“测到了目标能力”
能力证据来自一组相互约束的题,而不是某一道“刁钻题”。下面以汉语近义词、量词辖域和会话含义为例,说明同一现象怎样形成诊断链。
表4 由单题扩展为诊断链的样例
| 目标能力 | 基础题 | 关键对照 | 后续验证 |
|---|
| 近义词选择 | “这项措施___了风险”:降低/减少 | 换成“数量”或“程度”语境,观察候选排序是否相应改变 | 说明搭配和语义差别,再在新领域改写 |
| 量词辖域 | “每位学生读了一本书”有几种解释 | 改变语境,使“同一本”或“各自一本”成为唯一合理读法 | 生成释义,并在后文保持同一指称关系 |
| 会话含义 | 甲问“都交了吗?”乙答“有些交了” | 增加“其实全部都交了”,检查“并非全部”能否取消 | 解释字面意义、通常推论与取消条件 |
| 构式理解 | 把陌生词填入“越X越Y”等构式 | 保持词语不变,改用相似表面形式 | 选择构式义,并在新语境正确生成 |
每组题至少要接受五项验证:
语言学分析是否明确;
母语者是否稳定理解;
最小改写是否只改变目标条件;
模型答案能否跨提示复现;
解释或内部特征是否与行为变化一致。
CheckList在2020年把能力类型与不变性、方向性期待等测试类型组成矩阵,说明批量行为测试比单一留出集准确率更容易发现可操作的错误。[6]
机制证据也必须接受同样审查。探针高分只说明向量包含可供分类器使用的信息;SAE特征与语言现象相关,也可能响应词汇线索。只有在反事实材料、随机对照、多特征联合干预和跨模型复现中,操控相关表征能稳定改变目标答案,才适合提出较强的机制解释。
五、大模型语言能力评测体系的研究议程
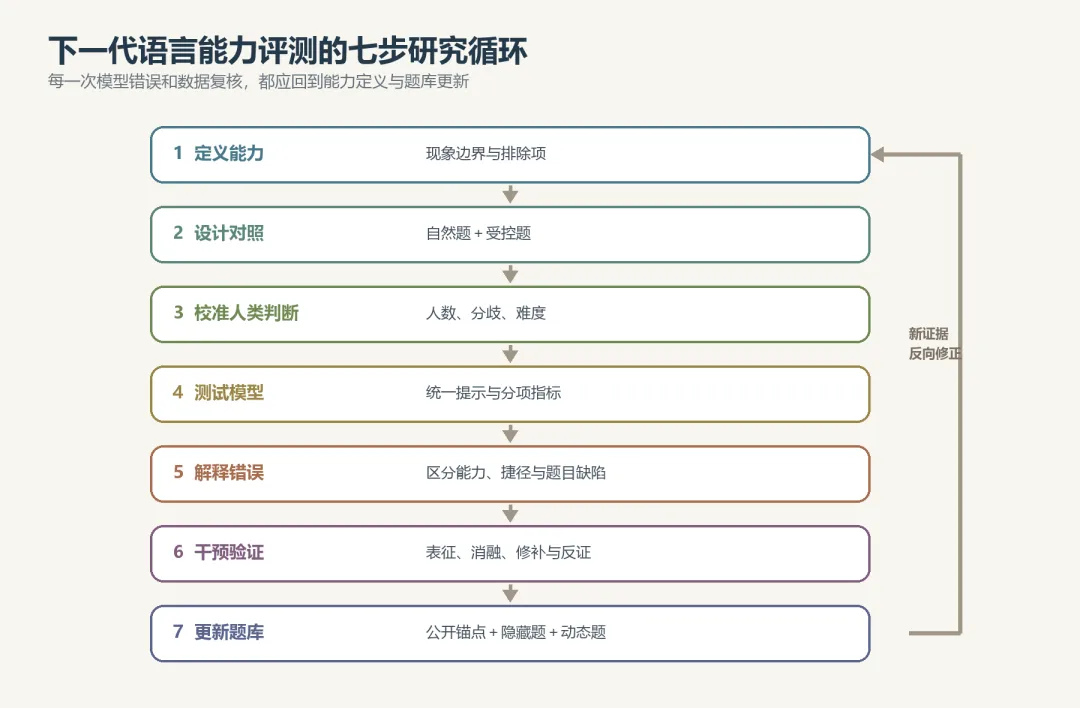
下一代评测应形成一条完整的循环:定义能力—设计对照—校准题目并建立人类参照—测试模型—解释错误—干预验证—更新题库。任何一环都不能由“更大的题量”代替。
表5 判断一项新Benchmark是否达到预期目的
| 验收问题 | 最低证据要求 | 达不到时应限制的结论 |
|---|
| 测量对象清楚吗 | 现象定义、样例、排除项和错误类型公开 | 不能把分数命名为宽泛的“语言能力” |
| 题目真的隔离目标吗 | 最小对照、自然材料、母语者复核 | 不能确认降分来自目标现象 |
| 分数可比较吗 | 模型版本、提示、解码和评分脚本完整;动态版本另需共同锚题、等值方法和测量误差 | 不能跨论文或跨题库版本直接排列模型水平 |
| 高分能迁移吗 | 隐藏新题、等义改写、跨语域和时间切分 | 不能宣布能力达到稳定水平 |
| 内部解释有因果性吗 | 随机对照、干预、修补和反证测试 | 只能说“相关信息可读出” |
| 题库仍有研究价值吗 | 分项仍有区分力,污染与标注持续审计 | 可保留历史价值,不宜继续充当现行能力标尺 |
据此,现有领域既不能概括为“模型的语言能力已经解决”,也不应反复用“尚未解决”抹平进步。较准确的图景是:
常见词义、许多英语局部语法对立、经典指称题和习规隐喻封闭题已经相当成熟;
组合泛化、汉语精细句法语义、跨语境稳定性和开放解释仍有明显差异;
近义词、构词、搭配、构式网络、动态语境与汉语修辞缺少统一的当前标尺;
内部机制研究已经能提出可检验假设,因果证据仍在积累。
语言能力评测研究的目标不是寻找一张永久有效的试卷,而是建立一套能够随模型演进、随语言现象扩展、随证据更新而自我校准的方法。届时,Benchmark的价值将不再只体现在排行榜上,而体现在它能否稳定回答:模型掌握了什么、在什么条件下会失败、内部怎样实现,以及新的证据会怎样修正原有结论。
主要资料来源
Waldis, A., Perlitz, Y., Choshen, L., et al. (2024). Holmes: A Benchmark to Assess the Linguistic Competence of Language Models. TACL, 12, 1616–1647.https://aclanthology.org/2024.tacl-1.88/
Jing, Y., Yao, Z., Guo, H., et al. (2025). LinguaLens: Towards Interpreting Linguistic Mechanisms of Large Language Models via Sparse Auto-Encoder. EMNLP 2025.https://aclanthology.org/2025.emnlp-main.1433/
Bowman, S. R., & Dahl, G. (2021). What Will it Take to Fix Benchmarking in Natural Language Understanding? NAACL 2021.https://aclanthology.org/2021.naacl-main.385/
Kiela, D., Bartolo, M., Nie, Y., et al. (2021). Dynabench: Rethinking Benchmarking in NLP. NAACL 2021.https://aclanthology.org/2021.naacl-main.324/
Chen, S., Chen, Y., Li, Z., et al. (2025). Benchmarking Large Language Models Under Data Contamination: A Survey from Static to Dynamic Evaluation. EMNLP 2025.https://aclanthology.org/2025.emnlp-main.511/
Ribeiro, M. T., Wu, T., Guestrin, C., & Singh, S. (2020). Beyond Accuracy: Behavioral Testing of NLP Models with CheckList. ACL 2020.https://aclanthology.org/2020.acl-main.442/
Zhao, K., Miao, Z., Xie, Z., Cao, S., & Tsuruoka, Y. (2026). CNeo-Bench: Diagnosing Large Language Models on Chinese Neologisms. arXiv preprint.https://arxiv.org/abs/2608.28053
Fang, Q., Oberski, D. L., & Nguyen, D. (2025). PATCH: Psychometrics-AssisTed BenCHmarking of Large Language Models against Human Populations. GEM² 2025.https://aclanthology.org/2025.gem-1.68/
Warstadt, A., Parrish, A., Liu, H., et al. (2020). BLiMP: The Benchmark of Linguistic Minimal Pairs for English. TACL, 8, 377–392.https://aclanthology.org/2020.tacl-1.25/
Wang, A., Pruksachatkun, Y., Nangia, N., et al. (2019). SuperGLUE: A Stickier Benchmark for General-Purpose Language Understanding Systems.https://arxiv.org/abs/1905.00537
本文配套附录包括下一代评测术语与方法说明、英汉语言能力覆盖与研究优先级和34项核心Benchmark元数据目录。可点击文末“阅读原文”查看。