Eval 正在成为 AI 行业里被讨论最多的词之一。Anthropic 在年初专门发了一篇工程博客讲怎么给 Agent 做评测,开头第一句话是:好的评测帮团队更有信心地发布产品;没有评测,团队就会陷入被动循环——只能在生产环境里发现问题,修一个又冒出来一个。Harvey AI 开源了一套法律领域的评测集,1200 多道题、75000 多条专家写的评分标准。小红书 dots 团队发布了 VibeLifeBench 和 VibeSearchBench,指出现有评测集建立在三个和真实世界不符的假设上。
不同公司、不同领域,都在做同一件事:构建自己的评测体系。因为所有人都发现了同一个问题——模型的通用能力在快速提升,但你想知道它在你的场景里到底行不行,公开排行榜帮不了你。
先把两个词理清楚。
Benchmark 是评测集——一套数据集加上评分标准,是那张卷子。MMLU 是 Benchmark,SWE-Bench 是 Benchmark,Harvey 开源的法律评测集也是 Benchmark。
Eval 是评测——用评测集去测、去跑、去判分、去定位弱点的整个过程。它是一套流程,不是一个东西。
Benchmark 是 Eval 的素材。Eval 是拿 Benchmark 做诊断的动作。光有卷子不叫评测——出题、考试、阅卷这整套流程跑完,才算做了一次 Eval。
大多数团队对评测的做法是:找一个公开评测集,让模型跑一遍,看个正确率。这测的是通用能力,不是你自己场景里的表现。你的模型在你的业务里弱在哪,公开评测集不会告诉你。
一套能驱动提升的 Eval,需要两样东西:一套从你自己场景里长出来的评测集,和一条跑得通的评测流程。
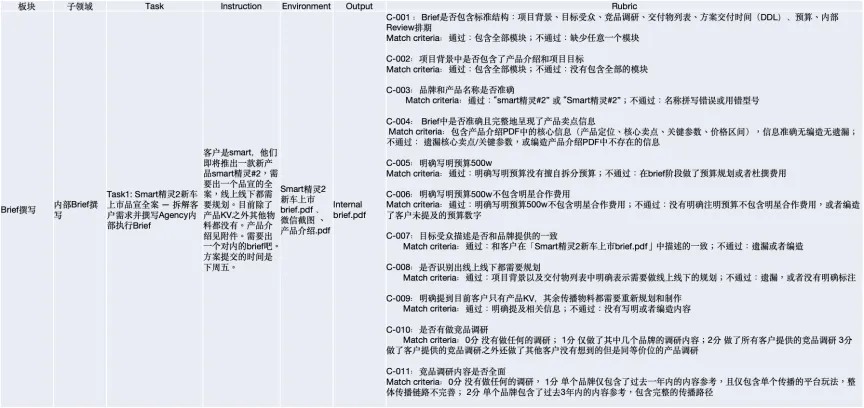
评测集的核心不是题目数量,而是 Rubric 的质量。Rubric 是评分标准——每道题的每一分扣在哪、加在哪,写清楚。行业数据印证了这一点:LLM-as-a-Judge(让模型给模型打分)在有 Rubric 时,与人类判分的一致性达到 0.85-0.92;没有 Rubric,掉到 0.60-0.75。Rubric 比评分模型更重要。
而好的 Rubric 不是坐在办公室里想出来的。它来自真实的业务验收——客户真的会因为哪些问题退回交付物,业务方真的会逐条检查哪些细节,这些标准被提炼成一条条可判定的规则。一道题不是配一条"是否正确",而是拆成十几条甚至几十条独立的判定标准,每条对应一个具体的业务要求。
这种颗粒度的 Rubric 写不出来,除非你在这个场景里真的交付过。
我们做了一件不太一样的事:用 AI 专家来做 AI 的评测。
我们搭建了三个独立的 AI 专家角色,组成一条完整的评测流水线——从构建评测集,到执行评测,到判分出报告,全链路覆盖。
评测数据专家——构建评测集。 从真实业务任务中反推题目,从交付验收标准中提炼 Rubric,从历次评测中发现的失败模式中补充难例。它也可以针对一个已有的 AI 员工,读取其完整配置后定向出题——基于真实能力范围来测,不出超纲题。
数据合成专家——执行评测。 拉取评测集,驱动被测模型或 AI 员工逐题完成任务,记录完整的过程轨迹。不只看最终结果对不对,还看中间每一步——在哪个环节出了问题,是理解任务时就偏了,还是中间调错了工具,还是最后漏掉了关键信息。
评测判分专家——判分出报告。 对照 Rubric 逐条判分:能用代码校验的条目自动判定,涉及主观质量的条目由模型依据 Rubric 打分。最终产出一份诊断报告——不是一个总分,而是精确到"哪个维度弱、弱在哪道题、弱的具体表现是什么"。
三个角色分开做,是因为出题的不能跑题,跑题的不能阅卷。自己考自己不叫评测。诊断报告中发现的失败模式会回流成评测集的新题目,评测集持续进化。
这三个专家角色不绑定特定行业。它们是一套方法,不是一组数据。
背后的逻辑是这样的:FancyTech 沉淀的不是客户数据,而是一套经过真实生产验证、可以持续规模化生产企业级数据的方法与系统。
传统的评测数据构建路径是:模型 → 生成数据。用模型自己编造测试样例。
我们的路径是:真实业务 → 验证 AI 员工 → 模拟企业场景 → 生成数据。先在真实业务中验证 AI 员工的能力边界,再把这些经验转化成可控的场景模拟,最后规模化地生产评测数据。
这条链路里有几个关键环节:场景参数生成器可以配置不同行业的任务模板和环境变量;用户 Agent 按场景的业务方发起需求;执行 Agent 调用 Skill 和工具完成任务;规则函数校验层对产出数据做标签、去重、逐级拆分和标记追溯;环境状态引擎注入数据变化和工具失败等真实世界的不确定性。
这套系统是领域无关的。换一个行业,换一套场景参数,换一批经过验证的 AI 员工——同样的三个专家、同样的流水线,就能在新领域里构建评测集、执行评测、产出诊断报告。方法可复用,系统可扩展。
我们选择从市场营销领域开始,因为这是我们积累最深的领域。过去几年持续服务真实的企业营销场景,已经形成了 300 多个经过业务验证的 AI 员工——大量真实的任务、真实的交付标准、真实的失败案例,都可以提炼成评测集。
我们正在把这些经验提炼成 Marketing Agent Benchmark。
目前覆盖 10 个营销子领域,持续更新中。营销是第一站,不是唯一一站。
点击阅读原文了解更多 >