端侧模型测评实战
从“跑通”到“选对”,我总结了这套三维决策法
图 1 端侧模型选型:速度、内存、精度三维决策法
速度、内存、精度——端侧模型选型的三条腿,缺一不可。
过去两周,我在摩尔线程 AIBook 上折腾 Spark-X2.5 系列模型,目标是用它搭一个海洋设备运维的离线诊断 Agent。
从最初的“能跑就行”,到后来系统性地测试 CPU vs MUSA、对比 1.7B vs 4B vs 9B、量化 Q8_0 vs Q4_K_M,再到修复 1.7B 的 chat 端点、测试 KV cache 量化、拆解 RAG 的延迟构成——这段经历让我意识到:端侧模型测评的核心,不是跑分,而是回答一个很实际的问题——“在我的设备上,用哪个配置,能跑出最好的效果?”
这篇文章,我把踩过的坑和总结的方法论完整记录下来。专业术语我会尽量用大白话解释,希望能给做端侧部署的朋友一些参考。
一、先搞懂几个基本概念
在开始之前,有必要先解释几个贯穿全文的术语。
什么是“端侧模型”? 简单说,就是直接跑在你设备上的 AI 模型,不需要联网请求云端服务器。好处是低延迟、隐私安全、断网也能用。代价是设备算力和内存有限,不能像云端那样随便堆大模型。
什么是“量化”? 模型本质是一堆数字(权重)。原始训练出来的权重通常是 16 位浮点数(FP16/BF16),占空间大。量化就是把这些数字用更少的位数表示,比如 8 位整数(Q8_0)、4 位整数(Q4_K_M)。
打个比方:原始权重像高清照片,量化像压缩成 JPEG。文件小了、跑得快了,但画质可能有损失。Q4_K_M 里的“K”代表分组量化,“M”代表混合精度——意思是不同层用不同的压缩策略,对输出质量影响大的层(如输出层)保留更高精度。
什么是 `ngl`?`ngl` 是 number of GPU layers 的缩写,意思是“把模型的多少层放到 GPU 上跑”。大语言模型是由很多层堆叠而成的。`-ngl 0` 表示全部在 CPU 上跑(慢但兼容性好),`-ngl 99` 表示全部卸载到 GPU 上(快但依赖后端兼容性)。你可以把它理解成“把多少活儿分给 GPU 干”。
二、测评第一步:先搞清楚“版本能不能对上”
我拿到的任务是:在 AIBook 上运行 Spark-X2.5-4B,开发海洋运维诊断 Agent。
第一步很顺利。从官方仓库下载了 Q8_0 量化版本(4.37GB),用官方 fork 的 `llama.cpp`(一个主流的端侧推理框架)编译了 MUSA 后端(摩尔线程 GPU 的计算平台)。编译过程没有报错。
但加载模型时,问题出现了。 用摩尔线程官方安装的 llama-server(版本 0.0.9252)加载 Spark 模型,直接报错:
unknown model architecture: 'spark2_5'
排查后发现,这是一个典型的版本错位问题:
• Spark2_5 架构在 2026年9月6日 才合并进 llama.cpp 上游主仓库
• 摩尔线程 MUSA 后端 0.0.9252 发布于 2026年8月20日
• 后端发布比架构合并早了 17 天
这意味着,官方 MUSA 后端不可能包含 Spark 架构支持。必须用自定义编译的 llama.cpp fork,不能用官方安装包。
测评启示:端侧模型测评的第一步,永远是确认“模型架构”和“推理后端”的版本兼容性。跑分之前,先看能不能加载。
三、CPU 后端:慢,但能告诉你“模型是不是好的”
既然 MUSA 后端跑不通,我决定先用 CPU 后端验证模型本身。
$ ./llama-cli -m Spark-X2.5-4B-Q8_0.gguf -ngl 0 -t 16 -c 4096 -p "你好" -n 32
结果:模型成功加载,正常推理。 生成速度约 0.6 tokens/s(每秒生成 0.6 个词),Prompt 处理约 0.8 tokens/s。
这个速度确实很慢——256 个 token 需要约 7 分钟。但这次测试的价值不在于速度,而在于定位问题边界:
• Spark 模型本身完好,架构支持正常
• CPU 后端可以稳定运行,适合开发阶段的逻辑验证
• 问题 100% 出在 MUSA 后端,而非模型或架构
测评启示:CPU 后端是端侧测评的“基准线”。它慢,但它能帮你排除模型本身的问题。当你怀疑是硬件或后端的问题时,先用 CPU 跑一遍,这是最有效的二分法。
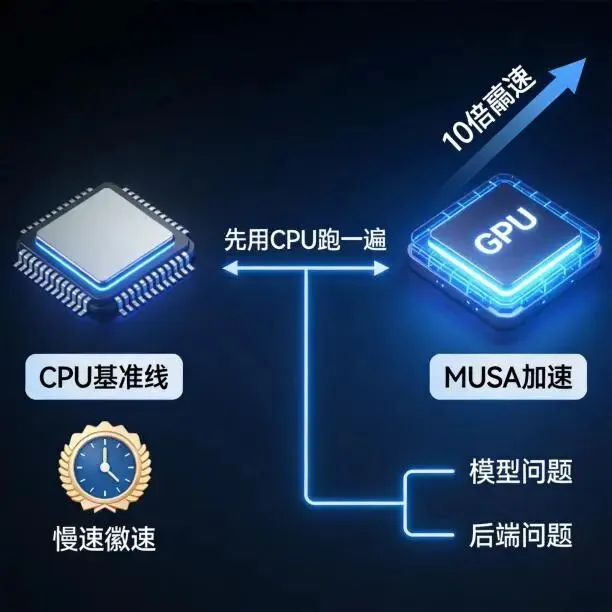
图 2 CPU 是稳定基准,MUSA 加速——先用 CPU 排除模型问题
四、MUSA 后端:从崩溃到跑通,再到新问题
确认模型没问题后,我开始攻克 MUSA 后端。
坑 1:库版本不兼容导致崩溃
最初用 `llama-cli` 加载模型后,在退出阶段核心转储崩溃。用 GDB 抓取崩溃栈,根因是自定义编译的库和系统安装的库版本不兼容。
修复方法:用绝对路径强制加载自定义库:
export LD_LIBRARY_PATH=/path/to/custom/build/bin
坑 2:llama-cli 崩溃,但 llama-server 能跑
修复库路径后,`llama-cli` 仍然在退出阶段崩溃。但一个关键发现是:`llama-server` 不触发这条路径。用 MUSA 后端启动 server 后,模型加载成功,推理正常。
性能实测结果:
指标 | CPU 后端 | MUSA 后端 | 提升倍数 |
生成速度 | 0.38 t/s | 4.10 t/s | 10.8× |
Prompt 处理 | 0.58 t/s | 15.81 t/s | 27× |
100 tokens 耗时 | ~260 秒 | 24 秒 | 10.8× |
测评启示:同一个模型,同一个后端,`llama-cli` 和 `llama-server` 的稳定性可能完全不同。测评时不要把 CLI 的崩溃等同于模型不可用,要尝试不同的入口。
坑 3:思考模式导致输出为空
MUSA 后端跑通后,新的问题出现了:模型生成 200 tokens,但 `message.content` 始终为 `null`。
原因是 Spark 模型有思考(reasoning)模式,会先输出思考内容再输出正式回答。当 `max_tokens`(最大生成 token 数)不够时,正式回答为空。正确的关闭方式是在 API 请求体中传入参数,而不是在启动时加 `--reasoning off`:
{"model": "Spark-X2.5-4B",
"messages":[{"role": "user", "content": "主机故障"}],
"chat_template_kwargs":{"enable_thinking": false}
}
测评启示:端侧模型的行为控制参数,可能在服务端启动参数和请求体参数之间分散。测评时需要系统性地测试两种传递方式,不能想当然。
坑 4:musacode 进程持续销毁 GPU 内存上下文
最棘手的问题出现了:MUSA 后端推理约 10 秒后崩溃,进程消失。查看 dmesg(系统内核日志)后发现,VS Code 的 MUSA 扩展(musacode)持续运行,每约 3 秒销毁一次 MUSA GPU 应用内存上下文。
解决方案:关闭 VS Code 的 MUSA 插件,在独立终端启动 MUSA 后端。
测评启示:端侧测评中,环境干扰因素是最大的变量之一。GPU 资源竞争、后台进程占用、驱动版本差异,都可能让测评结果完全失真。测评前需要确认环境“干净”。
五、系统化测评:用数据说话
踩完坑之后,我开始用 `llama-bench`(llama.cpp 自带的基准测试工具)做系统化基准测试。这是整个测评中最有价值的部分——把“跑通了”变成“测明白了”。
5.1 六维性能数据
维度 | CPU 后端 | MUSA 后端 | 提升 |
生成速度 tg128 (t/s) | 0.65 | 3.77 | 5.8× |
Prompt pp512 (t/s) | 209.95* | 251.47 | 1.2× |
100 tokens 耗时 | ~154s | ~26.5s | 5.8× |
峰值内存 (MiB) | Host 358 | MUSA 4557 + Host 358 | — |
模型加载时间 (s) | — | ~4.7 | — |
TTFT(首 Token,秒) | — | 1.44-1.74 | — |
\* `-ngl 0` 下 prompt 仍走 MUSA,只有生成走 CPU
TTFT 是 Time To First Token 的缩写,意思是“从提问到看到第一个字的时间”。它直接决定用户觉得“跟不跟手”。
5.2 最大优化发现:`-b 1024`
`-b` 是 batch size(批处理大小),指一次处理多少个 token。
n_batch | tg256 (t/s) | 相对默认 2048 |
512 | 3.71 | +3% |
1024 | 4.87 | +35% |
2048 (默认) | 3.59 | 基线 |
4096 | 4.45 | +24% |
`-b 1024` 是生成速度最优解,比默认 2048 快 35%。这个发现直接让生产配置的生成速度从 3.59 提升到 4.87 t/s。
5.3 参数量消融:Spark 1.7B vs 4B
“消融” 在这里的意思是:控制其他变量不变,只改变一个因素(如参数量),观察性能变化。
指标 | Spark 1.7B | Spark 4B | 倍数 |
生成速度 tg128 (t/s) | 8.37 | 3.77 | 2.22× |
Prompt pp512 (t/s) | 568.45 | 251.47 | 2.26× |
E2E 128 tok (s) | 11.93 | 27.80 | 2.33× |
总内存 (MiB) | 2189 | 4915 | 0.45× |
结论:参数量减 58%,速度提 2.2×,内存省 55%。对 RAG(检索增强生成,即先查知识库再让模型总结)任务,1.7B 性价比极高。
5.4 架构消融:Spark 4B vs Qwen 9B
这里有一个重要的纠错过程。初版报告用 `llama.cpp-spark` 测 Qwen 9B,崩溃后误判为“不兼容”。后来发现是引擎与架构不匹配:
引擎 | Spark 4B | Qwen 9B |
llama.cpp-spark(自定义) | ✅ | 无 SSM 内核 |
llama.cpp-musa 0.0.9252(官方) | 无法加载 | ✅全量 offload |
SSM 是 State Space Model(状态空间模型)的缩写,是一种与标准 Transformer 不同的架构,生成时计算复杂度更低。
修正后用各自最优引擎对比:
指标 | Spark 4B (Q8_0) | Qwen 9B (Q4_K) | Qwen 优势 |
生成速度 tg128 | 3.77 t/s | 6.75 t/s | 1.79× |
Prompt pp512 | 251.47 t/s | 134.27 t/s | 0.53× |
TTFT | 1.44s | 0.94s | 1.53× |
结论:Qwen 9B 生成快 1.79×(SSM 架构生成复杂度 O(1)),Spark 4B prompt 处理快 1.89×(Transformer+SWA 的 batch matmul 更高效)。架构差异决定了端侧性能特征。
六、Q4_K_M 量化消融:速度、内存、精度三维决策
量化直接决定模型能不能塞进设备内存。我测试了 Q4_K_M 对性能的影响,结果有反直觉的发现。
6.1 完整消融矩阵
配置 | 文件 (GiB) | MUSA tg128 | CPU tg128 | 内存 (GB) | 精度(预期) |
1.7B Q8_0 | 1.69 | 8.37 t/s | ~1.2 | 2.1 | ★★★★ |
1.7B Q4_K_M | 1.03 | 8.17 t/s | 1.79 | 1.5 | ★★★★ |
4B Q8_0 | 4.07 | 3.77 t/s | 0.65 | 4.9 | ★★★★★ |
4B Q4_K_M | 2.42 | 3.31 t/s | 0.94 | 2.8 | ★★★★ |
6.2 反直觉发现:量化在 GPU 上反而更慢
Q4_K_M 在 MUSA 后端生成速度比 Q8_0 慢 12%(3.31 vs 3.77 t/s),这与传统预期相反。
原因:MUSA GPU 的 dequantize(反量化,把压缩的权重还原成可计算的形式)kernel 对 Q4_K_M 不如 Q8_0 高效。Q8_0 的 dequantize 是简单除法,Q4_K_M 需要更复杂的查表和缩放。
但 CPU 后端下 Q4_K_M 比 Q8_0 快 50-67%(0.94 vs 0.63 t/s),因为 CPU 内存带宽是瓶颈,Q4_K_M 内存占用少 40%,且 CPU 有 SIMD 优化的 Q4_K_M kernel。
结论:MUSA 用 Q8_0,CPU 用 Q4_K_M——不同硬件后端对量化的偏好完全不同。
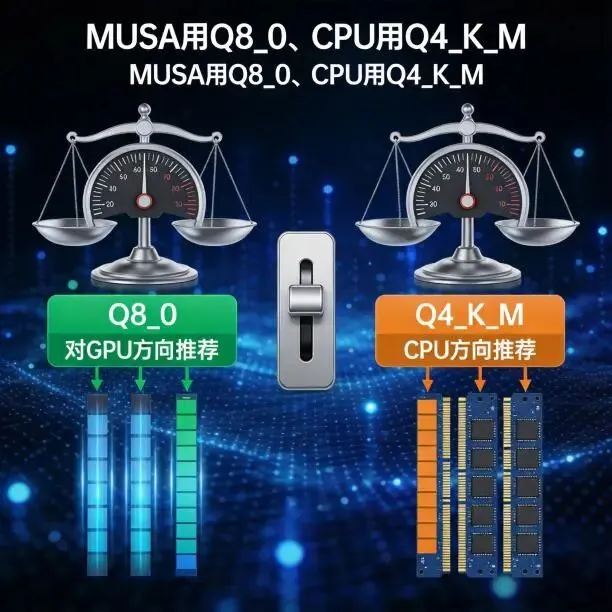
图 3 量化消融:MUSA 用 Q8_0、CPU 用 Q4_K_M
6.3 精度影响分析
Q4_K_M 对运维诊断任务的影响很小,因为这是“知识检索 + 复述”任务,知识在 RAG 里,模型做格式化总结,对量化精度不敏感。
任务特征 | 对量化敏感度 | 运维诊断表现 |
知识检索(RAG) | 低 | ✅ 关键词匹配为主,量化影响小 |
术语生成 | 低 | ✅ 高频专业术语,量化后仍可正确生成 |
因果推理 | 中 | 多步推理可能受影响 |
数值计算 | 高 | 但运维诊断很少涉及精确数值 |
6.4 二次量化无精度损失(验证完成)
之前担心“从 Q8_0 requantize 到 Q4_K_M 会有累积误差”。我从 HuggingFace 下载原始 BF16 权重,直接量化 Q4_K_M,与从 Q8_0 requantize 的结果做 tensor 级别对比——226 个 tensor 完全相同。
原因:Q8_0 的精度(~1/256)远超 Q4_K_M 的量化粒度(~1/16),dequant 误差不足以改变 4-bit 量化结果。
结论:现有 Q4_K_M 模型已是最优,无需从 F16 重新量化。
6.5 选型决策树
是否部署到 RK3576(4GB RAM)?
├─ 是 → 1.7B Q4_K_M(唯一选择,1.5GB)
└─ 否 → 是否 AIBook 应用?
├─ 是 → 4B Q8_0(精度优先)
└─ 否 → 是否长时运行?
├─是 → 1.7B Q8_0(速度+精度均衡)
└─否 → 1.7B Q4_K_M(内存最优)
七、系统集成测试:KV cache、RAG 与端点修复
7.1 KV cache 量化:MUSA 上不可用
KV cache 是模型推理时缓存的键值对,随上下文长度线性增长。量化它可以省内存,但测试发现:
后端 | KV 量化 | pp512 减速 | tg128 减速 | 结论 |
MUSA | q8_0 | -90.8% | -34.1% | 不可用 |
MUSA | q4_0 | -91.3% | -34.5% | 不可用 |
CPU | q8_0 | -35.4% | -5.6% | 有损失 |
MUSA 后端缺乏优化的量化 KV cache kernel,速度代价远大于内存收益。AIBook 有 31GB 内存,KV cache 即使 f16 也只占 752 MB,无需量化。
Flash Attention 在 MUSA 上反而减速 30%,说明 MUSA 后端的 FA kernel 实现不如标准 attention 高效。
7.2 RAG 性能:检索极快,TTFT 主瓶颈在 LLM
组件 | 耗时 | 占 TTFT 比例 | 优化空间 |
嵌入+检索 | 40 ms | 16% | 已很快,无需优化 |
Prompt processing | 7.5 ms | 3% | 已很快 |
First token | 202 ms | 81% | 主要瓶颈 |
top_k=3 是最优配置(TTFT 250ms),top_k=10 时 TTFT 增长 409%。RAG 检索本身极快(~40ms),几乎不增加延迟。
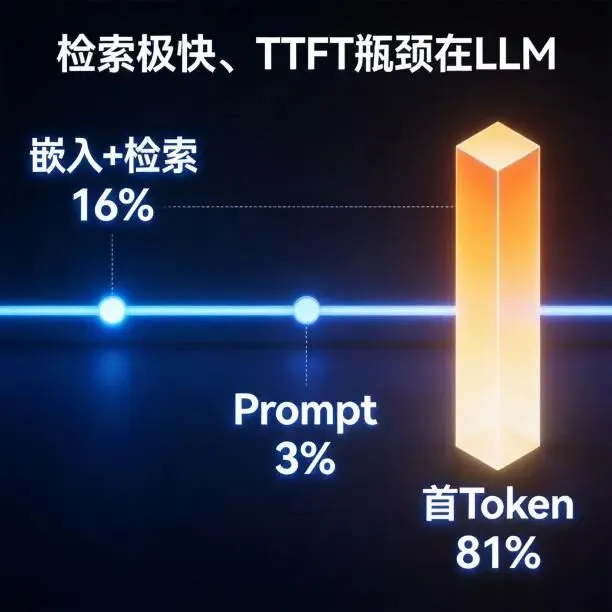
图 4 RAG 延迟构成:检索极快,TTFT 主瓶颈在首 Token
7.3 1.7B chat 端点挂起修复
1.7B 模型的 `/v1/chat/completions` 端点会在 generation 阶段挂起(slot 卡死,非崩溃)。修复方案:在应用层检测超时后自动回退到 `/completion` 端点,并手动拼接 Spark chat template。
def chat(self, messages, temperature, max_tokens, stream):
try:return self._chat_completions(...)# /v1/chat/completions
except
requests.exceptions.ReadTimeout:# 1.7B 挂起 → 回退到 /completion
return self._raw_completion(...)# /completion + 手动模板
模板拼接已验证与 GGUF Jinja 模板输出格式一致。4B 模型不受影响。
八、端侧模型测评的方法论总结
经过这两周的折腾,我把端侧模型测评的要点总结为四个维度:
1. 兼容性测评:先看能不能加载
• 模型架构与推理后端的版本匹配
• 库版本一致性(避免 ABI 不兼容)
• 量化格式支持(官方推荐 Q4_K,我用的 Q8_0)
• 引擎与架构的匹配(Spark 用自定义引擎,Qwen 用官方引擎)
2. 性能测评:量化“跑得快不快”
• 生成速度(tokens/s)
• Prompt 处理速度
• 首 Token 延迟(TTFT)
• 长推理稳定性
• 内存峰值占用
3. 能力测评:聚焦真实场景
• 指令遵循与格式稳定性
• 多轮工具调用(Agent 能力)
• 领域知识准确性(用海洋运维测试集)
• 长上下文有效性
4. 工程适配性
• 不同后端的稳定性差异
• 环境干扰因素(musacode 案例)
• 参数传递方式(启动参数 vs 请求体参数)
• 系统集成问题(KV cache 量化、RAG 延迟、端点挂起)
九、给端侧开发者的三个建议
第一,CPU 后端是你的朋友。 它慢,但它稳定、可复现、能帮你排除模型本身的问题。当你怀疑是硬件或后端的问题时,先用 CPU 跑一遍,这是最有效的二分法。
第二,不要迷信“官方支持”。 官方 MUSA 后端声称支持多种模型,但版本错位导致它不支持 Spark。端侧部署中,“官方文档说支持”和“实际能跑”之间,可能隔着几个月的版本差。不同硬件后端对量化的偏好也可能完全相反。
第三,环境干净比参数调优更重要。 我花了大量时间排查崩溃,最终发现是 VS Code 插件在后台销毁 GPU 内存上下文。端侧测评中,先确保环境干净,再谈性能优化。
十、当前成果与下一步
目前,我已经完成了:
• ✅ Spark 4B 系统化基准测试(6 维数据)
• ✅ Spark 4B vs Qwen 9B 架构对比(含错误修正)
• ✅ 三模型对比(1.7B/4B/9B)
• ✅ Q4_K_M 量化消融(速度/内存/精度三维)
• ✅ 从 F16 直接量化验证(确认 requantize 无精度损失)
• ✅ KV cache 量化测试(MUSA 上不可用)
• ✅ 端到端 RAG 性能测试(top_k=3 最优)
• ✅ 1.7B chat 端点修复(应用层回退方案)
• ✅ RK3576 部署分析
下一步计划:
•用运维诊断测试集完成实际精度评测
•端到端 RAG 诊断流程打磨
端侧模型测评,测的从来不只是模型本身。它测的是你对硬件、软件、环境的综合理解。
而这,恰恰是端侧 AI 最有意思的地方。
