TypeSafe的Jev模型是面向软件中的自动化判断:输入一段状态和预先定义的问题,输出可被程序直接使用的决策。[1]
LangChain 用它做了一项 Agent 评测对比实验。重点不在天气查询本身,而在一个 Agent 跑完任务后,系统怎样判断结果是否合格。
Agent 完成后,谁来判断结果
一个 Agent 给出答案、调用工具或处理一条工作流后,系统仍要决定:这次是否通过,是否重试,是否需要人工复核。
代码规则适合检查确定条件,例如字段是否齐全、工具是否被调用。但开放式任务很难把所有正确路径提前写成规则。
LLM judge 则把用户问题、执行轨迹和最终答案交给生成式模型,再由它给出分数或通过结论。它能处理开放式内容,但相同的执行结果重复评测时,结论可能变化;高频评测也会受到延迟和成本限制。
Jev 的输出是结构化判断
Jev 与 LLM judge 处在同一个 Agent 评测层,但输出路径不同。它接收文本、JSON 对象或文本数组形式的状态,返回有类型的答案和概率,而不是一段生成式评语;当前仅支持文本输入。[2]
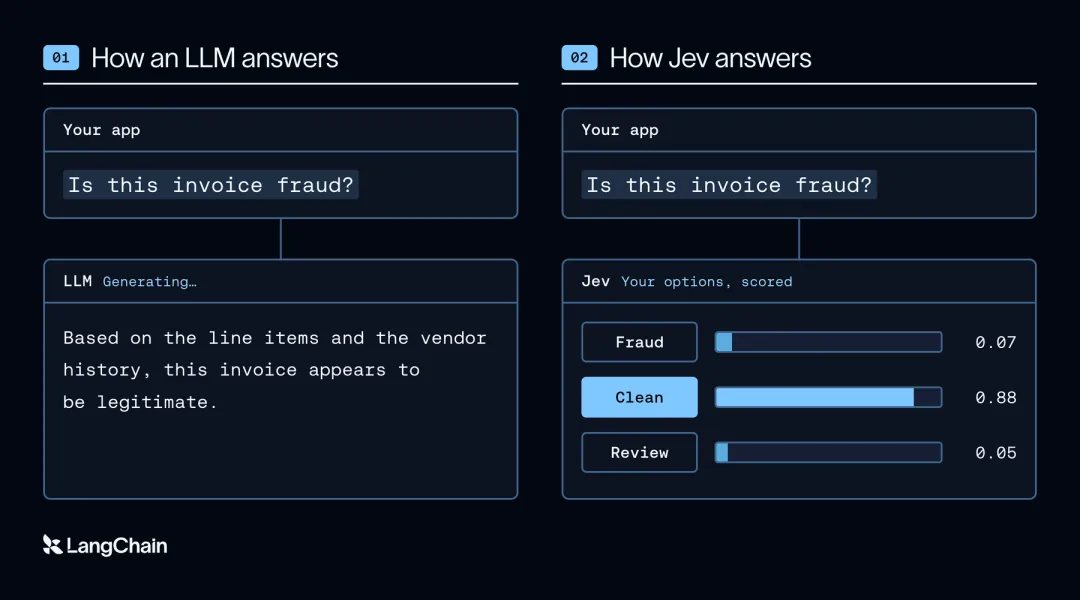
在 Agent 工程里,它可把评测结果写成类似这样的结构:
quality:连续质量分数does_pass:是否通过probability:判断概率
因此,Jev 更接近一个可放进程序分支的评测节点。它不负责解释为什么失败,也不负责生成修复方案。
LangChain 实际测了什么
LangChain 用一个天气查询 Agent 作为被评测对象。测试集只有 5 条天气请求;每条请求的完整 Agent 输出先被固定保存,再由人工按同一 rubric 标注。
随后,Jev、GPT-5.6 Luna、GPT-5.6 Terra 和 Claude Sonnet 4.6 分别评测这 5 条固定输出。每个案例重复 100 次,比较二元 does_pass 判断与连续 quality 分数的准确性、重复性、延迟和成本。[3]
这项实验的结果
在二元通过判断上,Jev 与人工标注一致 500 次;Terra 为 99.8%,Luna 为 96.4%,Claude 为 80.0%。
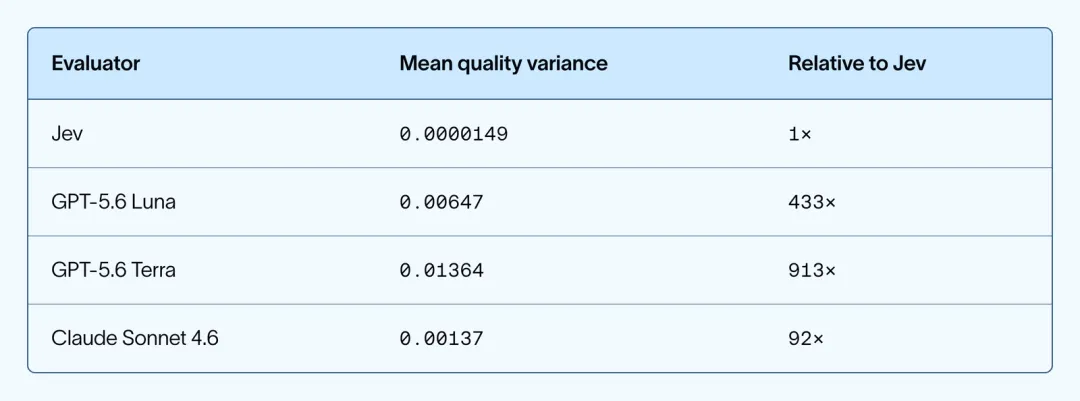
质量分数的平均方差方面,LangChain 报告 Jev 为 0.0000149;Luna、Terra、Claude 的观察值分别高 433 倍、913 倍和 92 倍。
这不等于“低方差天然更正确”。它只说明在这组固定输入上,Jev 更容易给出一致的判断。LangChain 也明确表示,实验不能证明低方差由模型训练方式直接造成。
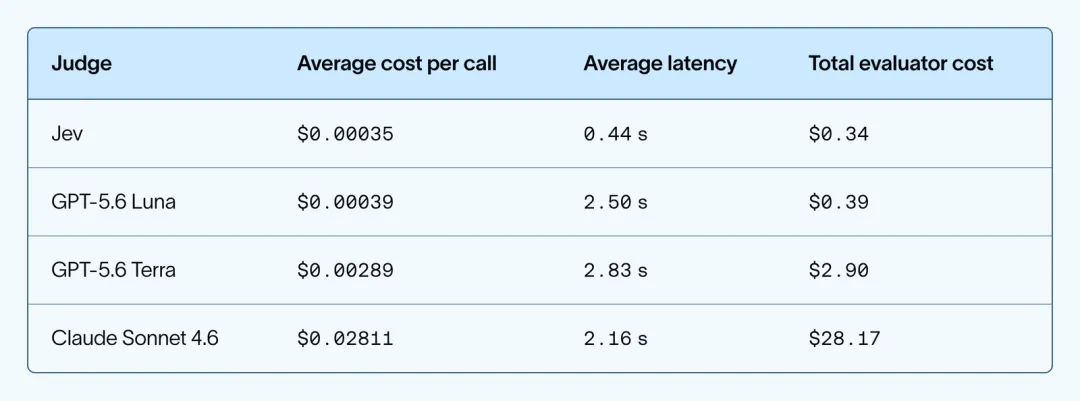
本次实验中,Jev 平均每次评测为 0.44 秒、$0.00035。这个数值只属于 LangChain 的 5 条天气请求和这套评测配置,不能直接推到其它 Agent、其它任务或生产环境。
放在 Agent 的判断节点
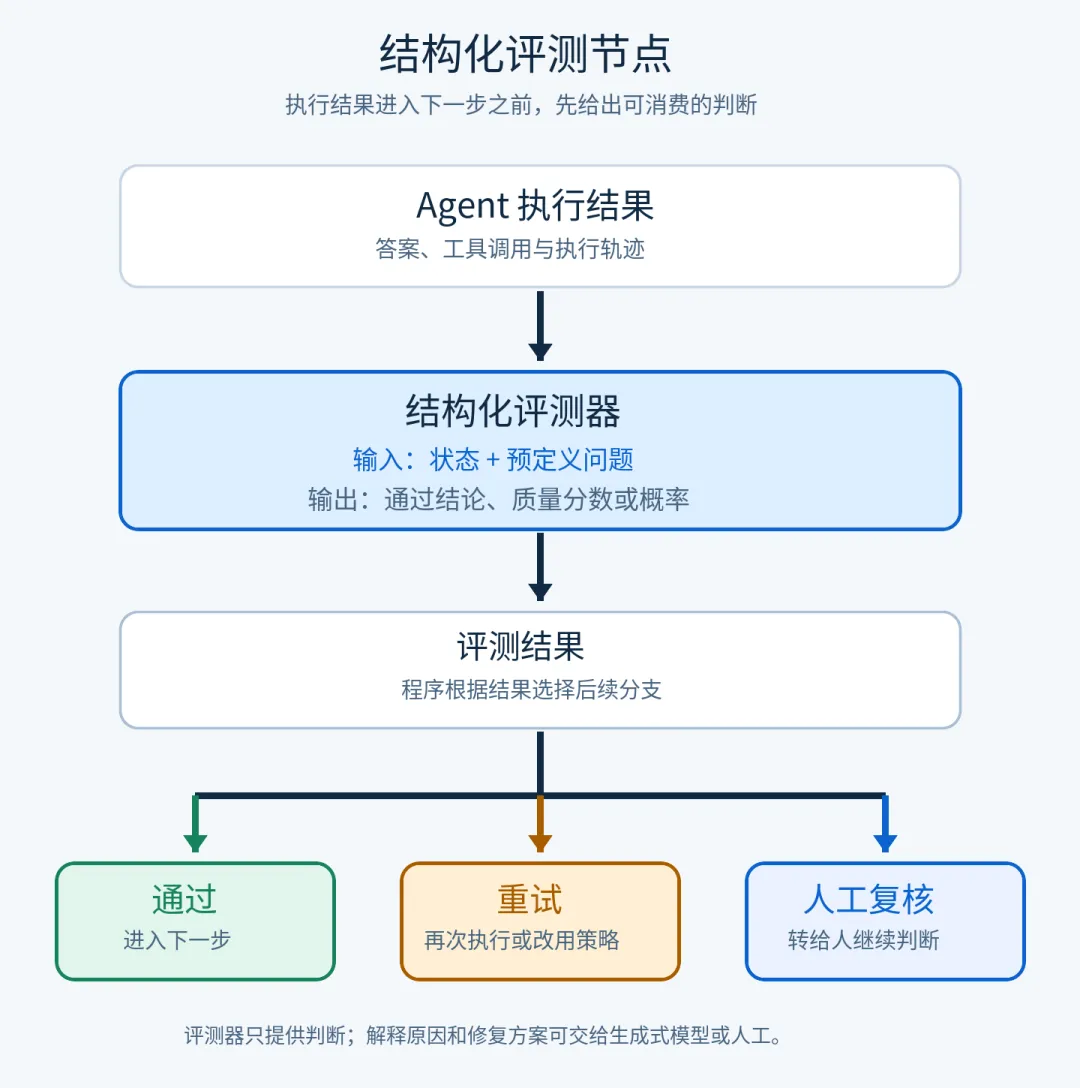
当问题可以预先定义,且输出需要被程序直接消费时,结构化评测器可以放在这些节点:
执行结果是否通过→ 是否需要重试→ 是否转人工复核→ 是否进入下一条工作流
需要解释原因、处理复杂歧义或生成修复建议时,LLM judge 和人工复核仍然有价值。
当 Agent 评测可以明确写成结构化判断时,评测器本身未必需要先生成一段文字。
参考资料
[1] TypeSafe AI:Introducing System One Models & Jevhttps://typesafe.ai/blog/introducing-system-one-models-and-jev
[2] TypeSafe AI:System Onehttps://docs.typesafe.ai/concepts/system-one
[3] LangChain:Can Jev Be a Better Agent Evaluator?https://www.langchain.com/blog/jev-agent-evals-langsmith
