序幕:一夜蒸发5888亿美元
2025年1月27日,星期一。
美股开盘,AI芯片巨头英伟达的股价像断线的风筝一样坠落。盘中最大跌幅超过17%,一天之内,这家全球市值最高的芯片公司蒸发了约5890亿美元——这是美股历史上单只股票单日市值损失的最高纪录。纳斯达克指数当天跌了3.1%,整个美国科技板块和AI相关股票合计蒸发了接近1万亿美元。
发生了什么?没有财报暴雷,没有监管利空,没有战争。
引爆这一切的,是一家很多人一个月前根本没听过的中国公司,和一个免费、开源的AI模型。
这家公司叫DeepSeek,中文名"深度求索"。
它的模型训练成本只有557.6万美元——大约相当于英伟达被蒸发市值的十万分之一。换句话说,硅谷花了几百亿美元建立的"算力护城河",被一群杭州年轻人用不到600万美元戳了一个洞。
美国风险投资家马克·安德森在社交媒体上写道:这是AI的"斯普特尼克时刻"。
一条从深海浮起的蓝鲸,让全世界最贵重的芯片帝国,感受到了第一次真正意义上的震动。
它从哪里来?它凭什么?它要去哪里?
这篇文章,用4个章节,讲清楚这条"鲸鱼"的完整故事。
一条蓝鲸从深海浮起,世界的航向就此改变。
01 量化天才的降维打击:从湛江到杭州
故事要从一个广东少年说起。
1985年,梁文锋出生在广东湛江吴川市覃巴镇的一个普通家庭。他从小成绩优异,是当地有名的高考状元,考入了浙江大学的电子与信息工程系,一路读到硕士。
2008年,全球金融危机爆发那年,梁文锋开始带着团队用机器学习技术探索量化交易。2013年,他与浙大同学徐进创立了杭州雅克比投资;2015年,两人又创办了幻方量化——这家公司后来成为中国最大的量化私募之一。
在外界看来,梁文锋身上有一种罕见的"双面性":一半是精于计算的量化天才,一半是痴迷技术的工程师。
2016年10月,幻方推出了第一个AI模型,第一份由深度学习生成的交易仓位正式上线;到2017年底,幻方几乎所有量化策略都改用AI模型计算。2019年和2021年,幻方先后投入逾10亿元,自建了"萤火一号""萤火二号"两代深度学习训练平台——在那个中国大模型还无人问津的年代,一家量化基金已经悄悄囤下了数千张高端GPU。
2021年,幻方量化的资产管理规模突破千亿元。梁文锋有钱了,而且非常有钱——2025年,幻方量化平均收益率达到56.6%,仅当年就为梁文锋带来超过7亿美元的个人收入。
但钱不是他的终点。
2023年7月,梁文锋在杭州创立了"杭州深度求索人工智能基础技术研究有限公司",正式进军通用人工智能。那正是全球大模型军备竞赛最激烈的时刻:OpenAI、谷歌、微软都在疯狂堆参数、堆算力、堆资金。
梁文锋的选择截然不同。
他几乎拒绝了所有投资人——据接近他的人透露,他觉得拿风险投资的钱是一种"负担",会影响公司的战略判断。DeepSeek背靠幻方量化的现金流,从未有过资金压力,团队始终控制在150人左右,绝大多数是本土高校的应届毕业生和还没毕业的实习生。
梁文锋自己说过一句话:"我们并没有什么高深莫测的奇才,都是一些Top高校的应届毕业生,没毕业的博四、博五实习生,还有一些毕业才几年的年轻人。"
一支没有"明星科学家"的年轻队伍,一个不靠融资活着的"实验室",接下来要做的事情,却让整个硅谷彻夜难眠。
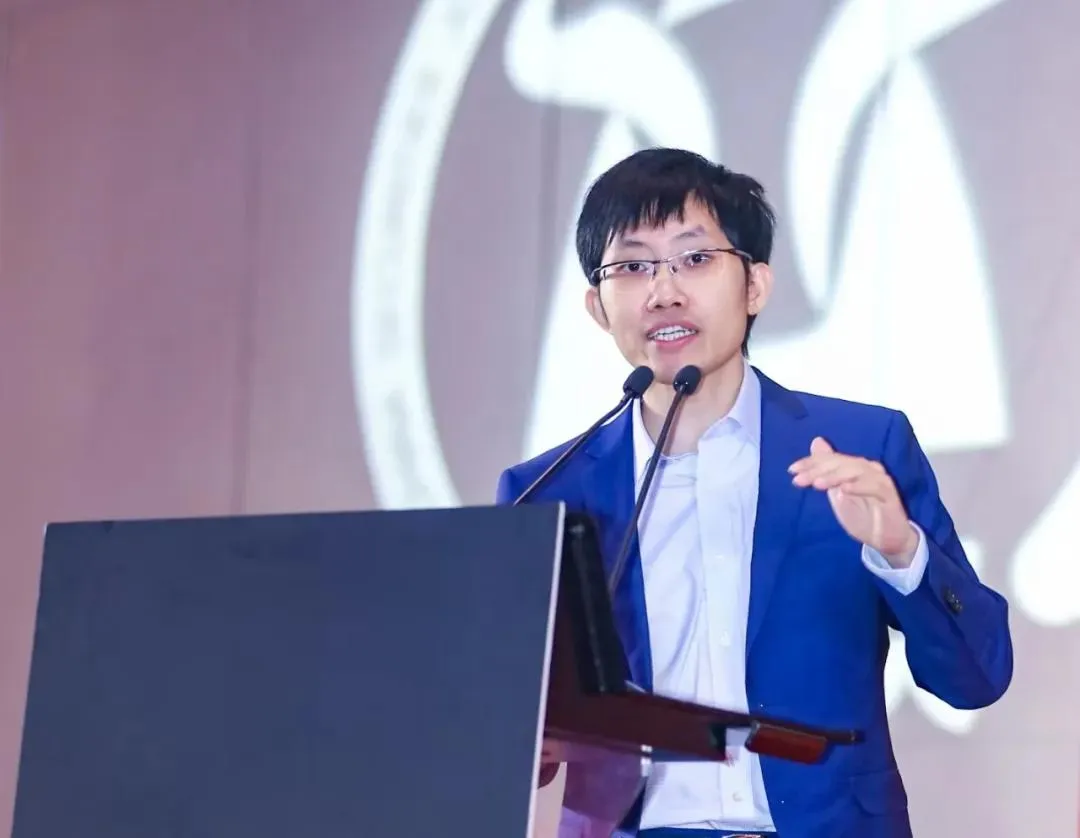
梁文锋,一个几乎从不出现在媒体上的创始人,正在改写AI的竞争规则。
02 一条鲶鱼:557万美元训练出顶级大模型
2024年5月,DeepSeek发布V2模型,率先把大模型的价格打了下去。梁文锋后来说:"我们不是有意成为一条鲶鱼,只是不小心成了一条鲶鱼。"
真正让世界震动的,是2024年12月26日发布的DeepSeek-V3。
这是一个拥有6710亿参数(其中37B激活)的混合专家模型(MoE),训练仅用了278.8万块H800 GPU小时,总成本557.6万美元——而OpenAI训练GPT-4的估算成本在5000万美元到1亿美元之间。差距接近百倍。
更让业界破防的是它的技术路线:
混合专家架构(MoE):不用每次推理都激活全部参数,像一家公司按项目抽调人手,大幅降低计算量;
多头潜在注意力(MLA):压缩了推理时的显存占用,让模型更轻、更快;
FP8混合精度训练:在保证精度的前提下,把训练成本再砍一截;
强化学习驱动推理:2025年1月20日发布的R1模型,用强化学习让模型"学会思考",在数学、代码、推理等任务上性能对标OpenAI的GPT-4o,却完全开源、免费使用,甚至把技术论文和训练细节都公之于众。
梁文锋对开源的态度,在业界几乎是"异端":"开源更像一种文化行为,而非商业行为。在颠覆性的技术面前,闭源形成的护城河是短暂的,即使OpenAI闭源,也无法阻止被别人赶超。"
他的判断被市场验证了。
2025年1月27日,英伟达市值单日蒸发5890亿美元;OpenAI、谷歌、Meta的高管连夜开会讨论如何应对;硅谷的投资人开始重新审视"算力军备竞赛"的逻辑——如果557万美元就能训练出顶级模型,那么那些动辄烧掉几百亿美元的"星际之门"们,还值得吗?
英国《金融时报》的评论很克制也很毒辣:"对于大多数商业用户来说,拥有一款足够可靠并且好用的模型,比拥有绝对领先的模型更重要。并不是每个司机都需要一辆法拉利。"
DeepSeek做的,就是那个"足够好用的车"。
557万美元,撬动了一个万亿市值的产业逻辑。
03 斯普特尼克时刻:全球爆火与集体"围堵"
技术爆发的另一面,是现象级的用户增长。
2025年1月20日R1发布后,DeepSeek App在1月26日登顶苹果全球应用商店下载榜首,一度在超过140个国家和地区霸榜第一。上线仅20天,全球日活跃用户突破2000万;发布前18天累计下载量达到1600万次,几乎是同期ChatGPT的两倍。
一个由中国公司开发的免费AI应用,在美国本土App Store登顶,超过了ChatGPT——这在过去是不可想象的事情。
随后,全球反应迅速分化。
一边是硅谷的震撼与警惕。白宫人工智能和加密货币总管戴维·萨克斯在X上发文:"DeepSeek的表现显示,人工智能竞争将非常激烈。我对美国充满信心,但我们不能自满。"2025年1月29日,美国众议院美中战略竞争特别委员会致信特朗普,呼吁进一步收紧对英伟达的芯片出口;1月31日,特朗普在白宫会见英伟达CEO黄仁勋,讨论的正是DeepSeek和芯片管制。
另一边是各国监管的紧急刹车。2025年1月30日,意大利成为第一个下架DeepSeek应用的西方监管机构;随后,美国宇航局(NASA)、美国海军、中国台湾、澳大利亚、韩国等政府和机构相继宣布在公务设备上禁用DeepSeek。
一家中国AI公司,在发布后一个月内,同时登上了全球应用商店榜首和全球多国政府的"黑名单"——这种矛盾的景象,本身就是这个时代最真实的注脚。
《纽约时报》写道:硅谷每个人都在关注DeepSeek。
它不再是一家公司,而是一个符号——中国AI从"追赶者"到"规则挑战者"的符号。
04 从"不差钱"到资本局:AI界的拼多多
爆火之后,DeepSeek面临一个新的问题:它不想商业化,但世界不允许。
2026年4月17日,市场曝出DeepSeek开启首轮外部融资的消息——此前它一直靠幻方量化的现金流支撑,梁文锋也一直拒绝见投资人。但当一个模型的日活、调用量、知名度都达到全球顶级时,继续"自给自足"已经不再现实。
2026年6月,DeepSeek完成首轮融资,规模约74亿美元(约合人民币500亿元),估值约500亿美元。A股公司开润股份的公告间接印证:按出资比例测算,DeepSeek本轮融资后估值约3508.77亿元。
2026年6月25日,胡润研究院发布《2026全球独角兽榜》,DeepSeek以3400亿元人民币的价值,成为全球308家新晋独角兽企业之首,成功跻身全球独角兽前15名——从成立到登顶全球新晋独角兽第一,只用了一年。
2026年8月,DeepSeek传出启动第二轮融资,计划募资500亿元,投前估值约5000亿元人民币(约740亿美元),较首轮提升约43%。到2026年9月,市场又传出它正在筹备上市——彭博亿万富翁指数显示,梁文锋的身家已升至约360亿美元,超过了Anthropic和OpenAI的联合创始人,被称为"全球AI模型首富"。
但资本的热捧,掩盖不了一个更尖锐的问题:DeepSeek到底怎么赚钱?
答案目前是:几乎不赚。
DeepSeek的API定价低到离谱——2026年4月,它宣布全系API输入缓存命中价格降至首发价的十分之一,V4-Pro叠加限时2.5折;2026年5月,它干脆宣布"永久降价"。与此同时,它的竞争对手们都在涨价。
36氪在一篇题为《DeepSeek想赚钱,最大的对手却是自己》的报道中直言:"它实在太便宜了。成也性价比,败也性价比。"
2026年8月,DeepSeek终于开始"算账":V4-Pro等模型引入峰谷定价,高峰期输出价格最高达27元/百万tokens,涨幅一度引发热议。2026年9月,DeepSeek又发布了新一代原生多模态模型V4.1-Flash,在成本降低的同时提升性能,登顶全球调用量榜首。
市场对DeepSeek的估值已经给出了自己的答案:148倍市销率,全球最贵的AI实验室之一——它究竟是下一个Anthropic,还是又一个估值陷阱?这个问题,连最乐观的投资人也说不准。
尾声:鲸鱼的下一片海
让我们回到2025年1月27日那个夜晚。
那一天,华尔街用5888亿美元的市值蒸发,给一家成立仅一年半的中国公司盖上了"规则改变者"的印章。而在此之前的很多年里,中国AI企业被反复灌输的观念是:算力不够、芯片被卡、差距巨大、只能追赶。
DeepSeek证明了另一条路:当算力被封锁时,效率就是最好的武器;当资本迷信"大力出奇迹"时,一群年轻人用数学和工程学给出了更优雅的答案。
它的出现,让"斯普特尼克时刻"这个冷战词汇,重新回到全球科技圈的日常讨论——这本身就是一种划时代的象征。
当然,故事的下一章并不轻松。
商业化是DeepSeek必须迈过的坎:极致的性价比让它赢得了用户,却也让盈利变得艰难;开源是它的信仰,却也是竞争对手的养料;而地缘政治的压力,从它登顶App Store的那一刻起,就没有停止过。
但或许,梁文锋根本不在乎这些。
他说过,DeepSeek的目标不是赚钱,而是"探索AGI的本质"。
一家把"通用人工智能"当成初心、把"开源"当成文化、把"应届生"当成主力军的公司,正在用最反资本的方式,成为全球估值最高的AI独角兽之一。
这条蓝鲸游向的下一片海,可能是AGI的深水区,也可能是商业化的浅滩。没有人知道答案。
但所有人都知道:从2025年1月27日开始,全球AI的竞争规则,已经被它永远地改变了。