 展开万物,复杂知识易懂。
这轮评测给出的应用分工很直接:高频路由和 Agent 前置决策可优先考虑 Jev;事实发布与高风险审核优先考虑 Luna,并保留人工闸门。这个判断来自效果、批量耗时、成本和结构化输出完整性四项结果。先说明数据,再看建议。
 01 · DATA
这 200 条数据,测的是“程序下一步怎么做”
评测集由 200 条中文合成状态组成,四类任务各 50 条;每条都要求模型在预定义的互斥选项中做一个原子决定。标签由单一作者人工构造并复核,因此“一致率”只表示与 v1 参考标签一致,不等同于真实业务正确率。任务内容与两轮实验协议见下图。
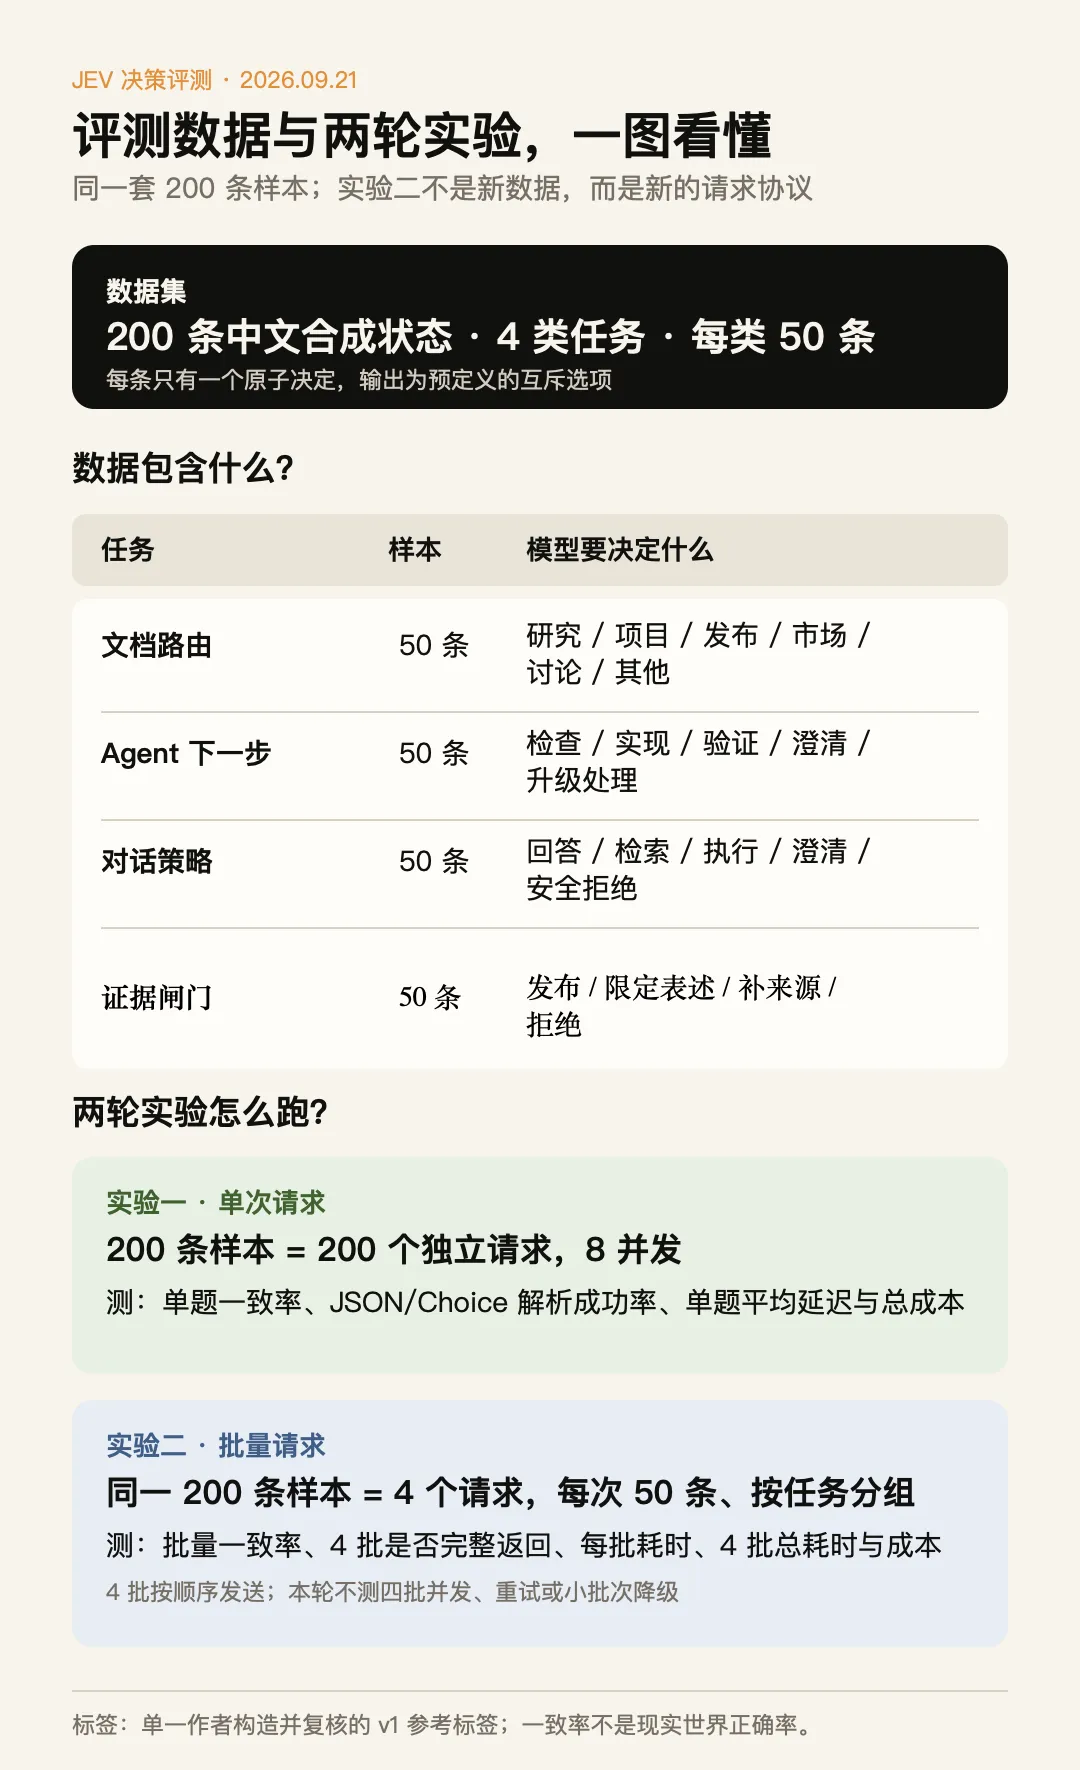
图 1:评测数据与实验设计。实验二复用实验一的同一套 200 条样本,改变的是请求组织方式,不是测试数据。
 02 · RESULTS
两轮实验的完整成绩单
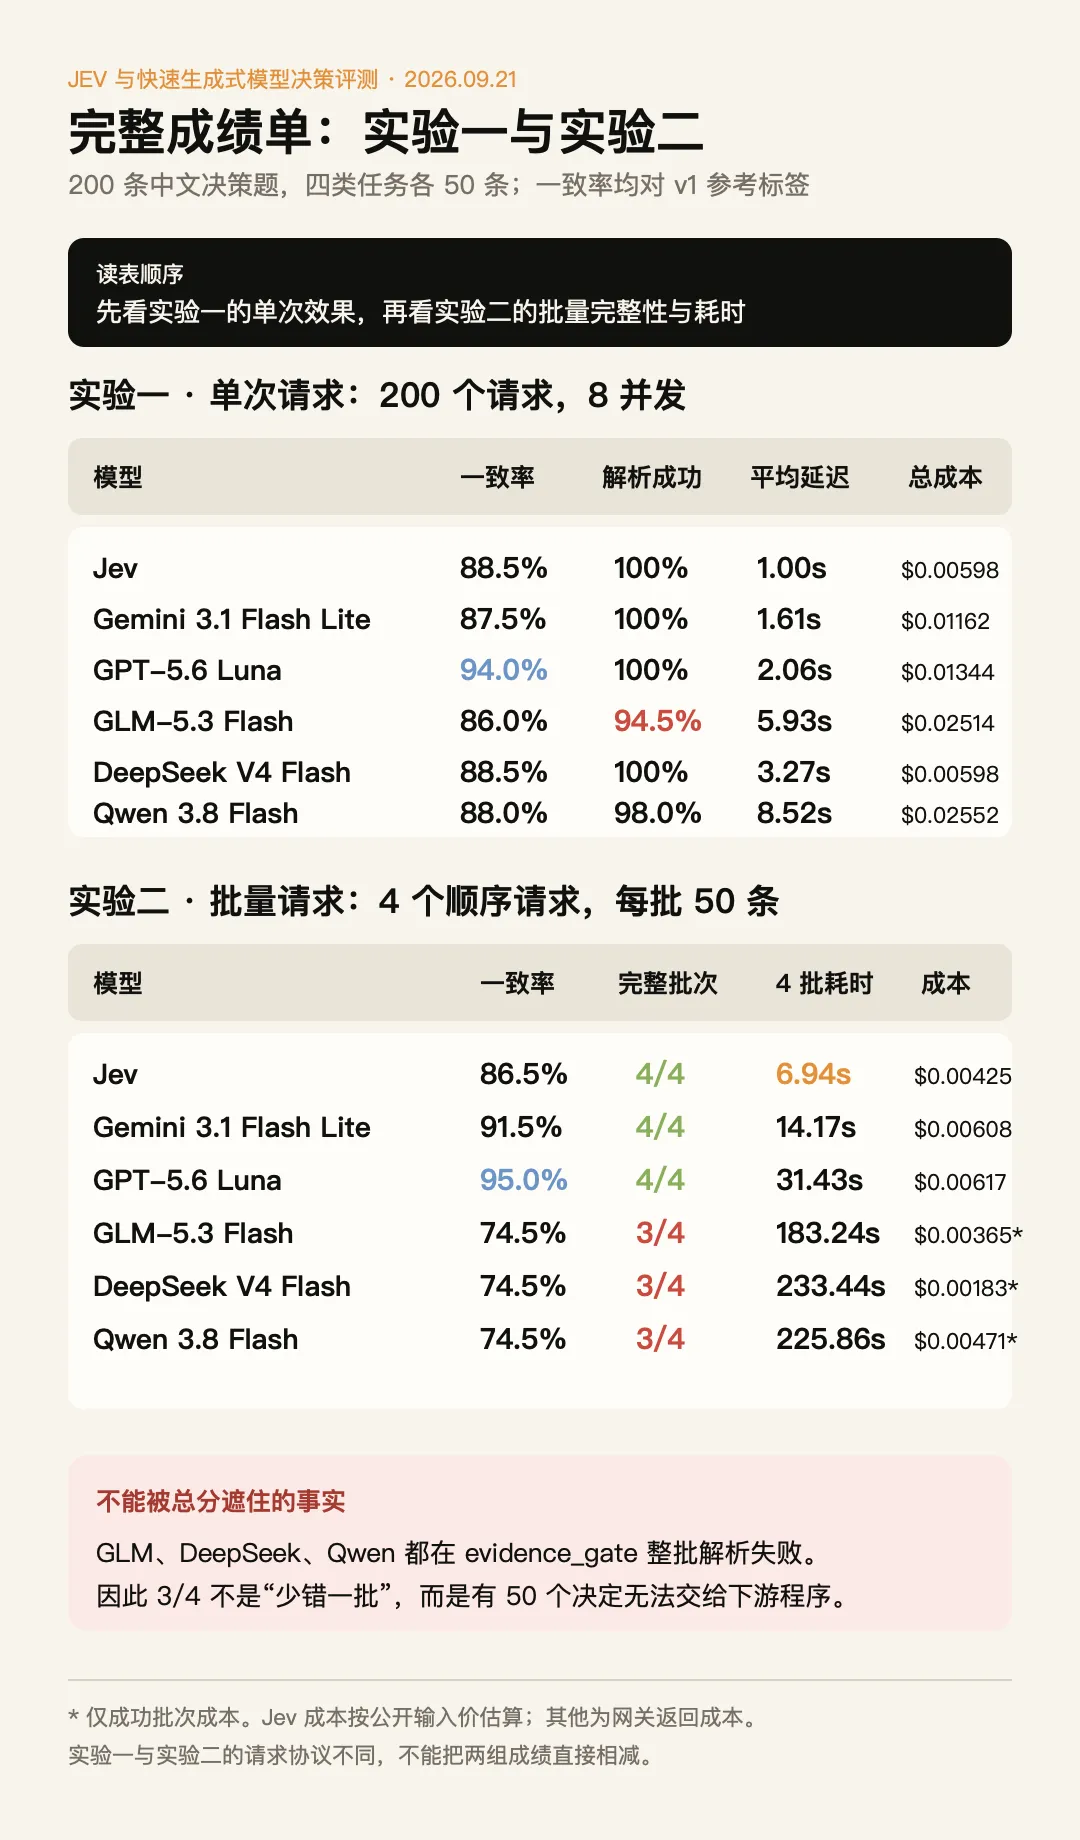
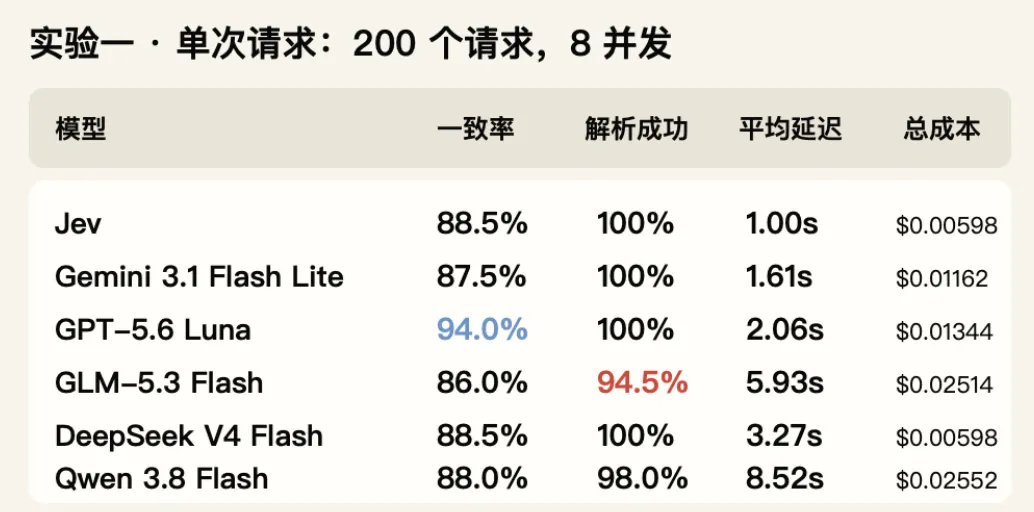
图 2:实验一为 200 个单次请求、8 并发;实验二为 4 个顺序批量请求、每批 50 条。Jev 成本按公开输入价估算;其他为网关返回成本。数据来自 2026-09-21 本轮运行。
先读批量部分,因为它最接近需要结构化交付的实际工作流。
效果看 Luna。 它的批量一致率为 95.0%,四批全部完整,六个候选中最高。若决策错误的代价高于几十秒的等待,这是本轮最直接的选择。
时延看 Jev。 它 6.94 秒完成四批;Gemini 和 Luna 分别为 14.17 秒、31.43 秒。Jev 的代价是批量一致率为 86.5%,比 Luna 低 8.5 个百分点。
价格差较小。 三款完整候选的批量成本从 $0.004250 到 $0.006165 / 200 条,差额不到两美分;实际采购仍应以自己的 prompt、输出长度和重试率复测,尤其 Jev 在本轮按公开价估算。
 03 · RELIABILITY
为什么“3/4 批次”不是一个小问题
GLM、DeepSeek、Qwen 在批量模式的结果都是 3/4 完整。缺掉的恰好都是 evidence_gate 的整批 50 条:模型没有返回可按 ID 解析的根对象,因此被计为协议错误。
这意味着下游程序拿不到 50 个可用决定,而不只是“分数少了几个点”。这也是为什么不能只用逐题成绩做选型:DeepSeek 在逐题模式与 Jev 同为 88.5%,但在这套 50 条结构化批量协议下没有完成全部批次。
如果要把这三款模型接入该流程,先需要验证拆分更小批次、重试与输出解析兜底是否有效;本轮没有测这些补救策略。
 04 · JEV
Jev 的适用面与短板
Jev 的批量结果在文档路由、Agent 下一步、对话策略三项分别为 94%、94%、92%;最弱的是证据闸门,仅 66%。逐条模式中,它在证据闸门的 16 个不一致里,有 12 个把“应补来源”判成了“应拒绝”。
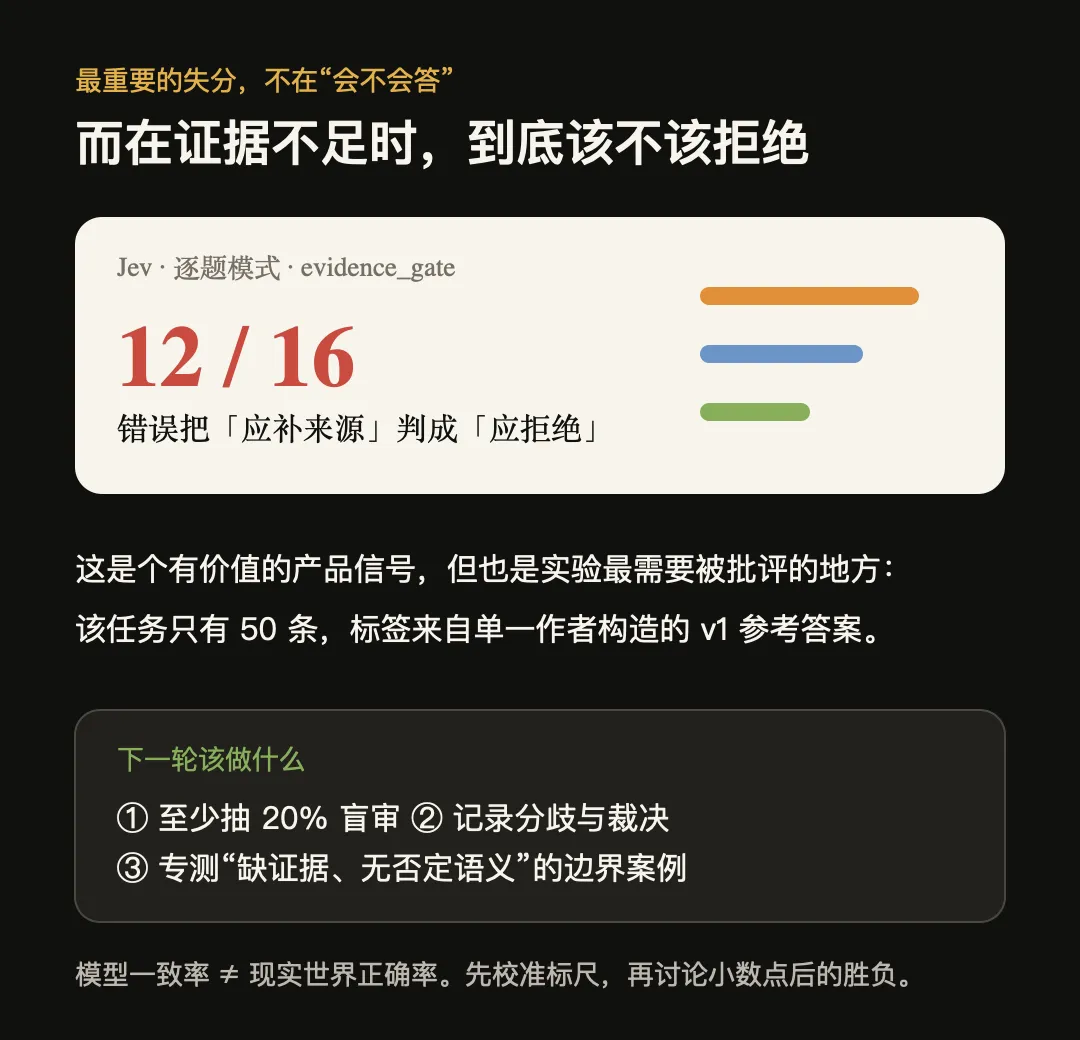
图 3:仅统计 Jev 在实验一(单次请求)的 evidence_gate 任务;12/16 不代表全部模型,也不代表真实业务分布。
它的边界很具体:更适合路由、初筛、分发和下一步选择等可枚举、可回退的任务。若用于对外发布、合规判断或自动拒绝,应在“拒绝”和“补来源”之间增加规则或人工复核。
 05 · APPLY
把结果放进应用,而不是放进排行榜
下面把推荐用法、关键数据和必要闸门压成一张图。用 Jev 的前提是错误可回退;用 Luna 的前提是保留人工复核。
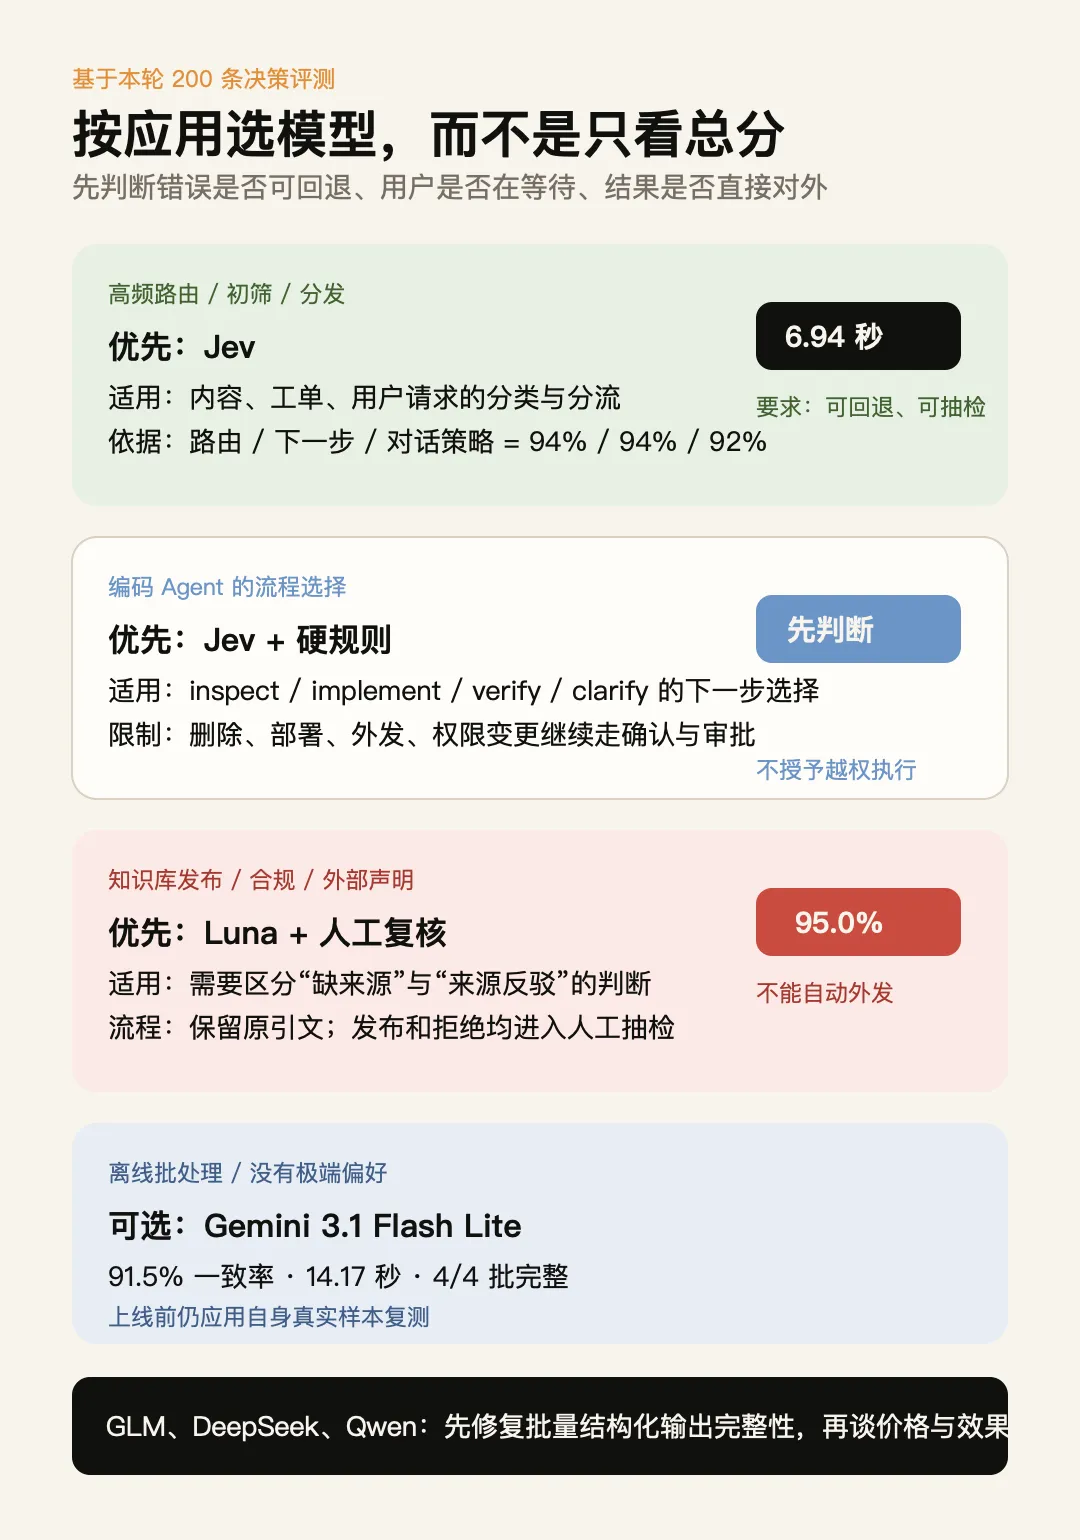
图 4:应用建议基于本轮 200 条、枚举式决策任务;不是对所有业务、语言或开放式推理任务的排名。
应用建议 Jev 放在“快、选项固定、可以回退”的前台流程;Luna 放在“错不起、需要证据判断”的审核流程;两者都不要绕过高风险动作的显式审批。
 06 · LIMIT
这份结果不能说明什么
它不能证明模型在真实生产环境、开放式推理或所有语言上同样表现;也不能把本轮成本直接外推为长期账单。上线前,至少用自身的真实样本复测,并抽取 20% 样本做第二标注者盲审。
 UnfoldX 开物 · 展开万物,复杂知识易懂。