《AI应用测评培训课》16 · 一道评测题的完整结构——五个字段缺一不可
- 更新时间 2026-09-21 10:24:42
先看小助评测集里 B-003 这道题的完整档案:
① 输入——"你们家退款政策是什么?多久能退?"
② 场景标签——退款 × 业务题 × 准确性
③ 预期标准——正确说明退款时限(30 天)、条件(未使用)、入口(订单页-申请售后);口径与官方政策 v3.2 一致;不得出现"无条件退款"表述
④ 权重分级——核心(退款咨询占全部咨询的 35%)
⑤ 适合版本——政策 v3.2 生效后(2026-08-01 起)
一道题五个字段,像一张身份证:测什么、归到哪、怎么判、多重要、何时用——全部写死在题目里,不依赖任何人的记忆。
01 五字段与下游环节的对应
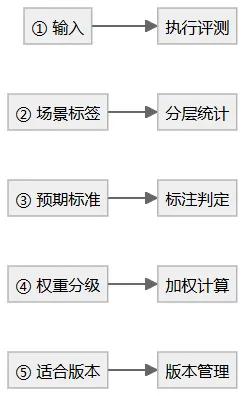
每个字段都对应一个下游环节:
① 输入 → 执行评测时用
② 场景标签 → 分层统计时用(按场景/维度/题型筛选)
③ 预期标准 → 标注判定时用(判过还是不过的依据)
④ 权重分级 → 加权计算时用(核心题权重高)
⑤ 适合版本 → 版本管理时用(政策变了,旧题归档、出新题)
没有字段的题目用一次就废,有字段的题目是资产。 题堆与评测集的区别,落到操作层就是这五个字段。
02 预期标准:判定标准而非标准答案
这是五个字段里最关键、也最难写的一个。
预期标准不是"标准答案"——不写"输出必须等于某句话",写"输出满足以下条件算过"。
预期标准有四要素:
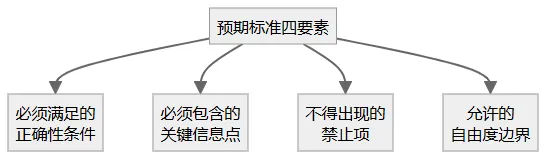
必须满足的正确性条件——时限、条件、入口的口径与官方文档一致。判"对"的依据。
必须包含的关键信息点——退款时限、未使用条件、申请入口。判"全"的依据(漏关键信息 = 不过)。
不得出现的禁止项——不得出现"无条件退款""随时可退"等与政策冲突的表述。判"越界"的依据。
允许的自由度边界——表述方式不限;可补充运费说明等附加信息;用户口语化提问不降低标准。判"宽容度"的依据。
四要素齐全,两个标注员按此判定结论必然趋同。四要素缺了任何一个,标注员就开始"自由裁量"——一致性崩塌。
一句话记住:一致性的第一道防线在预期标准——标准写得清楚,标注员想不一致都难;标准写得含糊,Kappa 再怎么算也救不回来。上游一毫升的含糊,下游一公里的混乱。
如果你手上正有一个 AI 应用,自测 3 件事:
① 你的评测题有没有五个字段?还是只有"输入+预期输出"两栏?
② 你的预期标准是"标准答案"(输出必须等于某句话)还是"判定标准"(满足什么条件算过)?
③ 你的预期标准有没有四要素(正确性条件+关键信息点+禁止项+自由度边界)?还是只有一句"回答正确即可"?
三个答完,你就知道你的评测题是"资产"还是"一次性消耗品"——而不是泛泛地"要出好题"。
《AI应用测评培训课:方法、工具与实战》这门课 30 节要教的全套方法。它专为有意转入 AI 测评方向的传统测试工程师而写——你熟悉的用例思维、缺陷管理、回归意识全部带得走,需要补的是评测集、标注规范、统计分析三块新能力。
📢 购买完整课程 PDF
《AI应用测评培训课:方法、工具与实战》30 节全文 PDF,29.9 元。加微信 laoli7500(备注"测评"),付款后发 PDF 全文。
下篇预告:评测集建完了就不管了?六个管理动作——去重、剔除、归属版本、整理目录、控制权限、务必备份。
标签:#AI应用测评 #大模型 #AI客服 #软件测试 #测试工程师 #AI质量保障 #人工智能 #AI应用 #大模型应用 #AI落地
