知识工作者的办公活里,AI 能插手的地方越来越多,工具也分了三类:带深度研究的对话式大模型(Kimi、ChatGPT、Gemini),写代码的智能体(Claude Code、Codex),面向职场的办公智能体(腾讯 WorkBuddy 等)。拿写竞品调研报告来说,这类活信息大多在网上、交付物是一份文档,到底该交给哪一类,正是这篇文章要回答的。
要回答它,得先看清任务本身的链路。一份竞品报告要经历明确范围、检索信息、阅读评估、交叉综合、排版交付五个环节,前四个是"信息综合",最后一个是"文件产出"。不同工具卡在不同环节,选型就是看哪个环节是你的瓶颈。
三类工具,三套逻辑
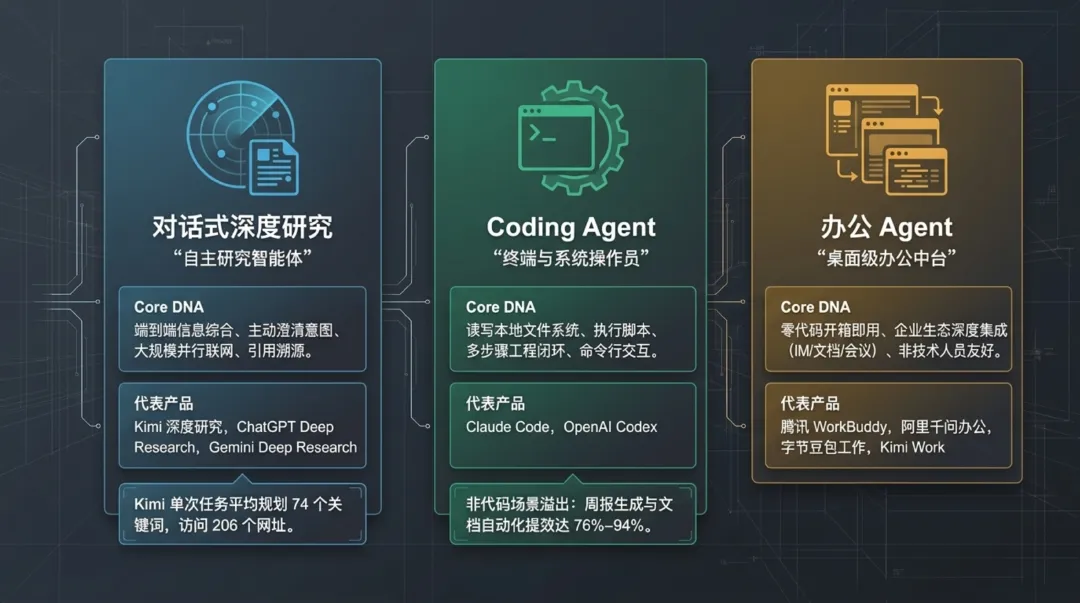
市面上的 AI 工具大致分三类,它们优化的主战场完全不同。
第一类是对话式深度研究工具。Kimi 深度研究、ChatGPT Deep Research、Gemini Deep Research 本质是自主研究智能体:你抛出问题,它自己澄清意图、规划检索、阅读来源、迭代推理,最后吐出带引用的长文。Kimi 平均每个任务规划 74 个关键词、访问 206 个网址,筛出质量最高的前 3.2% 才落笔。这套链路就是为调研报告长的。
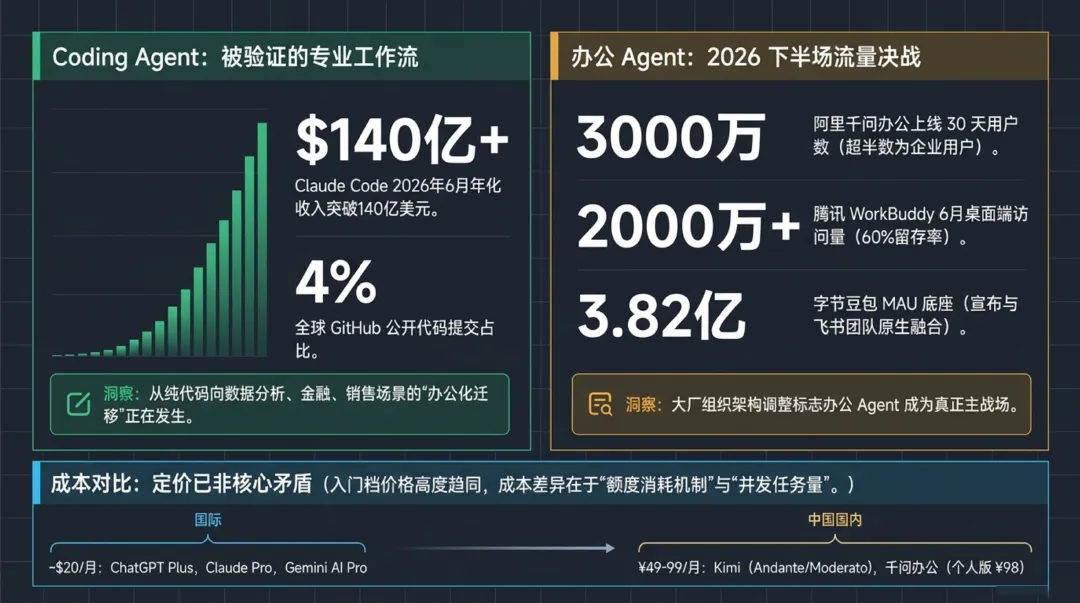
第二类是 Coding Agent。Claude Code、Codex 的设计目标是读写代码库、跑命令、提 PR,核心能力在操作终端与代码仓库。它们做文档任务是溢出的——实测把文件整理从 240 分钟压到 30 分钟,厂商多案例平均省下 76% 的工时,单案例最高达 94%。前提是你能用得了终端。
第三类才是 2026 年成形的办公 Agent,WorkBuddy、月之暗面 Kimi Work、阿里千问办公、字节豆包工作都在这条线。它们把 Coding Agent 的执行力搬到桌面,面向不写代码的职场人。WorkBuddy 和 Claude Code、Codex 不属一类:前者解决"对话式 AI 只给建议不干活",后者是给开发者的。
选型的第一性原理:信息在哪,产出是什么
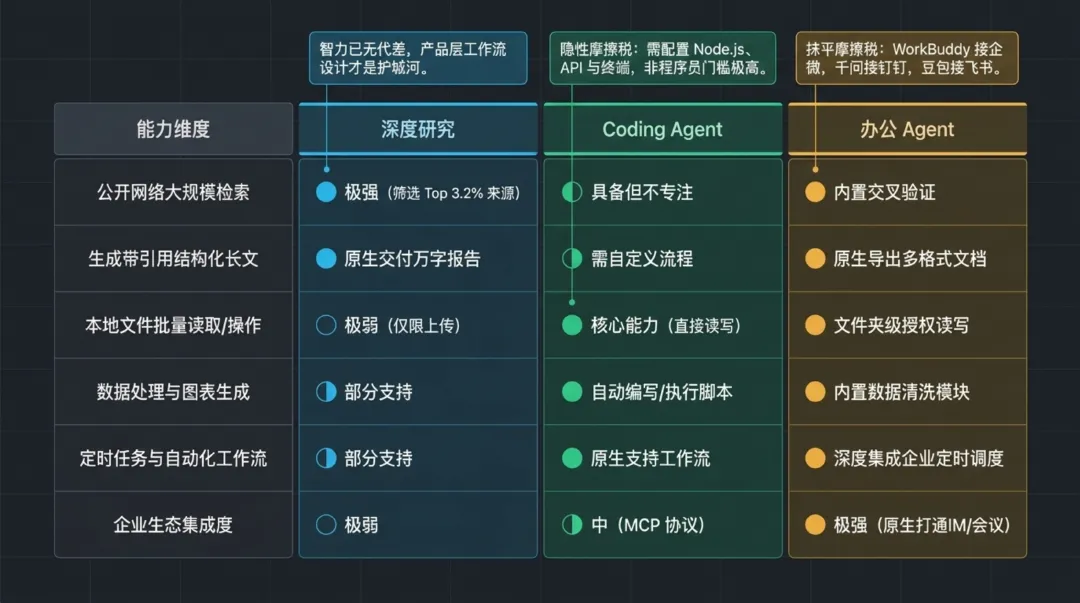
把五个环节逐一对号入座,结论很清楚:报告的信息源越偏向公开网络,越该用深度研究工具;信息源越偏向本地文件和内部数据,越该用 Coding Agent 或办公 Agent;产出物越偏向能跑起来的东西(看板、网页、自动化流程),越该用 Agent 类工具。
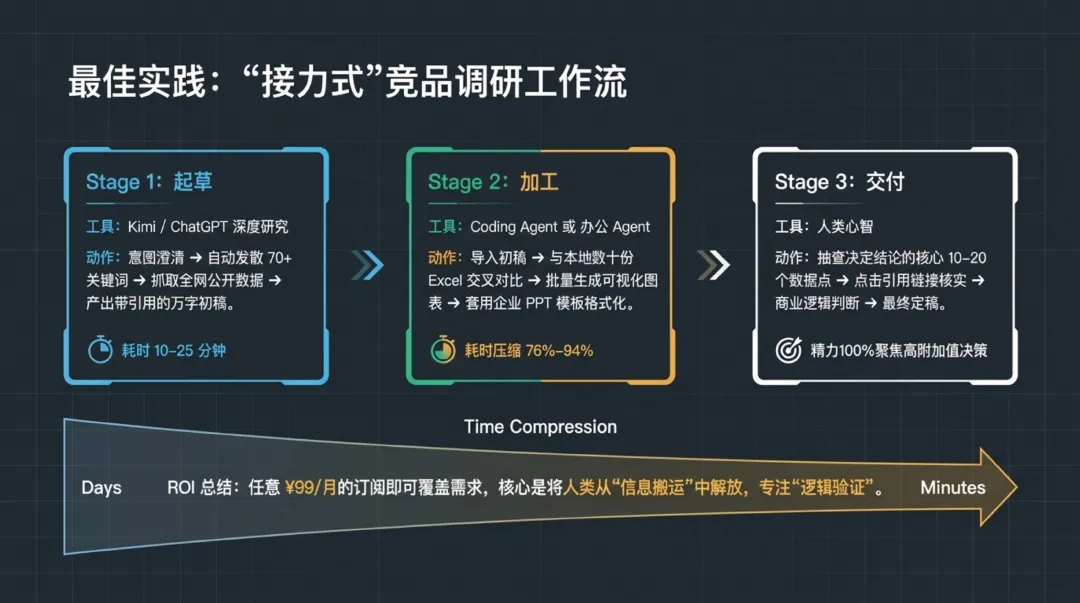
一份纯靠公开资料拼的竞品分析,用 Kimi 深度研究一次跑完,10 到 25 分钟出初稿,省掉的是传统上几天的人工检索阅读。可一旦要把竞品价格拉进公司自己的销售表做交叉、批量出图、套企业模板,深度研究工具就露怯——它导得出 Word 和 PDF,处理本地数据不是它的活。这时候 Claude Code 或 WorkBuddy 反而更顺手。
值得注意的是,模型层的智力差距已不是选型变量。OpenAI 的 GDPval 基准测真实职场任务,头部模型"不输人类专家"的比例从 2025 年的 47.6% 爬到 2026 年的 83.0%;深度研究的 HLE 基准上,头部模型集中在 47% 到 59%。模型本身不再是决定性因素,拉开差距的是为这条任务链路做了多少优化。
被低估的"摩擦税"
Coding Agent 用在办公上,最大的隐性成本是门槛。非技术用户想用 Claude Code,得先开终端、装 Node.js、配 API 密钥,再在命令行里对话。它的能力非程序员其实也能用,但使用方式对非程序员并不友好:报错看不懂、不适合边做边改、描述不精准就得多轮返工,每一步都在劝退。
办公 Agent 正是来抹平这层摩擦税的。WorkBuddy 主打零部署开箱即用,微信、企业微信都能远程下指令;Kimi Work 一个对话框调度整个桌面工作流,新用户很快就能完成首次体验。不过也要冷静:办公 Agent 生成一份 PPT 看着很快,不等于很快就能交付,配置、等待、核查、返工都得算进总成本;深度研究工具同理,25 分钟出报告也得人工核关键事实才敢发。
国内办公 Agent 市场在 2026 年格外热闹。WorkBuddy 3 月上线,上半年桌面端访问量 2097 万次居首;阿里千问办公 8 月公测,30 天用户破 3000 万,过半是企业用户;字节把飞书并进豆包,拿 3.82 亿月活往办公场景迁。四条路线分明:WorkBuddy 拼入口,Kimi Work 拼深度,千问办公拼 B 端,豆包工作拿 C 端反哺 B 端。
避不开的引用幻觉:AI 起草,人工核查
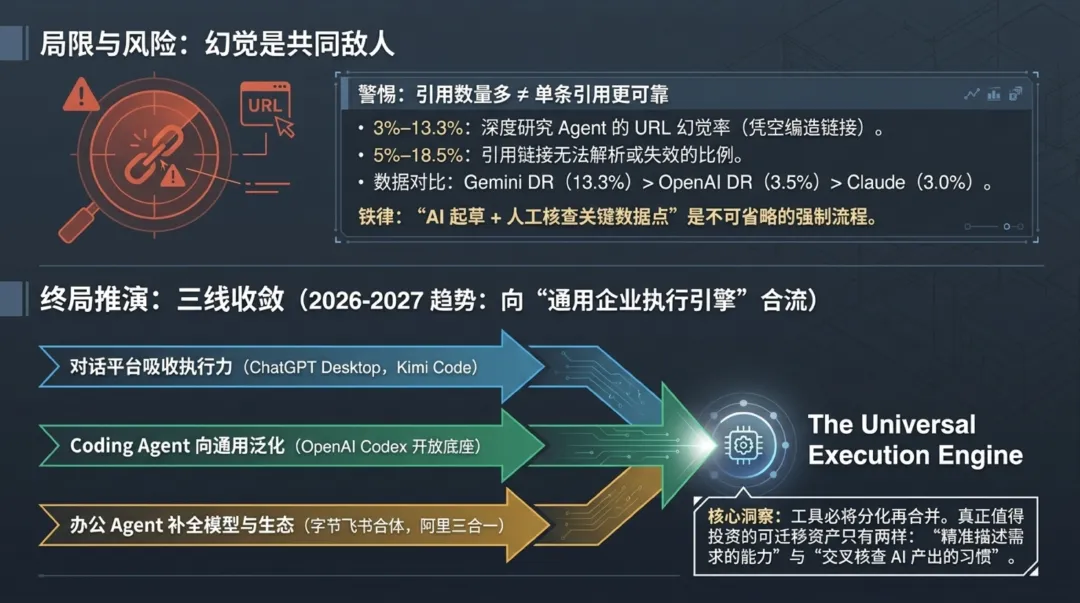
调研报告的核心资产是事实可信度,而这恰恰是 AI 的共性短板。2026 年一项覆盖 10 个商用模型的大研究发现,引用 URL 的幻觉率(凭空编的链接)在 3% 到 13.3% 之间,无法解析的链接占 5% 到 18.5%;有意思的是,深度研究 Agent 生成的引用数量远多于普通模型,幻觉率却最高——Gemini 2.5 Pro Deep Research 达 13.3%,OpenAI 是 3.5%,Claude 系列最低,3.0% 到 3.2%。引用多不代表引用准,检索架构比输出数量更要紧。
另一项学术检索研究里,Deep Research 的参考文献错误率仍有 26.57%,超四分之一的引用在标题、DOI、作者或日期上出错;还有实测发现 Gemini 估算市场规模时,直接用会计软件市占率乘企业总数,忘了其中一半企业根本不用会计软件。无论选哪类工具,"AI 起草加人工核查关键数据点"这步都省不掉。 好消息是,深度研究带来的可点击引用,让核查成本远低于传统人工调研。所以与其纠结选哪家,不如先把核查流程固化下来。
结语:选工作流,别选产品
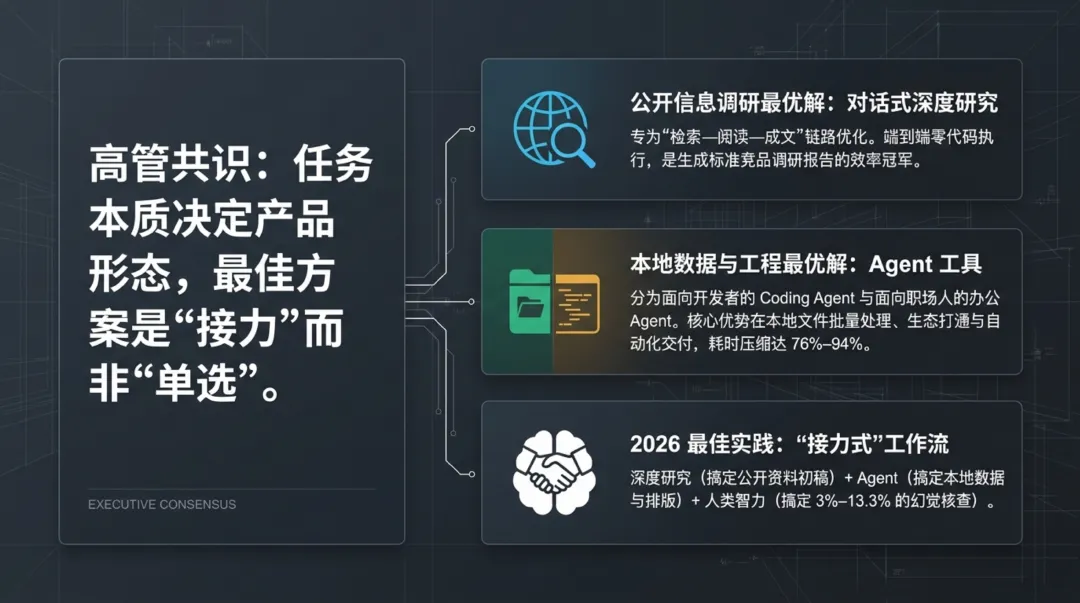
对大多数知识工作者,更务实的做法是分阶段接力:深度研究工具拿公开信息出初稿,Coding Agent 或办公 Agent 做本地交叉、出图、套模板,最后人抽查那决定结论的关键数据点定稿。不过也别把接力想复杂——若报告只依赖公开资料,一个深度研究工具或 WorkBuddy 这类集成式办公 Agent 已能包圆;只有当任务要接本地数据、套企业模板、跑自动化流程时,才值得把"执行腿"交给 Coding Agent 或办公 Agent 接力。这套接力的经济账很清楚:深度研究把原本几天的检索阅读压到几十分钟,Agent 类工具再砍掉整理、处理环节的一大半工时,人的时间集中在最值钱的核查与判断上。
三条路线正在收敛。ChatGPT 桌面端合成了 Chat、Work、Codex 三种模式;Kimi 用"深度研究、Kimi Work、Kimi Code"覆盖调研到执行;字节把豆包和飞书工作流打通。大厂在 2026 年夏几乎同时调整架构,把办公 Agent 定为接下来的主攻方向。今天的选型,选的是工作流习惯,不是某个固定的产品。 能带走的资产只有两样:把需求描述清楚的能力,和核查 AI 产出的习惯。工具会继续分了又合,但"AI 起草、人类判断"这副分工,短期内不会变。