今天开合集第一节。网上一搜全是指标公式,真要把评测接进工程,还得先有读表、调接口、写回结果这条骨架。下面就按我这份 python_foundation.py 说,我是怎么接的。有疑问欢迎评论区留言~
默认 mock,不烧 token。本机 Ollama 起来了再加 --live。
tips:对照实现就这一份脚本。函数、JSON / CSV、requests、异常,全压在「造数 → 读表 → 调接口 → 写结果」上。Judge、RAGAS、命中率都是后面的事。
后面混淆矩阵、裁判员、工具命中率,骨架几乎一样。第一节只把前三步练熟:读数据集、逐条问模型 / 智能体、把 actual 写回文件。
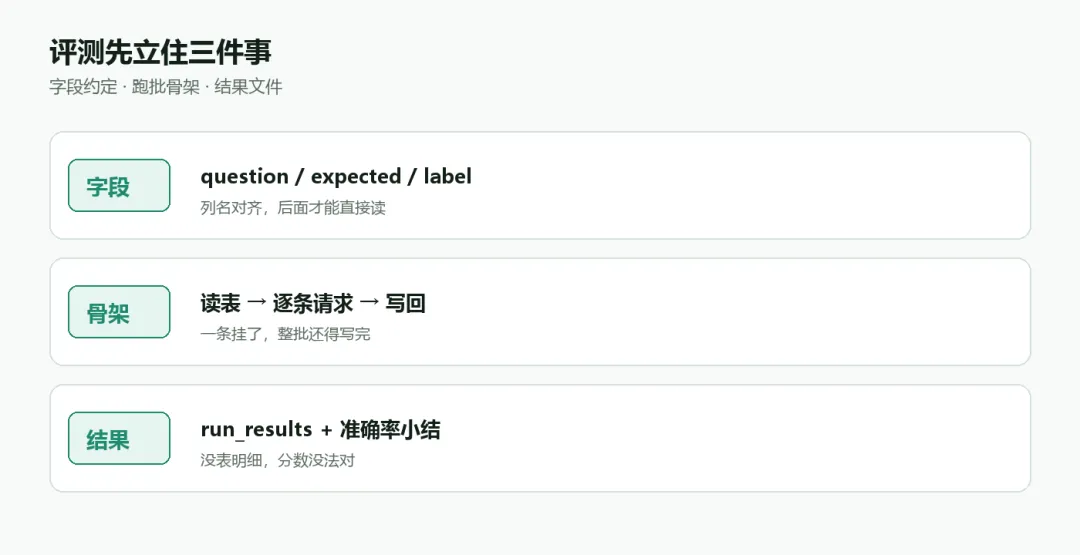
字段约定、跑批骨架、结果文件。三件事立住,分数才对得上。
01先认清这条骨架
拿掉名词,评测链路就这四步。指标后置,先把链路跑通。
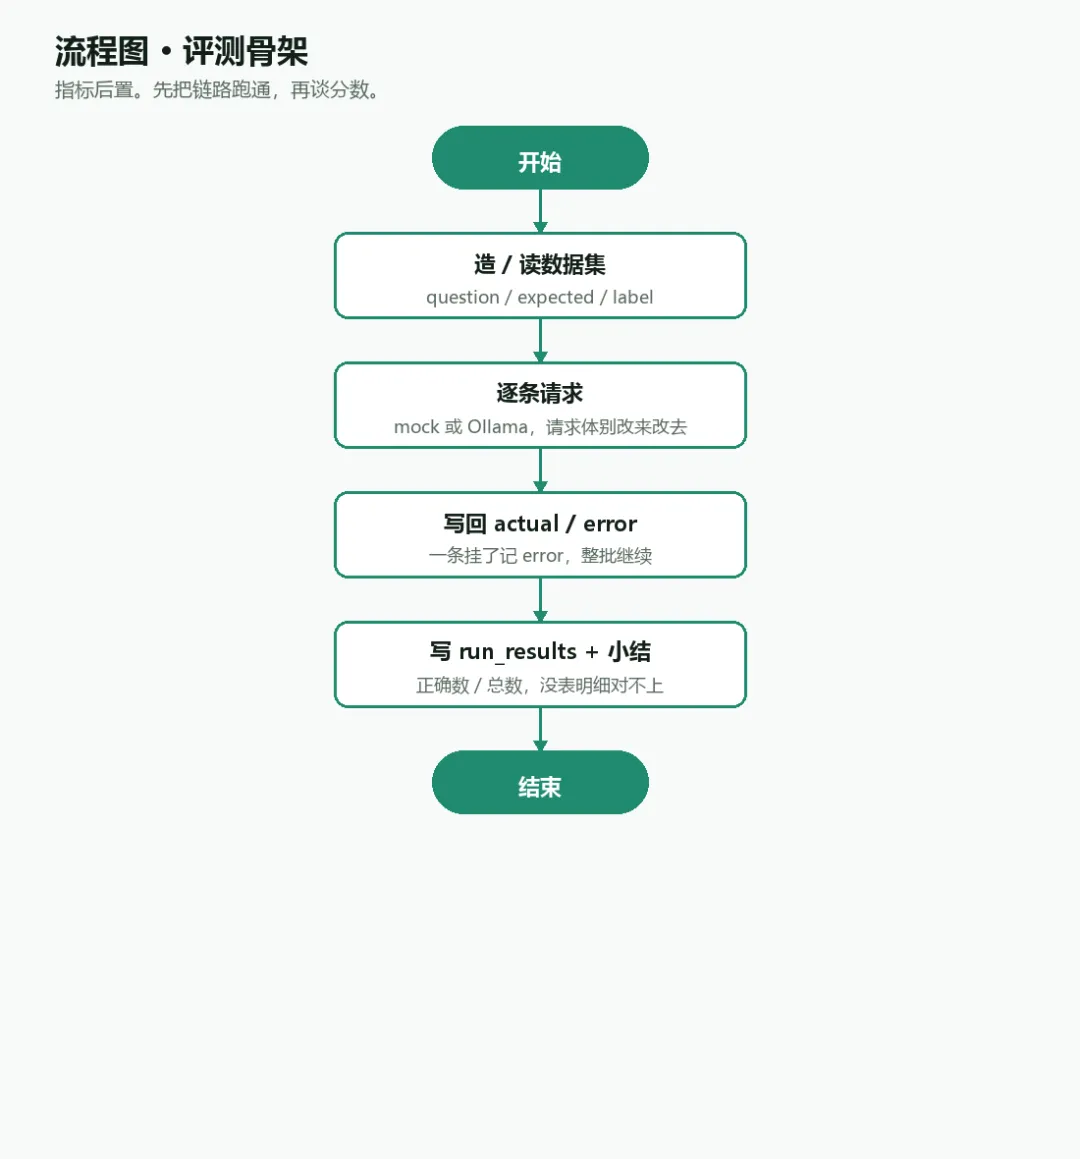
造 / 读表 → 逐条请求 → 写回 actual / error → 出小结。分数往后放。
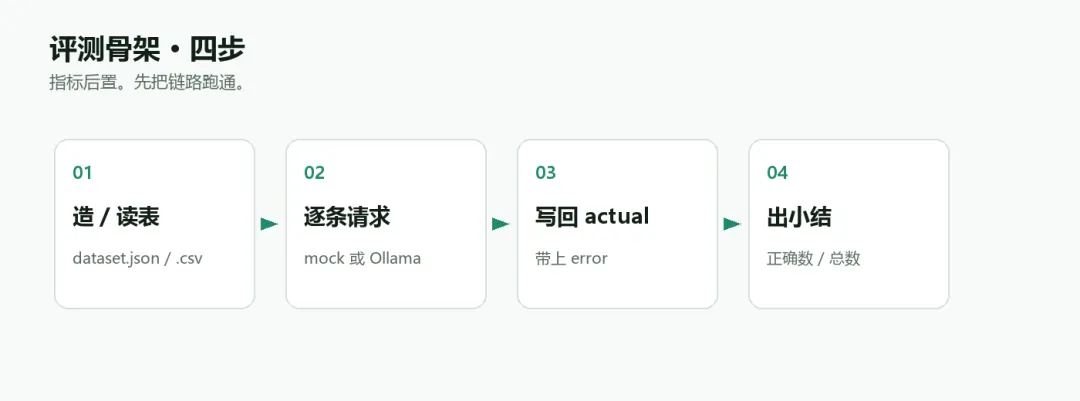
对照脚本:build_sample_dataset → run_pipeline → save_json / save_csv。
语言可换,这五块不能缺:
能力 | 函数 | 后面用在哪 |
函数 | build_sample_dataset / run_pipeline | 造数、评测主流程 |
JSON IO | save_json / load_json | 数据集、跑批结果、Trace |
CSV IO | save_csv / load_csv | Excel 友好的明细、Bad Case |
requests | call_api / call_ollama_chat | 调智能体 / 本机模型 |
异常 | 超时重试、单条失败继续 | 第 3 条挂了,后面 97 条还得跑 |
默认走 mock_answer:正例直接回 expected,负例故意回一个「看起来像但错」的答案。不依赖模型,几秒出 dataset.* 和 run_results.*。本机推理就绪再加 --live。
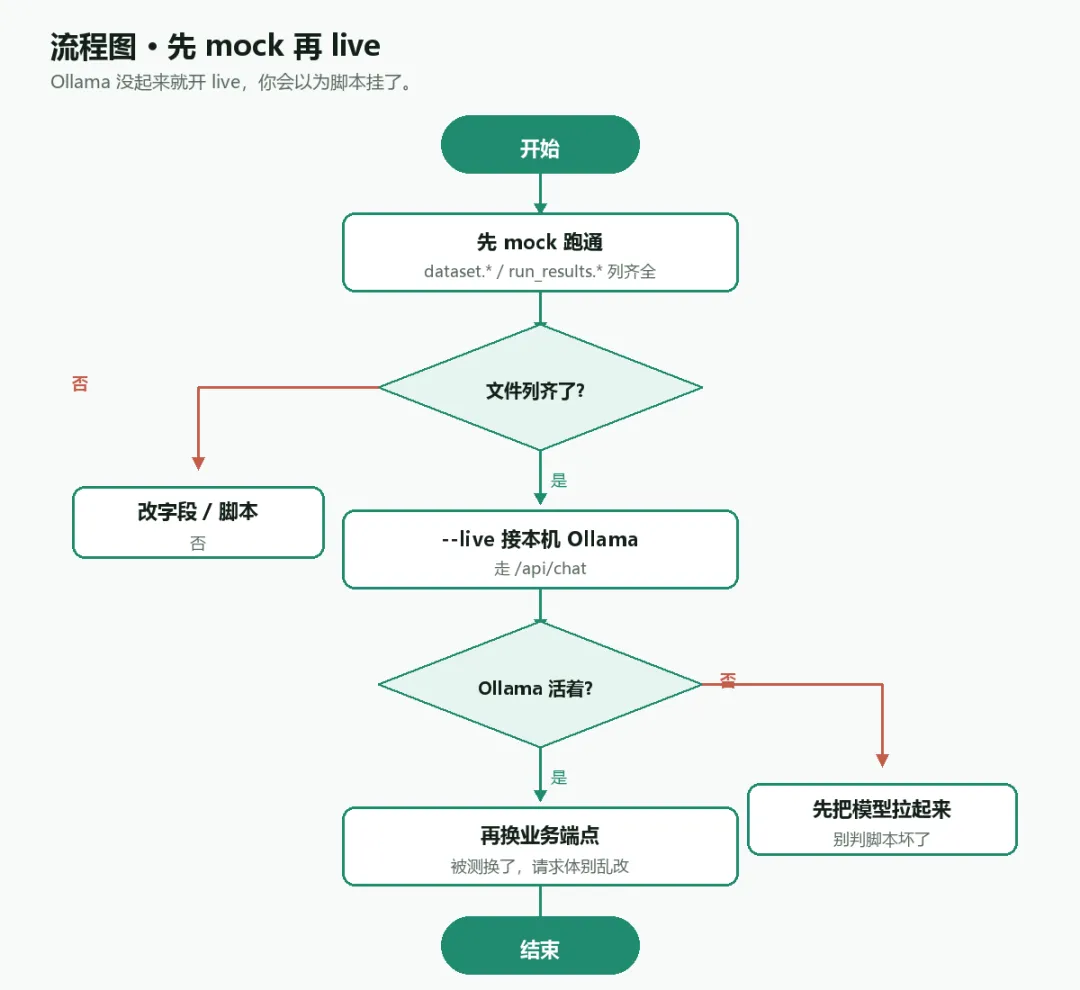
文件列齐了再接 Ollama。服务没起来就开 live,你会以为是脚本挂了。
02字段就按 question / expected / label
脚本里造了 10 条单轮样例。后面混淆矩阵、裁判员、正负例过滤都按这几个键对齐。现在列名随便起,后面每一层都要改。
字段 | 含义 | 示例 |
id | 题号 | 1 |
question | 问题(发给模型) | 中国的首都在哪儿? |
expected | 期望答案 | 北京 |
label | 期望答案本身的真负 | Positive / Negative |
tips
切记:label 标的是期望答案本身对不对,不是模型这一次有没有答对。正例:首都 → 北京。负例:北极企鹅 → 「是的」(金标本身为假)。后面上混淆矩阵,会把「金标真伪」和「输出像不像期望」拆开算。
03默认 mock,先把链路跑通
业务代码追求功能对。评测脚本还多三件事,少一件后面分数就对不上:
1. 同一题库、同一请求体,下周还能复跑
2. 不只留总分,每条留下 actual,挂了留下 error
3. 结果必须写成文件,笔记本里聊几句不算数
所以先 mock 跑通全链路:不依赖外网和模型,也能看到 dataset.* 与 run_results.*。列齐了,再接真实推理。
tips
切记:笔记本手敲几条问答、结果没有判定列、一条超时整批停掉——这三样最常见。规模一大,你都不知道哪条没跑。
04在合集里的位置
后面依次换被测和判分:多源题库 → RAG 词重叠 → Judge → 插件命中 → 意图 → RAGAS → 多轮与多智能体。
骨架不变:
· 读一张字段对齐的 JSON / CSV
· 用统一客户端(或封装后的 Agent)逐条请求
· 写回 actual 和指标列
· 输出带明细的小结
第一节之后,只替换「被测」和「判分」,不再重写脚手架。
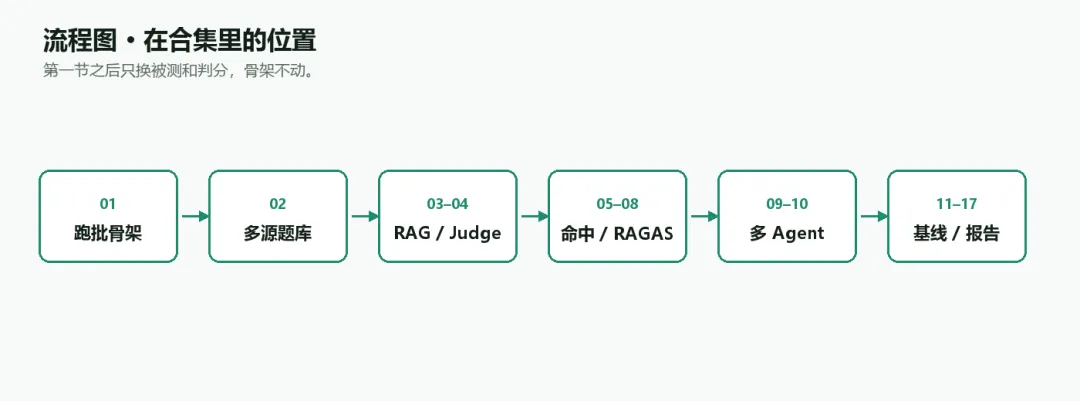
跑批骨架 → 题库 → RAG / Judge → 命中 / RAGAS → 多 Agent → 基线。骨架不动。
下期预告
下篇把脚本跑起来:mock / --make-only / --live 怎么接,产物有哪些列,以及第 3 条挂了为什么后面还得跑完。
