上一篇讲了三层断言,说的是"你要断言什么"。
那篇发出去之后,有人来问我:断言我大概懂了,那我拿什么去测?
问得好。因为这里还埋着一个坑,比上一个深。你完全可以把断言想得很清楚,最后却得出一堆没用的结论。问题出在评测集上。
先说一个我见过很多次的场景。
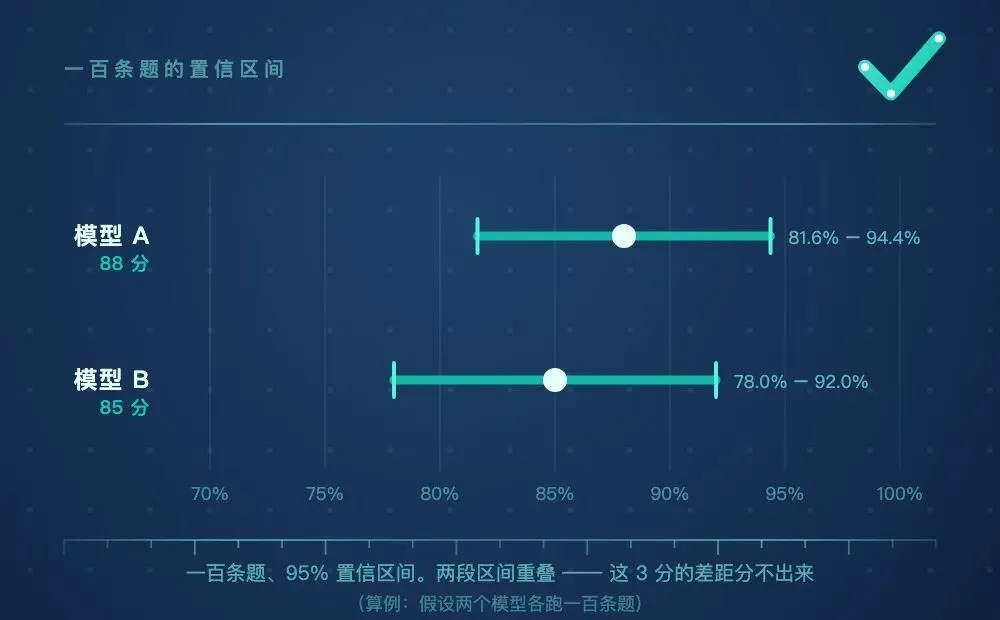
攒一百条题,把两个候选模型各跑一遍。A 得 88 分,B 得 85 分。差 3 分,选 A。结论干净,报告也干净。
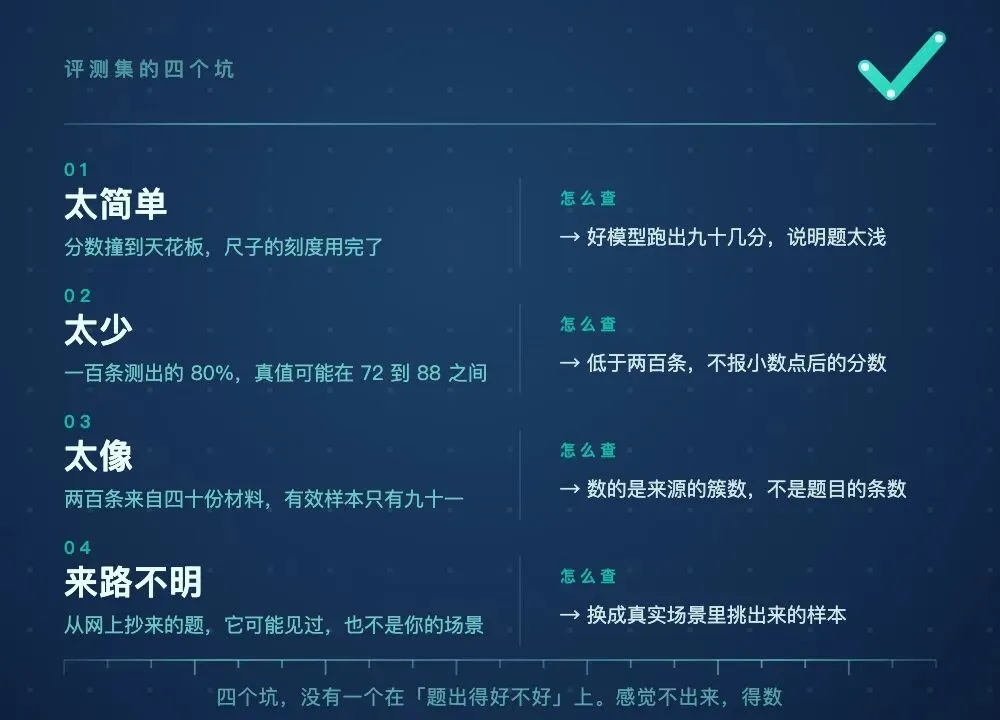
我一般会在这里叫停。3 分不算小。但这一百条题里藏着四个坑,踩中任何一个,"88 比 85 好"这句话就不成立。
一、太简单:分数撞到天花板
第一个坑最隐蔽:你选的题,模型基本都会。
这件事在公开测试集上已经演成了教科书。有个常识问答类的测试集,刚出来的时候,当时最好的模型只能做到四成多。五年以后,排在前面的模型全挤在 88 到 92 之间。而人类专家的成绩,测出来大概是 89.8。
你用来比较模型的那把尺子,刻度用完了。
分挤在一起之后,"差 3 分"就不再等于"强 3 分"。那个差距可能比尺子自己的误差还小。有人量过,光是换一种提问的排版方式,同一个模型的分数就能晃到十个百分点。
这个坑还有一个更脏的版本:题目本身的答案就是错的。有人手工核过几千道题,发现大约百分之六的题,标注的正确答案就是错的;某个很冷门的科目,这个比例超过一半。
你可能觉得这是公开测试集的毛病,自己攒的题不会。会。而且更难发现,因为你自己出的题,你天然觉得它是对的。
怎么查?拿一个你知道很好的模型跑一遍。如果它能在这套题上拿到九十几分,这套题对你已经没有分辨力了。这跟你的测法没关系,题本身太浅。
二、太少:一百条题测出来的 90 分,不是一个数
第二个坑来自统计,也最容易被忽略。
一百条题跑完,通过 80 条,你写下"通过率 80%"。这个数看着很确定,其实它只是一个点估计。真实的值在哪,得用一个区间来说。
一百条题的样本,80% 的通过率,95% 的置信区间大概是 72% 到 88%。也就是说,你测出来 80,真实值可能落在 72 到 88 之间的任何一个位置。
你手上那个 3 分的差距,整个都在这个区间里面。
再看一件事:想让误差减半,样本量得翻四倍。因为误差是按样本量的平方根缩小的。一百条题的误差是八个点,要压到四个点得有四百条;要压到一个点,得上万条。
有人认真算过:想有把握地分出两个模型之间 2 个百分点的差距,在九成准确率的水平上,大概需要一千二百条;如果准确率只有八成,需要两千四百条。
这是两个模型各跑各的情况。还有一条省力的路:让它们跑同一批题。两个模型在同一道题上的表现是相关的,需要的样本量能少好几倍。所以真要比,就用同一批题去比。
反过来看,"一百条就够用了"这句话,只在你不想区分模型的时候成立。
一条现在就能用的规矩:评测集低于两百条,就别报小数点后面的分数,也别公布排名。你可以说"这版比上版好",但别说"好 3 个点"。
三、太像:你以为测了一百条,其实只测了四十条
第三个坑是我觉得最值得讲的一个。
前面那个置信区间,悄悄用了一个假设:这一百条题是互相独立的,每一条都在告诉你一件新事。
大部分评测集不满足这个假设。
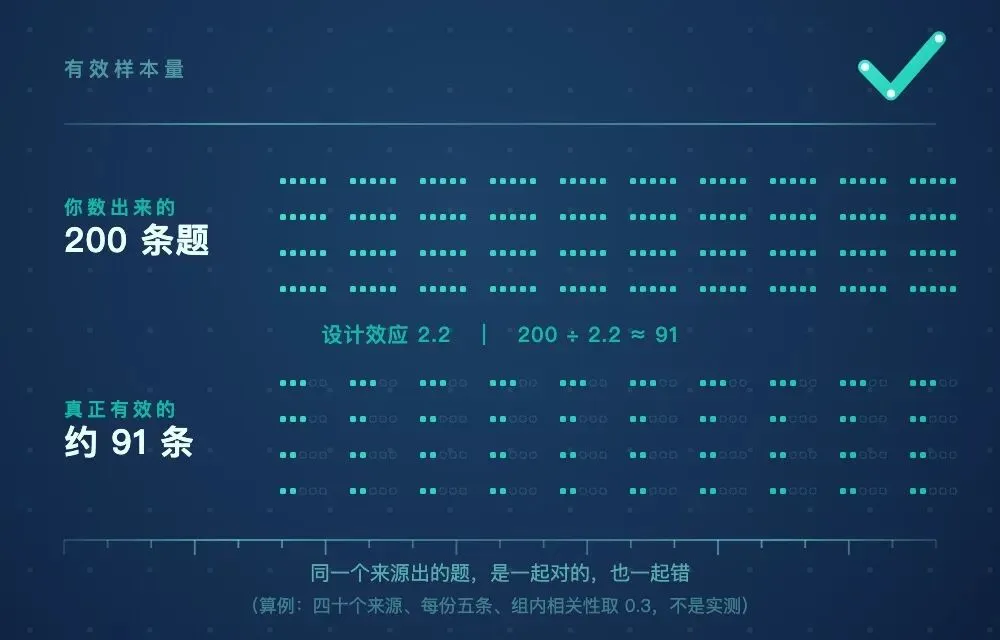
假设你有两百条题,但它们是从四十份材料里挖出来的,平均每份出了五条。这五条不是五个独立的观察。模型要是读懂了那份材料,五条一起对;没读懂,五条一起错。它们是一起动的。
统计上这叫设计效应。算下来你真正有效的样本量是:200 除以 2.2,约等于 91。
你以为是两百条,其实只有九十一条。
这个落差比你想的常见。多轮对话的评测,同一个会话里挑十轮来打分,这十轮共享同一个用户、同一个目标、同一段上下文,它们之间相关得更紧。还有一种是改写扩增:五十条种子题,改措辞扩成一百五十条。在统计上,这一百五十条更接近五十条。改写的版本测的是"它扛不扛得住换句话问",不是一百五十种能力。
而这个误差的方向很讨厌:它只会让你的区间算得太窄,不会算得太宽。也就是说,它永远在给你虚假的自信。
所以数题的时候,要数的不是条数,是来源的簇数。
四、来路不明:这批题是从哪来的
第四个坑跟题目好坏无关,跟题目从哪来有关。
最省事的做法是从公开测试集里挑一批,或者让模型生成一批。这两条路各有一个后果。
从公开测试集里挑,第一个后果是模型可能见过。有人做过一个很直接的实验:把测试题的选项挖掉,让模型去猜,它能猜对一多半。这只能说明它见过这些题。也有人在数学测试集上做过对照,把模型很可能见过的题剔掉之后,准确率掉了十三个百分点。
第二个后果是它不代表你的场景。公开测试集是在通用语料上出的题,你的业务不是通用语料。如果你手上有一套专门的说法、专门的口径、专门的红线,通用测试集一条都覆盖不到。
让模型生成那边,还有一个更绕的陷阱:用它出题,又用同一个模型来判分,很容易测出一个好看的分。但那个分可能只说明它熟悉自己出题的风格。
还有一件事,是合规要求高的场景独有的。你的评测集里必须有一批"必须要拒答"的题,不该说的不能说,不该承诺的不能承诺。这类题公开测试集里没有,因为它是你的红线,不是别人的。你只能自己攒。
四个坑走到这里,其实是同一个方向:评测集要从真实场景里长出来,不能从网上抄。
五、搭之前,先问五句话
把四个坑收成一张体检表。拿到一份评测集,先问五句:
五句里没有一句在问"题出得好不好"。题出得好不好,你能感觉出来。这四个坑,感觉不出来,得数。
六、最后说一句我的判断
评测集这件事,我以前当成体力活。攒题嘛,谁不会。
后来才明白,它更像校准量具。量具本身不准,你量得再仔细,读出来的数也是假的。
而"量具要校准"这件事,恰好是测试人的本能。我们知道一条用例通过不代表功能没问题,知道要跑回归、要控变量、要看样本量。这些直觉换个场景,全都用得上。
我自己那份小评测集,最近加了一列"题目来源"。加完之后我停了一会儿,因为一百二十条题,只有十九个来源。
我是老胡,下周见。