你正在系统上部署一个模型。系统已经启动,提示也能得到响应。现在,难题来了:它够快吗?
凭直觉,你可能会发送 curl 命令、自己编写 asyncio 脚本,或者凭感觉再编写一个一次性的负载生成器。这些做法都有同样的问题:单进程性能受限、Python 的 GIL 限制并发,或者测量结果所依据的参照也是你自己构建的。无论采用哪种方式,最终得到的结果都无法让你完全信任,而且需求一变,配套工具就得重写。
你需要的是这样一种负载客户端:它能够让真实服务器达到饱和,而自身不会成为瓶颈;能够生成可直接用于决策的结果;配置只需五分钟,而非五小时。这就是 NVIDIA AIPerf。
AIPerf 有何不同
AIPerf 是 GenAI-Perf 的指定后继工具,也是一次从头开始的重写。其设计选择反映了大规模运行 LLM 基准测试时得到的深刻经验:
- 彻底告别旧架构。 AIPerf 不像 GenAI-Perf 那样运行在 Perf Analyzer 之上。它与旧架构彻底分离,这正是 AIPerf 能够实现这种扩展能力的原因。如果你要迁移现有工作流,迁移指南介绍了关键差异。
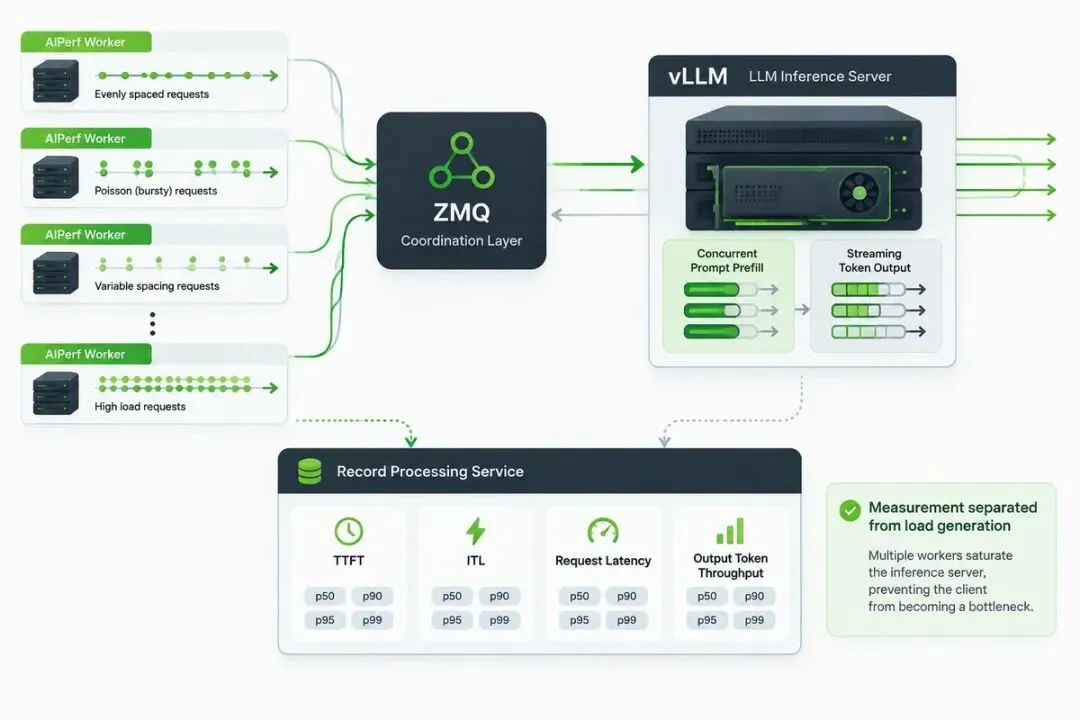
- 客户端不应成为瓶颈。 大多数基准测试工具(包括 GenAI-Perf)采用单进程架构,在实际并发或请求速率下会受到 GIL 限制。AIPerf 是一个多进程系统:工作进程生成负载,独立的记录处理服务负责处理结果,所有组件通过 ZMQ 协同。这种结构可避免 AIPerf 成为客户端瓶颈,从而更准确地对服务器进行基准测试。
- 工作负载范围与你的实际运行场景相匹配。 AIPerf 支持 15 种以上的端点类型,包括聊天、responses、NIM rankings、图像生成等;同时支持 ShareGPT 等公共数据集,以及 Mooncake、Baseten、WEKA(AgentX)等来源的轨迹重放格式。无论是快速执行合成冒烟测试,还是重放采集到的生产流量,都不需要换用其他工具。
- 真正可控的负载形态。 AIPerf 支持恒定、Poisson 和 gamma 到达模式,可调节突发程度;支持逐步提高并发量和请求速率;还支持多种合成分布,包括用于可变 ISL/OSL 的 vLLM/SGLang range-ratio。你控制的不只是负载量,还有负载的形态。
首次基准测试:在 vLLM 上测试合成 ISL/OSL
本演练将使用通过 vLLM 提供服务的 Qwen3-0.6B。选择这个模型是经过考虑的:它足够小,可以在单块 GPU 上运行,也足够快,能够快速迭代而无须长时间等待。这里的重点并非专门对 Qwen3-0.6B 进行基准测试,而是建立测量闭环。建立之后,只需更改一个标志即可换用其他模型或端点。
启动服务器
拉取并启动 vLLM,同时启用推理解析器:
docker pull vllm/vllm-openai:latest docker run --gpus all -p 8000:8000 -e HF_TOKEN vllm/vllm-openai:latest \ --model Qwen/Qwen3-0.6B \ --reasoning-parser qwen3 \ --host 0.0.0.0 --port 8000
安装 AIPerf
可以使用 uv 集中安装一份 AIPerf:
uv tool install aiperf
也可以安装到虚拟环境中:
uv venv venv source venv/bin/activate uv pip install aiperf
需要注意一个平台问题:在 aarch64 上,crick 依赖项仅以源代码形式发布,需要 C 工具链(Debian/Ubuntu 上为 build-essential,RHEL 上为 Development Tools)。如果安装过程卡在这个软件包上,原因就在这里。
运行基准测试
服务器启动并安装 AIPerf 后,现在可以运行第一次基准测试:
aiperf profile \ --model Qwen/Qwen3-0.6B \ --endpoint-type chat \ --streaming \ --url localhost:8000 \ --synthetic-input-tokens-mean 128 \ --synthetic-input-tokens-stddev 0 \ --output-tokens-mean 128 \ --output-tokens-stddev 0 \ --extra-inputs min_tokens:128 \ --extra-inputs ignore_eos:true
这里有几个标志的作用比看上去更大:
--synthetic-input-tokens-stddev 0 和 --output-tokens-stddev 0 将工作负载固定为每个请求恰好包含 128 个输入 token 和 128 个输出 token。这复现了一种常用的静态基准测试,其中请求长度和输出长度均保持不变。
--extra-inputs min_tokens:128 和 --extra-inputs ignore_eos:true 会让模型实际生成 128 个 token,而不是提前停止。没有这些标志,输出 token 数量只是一项建议值。模型会在自然完成时停止,实际数量可能远低于目标 OSL。这样得到的吞吐量数值会低于应有水平,而且无法在多次运行之间复现。
如果要测量 TTFT 和 ITL,--streaming 必不可少。如果不使用流式传输,服务器会先汇集完整响应再发送,因此没有可供测量的首个 token 事件或解码 token 事件。
你将看到什么
原文图 1:AIPerf 实时仪表板用户界面的动画示例。实时仪表板会显示运行进度、各项指标及其分布列表,以及来自 AIPerf 后端的实时事件日志。
下一节将介绍如何解读这些数值。现在先留意下方原文图 2 中的输出结构:按百分位细分的延迟、以每秒 token 数表示的吞吐量,以及请求级统计数据,全都集中呈现。这就是后续比较其他结果时使用的基线。
原文图 2:AIPerf 一次运行结束时的输出指标截图示例,其中包含多种不同指标的有效指标、活动指标和汇总统计,以及便于快速查看的百分位细分、复现命令行和输出位置。
解读数值:AIPerf 呈现哪些指标
一次运行完成后,AIPerf 会在控制台中输出指标表,并将完整结果写入 CSV 和 JSON。下面介绍表中的内容。
四项核心指标:
- TTFT(Time to First Token,首个 token 时间)——从发送请求到收到首个 token 所用的时间。这是交互式用例的主要延迟信号。
- ITL(Inter-Token Latency,token 间延迟)——生成过程中相邻 token 之间的时间。即使 TTFT 表现正常,ITL 较高也意味着解码阶段难以承受负载。
- Request Latency(请求延迟)——获得完整响应的端到端时间。它将预填充和解码开销合并为一个数值。
- Output Token Throughput(输出 token 吞吐量)——所有并发请求每秒生成的 token 数。这是容量规划的主要吞吐量信号。
有关这些指标以及 AIPerf 所报告其他所有指标的完整定义,请参阅指标参考。
了解全貌。 上述各项指标均按百分位(p25、p50、p75、p90、p95、p99)报告,同时提供最小值、最大值、平均值和标准差。这些细分数据很重要,因为它们能够揭示长尾分布:一台服务器即使平均 TTFT 正常,但 p99 异常偏高,汇总结果看起来可能没有问题,到了生产环境却会失败。
不止四项核心指标。 如果可以使用 DCGM 或 pynvml,AIPerf 还会将 GPU 功耗、利用率和内存消耗纳入同一次运行的输出。要把延迟激增与内存压力事件关联起来,无须另行执行性能分析,因为遥测数据已经包含在内。
进一步探索:配置流量模式
通过静态基准测试初步上手后,我们可以开始探索更动态的场景。上一节采用了极为固定的流量模式,但真实推理流量并不遵循静态模式。为了采用不那么固定的场景进行基准测试,可以利用 AIPerf 的一些合成工作负载调节项,让请求产生变化。
aiperf profile \ --model Qwen/Qwen3-0.6B \ --endpoint-type chat \ --streaming \ --url localhost:8000 \ --request-rate 10 \ --arrival-pattern poisson \ --synthetic-input-tokens-mean 512 \ --synthetic-input-tokens-stddev 128 \ --output-tokens-mean 128 \ --output-tokens-stddev 32 \ --random-seed 42 \ --request-count 200
与上面的静态基准测试相比,这里有几处变化。
--arrival-pattern poisson 与 --request-rate 10 搭配使用,表示请求以平均每秒 10 个的速率到达,到达间隔则从指数分布中抽取。此时服务器经历的是突发和间歇,而不是单一用户请求流;这更符合真实流量下的实际排队情形。
--synthetic-input-tokens-stddev 128 会围绕 512 token 的平均值引入方差,从而生成长短混合的提示。服务器必须在预填充阶段处理不同的提示长度,而不再是完全相同的长度。
--output-tokens-stddev 32 在输出端增加了方差。请注意,这条命令中已不再包含 min_tokens 和 ignore_eos。在静态基准测试中,这些标志将输出固定为恰好 128 个 token,以保持基线清晰;这里则有意解除这一限制,让输出分布可以变化。
--random-seed 42 使 Poisson 时序和合成长度抽样可以复现。重新运行这条命令会生成相同的请求序列。
--streaming 必不可少。如果不使用流式传输,服务器会先汇集完整响应再发送,因此没有可供测量的首个 token 事件或解码 token 事件。
观察此次运行的 LLM 指标,可以看到其分布明显宽于静态基线。这符合预期,因为有更多请求同时争用 GPU,而且每个请求的预填充长度也各不相同。
原文图 3:Poisson 到达模式运行的汇总统计截图示例。由于采用了新的流量模式,统计数据的分布与 512/128 静态场景存在显著差异。
观察下方原文图 4 中的图表可以看到,Poisson 命令行产生的请求速率以每秒 10 个请求为中心,但并不与其完全一致。与保证固定每秒 10 个请求的恒定模式相比,这种到达速率模拟了请求抵达时间的抖动。
原文图 4:从首次发送请求起计的延迟,与恒定每秒 10 个请求的模式进行比较,显示发送时序围绕指定请求速率变化。
从下方原文图 5 可以看到,请求长度围绕 512 token 的平均值变化,输入序列长度范围为 154 至 818 token。
原文图 5:直方图显示输入(请求)长度的分布以所要求的平均 512 token 为中心。
比较两次运行的 TTFT,可以看到 Poisson 运行的分布范围宽得多。更多请求会同时争用 GPU,预填充长度不断变化,而且预填充与解码操作彼此重叠。单并发场景是一种理想化情况,每次只运行一个请求,以牺牲吞吐量为代价获得尽可能低的 TTFT。
原文图 6:直方图比较单个活跃用户与 Poisson 到达模式下 AIPerf 运行的首个 token 时间分布差异。
从上方原文图 6 可以看到,与 Poisson 实验中变化更大的工作负载相比,单用户运行的 TTFT 变化较小。
还有更多内容可供探索
本演练介绍了基础用法,但 AIPerf 也面向更复杂的场景构建。同一工具可以处理多节点 Kubernetes 部署、KV cache 重用的预热机制、生产流量轨迹重放、前缀合成、自定义数据集,以及跨并发级别的扫描配置。如果你要大规模运行分布式推理,请参阅 NVIDIA Dynamo 1.0 如何支持生产规模的多节点推理。
要快速上手,最佳途径是阅读 AIPerf 仓库中的教程。AIPerf 仓库和文档是了解新功能和参与贡献的权威参考。
致谢
AIPerf 是 NVIDIA 与外部贡献者协作完成的成果。感谢以下人员:Loki Ravi、Dan Ferguson 和 Sheng Moua(AWS)持续开展协作、跨公司验证,并推动以 AIPerf 为标准;Aaron Batilo(Coreweave)贡献了 Weights & Biases 导出器、推测解码接受长度数据集,并增强了并发情况下扫描和 credit-dispatch 的可靠性;Shounak Ray(Baseten)实现了高保真的 Baseten 轨迹重放支持;Michael Feil(Baseten)实现了更快的轨迹加载和会话亲和性标头;Cristian Lopez(Pinterest)密切协作开发 DAG 基准测试方法。我们也感谢 Ben Hamm 在 AIPerf 的设计、规划与实现期间提供产品指导。
原文: developer.nvidia.com · Benchmarking LLM Inference at Scale with AIPerf