给你的 Agent 建一套行为评测:从断言工具调用开始
- 更新时间 2026-09-20 10:13:31
引子:改了 prompt,输出更漂亮了,但它偷偷变笨了
有个团队做过一次"优化":把 Agent 的系统提示词重写了一遍,措辞更清楚,示例更规范。
上线后大家很满意——输出的确更好看了。
一周后有人偶然翻账单,发现单次任务的 token 消耗涨了 40%。再深挖才发现:重写 prompt 之后,Agent 开始多做一步"确认性检查",每次任务都要多调一次工具、多读一遍同一个文件。
这个过程,传统的文字匹配评测完全看不见。因为它只看最终输出——而输出是好的。
这就是 Agent 评测和传统评测最根本的区别:
Agent 的正确性藏在行为里,不在输出里。
今天这篇解决这个具体问题:怎么断言行为,以及测试集该怎么攒。20 行代码可以先跑起来。
原理层:为什么文字匹配不够用
文字匹配的三个死穴
假设我们这样写评测:
# 传统做法assert "订单已取消" in agent_output
看起来合理。但有三个问题:
| 抗扰动差 | |
| 看不见成本 | |
| 看不见手段的正确性 |
第三条最危险:结果对,手段错。文字匹配完全无法区分。
行为断言长什么样
行为断言判断的是 trace——这次任务里 Agent 做了什么:
# 行为断言assert agent.called_tools == ["query_order", "cancel_order"]assert len(agent.trace.steps) <= 5assert agent.trace.total_tokens <= 2000
对比一下:
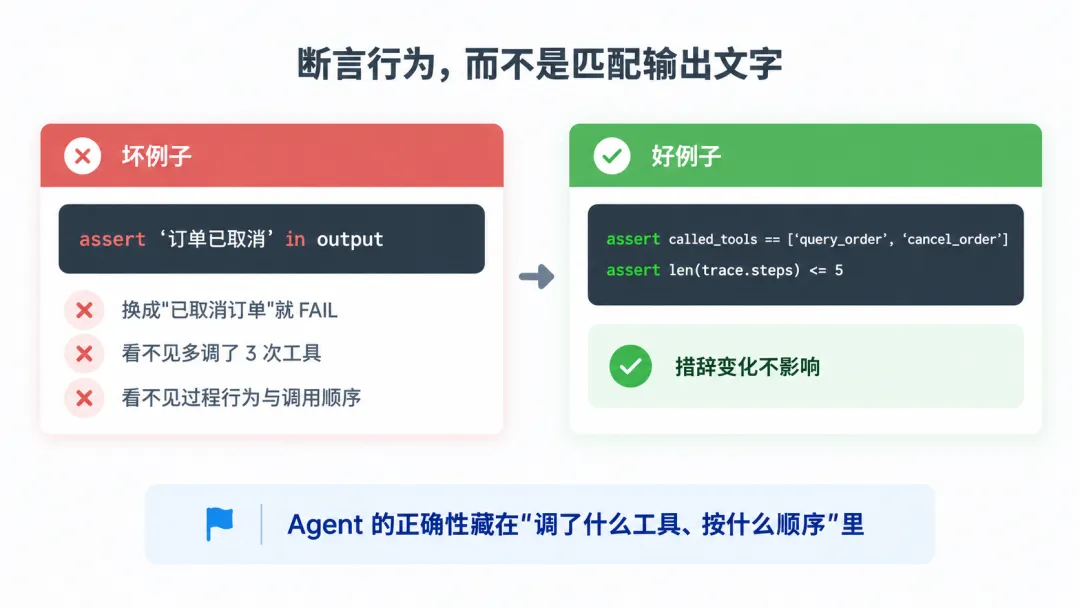
上图说明左边是文字匹配的三个失效场景;右边是行为断言——断言工具序列 + 步数上界,既能容忍措辞变化,又能卡住成本漂移。
Google 在 2026 年 9 月提出的 Harness Engineering 方法论,核心主张就是这个:把 prompt、tools、policies、evals 当作生产软件来管理,评测要用行为断言(behavioral assertions),而不是文字匹配。
实现层:20 行最小评测脚本
下面这段代码可以直接跑。思路是:把 Agent 的每次工具调用记录成 trace,然后对 trace 做断言。
"""最小行为评测器 —— 断言工具调用,而不是输出文字"""from dataclasses import dataclass, field@dataclassclass Trace: """记录一次 Agent 任务的完整行为""" tool_calls: list = field(default_factory=list) total_tokens: int = 0 def call(self, tool: str, **kwargs): """供 Agent 调用工具时登记""" self.tool_calls.append(tool) self.total_tokens += kwargs.get("tokens", 0)def evaluate(trace: Trace, expect_tools: list, max_tokens: int = 2000, ordered: bool = True) -> dict: """核心断言逻辑:工具是否被正确调用""" if ordered: tools_ok = trace.tool_calls == expect_tools else: # 不关心顺序时,允许额外冗余调用(但要有上界) expect_set = set(expect_tools) tools_ok = expect_set.issubset(set(trace.tool_calls)) tokens_ok = trace.total_tokens <= max_tokens return { "pass": tools_ok and tokens_ok, "tools": "✅" if tools_ok else f"❌ 实际 {trace.tool_calls} ≠ 期望 {expect_tools}", "tokens": "✅" if tokens_ok else f"❌ {trace.total_tokens} > {max_tokens}", }
用法演示:
# Arrange:模拟一次 Agent 任务trace = Trace()trace.call("query_order", tokens=300)trace.call("cancel_order", tokens=250)# Act:断言result = evaluate(trace, expect_tools=["query_order", "cancel_order"], max_tokens=2000)# Assertprint(result)# {'pass': True, 'tools': '✅', 'tokens': '✅'}
这段代码虽然短,但包含了行为评测的全部核心:
1. Trace 记录行为(而不是记录输出)
2. ordered 参数控制是否关心顺序
3. 同时断言工具序列和 token 上界
顺序敏感 vs 顺序无关
ordered 这个开关怎么选,是行为断言最需要判断力的地方:
| ordered=True | ||
| ordered=False |
顺序敏感更严格,但也更容易产生假阴性(Agent 用另一种同样合理的顺序解决了问题,却被判 FAIL)。
经验:核心业务路径用顺序敏感,信息收集类用顺序无关,但都要配 token 上界。
数据层:测试集怎么攒
有了断言引擎,下一个问题是用例从哪来。
这是绝大多数团队翻车的地方——他们的第一反应是"造 500 个测试用例",结果做出来的东西完全没用。
别用人造题
人造题有个致命缺陷:出题的人知道答案。
这意味着人造题的分布天然偏移——你会不自觉地把题出成"你希望被测试的东西",而不是"Agent 真正会失败的地方"。
从真实失败日志里捞
正确做法是:翻你的线上日志 / 用户反馈 / bug 记录,把 Agent 真实翻过的车,攒成测试用例。
数量上,20-50 个就足够起步——多个来源都提到这个数量级。
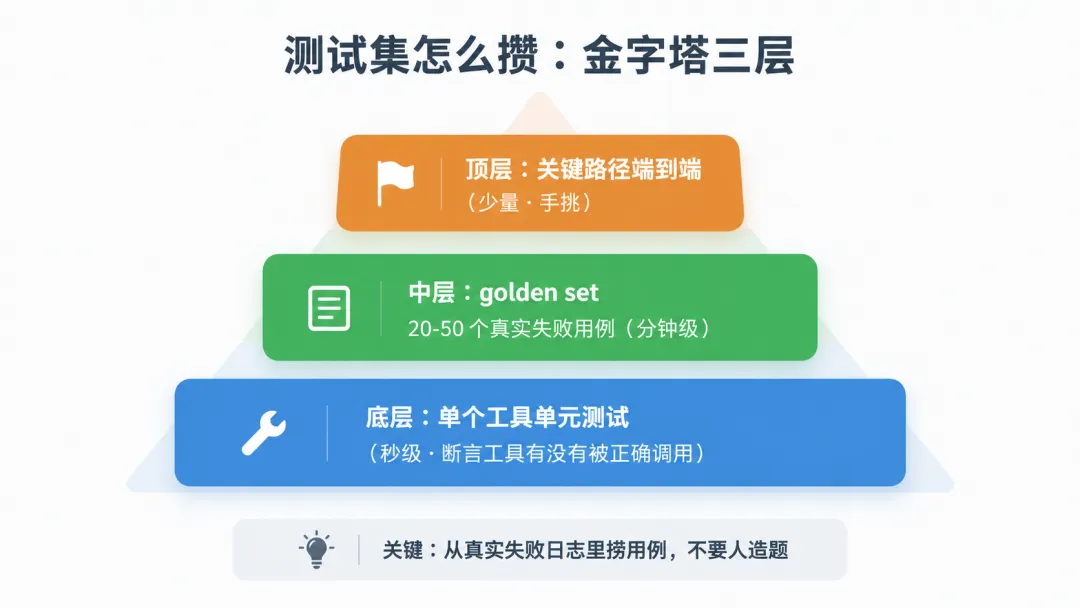
上图说明三层金字塔。底层是秒级的单工具单元测试,中层是 20-50 个真实失败用例组成的 golden set(分钟级),顶层是少量手挑的端到端关键路径。先从中层开始建,别一上来就想要 500 题。
每个用例记什么
一个有用的用例至少要包含三样东西:
## 用例:取消超时未支付的订单**输入**:用户说"帮我取消那个一直没付款的订单"**期望行为**(不是期望文字):- 必须调用 query_order 查订单状态- 必须调用 cancel_order- 步数 ≤ 4**关键约束**:- 如果该订单已支付,必须拒绝取消并提示用户- token 上界 3000
注意"期望行为"这一栏——写的是 Agent 应该做什么,不是它应该说什么。这是行为评测和传统评测的分水岭。
给 judge 留"不知道"选项
如果你的评测用了 LLM-as-a-judge(让模型给另一个模型的输出打分),必须给 judge 一个显式的"我不知道"选项。
原因很实在:如果 judge 只能在"通过"和"不通过"里选,遇到模糊情况它会随机猜一个。而随机猜,就有 50% 的概率猜对——这会让你的评测分数虚高。
给 judge 留退路,它才会在真不确定的时候老实说出来。
避坑层:三个高频坑
坑 1:断言写得太死
# ❌ 太死:连参数都写死assert trace.tool_calls[1] == {"name": "cancel_order", "args": {"id": "SO-20260913001"}}# ✅ 合理:断言结构和关键字段assert trace.tool_calls[1]["name"] == "cancel_order"assert trace.tool_calls[1]["args"].get("id") is not None
订单 ID 是运行时才知道的,写死只会让评测在每次数据变化时全红。
坑 2:只测 happy path
真实世界的 Agent 绝大部分问题出在边缘情况:
• 用户说了一半就走了
• 工具返回超时
• 查不到结果
如果你的用例全是正常流程,评测通过率一定会很高,但它什么都保护不了。
坑 3:一次想做全覆盖
先有 20 个能跑的用例,比有 500 个写不完的用例强得多。
先用 20 个真实失败用例跑通整个流程(断言 → CI → 修复 → 回归),再逐步扩充。流程不通,用例再多也是摆设。
落地层:trace 到底长什么样
最后补一张图,把"行为"这个概念具体化——这是接下来两篇的基础。
一次 Agent 任务会被记录成一个 trace,里面包含若干 span(每次模型调用、每次工具调用、每次检索都是一个 span):
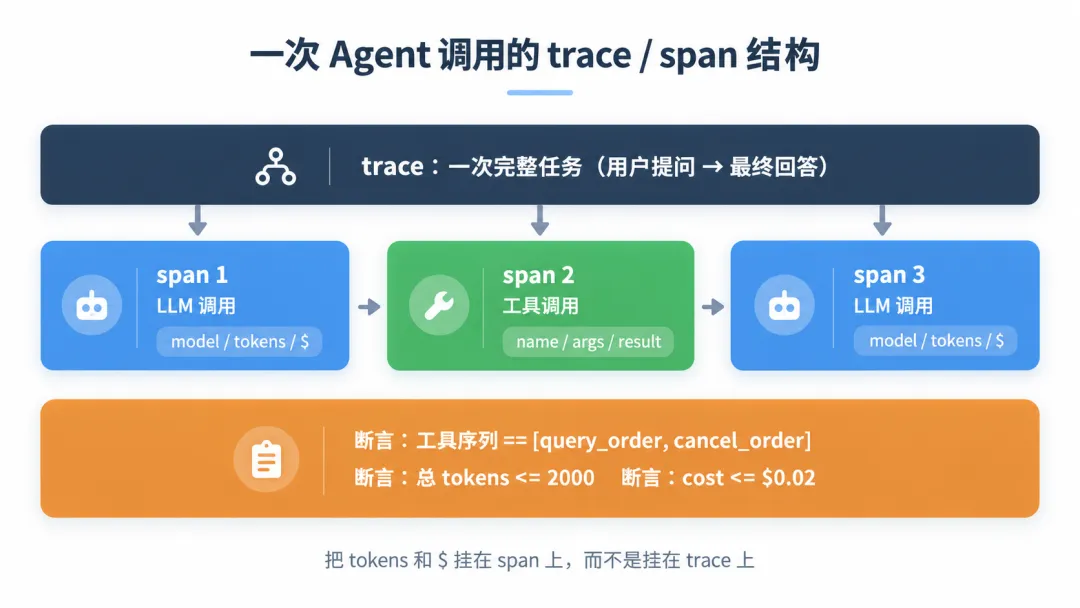
上图说明一个 trace 包含三个 span(LLM 调用 → 工具调用 → LLM 调用)。关键在于把 tokens 和 cost 挂在 span 上,而不是挂在 trace 上——只有这样你才知道钱具体花在哪一步。这一点下一篇会展开。
收尾:有了断言,还得看得见过程
到这一篇,你已经能:
1. 写出不断调优提示词就 FAIL 的行为断言
2. 从真实失败日志里攒出 20-50 个有效用例
3. 知道 Avoid 断言太死、只测 happy path、一次求全覆盖这三个坑
但有个前提问题还没解决:你怎么拿到 trace?
现在的 Agent 一次任务可能调几十次工具、几万 tokens。如果账单翻了三倍,你必须在 span 级别看清是哪一步花的——而不是只知道总数。
下一篇讲这个:Agent 可观测性,包括 trace/span 怎么设计、怎么把 token 和钱挂到 span 上,以及 Netflix 实测过的四条真能省钱的路径(其中一条什么都不剪,只重排 prompt 就能省 30-50%)。
觉得有帮助?,请转给正在学习Agent的朋友吧
下一篇:Agent 可观测性:几十次工具调用,怎么看清钱花在哪
系列导航:
Agent实战系列 → DeepSeek Harness实战 → Agent协议层系列 → RAG 实战系列 → Coding Agent 实战系列→Agenet Skill 系列→Agent评测系列(更新中)
