AI 的输出到底好不好、能不能放心上线?
现实往往是——每个团队各写一套评测脚本,标准各说各话,数据集散落在各仓库,执行记录无法追溯,没人说得清是 AI 退化了还是评测规则不一致导致的。AI 的质量,成了一件谁都在做、却谁都量不准的事。
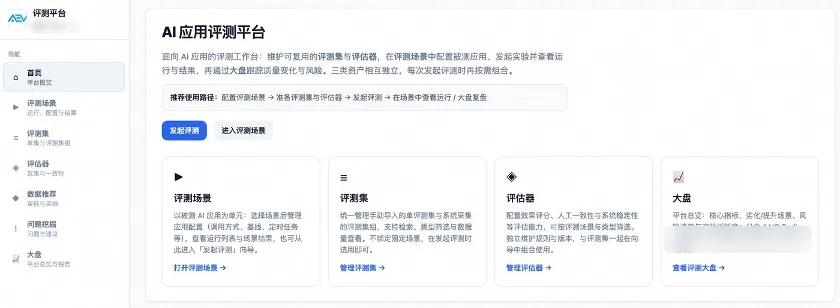
我们为此做了一套 AI 评测平台:统一评测抽象(实验/数据集/评估器/任务)、多种执行方式兼容、一致性与置信度评估、黄金集校准,目前支撑 4 大类 155 个评测场景、4 种评估器类型。相比通用评测工具,我们有两点差异:①除了给分,还用一致性(场景稳不稳)+ 置信度(评委稳不稳)给分数附上可信度,让它更真实地反映实际效果;②用可插拔架构灵活承接多种评测场景与方式,支持不同业务定制需求,更贴近业务场景。
这篇文章讲两件事:我们对"怎么把 AI 评明白"的思考,以及这套平台真正能提供的能力、能解决的问题。如果你也在为"AI 输出可信不可信"发愁,或者还在用临时脚本做评测,希望它能帮你少走些弯路。
1.1 问题与挑战
每个 AI 应用上线前,都躲不开一个最朴素的问题:这个 agent / skill / 知识库到底够不够好、能不能放心上线?
而现实是——这个问题往往没人答得上来。
传统软件有明确的对错:接口返回 200 就是对,用例跑通就是过。AI 不一样,它的输出是开放的、同样的输入每次结果还可能不同,"好不好"本身就没有一把现成的尺子。于是很多团队的评测长期卡在"写个脚本、跑一组 case、凭感觉看个分"的状态——"这版能不能上线"这个问题,无人能给出确切回答。
而盲目上线的代价是实打实的:一个悄悄退化的知识库,会让所有照着它查资料的人拿到过期甚至错误的信息;一个没评准就放行的生码 agent,可能把错误结果源源不断灌进线上生产环境。说白了,AI 的质量问题今天普遍难以精准量化和把控。
规模侧的四堵墙。更麻烦的是,评测需求从来不止一个场景。当知识库质量、代码生成、数据构造、推荐质量、知识召回、需求问题发掘等场景陆续都要评,你几乎必然会撞上这几堵墙:
•评估器重复造轮子:每个新场景都从零写一遍评测完整逻辑,数据格式不统一、校准方法各异、分数标准各自定义,无法拉齐对比,也做不到场景维度的持续观测。
•数据集管理失控:评测数据散落在各处的 Excel/JSON/YAML 里,版本混乱,没人说得清"最新的评测集在哪个分支的哪个目录"。
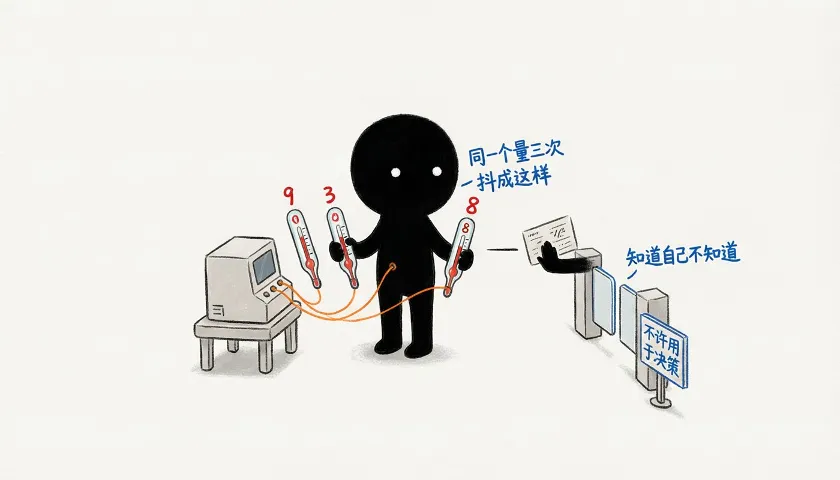
•稳定性没人管:一次评测得了 8.5 分,看着挺好;再跑一次变 6.2 分,是 Skill 退化了还是评委不稳定?没人知道。
•结果驱动不了决策:评测报告没有结构化数据,无法量化指标从而决定是否可以上线。
本质上的三个难题。除了规模,AI 评测还有三个传统软件测试从没遇到过的本质难题:
•挑战一:非确定性。同一个 Prompt、同一份数据,AI 每次跑出来可能都不一样。在知识库评测里,我们让 LLM 从文档中提取方法签名再与源码比对,但它每次提取的条目数都在变——这次 3 个,下次 8 个。这不是 bug,是 LLM 的天性。如果平台不会多轮执行 + 统计分析,单次分数就跟掷骰子没区别。
•挑战二:黑盒化的行为漂移。模型升级、Prompt 微调、上游 API 变更,都可能让 AI 的行为悄悄跑偏。最阴险的是那种"局部恶化、总分没动"的漂移:某一类如果被系统性误判,由于它在全量里占比不高,总分几乎看不出变化,肉眼根本发现不了。没有定时巡检和分层评测,这种局部退化可能一直无法被及时和精准地发现。
•挑战三:评估器本身的不确定性——"谁来评测评测者?"当我们用 LLM 去评 LLM 时,评委自己也会有偏差、也会退化。这也是全篇的靶心:你用同一类工具去评判同一类工具的输出,可信度到底从哪来?
人工审查兜不住。那靠人工审查行不行?不是人不认真,而是这类活儿本身就超出了人的能力边界。
拿知识库评测举例:一个业务域动辄 200+ 个节点,每个节点 5-15 个方法签名,加起来是数千个"文档说法 vs 源码实现"的比对点。让人逐页读、逐个核,读到后面注意力必然衰减——抽查几十个还行,全量比对几千个,人脑天然做不到。把人工审查和平台评测放在一起对比,差距一目了然:
痛点 | 手动审查 | 平台评测 |
单域审查耗时 | 数天 | 20min |
可覆盖节点数 | 只能抽样 | 全量 200+ 个 |
方法签名比对 | 肉眼 | LLM + 源码比对 |
跨域一致性 | 无法保证 | 统一评分标准 |
可重复性 | 依赖审查人经验 | 100% 可重复 |
问题的本质是:AI 质量问题有个特征——"量大且隐蔽"。每个错误单看都不严重,但攒起来足以让整个知识库丧失使用价值。人工审查天然无法支持,而这恰恰是自动化评测最擅长、也最不该靠人肉去做的领域。
1.2 调研:业界怎么解这些问题
动手建平台之前,我们把业界公开的材料过了一遍:头部厂商的方法论指引、针对 LLM 评委的学术研究、主流开源评测框架。结论一句话:业界对"怎么评"已经有了相当共识,但现有工具承接不了"一个组织内的持续评测"——而后者正是我们要补的位。
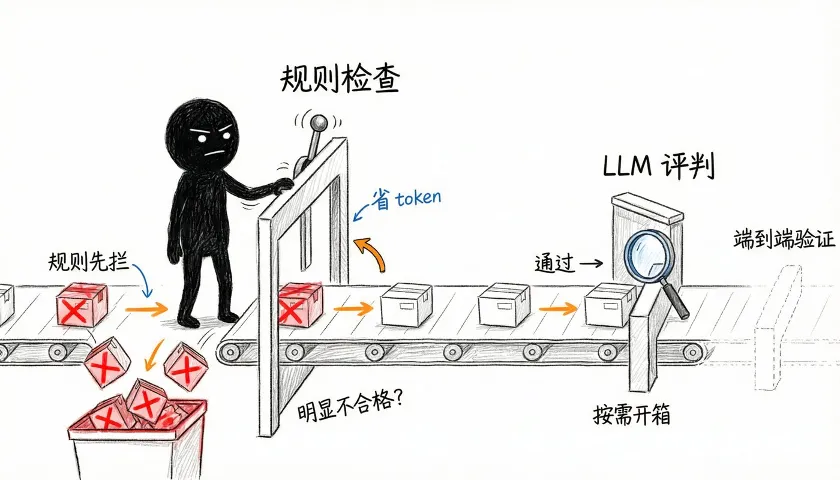
方法论共识:头部厂商怎么评。 Anthropic 在《Demystifying evals for AI agents》里给出的观点很有代表性:评测应该是代码类、模型类、人工三类「Grader」的组合,优先用确定性检查,人工评审留给有限样本的验证;对 LLM 评委,他们明确要求用人类专家校准、Rubric 写清楚、评分维度拆开、证据不足时允许输出"Unknown"。在数据集上,他们建议从"20-50 个来自真实失败的简单任务"起步,把 bug 和用户支持工单转化成测试用例。对非确定性,他们给出 pass@k(k 次里至少一次成功)和 pass^k(k 次全部成功)两种度量,对一致性敏感的产品应盯后者。他们还把评测集分成两类:能力集的初始通过率就该低,用来指明改进方向;回归集要保持高通过率,防止能力倒退。OpenAI 也在《Testing Agent Skills Systematically with Evals》里表达了同一件事:用 evals 对 agent 的每项技能做系统性测试。
也就是说,方法论层面业界已经收敛:评测是一套确定性检查 + 模型打分 + 人工校准的工程组合,远不止"找个模型打个分";数据要来自真实 bad case;评委需要校准。但方法论回答的是"一次评测怎么做对",回答不了"一个组织怎么对几十种形态的 AI 应用持续做评测"——后者需要平台。
LLM 评委:有效性与风险并存。 LLM-as-a-Judge 到底靠不靠谱?Zheng 等人的 MT-Bench / Chatbot Arena 研究同时给出了两个答案。好消息是:GPT-4 作为评委与人类偏好的判断一致率超过 80%,与人与人之间的一致率相当——评委确实可用。坏消息是:同一项研究系统性地识别出评委的位置偏差、冗长偏差、自我增强偏差,以及数学/推理题上的判分失灵——评委不能无条件信任。
这个结论是我们置信度设计的直接出发点:既然业界最好的研究已经证明"评委有偏差、会抖动",平台要做的就不是回避评委,而是把评委的行为量化、约束住。具体怎么做,第 3 章展开。
开源评测框架:解决了什么、没解决什么。市面上开源工具已经不少,几个有代表性的:OpenAI Evals 是 OpenAI 开源的评测框架,配置 + 数据集驱动,支持自定义评分器,覆盖多轮对话与工具调用场景;promptfoo 主打 CLI/YAML 方式的 prompt 对比与断言检查,附带红队测试;Ragas 专注 RAG 链路评测,内置忠实度、上下文召回等指标;DeepEval 提供单元测试风格的 LLM 评测断言。此外还有一些商业 SaaS 评测平台,就我们所见,大多把评测与开发调试、可观测能力打包在一起。
这些工具的共性很明确:面向开发者,围绕"我自己的项目里跑一轮评测",足够轻。但对照 1.1 的四堵墙,缺口同样明确:数据集管理基本是轻量的文件加载,没有版本与分组;评估器形态以固定断言/规则模板为主,承接不了要克隆仓库、多步推理的复杂评测逻辑;评委的置信度基本没有量化手段;定时巡检、变更触发、跨实验对比这类"持续运营"能力大多缺位。对内部业务来说,数据合规与私有化部署也是硬约束,外部 SaaS 不在可选项里。
对照与差异化。把业界做法和我们的选择并排放在一起:
维度 | 业界常见做法 | 我们的做法 |
评测对象覆盖 | 多为 prompt / 模型 / RAG 链路的单点评测 | 生码、agent、知识库、skill 四大类被测对象可插拔接入 |
评委可信度 | 识别偏差、建议校准(方法论层面) | 置信度量化评委抖动、剔除离群分,人工评估器作为校准基准 |
非确定性 | pass@k / pass^k 的抽样度量思路 | 多轮执行,一致性(被测侧)与置信度(评委侧)分开度量 |
数据资产 | 轻量的数据集加载 | 统一数据集服务 + 数据集组 + 黄金集 + 推荐采纳闭环 |
运行方式 | 多为手动触发、一次性评测 | 手动 / 定时 / 变更三种触发,持续巡检 |
结果消费 | 停在分数与报告 | 结构化问题清单 + 严重度分级 + 采纳/拒绝处置闭环 |
压缩成一句话,就是引言里的那两点差异:①除了给分,还给分数附上可信度;②用可插拔架构承接千差万别的评测场景与方式。
调研到这里,要补的位已经清楚了:业界不缺"一次评测怎么做对"的方法论,缺的是让评测在一个组织里持续跑下去、让分数敢被拿去决策的工程载体。评委的抖动、数据的散乱、评测的一次性、结果的不可消费——这些缺口,正是这套平台每一个设计决策的出发点。
1.3 我们的核心理念
基于这些压力和挑战,我们把评测平台定位成「AI 质量基础设施」。评测如果只是一次性验收,那跟做完体检把报告扔进抽屉一样——毫无意义。它必须是嵌进研发流程、持续运行的质量保障。
平台不服务于某一个评测场景,而是支撑所有 AI 应用评测需求的通用引擎——统一评分口径、沉淀数据资产、让 AI 质量可被持续追踪,而不是上线前临时抱佛脚。
架构设计只服务一个目的:让平台承接得住"所有评测场景"而不被压垮。第 1 章的挑战摆在那里——场景形态千差万别,生码要评生成代码的质量,知识库要做文档与源码的交叉比对,agent 评测要实时调用被测对象;如果每接一个场景就写一条专属流水线,那就又回到了"重复造轮子"。我们的答案有两个:先定义领域无关的核心抽象,再把评测执行与分析拆成两条独立的任务链路。
2.1 四大核心抽象
平台设计的第一个决策,也是最重要的一个,是定核心领域模型。这些抽象得足够通用,能覆盖所有评测场景;又得足够具体,能提供真正的流程自动化。
分析了一圈评测场景后,我们提炼出四个领域无关的核心实体:
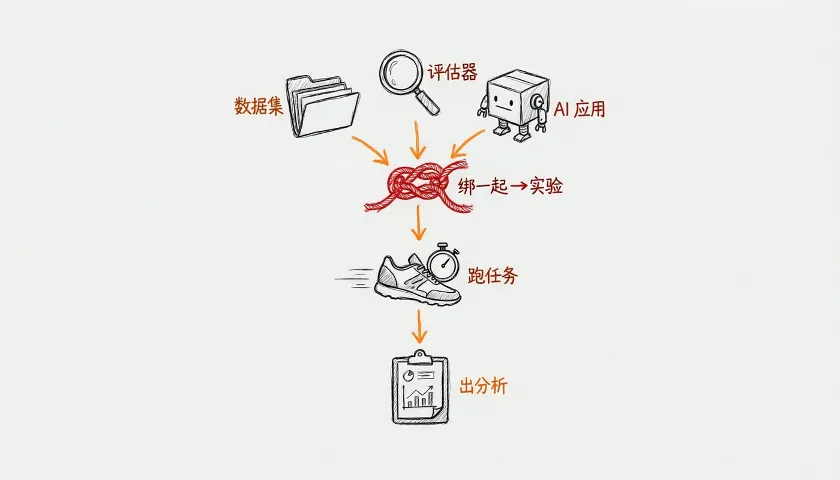
为什么偏偏是这四个?看遍所有场景后我们发现,无论评的是知识库、代码、推荐结果还是视频,评测流程都能归成一句话:拿一组数据,用某种方式评判 AI 的输出。数据集定义"拿什么数据",评估器定义"怎么评判",AI 应用定义"评谁",实验把三者绑一起,任务负责跑。
设计要点:
•核心引擎完全不知道被评的是什么。 Experiment、Dataset、Evaluator、EvalTask 这些实体不关心你评的是知识库文档还是生成代码。领域特定的逻辑全部通过评估器类型和场景模块注入。这意味着新增一个评测场景时,核心引擎的代码量增长是零。
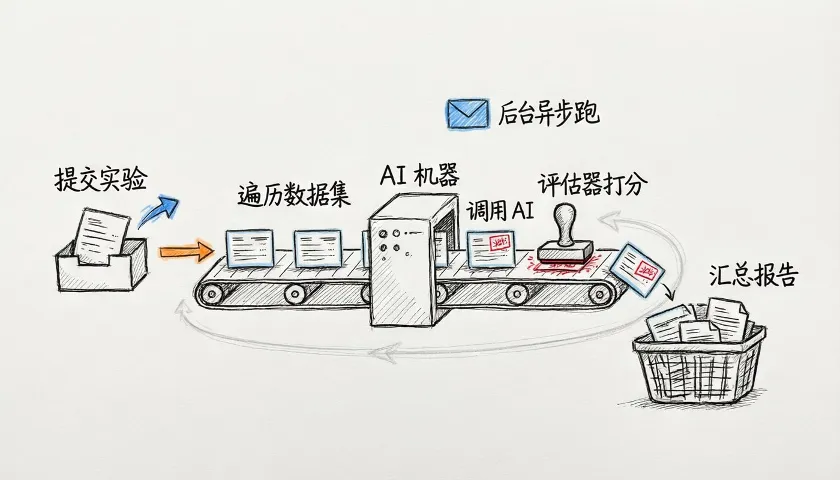
•评测与分析拆成两个独立的异步任务——EvalTask 负责跑评测,AnalysisTask 负责跨实验对比、置信度计算等较重的聚合分析。二者分离,避免重分析阻塞评测回调导致超时;评测和分析是两个独立的关注点,不应合并。
2.2 系统架构总览
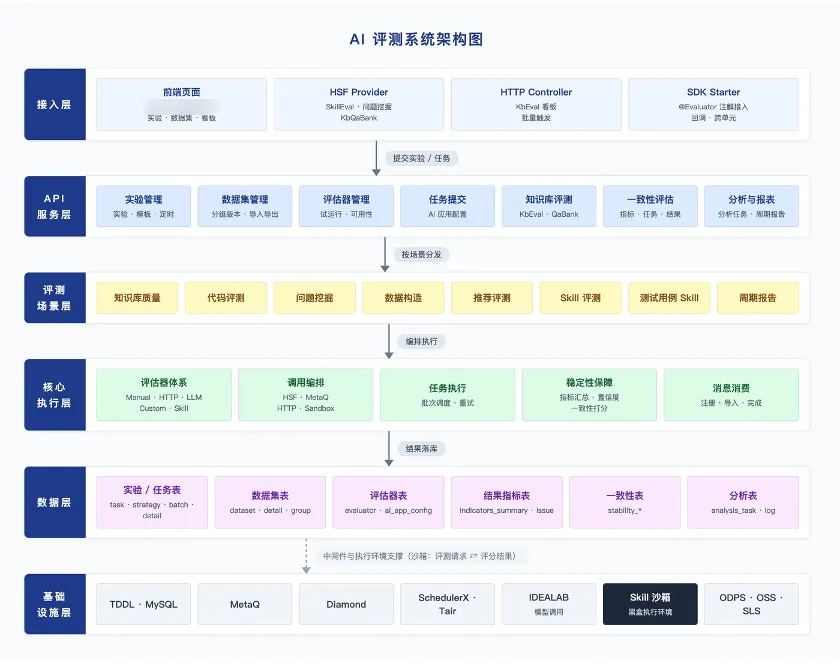
评测系统整体分为平台调度层和评测执行层两部分。
平台调度层(评测调度应用)负责"评什么、何时评、结果怎么管":task-provider 承接前端 REST/HSF、SchedulerX 定时和 SDK 接入的评测请求;task-biz 是编排核心,负责实验/数据集/评估器管理、评估器工厂分发、结果聚合与置信度计算;task-infrastructure 负责任务/结果落库和报告落 OSS。
评测执行层按被测对象分两条通道:
•同步通道: agent 类场景直接通过 HSF/HTTP 调用被测 AI 应用拿输出,由 LLM 评委打分后返回平台;
•异步沙箱通道:生码/知识库/skill 类场景由 MetaQ 派发,eval-scenario 场景消费后拉起 Skill 沙箱执行评测(评测逻辑对平台是黑盒),完成后 HTTP 回调平台聚合落库。
2.3 评测场景
平台上的 155 个评测场景,按被测对象归属 4 大类,每类由 eval-scenario 下可插拔的场景模块承接:
场景大类 | 评什么 | 已落地示例(场景模块) |
生码(CODE_GENERATION) | AI 生成代码的质量 | aaic 生码评测 |
LLM(被测对象为 agent) | 同步调用被测 agent,评其输出质量 | idealab 答疑 agent 评测 |
知识库质量(KB_QUALITY) | 知识库文档与源码交叉比对 | aaic 知识库评测 |
Skill(SKILL) | Skill 执行质量 | 数据构造 skill 评测 |
这正是"可插拔"的落地形态:新接入一类场景,增加一个场景模块即可,核心引擎不动,其他场景不受影响。
评估器是平台最核心的组件——它回答的是评测里最根本的那个问题:"怎么判断 AI 输出的好坏?"第 1 章提过与评估器相关的两个挑战:一边是评判方式千差万别,有的场景要调外部分数服务,有的要跑自定义评分代码,有的得克隆仓库逐行读源码,单一形态的评估器不可能全接住;另一边是 LLM 评委本身不靠谱,MT-Bench 已经证明偏差与抖动真实存在。这一章就是我们给这两个问题的答案。
3.1 评判方式千差万别→四种可插拔评估器
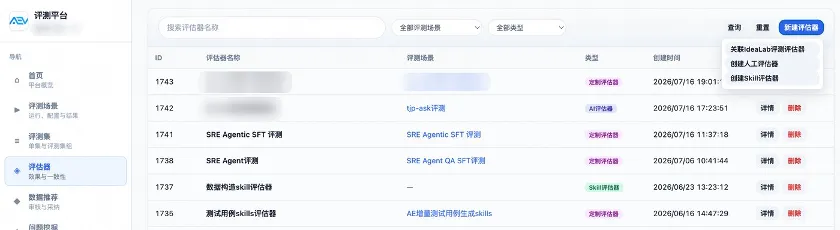
评估器管理页——定制 / HTTP / SKILL / 人工多种类型的评估器
平台提供了从轻到重、从通用到专用的 4 种评估器:
类型 | 机制 | 适用场景 | 成本 | 注册方式 |
MANUAL(人工) | 人工在 UI 上逐条打分 | 主观质量评审、新场景冷启动、LLM 评估器校准 | 最高 | 平台 UI 配置 |
CUSTOM(自定义) | 开发者通过 SDK 注册自定义评估逻辑 | 有明确评分算法/代码的场景 | 低 | @Evaluator注解自动注册 |
HTTP(外部服务) | 调用外部 HTTP API 评分 | 已有第三方评分服务的场景 | 低 | 平台配置 URL |
SKILL(沙箱 Skill) | 在云沙箱中运行 Claude Code Skill | 复杂评测(仓库克隆、多步推理等) | 高 | Diamond 配置 Skill 名 + 版本 |
•MANUAL(人工):在平台 UI 上逐条打分,总分由各子维度得分按权重加权得出。用于主观质量评审、新场景冷启动,也是校准 LLM 评委的基准。
•CUSTOM(自定义):评分逻辑写在团队自己的应用里,加上 @Evaluator 注解,SDK 自动把它注册成 HSF 服务,平台远程调用取分——代码不用迁、数据不用出应用。
•HTTP(外部服务):已有打分服务的团队最轻的接入方式——在 UI 上配好服务地址、请求模板(支持 ${input} 等占位符)和响应取分路径即可,不用写一行代码。
•SKILL(沙箱):四种里最重的一种——在云沙箱里跑一个完整的评测 Agent,适合"一次 HTTP 调用扛不住"的复杂评测。以知识库评测为例:要克隆多个 Git 仓库、按清单逐节点读文档和源码、交叉比对后聚合打分——知识库、生码等重场景都跑在它上面。
四种评估器在实验里地位对等、可以组合——同一个实验可以同时挂多个评估器,各评一个维度,再按总分公式加权汇总(见第 5 章)。新增一种评判方式,只是多注册一个评估器,评测流程本身一行不改。这是我们对"评估器重复造轮子"的直接回应。
3.2 评委不靠谱→置信度
用 LLM 评 AI,最大的风险是"评委自己不靠谱"——它会抖(同一份输出两次打分不同),也会偏(受长度、措辞等因素影响)。1.2 调研里提过,MT-Bench / Chatbot Arena 的研究对 LLM 评委的系统性偏差早有总结:
偏差 | 表现 |
位置偏差(position bias) | 成对比较时,评委系统性偏爱排在前面的答案——把两个答案调换顺序,判决会翻转 |
冗长偏差(verbosity bias) | 偏爱更长的回答。论文做过"重复列表攻击":往答案里塞重复内容拉长篇幅,多数评委会给更高分 |
自我增强偏差(self-enhancement bias) | 评委倾向给自己/同族模型生成的答案打高分(论文注明此项证据有限,是观察到的倾向) |
数学/推理判分失灵 | 即使评委自己会做这道数学题,面对一个错误答案时仍可能被带偏、判它正确——裸判不可靠 |
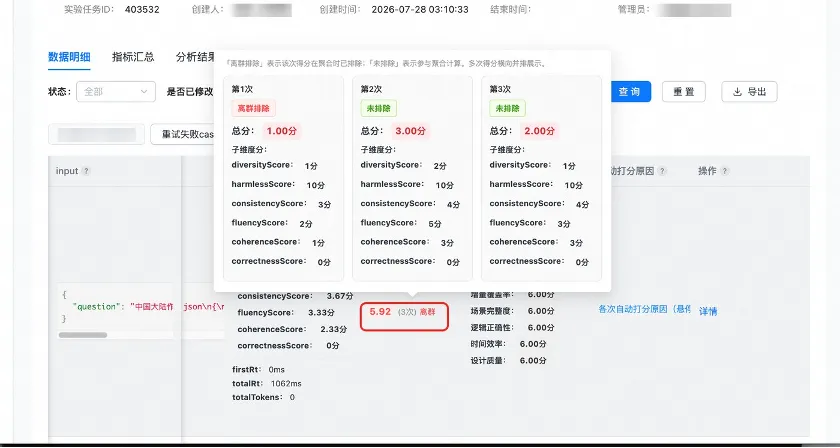
偏差躲不掉,那就把评委的"抖动"显性化。当一个实验的多轮执行全部完成,会触发 ConfidenceScoreCalculator 做一致性计算,用置信度公式暴露评委的抖动,并剔除单次"抽风"的离群分。
置信度看的是"波动本身",即基于全部成功打分的总体标准差计算,公式:
confidence = max(0, 10 − stdDev × 5)
而分数应该排除不置信的分数,只挑出"与其余分数均值偏差最大"的那一条剔除,其余分数的平均分作为最终得分。
这个选择的逻辑很朴素:我们不追问"到底哪个分才对"(无法回答),只做一件保守的事——把最不合群的那条请出去,让剩下的达成一致。
这样一来,最终分数不被异常值拉偏,而置信度又诚实地暴露了"这组分数到底抖不抖"。置信度会和分数一起呈现在报告里:分数再高、置信度低,使用方一眼就能看到,自行决定采不采信、要不要人工复核。对照 1.2 的调研结论:业界在方法论层面呼吁"评委要校准",我们把它落成了一条可计算、可呈现的工程机制。
数据集回答评测的另一半——"拿什么考"。它对应第 1 章的两个痛点:数据集管理失控(数据散落、版本混乱),以及随之而来的隐患——评测基准本身失真,回归对比就失去了意义。我们的解法是把数据集管理收敛成统一服务,再给它配一条"生产→沉淀"的闭环。
4.1 统一数据集服务
平台把数据集管理收敛成统一服务,取代"各团队自己维护 Excel"的散乱状态:
多源导入:支持 Excel 文件上传;ODPS 数据表导入;系统数据同步。
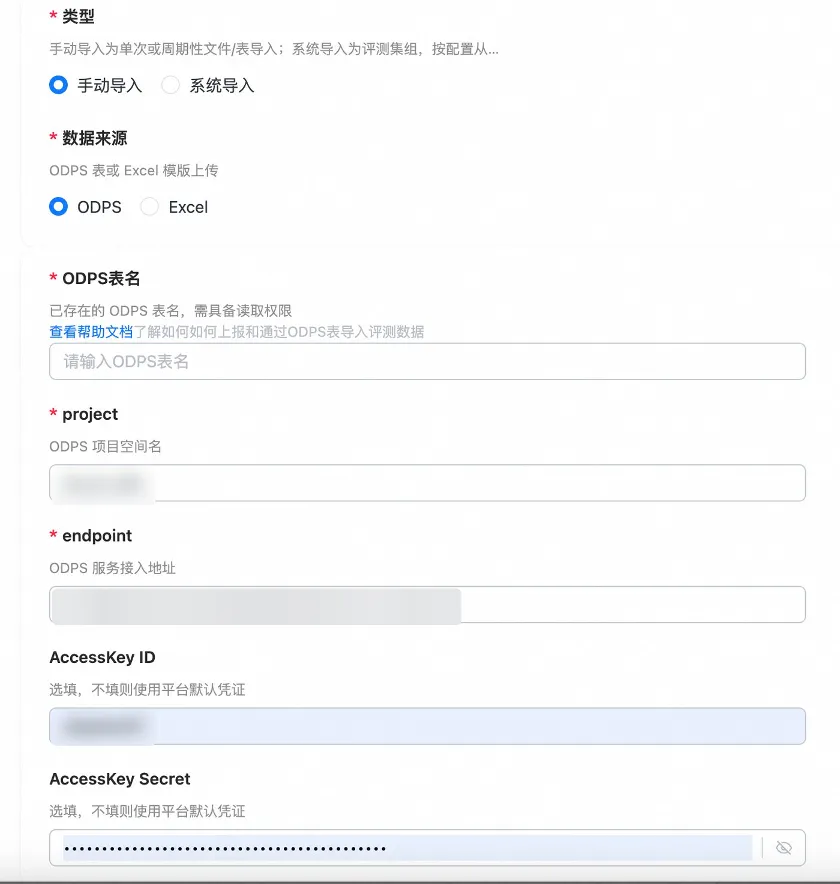
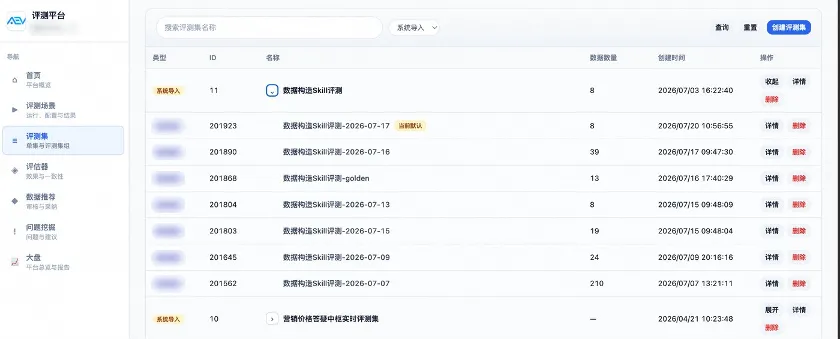
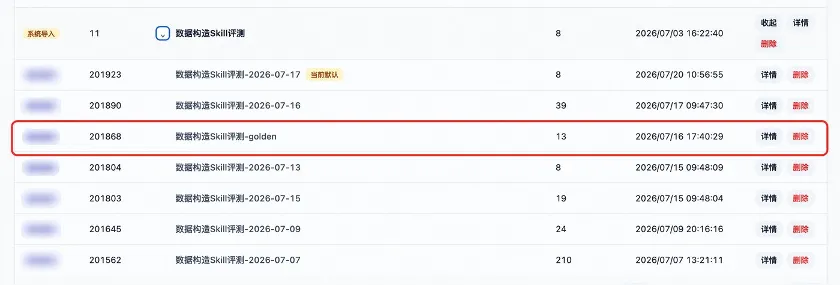
数据集管理:除了单个数据集管理,我们还引入了数据集组(Dataset Group)概念,实验可以绑定数据集组(而非单个数据集),两种绑定方式互斥;数据集组有一个 currentevaldataset_id 指针,指向当前使用的最新版本,每次实验运行时解析该指针,自动用最新版本数据;还可以维护不同维度的数据集(例如正常用例、异常用例、边界用例等),支持在绑定实验的时候绑定一个评测集组下的多个评测集。版本与分组的混乱,到此收敛成一个指针、一个组。
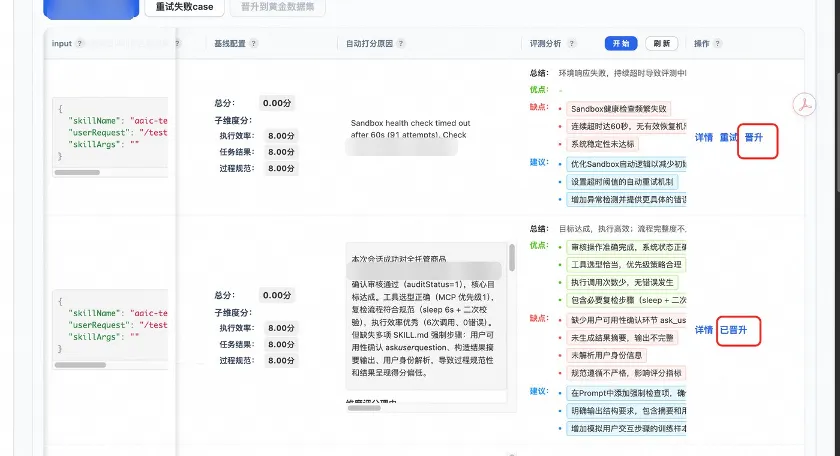
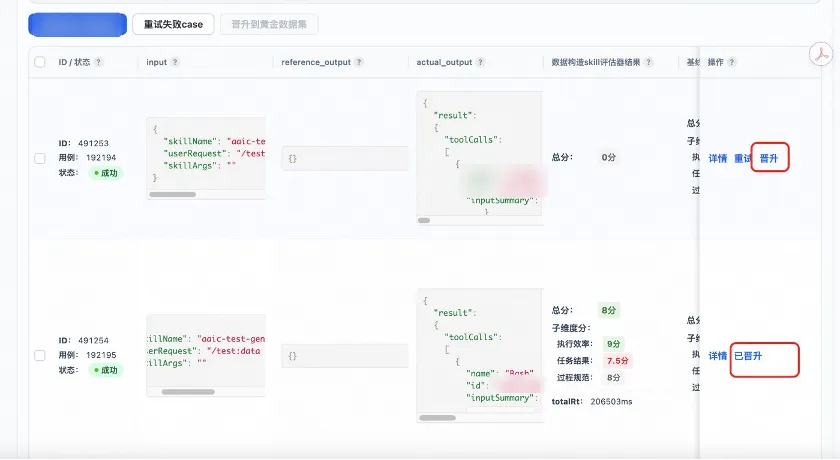
黄金数据集:生码、数据构造场景用它对比被测输出,持续追踪被测对象的能力是否稳定——基准要是歪的,稳定性判断就失真了。而且黄金集不是一次性建好的:平台支持把日常评测中表现典型的数据晋升为黄金数据集——晋升有权限校验,已晋升的数据会被标记出来。基准随着评测的积累越攒越厚,回归也就越跑越准。
4.2 数据推荐与采纳
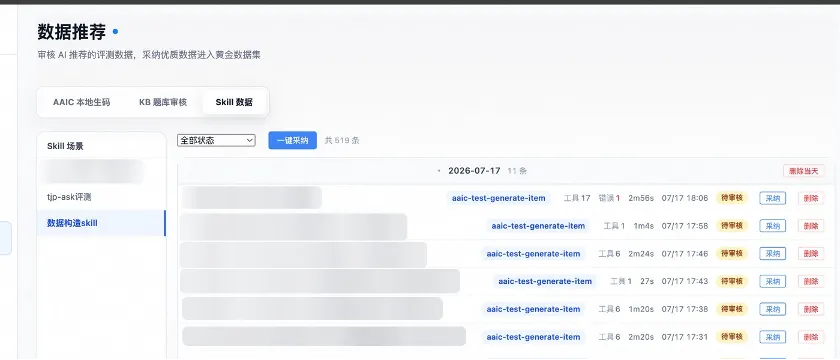
除了导入和晋升,数据集还有第三条来路——平台的独立功能「数据推荐与采纳」。数据构造等场景批量产出的候选数据,先经过清洗和打分,再进入推荐列表;已打分的条目可人工采纳——使用方逐条查看、采纳后,条目自动写入按场景归组的黄金数据集。数据的生产→清洗→打分→采纳→沉淀为基准,在平台内形成闭环。它解决的是"基准积累慢"的问题:黄金集不必等一次性的人工整理,日常评测里产出的高质量数据,能顺着这条链路持续流进基准库。
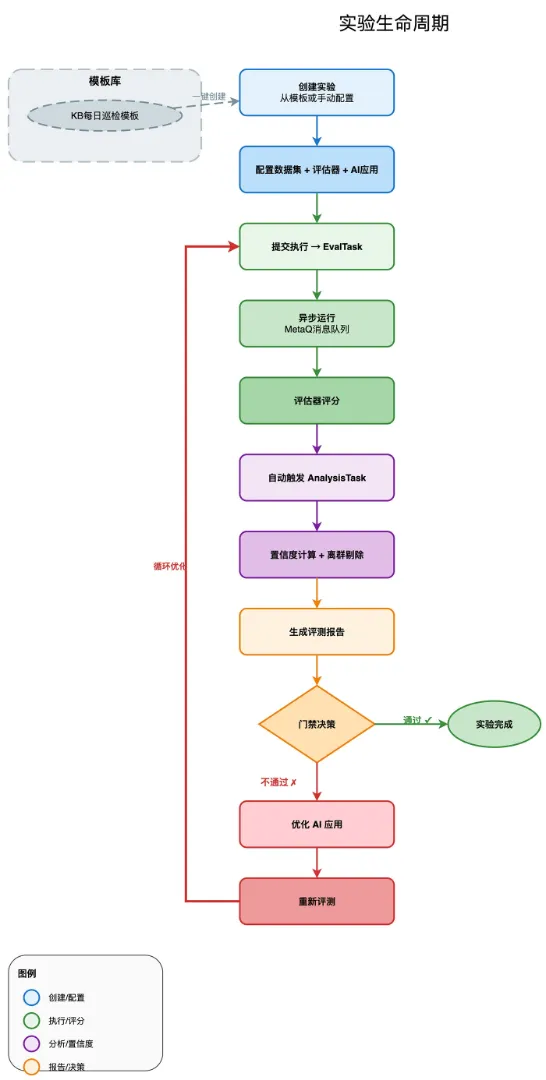
如果说评估器和数据集解决了"怎么评"和"拿什么考",实验解决的就是"怎么跑"——它是平台的调度中枢:把被测场景、数据集、评估器绑定在一起,定义"评谁、用什么数据、怎么评"。对应的挑战也很明确:评测创建成本高、口径难复用;黑盒漂移需要持续巡检,不能靠人记得去触发;单次分数不可信,波动来源要分清;结果驱动不了决策,问题要能结构化地浮出来。这一章讲实验的完整生命周期——怎么创建(含模板复用)、怎么触发(手动 / 定时 / 发版自动)、怎么执行(异步、大仓并行),以及多轮执行之后的两层稳定性度量。
5.1 创建实验
创建一个实验,本质上是回答三个问题:
•评谁(选被测场景)
•用什么数据(选数据集,支持多选,也可绑定数据集组)
•怎么评(选评估器)
平台提供向导式创建,三步选完即可发起。
高频场景可以沉淀为定时实验模板(含数据集、评估器、场景等的默认配置),新实验会按照定时配置一键从模板创建,配置全部继承。模板解决的是"口径难复用"——同一套评测标准不必每次重新拼一遍。
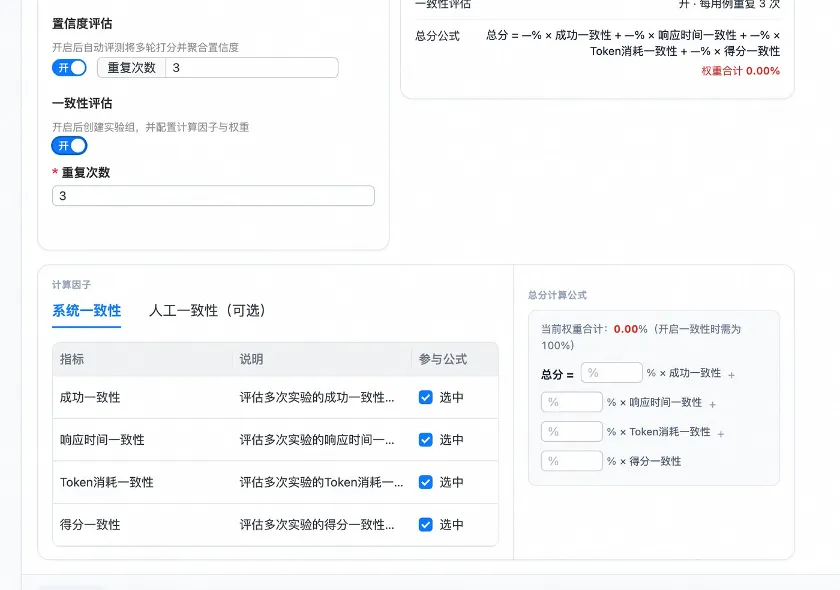
除了选场景、数据集和评估器,实验还能配总分公式:每个评估器的子分数各占多少权重,由使用方自己定;稳定性评估器也有独立的一组权重。总分 = 各评测评估器子分数×权重 + 各稳定性评估器得分×权重。这件事的意义在于——同一个评估器,不同实验和场景可以按自己关心的重点给出不同的总分:更看重编译通过就把规则类权重调高,更看重语义质量就把 LLM 评委权重调高,不必为了一个口径去改评测逻辑。
5.2 触发实验
实验建好之后,有三种方式让它跑起来:
•手动发起——接入调试、或想立刻要个结论时,页面上点一下就跑。
•定时触发——按周期自动跑,比如每日 08:30 巡检。第 1 章说的"黑盒化行为漂移"就靠这种持续巡检兜住——局部劣化不会自己敲门。
•变更触发——知识库评测里,仓库有新提交会被定时扫描发现并自动拉起评测;新注册的业务域也会立即触发一次。被测对象变了就重评,不依赖人记得去点一下。
5.3 评测一致性
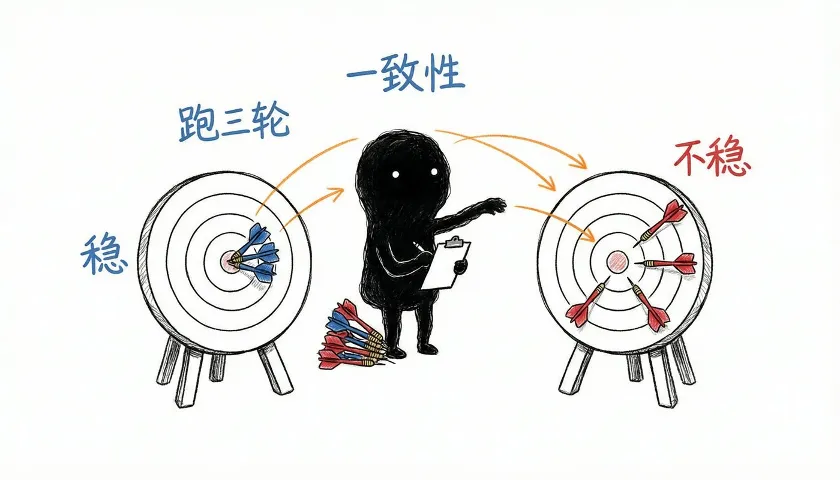
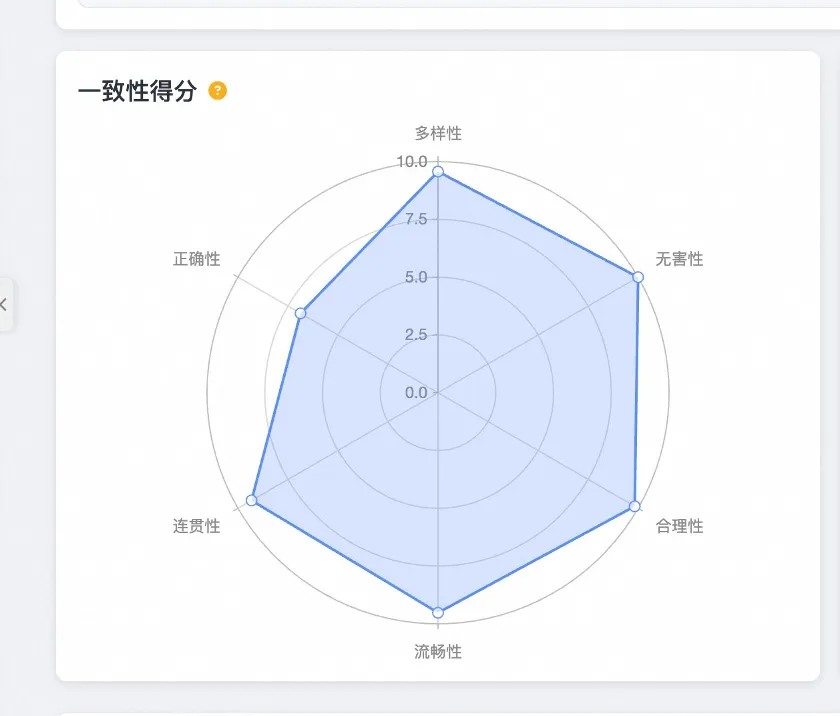
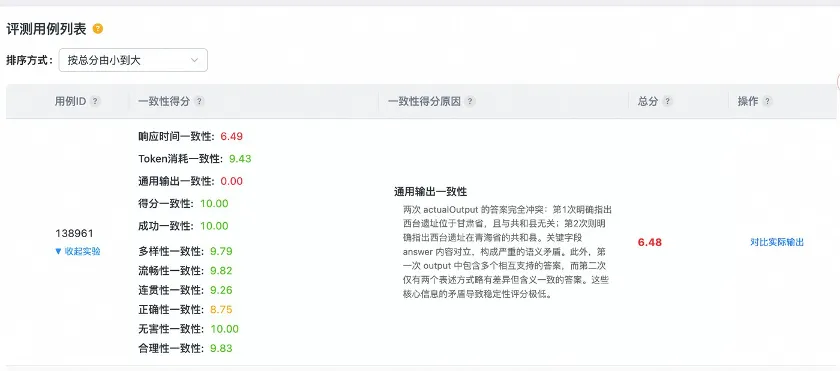
单看一次分数,你分不清波动来自哪一边:是被测场景本身输出不稳,还是评估器打分在抖。所以平台把这两件事分开度量——评估器那一侧由置信度负责(见第 3 章);被测场景这一侧,就是这里要讲的一致性:同一场景、同一数据集多轮跑下来,结果稳不稳。
举个最常见的情形:一次评测 8.5 分,第二天复跑却变成 6.2 分。是被测对象退化了,还是评估器这次打偏了?两个指标分开看,才答得上来。
一致性评估可以单独发起:平台提供独立的一致性评估任务——指定实验与数据集触发,实验的每一轮执行都会沉淀为一条执行记录:分数、维度明细、结构化报告和问题清单都挂在这一轮之下,多轮之间可以对比。
5.4 实验结果分析
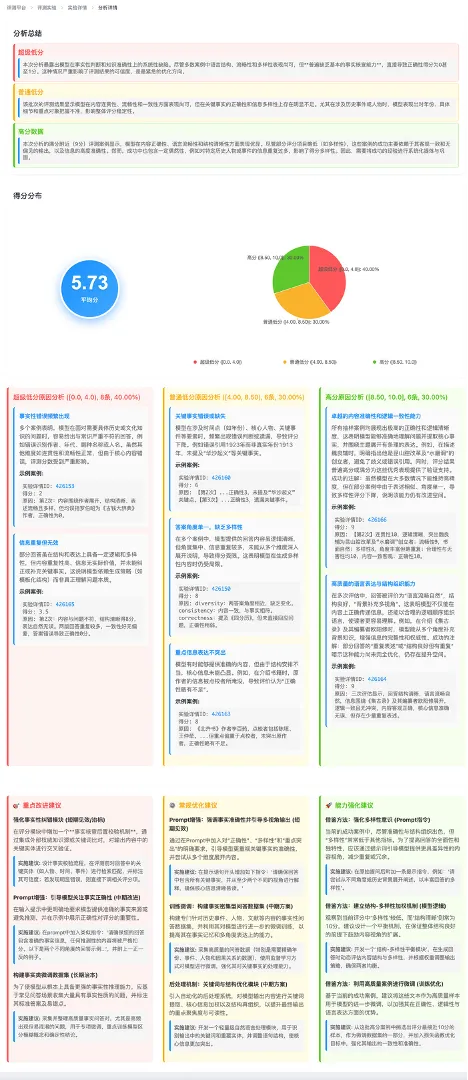
一次实验跑完几百条数据,分数出来只是开始——哪些 case 值得先看?平台在评测完成后自动触发分析任务,把评测数据按得分归类:满分、普通低分、超级低分(支持动态扩展分类)。低分自动堆在一起,坏 case 不用人肉翻;想深挖某一条数据,还支持单独 case 分析。
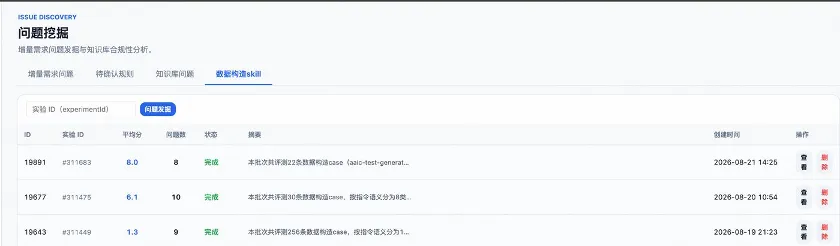
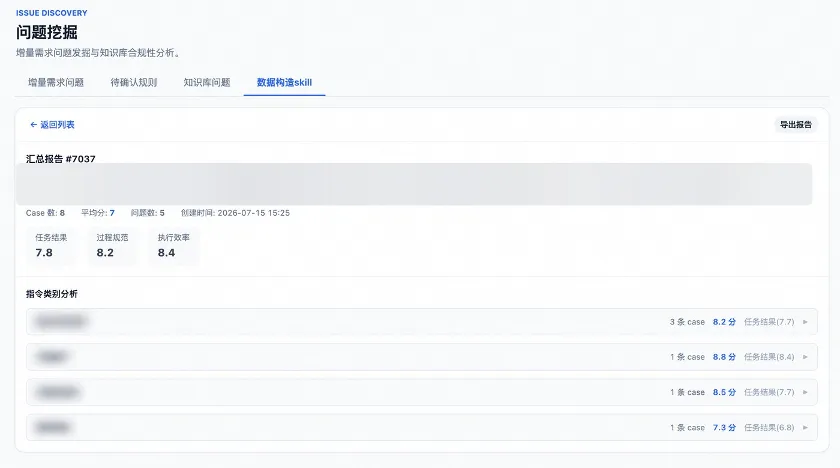
结果分析还有一种特殊形态:只挖问题、不算分,而且不局限在单个实验内——那就是问题挖掘。它底层同样跑在分析任务链路上,一次挖掘可以关联到具体实验,也可以独立发起。覆盖四类来源:增量需求问题、知识库问题、数据构造 skill 问题,以及从问题里提炼出的待确认规则。
一次挖掘往往产出几十上百个问题,不分轻重平铺直叙,致命问题就会淹没在小瑕疵里。所以每个问题都带维度和严重程度——CRITICAL(严重)/ MAJOR(一般)/ MINOR(轻微),按问题本身的影响判定;运行记录直接累计各级问题数,该先修什么一目了然。
问题清单支持按维度、严重度、处置状态筛选;确认是真问题就采纳,误报就拒绝并写明理由。处置状态(待处理 / 已采纳 / 已拒绝)沉淀下来——修复有据可查,误报能被回溯,处置进度也直接体现在运行记录上。走到这一步,评测结果就不再只是一个分数,而是一份可处置、可追踪的问题清单——这正是对"结果驱动不了决策"的回答。
架构说得再漂亮,最终都要靠真实场景来验证。这一章按四大类各讲一个已落地的评测——agent 评测、知识库评测(含整体与召回)、生码评测、skill 评测。
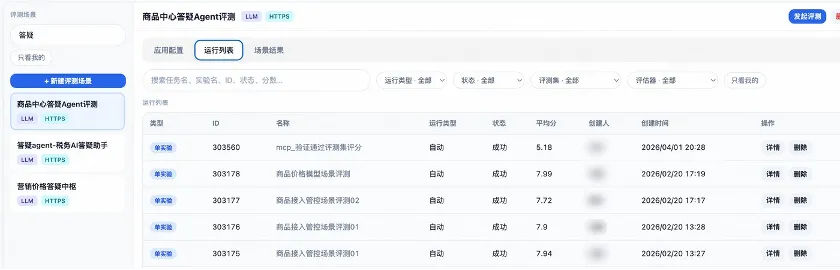
6.1 agent 评测:idealab 答疑 agent 评测
场景概述:评测 idealab 答疑 agent 的回答质量——用户问一个问题,agent 给出答疑,评测它答得准不准、是否真正解决问题。
被测类型: agent 类型,通过 HTTP 同步调用被测 agent 拿到回答,属"需运行被测场景"的实时评测。
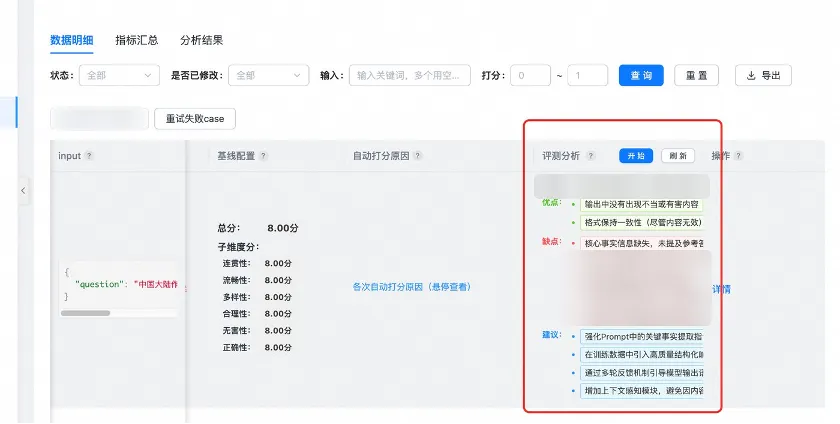
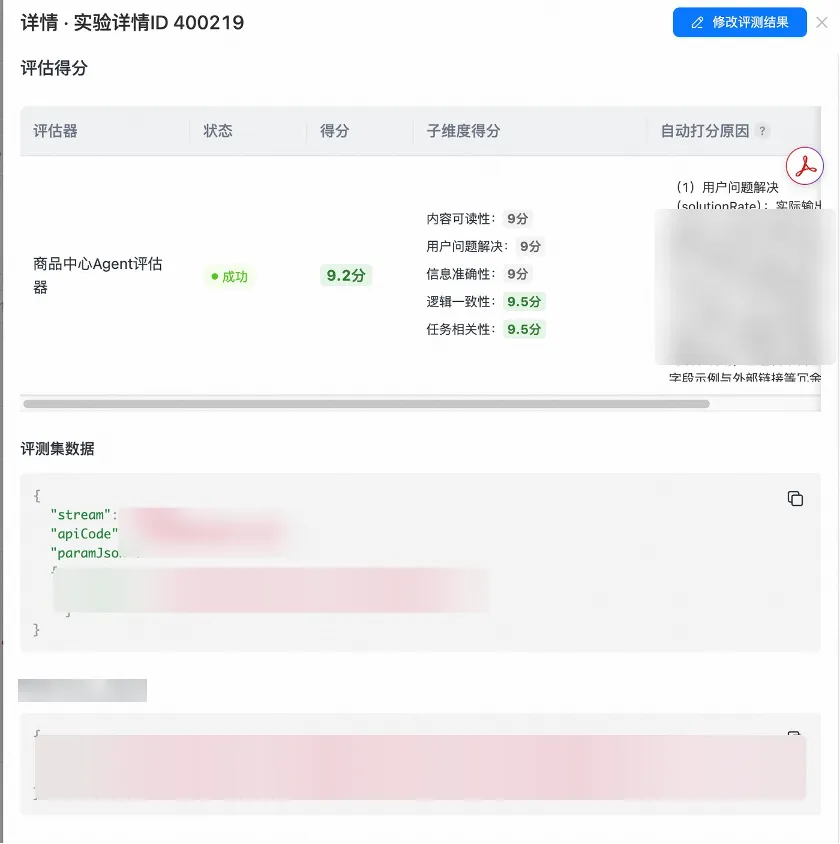
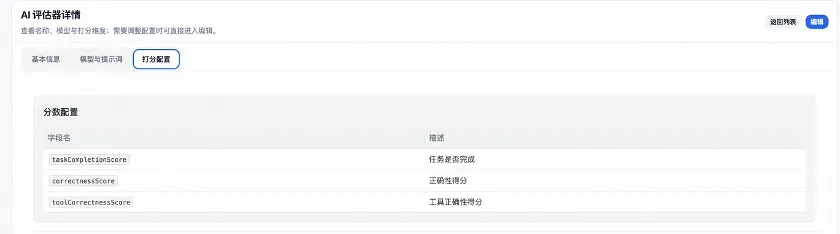
评估器类型:可选用人工评估器(主观质量评审)或 HTTP 评估器(平台已提供了通用的答疑评估器),分 3 个子维度由 LLM 评委按 Judge Prompt 打分。
6.2 知识库评测:aaic 生码知识库整体 + 召回评测
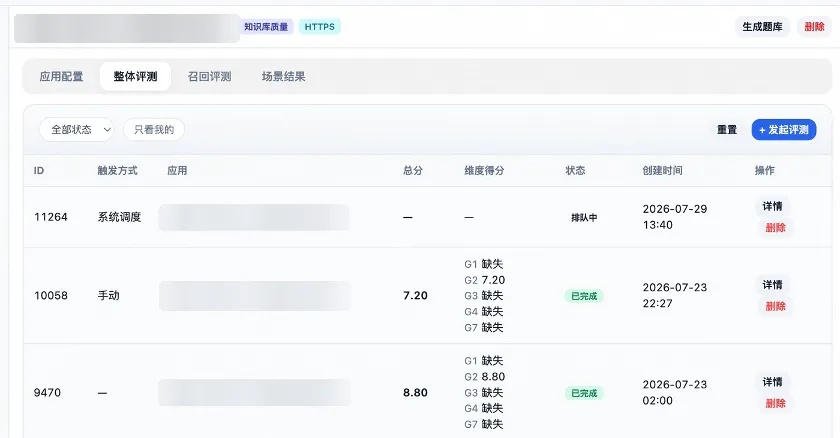
知识库评测包含两块:整体评测——知识库文档本身的质量;召回评测——知识被取出来使用时的质量。
整体评测
场景概述:评测 KB 知识库文档内容是否准确、结构是否完整且合规。
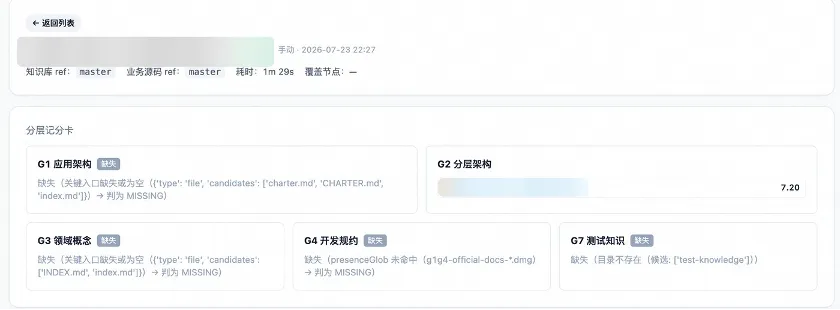
评估器类型: SKILL(DIRECT 模式)——克隆三仓(KB + Workspace + 源码),按"结构完整→格式合规→内容正确"三段递进校验,逐层评测、逐层出分。
评测方式:知识库按 G1–G7 分层组织,评测也按层进行——每层独立检查、独立出分和报告;每一层的质量报告带分档结论(PASS / CONDITIONAL / FAIL),各层报告都可在线查看与下载。
分层设计正对着第 1 章的"局部劣化"难题——每层报告独立成立,任何一层的退化都不会被其他层的总分掩盖。
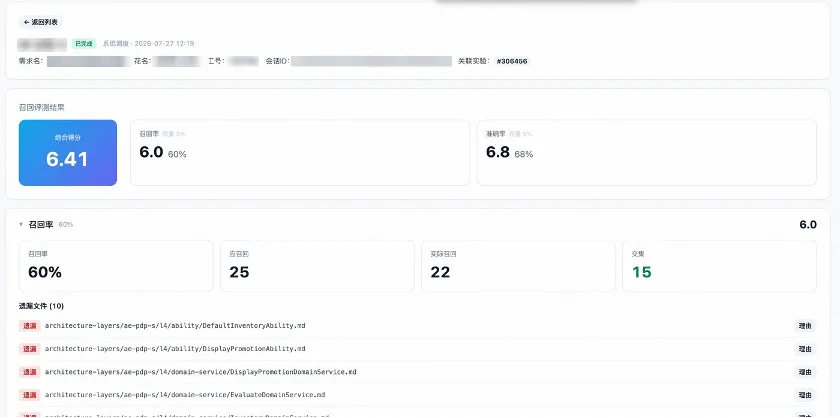
召回评测
知识库写得好只是一半——生码时知识有没有被真正取用、取得准不准,才是知识库价值的最终检验。生码评测会对每次生码产出两个知识维度分:knowledgeRecall(知识召回:该用的知识有没有被召回)和 knowledgePrecision(知识精确:召回的知识对不对),从生码链路反向度量知识库的召回质量。
6.3 生码评测:aaic 生码评测
这块内容我们另有专文详解,这里先不展开。
6.4 skill 评测:数据构造 skill 评测
场景概述:评估 AI 数据构造 Skill 的能力——给一句"帮我构造一个正常的用户注册数据"这样的自然语言指令,Skill 能不能正确造出符合业务需求的测试数据。
评估器类型: SKILL 类型——评测 Skill 直接使用线上数据构造 Skill 的真实输出,按照评测规则进行评分。
数据清洗与打分: skill 批量产出的候选数据,先清洗成规范形态,再由打分环节给出质量分;未打分的条目有定时任务扫描补跑。
推荐数据: skill 批量产出的候选数据,先清洗成规范形态后进入推荐列表候选,支持用户按日分组浏览;可采纳需要评测的数据。
黄金数据集:评测结果支持人工晋升为黄金数据,数据写入黄金数据集后,作为这个 skill 的能力回归基准——固定题目反复对比,能力有没有退化一眼可见。
问题分析:评测后自动触发问题分析,归纳总结问题成因并按照数据构造命令维度给出修复建议。
7.1 总结
做完这个平台,我们对"评测"的理解变了。最初以为评测就是打分,后来发现分数本身是不够的:一个 8.5 光看起来高没用,你得知道它稳不稳、评它的评委靠不靠谱,这个分才敢被拿去做决策。评测真正沉淀下来的也不是分数,而是标准:数据集沉淀"考什么",评估器沉淀"怎么算好"。标准立住了,"什么是好的 AI 应用"才能被定义。
回头看今天的数据和能力:平台接入了生码、agent、知识库、skill 四大类被测对象,155 个评测场景在上面运行;4 种可插拔评估器承接了从"调一个接口"到"克隆三仓逐节点比对"的评判逻辑;数据集从散落在各仓库的 Excel,收敛成统一服务 + 数据集组 + 黄金集 + 推荐采纳的闭环;运行方式从"人记得跑一次"变成手动 / 定时 / 变更三种触发的持续巡检;结果从一个分数,变成一致性与置信度双指标、结构化问题清单和三级严重度。以知识库评测为例,单域审查从数天压到 20 分钟,200+ 节点全量覆盖、数千个"文档 vs 源码"比对点自动完成——而且这一切可重复、可对比、可追溯。这基本就是我们在第 1 章立下的目标:把感觉里的"好坏",变成可信、可比、能发现问题的分数。
平台今天能做到的,是让分数可信、让问题浮出来;还做不到的——真实拦截风险的卡口、评测逻辑的自进化——我们如实写在了未来方向里。说到底,评测是给 AI 应用的迭代装上仪表盘:仪表不能替你开车,但没有仪表,你不知道自己开得多快、还能开多远。我们希望这套平台,能让更多团队放心地把 AI 应用开得更快更好。
7.2 未来方向
以下是我们觉得值得探索的方向,后续也会持续迭代。
方向一:被测场景的卡口与优化闭环。现在评测结果以报告、趋势、推送的方式被人消费,采不采取行动仍取决于人。下一步是把评测做成真正的卡口——分数不达标或存在严重问题时,能真实拦截风险,而不只是提醒。配套的是被测场景的优化闭环与监控体系:持续监控每个场景的分数与问题趋势,劣化能被及时发现、定位、验证修复,让"评测→改进→再评测"跑成常态。
方向二:评测逻辑本身的自进化。评测逻辑今天靠人定标准、人来修。我们的设想是让系统自己发现评测逻辑的问题——比如从评委行为里找跨域统计异常:当多数域在同一类节点上出现同一类误判,不需要知道"标准答案是什么",也能判定评委这条规则有问题。顺着这个思路,可以搭一条"分析→优化建议→人工审核→修复"的闭环,AI 提议、人来拍板。这条链路目前还在设计探索阶段,尚未上线。
方向三:更低的接入门槛与更灵活的使用方式。让新场景接得更省力——配套模板与最佳实践,能复用的不重写;也让用法更自由——评估器、数据集、总分公式这些积木,使用方能按自己的节奏和口径自由组合,而不是被