当前位置:首页>排行榜>论文分享丨从评测基准到意图引导:探索智能体评测与可视分析新进展

论文分享丨从评测基准到意图引导:探索智能体评测与可视分析新进展

  • 更新时间 2026-09-19 14:38:33
论文分享丨从评测基准到意图引导:探索智能体评测与可视分析新进展
Intro

近年来,大模型驱动的智能体正在从"完成一步操作"走向"承担完整工作流",可视分析领域也在探索如何让 AI 真正理解用户的分析意图。当下的研究不再满足于让模型"答对一道题",而是开始追问:如何评测智能体在真实、长程任务中的工作能力?如何在用户意图尚不明晰时,引导而非代替用户做出可视化决策?本次组会,智能 VA 组与 GUI Agent 组联合开展分享,围绕两个前沿评测基准与一项组内投稿工作展开了深入讨论。

DAComp

论文引用:Lei F, Meng J, Huang Y, et al. Dacomp: Benchmarking data agents across the full data intelligence lifecycle[C]//International Conference on Learning Representations. 2026, 2026: 104463-104501.

分享人:丁厚钦

论文简介

随着大语言模型在代码生成、工具调用与复杂任务规划方面的能力持续提升,数据智能体逐渐由简单的数据问答扩展至数据工程、数据分析及决策支持等真实业务场景。然而,现有评测基准大多集中于 SQL 生成、代码补全或单步数据分析,难以全面反映企业数据工作的流程复杂性与系统依赖性。

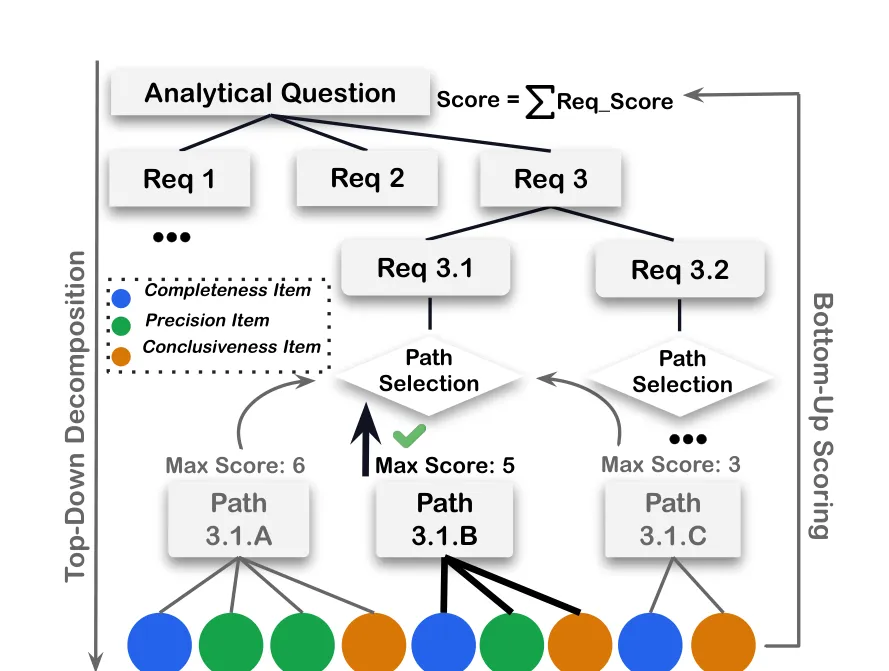
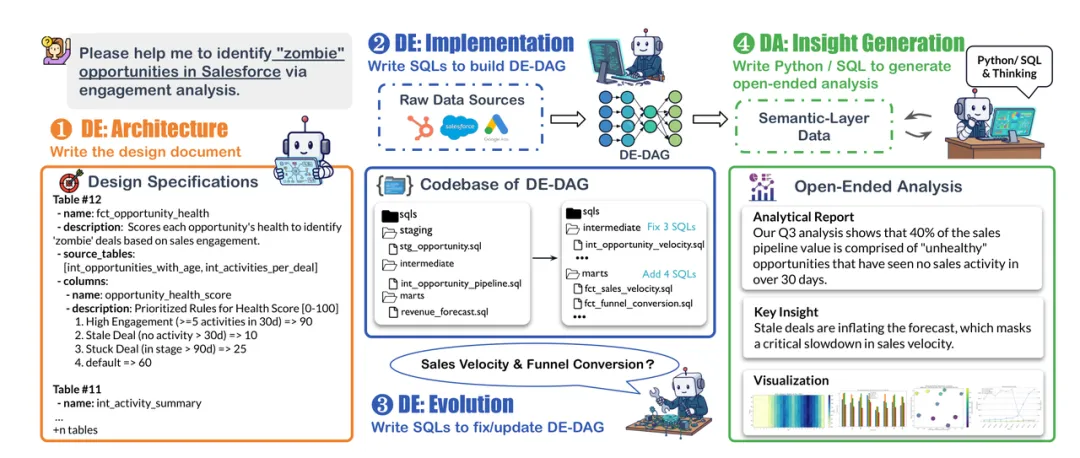
为弥补上述不足,DAComp(Benchmarking Data Agents across the Full Data Intelligence Lifecycle)构建了一个覆盖完整数据智能生命周期的综合评测基准。该基准将任务划分为数据工程与数据分析两大部分,系统考察智能体在业务需求理解、数据架构设计、数据管道开发、既有系统维护以及开放式数据分析等环节中的能力。其核心目标是评估智能体能否完成项目级、长流程且具有复杂依赖关系的真实数据工作,而非仅验证其生成局部代码或回答单一问题的能力。

方法与系统设计

(1)数据工程架构设计

在数据工程架构设计任务中,智能体需要依据自然语言形式的业务需求与现有数据环境,识别相关数据来源、业务实体、指标定义及依赖关系,并形成结构化的数据工程方案。该环节主要评估智能体将模糊业务目标转化为可执行技术规范的能力。

(2)数据工程实现与演化

在数据工程实现阶段,智能体需要构建由 Staging、Core 或 Intermediate、Marts 等数据层组成的数据管道,并正确维护 SQL 节点之间的依赖关系与数据血缘。数据工程演化任务进一步引入业务需求变更,要求智能体识别受影响的组件、修改既有仓库,并尽可能保证原有功能不受破坏。该设计用于模拟真实数据系统的开发与持续维护过程。

(3)开放式数据分析

在数据分析任务中,智能体需要围绕开放式业务问题自主制定分析计划,并使用 SQL、Python 等工具开展数据探索。智能体还需依据中间结果动态调整分析策略,最终形成具有证据支持的分析结论、可视化结果与业务建议。该任务不仅关注最终答案的正确性,也强调分析过程的完整性、合理性与决策价值。

(4)多层次评测机制

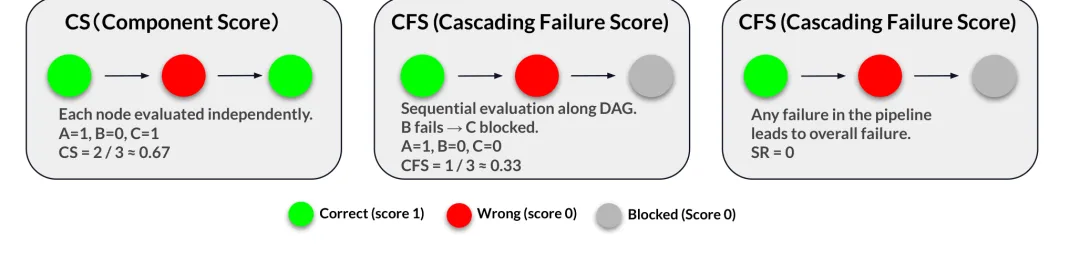
DAComp 根据任务输出形式采用差异化评测方法。对于可执行的数据工程任务,基准通过组件正确性、级联依赖影响及整体任务成功情况评估系统实现;对于架构设计与开放式分析等不存在唯一标准答案的任务,则采用分层评价准则,从完整性、准确性、分析深度、洞察质量与表达效果等维度进行综合判断。该机制有助于定位智能体在局部代码生成、长程规划或全局依赖管理等不同环节中的能力缺陷。
OSWorld 2.0

论文引用:Yuan M, Zhou Z, Xiong X, et al. OSWorld2. 0: Benchmarking Computer Use Agents on Long-Horizon Real-World Tasks[J]. arXiv preprint arXiv:2606.29537, 2026.

分享人:杨朝杰

论文简介

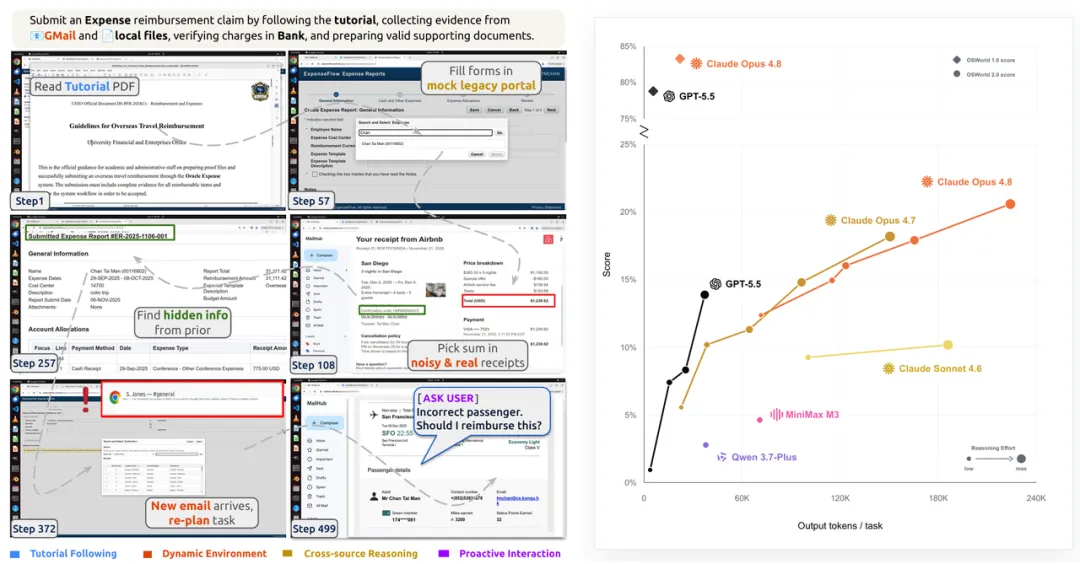
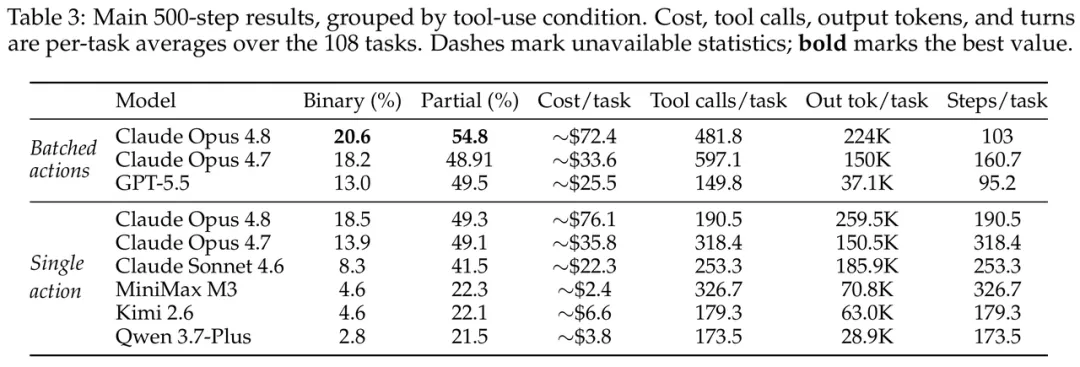
现有 Computer-Use Agent benchmark 更多关注短程 GUI 操作,例如打开软件、填写表格或修改设置,但这类任务难以反映真实工作中跨应用、长时间、持续变化的复杂流程。OSWorld 2.0 因此提出一个面向 Long-Horizon Workflow(长程工作流) 的 benchmark,共包含 108 个真实工作流任务,熟练人类完成单个任务的中位时间约为 1.6 小时。相比 OSWorld 1.0 平均约 30 次工具调用,OSWorld 2.0 中 Claude Opus 4.7 平均需要约 318 次调用。它的重点在于提出的长程任务要求前后步骤存在真实依赖,并引入跨来源推理、隐式状态推断、动态环境和主动询问等真实工作中常见的问题。

OSWorld 2.0 中一个典型报销任务需要 Agent 先阅读教程,再从收据、Gmail、银行记录和历史报告中收集信息;执行过程中还可能收到新的邮件,从而改变原来的任务状态。如果不同来源存在冲突,Agent 需要主动询问用户,最后再完成表单检查与提交。因此能够测试 Agent 能否在长程过程中持续维护一个正确的任务状态。

方法与系统设计

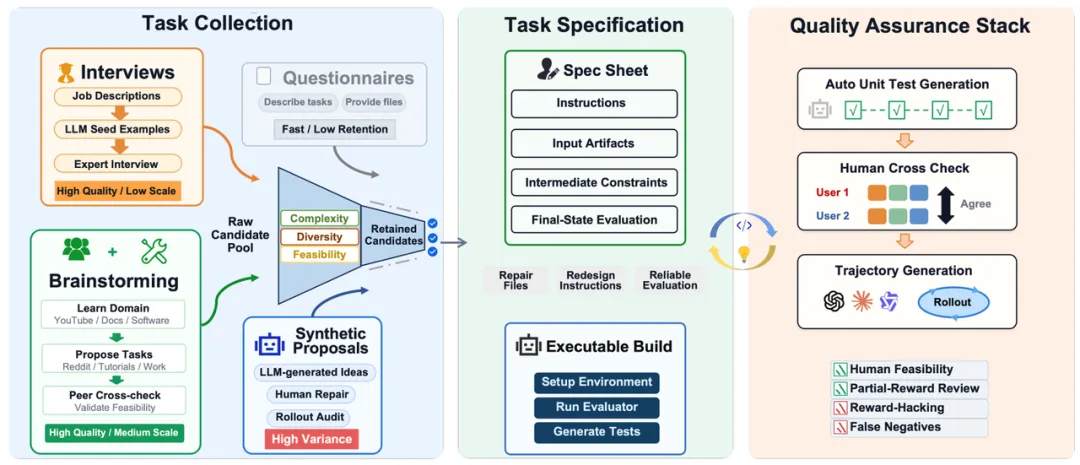
OSWorld 2.0 的任务构建分成以下三个阶段。任务想法首先来自团队 brainstorming、访谈、问卷以及 LLM 生成的 synthetic proposals,再根据 Complexity(复杂度)、Diversity(多样性) 和 Feasibility(可实现性) 进行筛选,随后被转换成可执行的 task specification。构建阶段进一步配置 self-hosted web services、桌面应用、初始/最终 workspace state、simulated user channel 和 dynamic-update hooks,使任务能够真实复现跨应用、动态变化的长程工作流。最后通过 unit-test generation、human cross-checking、agent trajectory rollouts,以及针对 feasibility、partial reward 和 reward-hacking 风险的专项检查进行多轮质量保证。评测方面,每个任务平均包含约 27 个 checkpoint,任务结束后报告严格的 Binary Completion(完整完成率) 和 Partial Score(部分完成分数),从而区分“完整完成的任务”和“部分完成的任务”。

实验结果显示,在 500-step 设置下,最佳模型 Claude Opus 4.8 的 Partial Score 达到 54.8%,但 Binary Completion 只有 20.6%。随着任务时间跨度增加,完整成功率进一步快速下降。作者发现当前 Agent 的主要失败已经不再只是基础 GUI 操作,而是长期执行过程中会忘记约束、漏掉中途新信息、本应询问用户时自行猜测,以及缺少最终验证。这说明当前 Computer-Use Agent 的主要瓶颈正在从 GUI Grounding 转向 Long-Horizon Task / State Management(长程任务与状态管理)。

END

供稿 | Intelligent VA组 & GUI Agent组

排版 | 丁厚钦

FDU-VIS

复旦大学可视分析与智能决策实验室(FDU-VIS)成立于2020年9月,我们的研究方向涵盖了可视化与可视分析、人机混合智能、用户行为分析、决策支持与数据新闻故事叙述等,并在多个应用领域,包括社交媒体、网络空间安全、时空城市大数据、人文历史数据与金融科技方面有一定的科研成果。研究组秉承着人机协同、共同智能的理念,利用人机交互、数据可视化与机器学习相结合,搭建用户与数据之间的桥梁,让数据及数据背后的意义变得可感知、可理解以及可交互,进而支持人在复杂环境中进行智能决策。

随机文章