8月多模态视觉测评榜单出炉:Qwen3.8-max问鼎国内榜首,GPT-6-Astra总榜领先!
- 更新时间 2026-09-19 09:22:38
「过往文章介绍」
1.【2026年6月多模态视觉语言测评文章】6月多模态视觉测评榜单出炉:Qwen3.7-Plus问鼎国内榜首,Gemini 3.1保持总榜领先!
2.【2026年4月多模态视觉语言测评文章】4月多模态视觉测评榜单出炉:Doubao-Seed-2.0问鼎榜首,国内模型大放异彩!

多模态视觉语言模型测评摘要
摘要3:子榜格局分化,视觉应用成“分水岭”,智能交互成最突出短板!
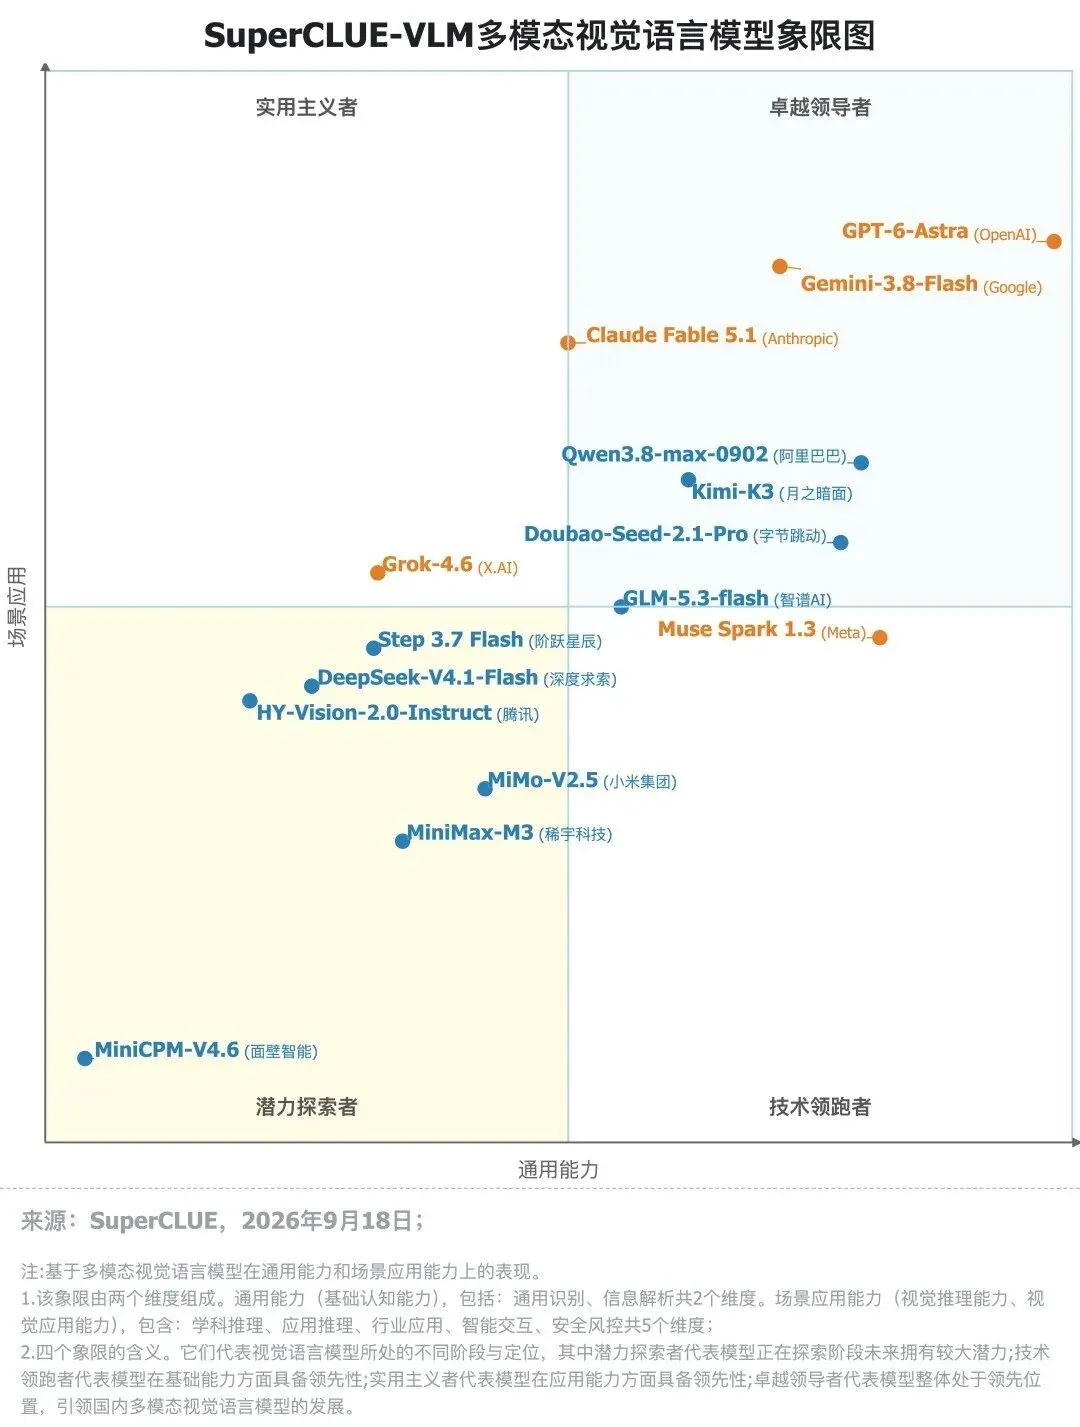
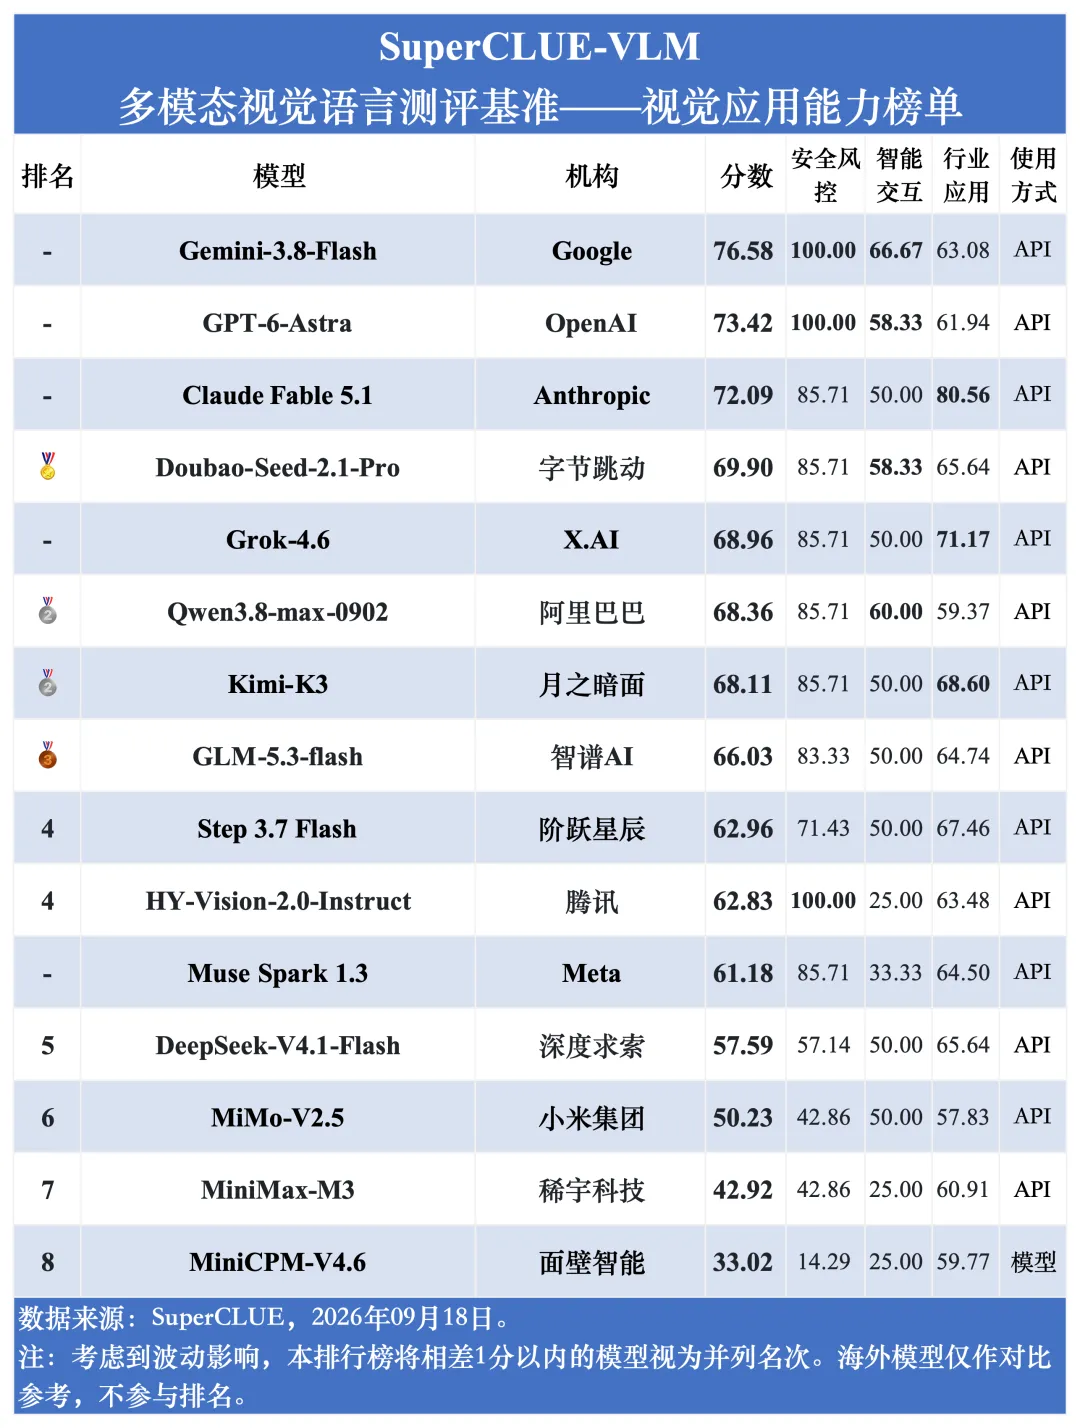
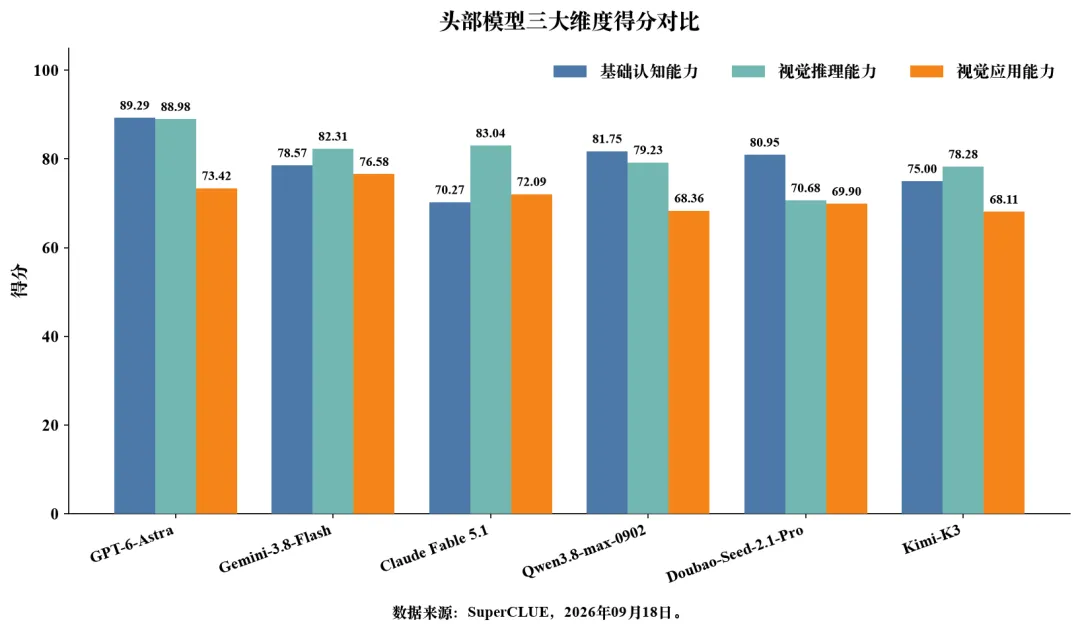
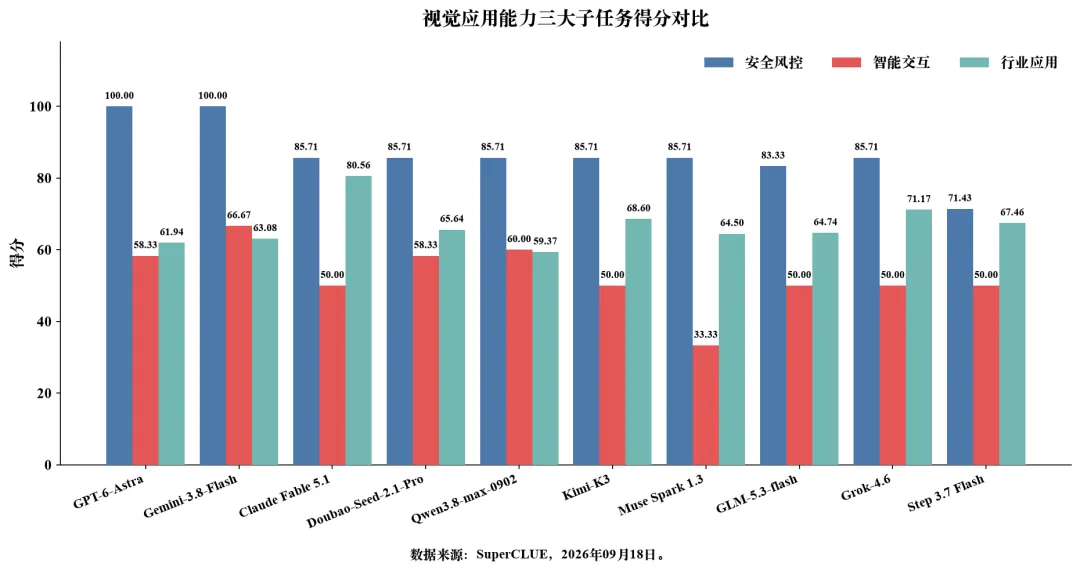
基础认知与视觉推理榜单榜首模型均已接近或超过85分,而视觉应用能力榜单最高仅76.58分(Gemini-3.8-Flash),整体明显弱于前两个维度;进一步下钻子任务,安全风控子任务表现成熟(多家100分),行业应用多数模型得分在60—75分之间,而智能交互子任务各模型得分普遍低于70分,面向真实业务场景的交互与落地能力,是各模型下一步重点突破的方向。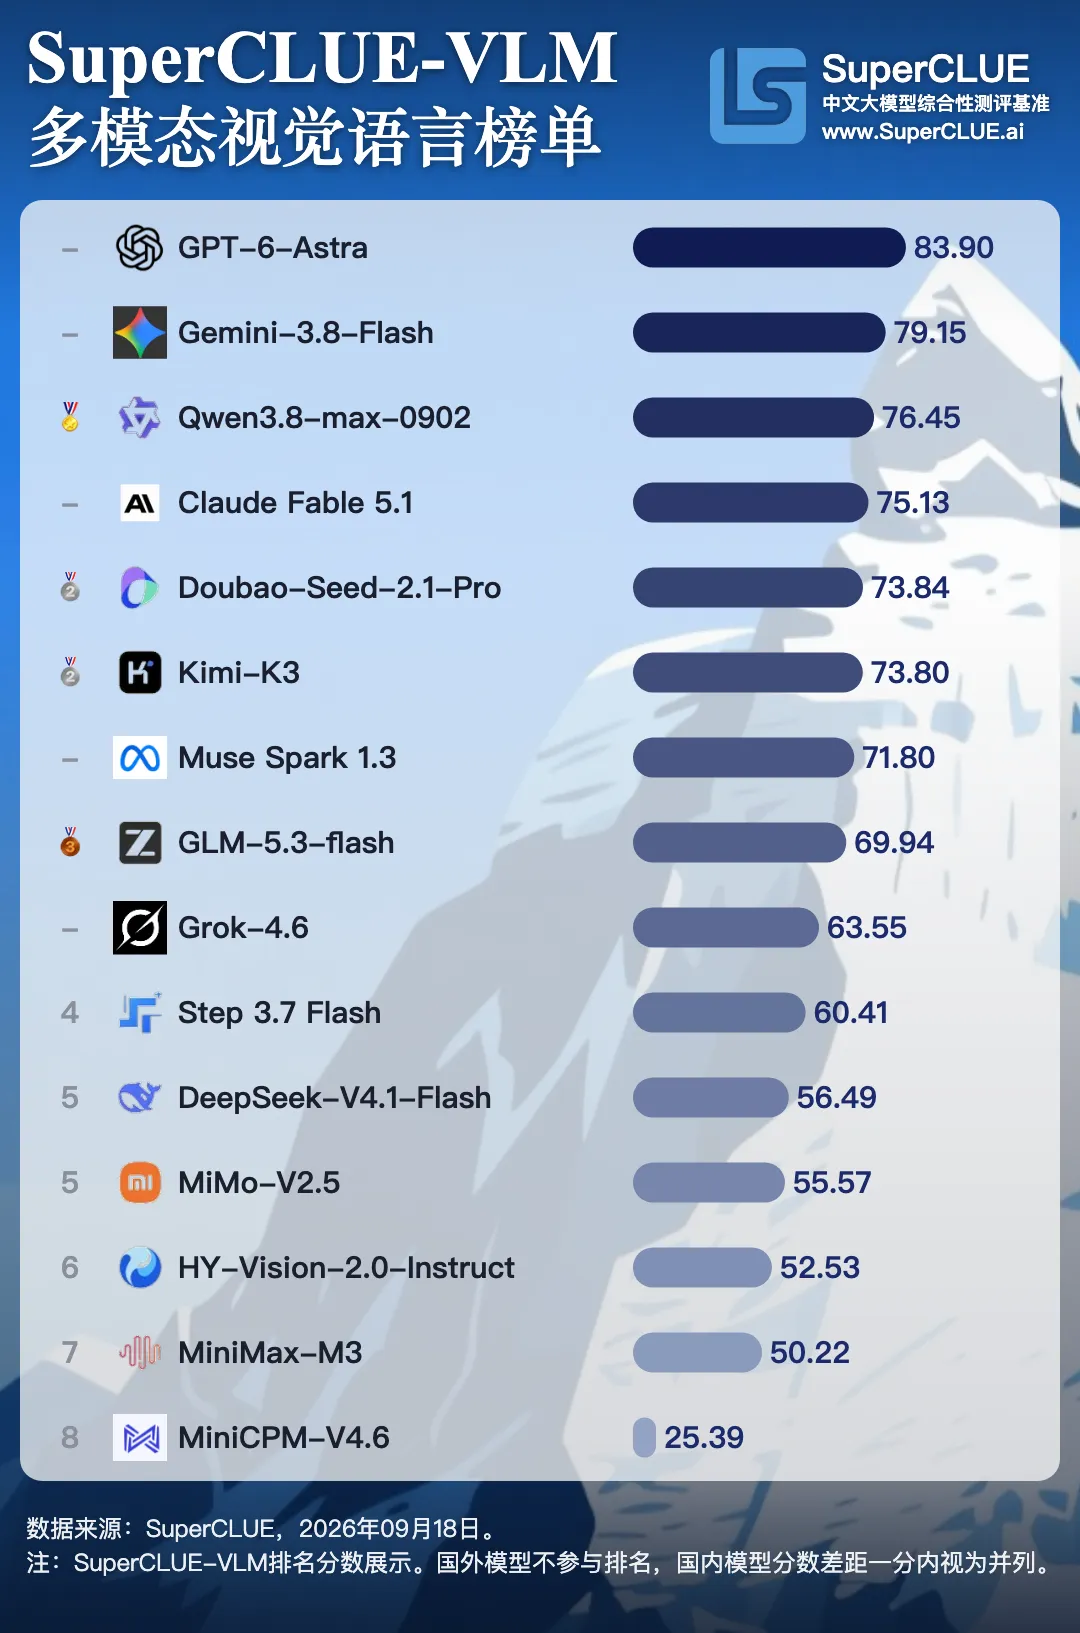
榜单地址:www.superclueai.com
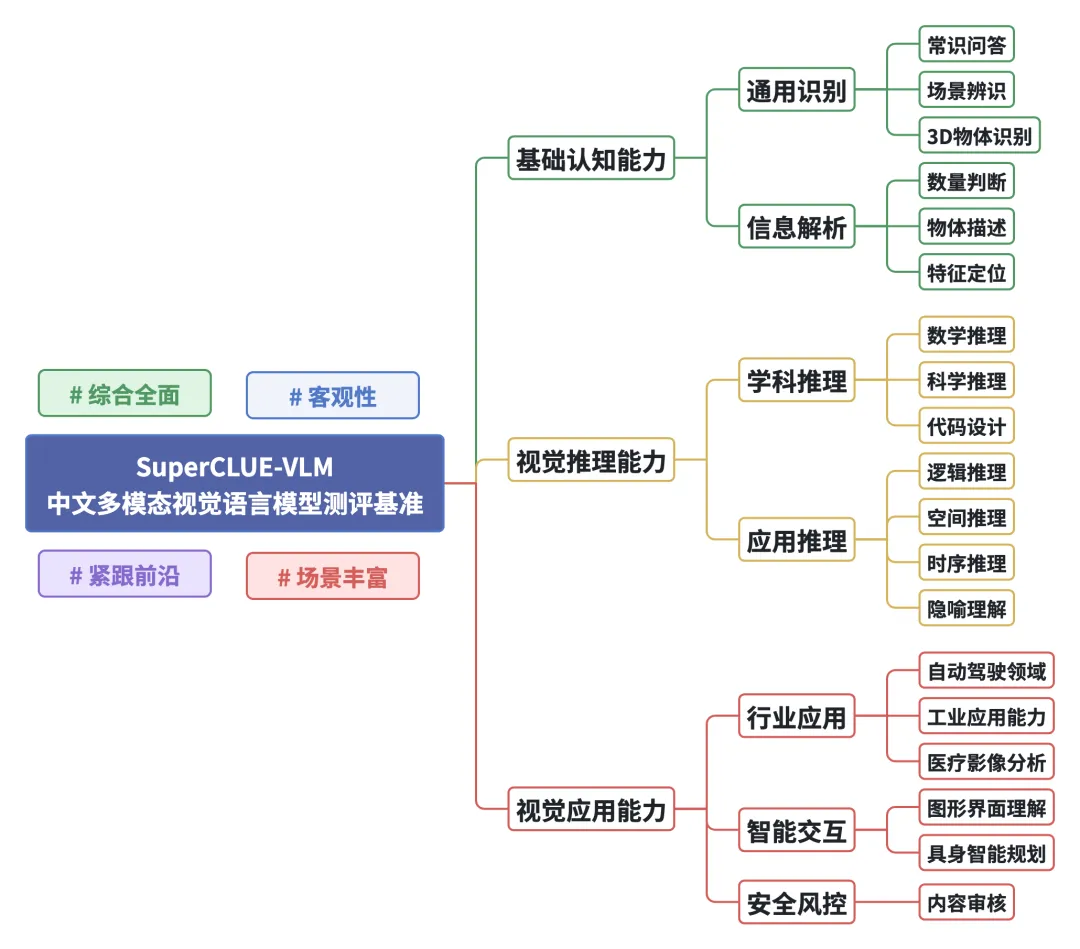
5.系统化构建各维度专属评测集,形成完整测评题库。
对于绝大多数通用任务,所有测试用例均配备标准参考答案,通过模型输出与参考答案的一致性判定回答正确性;
针对代码生成任务,仅凭图片解析难以得出唯一最优解(如CSS样式、排版格式无统一标准),采用自动化评价流程:满足任务核心需求、逻辑自洽的生成结果判定为正确,错误率较高、存在严重逻辑缺陷或不满足任务要求的结果判定为错误。
评估示例
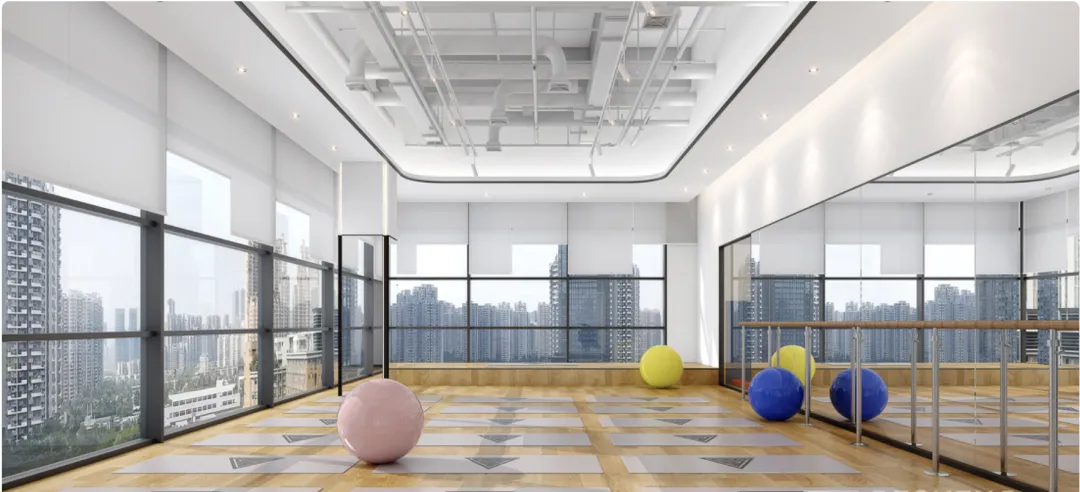
【参考答案】:「3个」
图里真实存在的瑜伽球共有3个:1个粉色、1个黄色、1个蓝色,剩余的1个黄色、1个蓝色,是右侧墙面镜子反射形成的虚像,不属于真实存在的球。答案:3个。
****评价开始**** 1. **模型回答的核心内容分析**:
模型明确回答图中共有3个真实的瑜伽球,并详细解释了颜色的分布(粉、黄、蓝各一个)。同时,模型展现了对图像场景的深度理解,指出画面中另外出现的球体是镜面反射形成的虚像,不应计入总数。
2. **参考答案的核心内容分析**:
参考答案给出的核心数值为“3个”。
3. **模型回答与参考答案的详细对比**:
- **核心结论一致性**:模型给出的最终数量“3个”与参考答案完全一致。
- **关键信息点**:模型不仅提供了正确答案,还通过逻辑推理(区分实物与镜面虚像)解释了得出该答案的原因。这种解释增强了回答的准确性,并未改变或偏离参考答案的核心语义。
- **表述差异**:模型回答包含了详细的推理过程,而参考答案仅提供了精简的数值。根据评估要求第3点,这种表述形式的差异(详细描述 vs 简洁数值)不影响核心事实的认定。
4. **最终判定及理由**:
[[回答正确]]
理由:模型给出的核心答案(3个)与参考答案完全一致。模型通过识别镜面反射准确判断了物体的真实数量,其提供的额外解释信息支持了核心结论的正确性,没有事实性错误。
****评价结束****
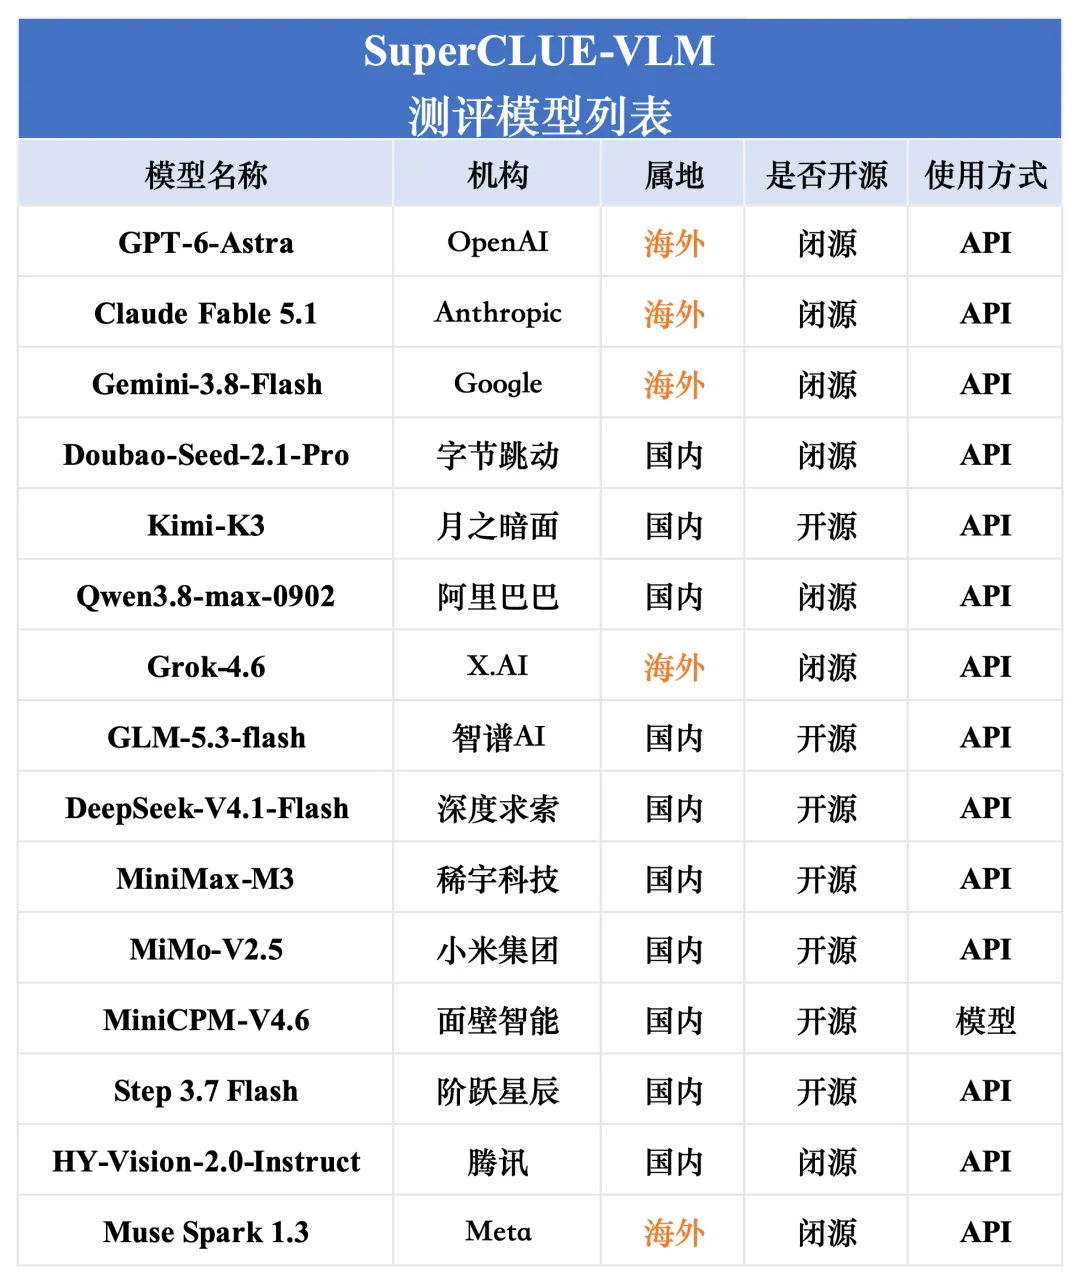
# 参评模型
# 模型对比示例
#示例1 基础认知能力-信息解析-特征定位
【问题】:「如图所示为堆叠的方块,规定三维坐标系为X左右方向,Y向上正方向、向下负方向,Z前后方向。如果A方块坐标为(-4,-2,3),C方块坐标为(-2,-2,1),那么B方块坐标是什么?(以相同的格式回答)」
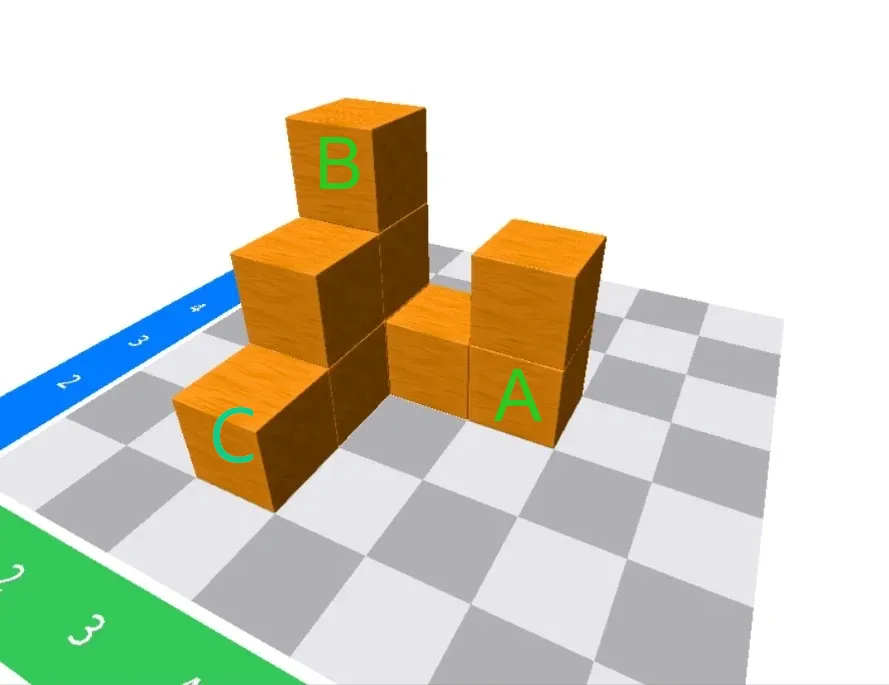
【参考答案】:「(-2, 0, 3)」
(-2,0,3)通过分析 A 方块和 C 方块的坐标,以及两者在网格中的相对位置,可以确定 B 方块的坐标。1. 确定 X 轴和 Z 轴坐标
C 方块的坐标为 (-2,-2,1)。
A 方块的坐标为 (-4,-2,3)。
根据 A、C 两个方块在网格中的相对位置,可以判断:B 方块所在的立柱位于 C 方块的正后方,并且与 C 方块处于同一条 X 轴直线上。
因此,B 方块底部支撑方块的:
X 坐标与 C 方块相同,即 X = -2;
Z 坐标比 C 方块向后移动 2 个单位,即从 Z = 1 移动到 Z = 3。
所以,B 方块的 X、Z 坐标分别为 -2 和 3。
2. 确定 Y 轴坐标
C 方块位于地面层,Y 坐标为 -2。
B 方块位于地面上方一层,并且 Y 轴正方向表示向上。
每向上一层,Y 坐标增加 1,因此:
Y = − 2 + 1 = − 1 3. 得出 B 方块坐标
综合 X、Y、Z 三个方向的坐标变化,可以确定:
B = ( − 2 , − 1 , 3 ) 因此,B 方块的坐标为(-2,-1,3)。
#示例2 视觉推理能力-应用推理-时序推理
【问题】:「请将图中 "拉狗狗滑旱冰" 的故事按正确时间顺序从左到右排序。(数字标识,用,分割)」
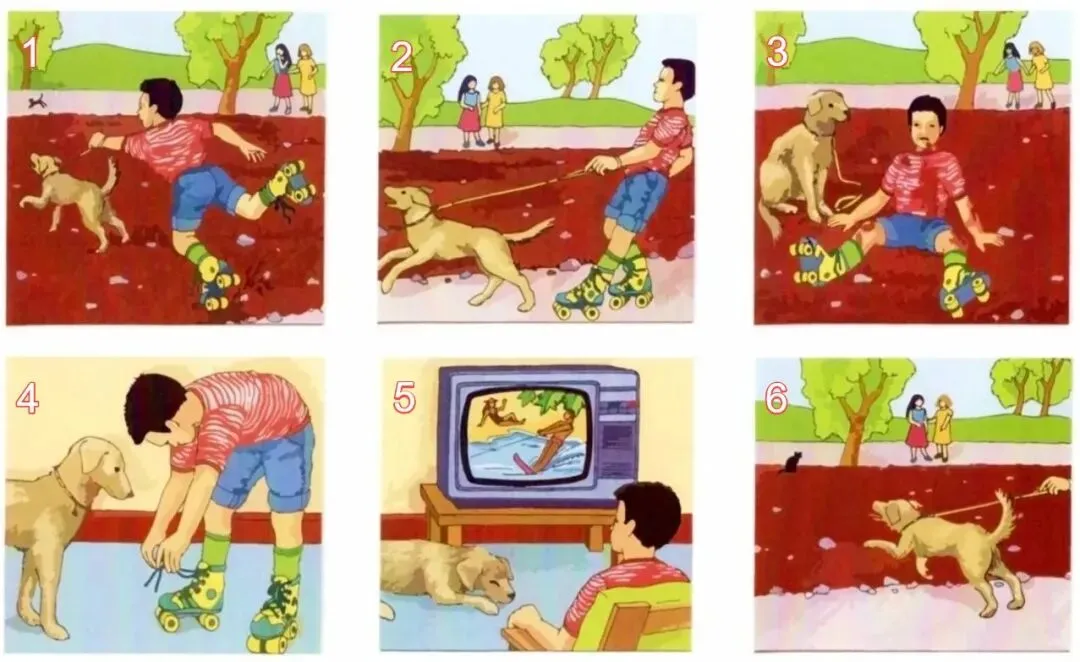
【参考答案】:「5,4,2,6,1,3」
正确的时间顺序为:5, 4, 2, 6, 1, 3
故事逻辑如下:
5:男孩在家看电视里的滑水表演,由此产生灵感。
4:男孩在家里穿好旱冰鞋,准备让狗狗拉着自己滑。
2:男孩在公园里让狗狗拉着滑旱冰,玩得很开心。
6:狗狗突然发现前面有一只黑猫,猛地向前冲去追猫。
1:男孩失去平衡,被突然加速的狗狗拽得踉跄摔倒。
3:男孩摔在地上,身上弄脏受了伤,狗狗坐在旁边看着他。
观察各图内容:图5:男孩在看电视,狗趴在一旁睡觉——故事的开头。
图4:男孩坐在凳子上穿旱冰鞋,准备出门。
图2:男孩穿着旱冰鞋,牵着狗在路上正常滑行。
图1:狗突然向前冲(追猫),男孩被猛地一拉,身体前倾、站立不稳。
图6:男孩被狗拖着走,画面中只剩下一只拉绳子的手,说明他已摔倒被拖行。
图3:狗停下来,男孩坐在地上,狗坐在他旁边——故事的结尾。
归纳顺序: 先在家看电视(5)→ 穿旱冰鞋(4)→ 出门牵狗滑旱冰(2)→ 狗突然奔跑,男孩被拉得失去平衡(1)→ 男孩摔倒被拖行(6)→ 狗停下,男孩坐在地上(3)。
因此,答案是5,4,2,1,6,3。
#示例3视觉应用能力-智能交互-图形界面理解
【问题】:「首先点一份泡椒鹌鹑蛋,然后再点一份面食,最后再结算,需要按顺序点击哪些控件来进行?(结果返回序号即可,用“、”隔开)」
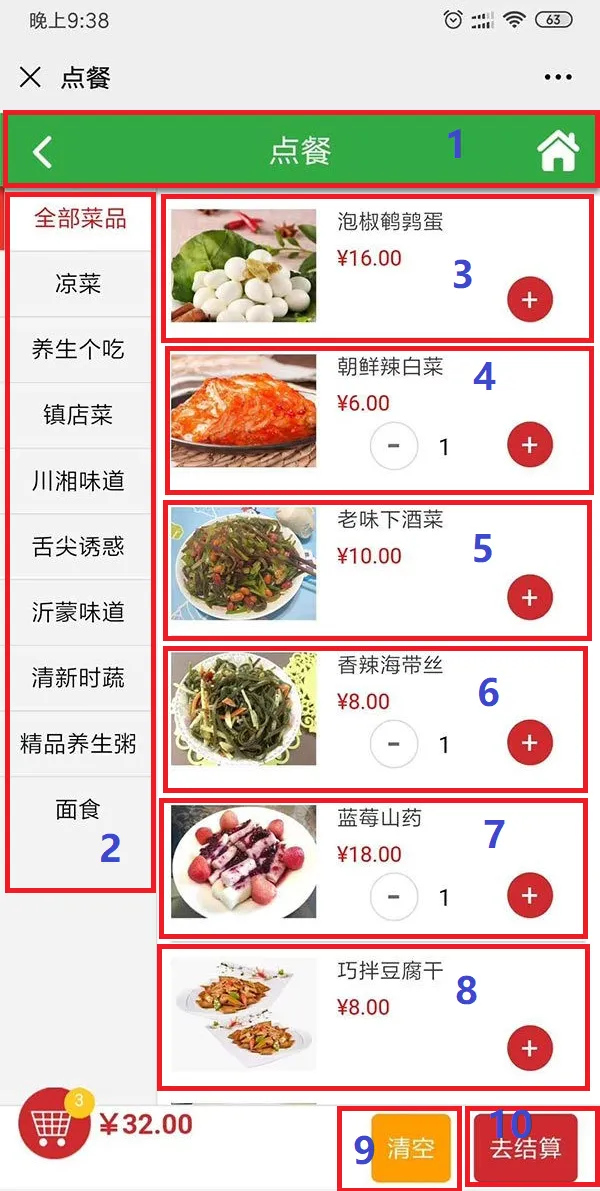
【参考答案】:「3、2、10」
按顺序需要点击的控件序号为:3、2、10
3、2、3、10
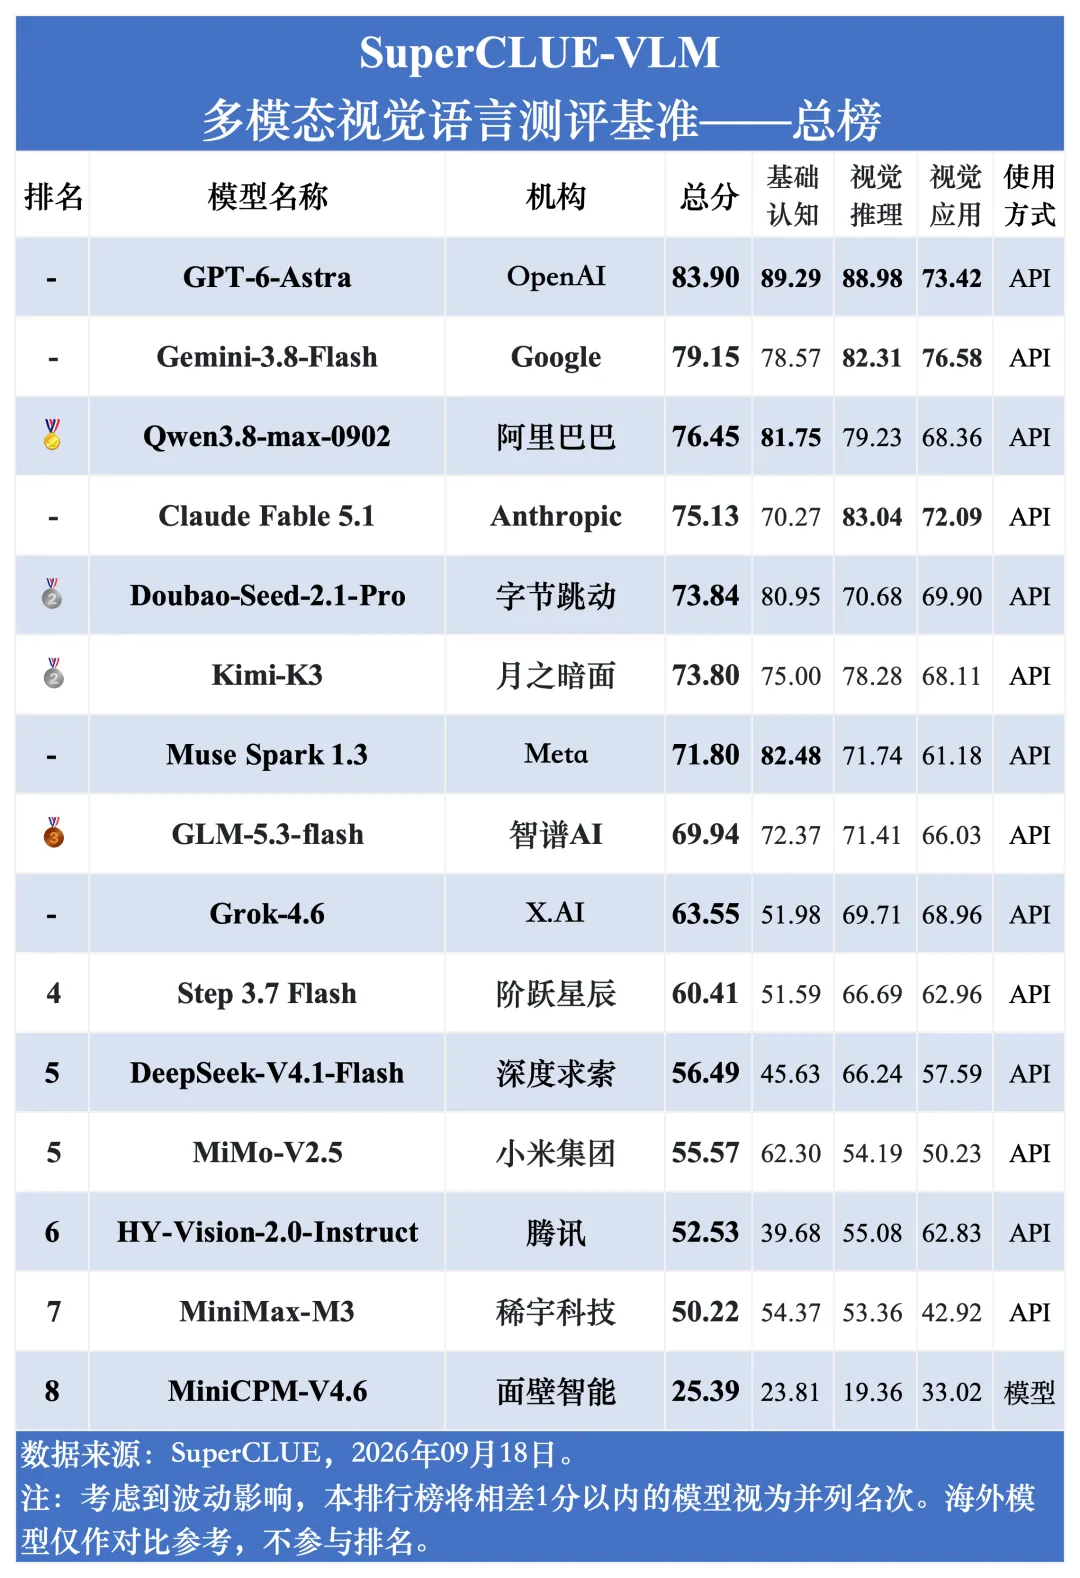
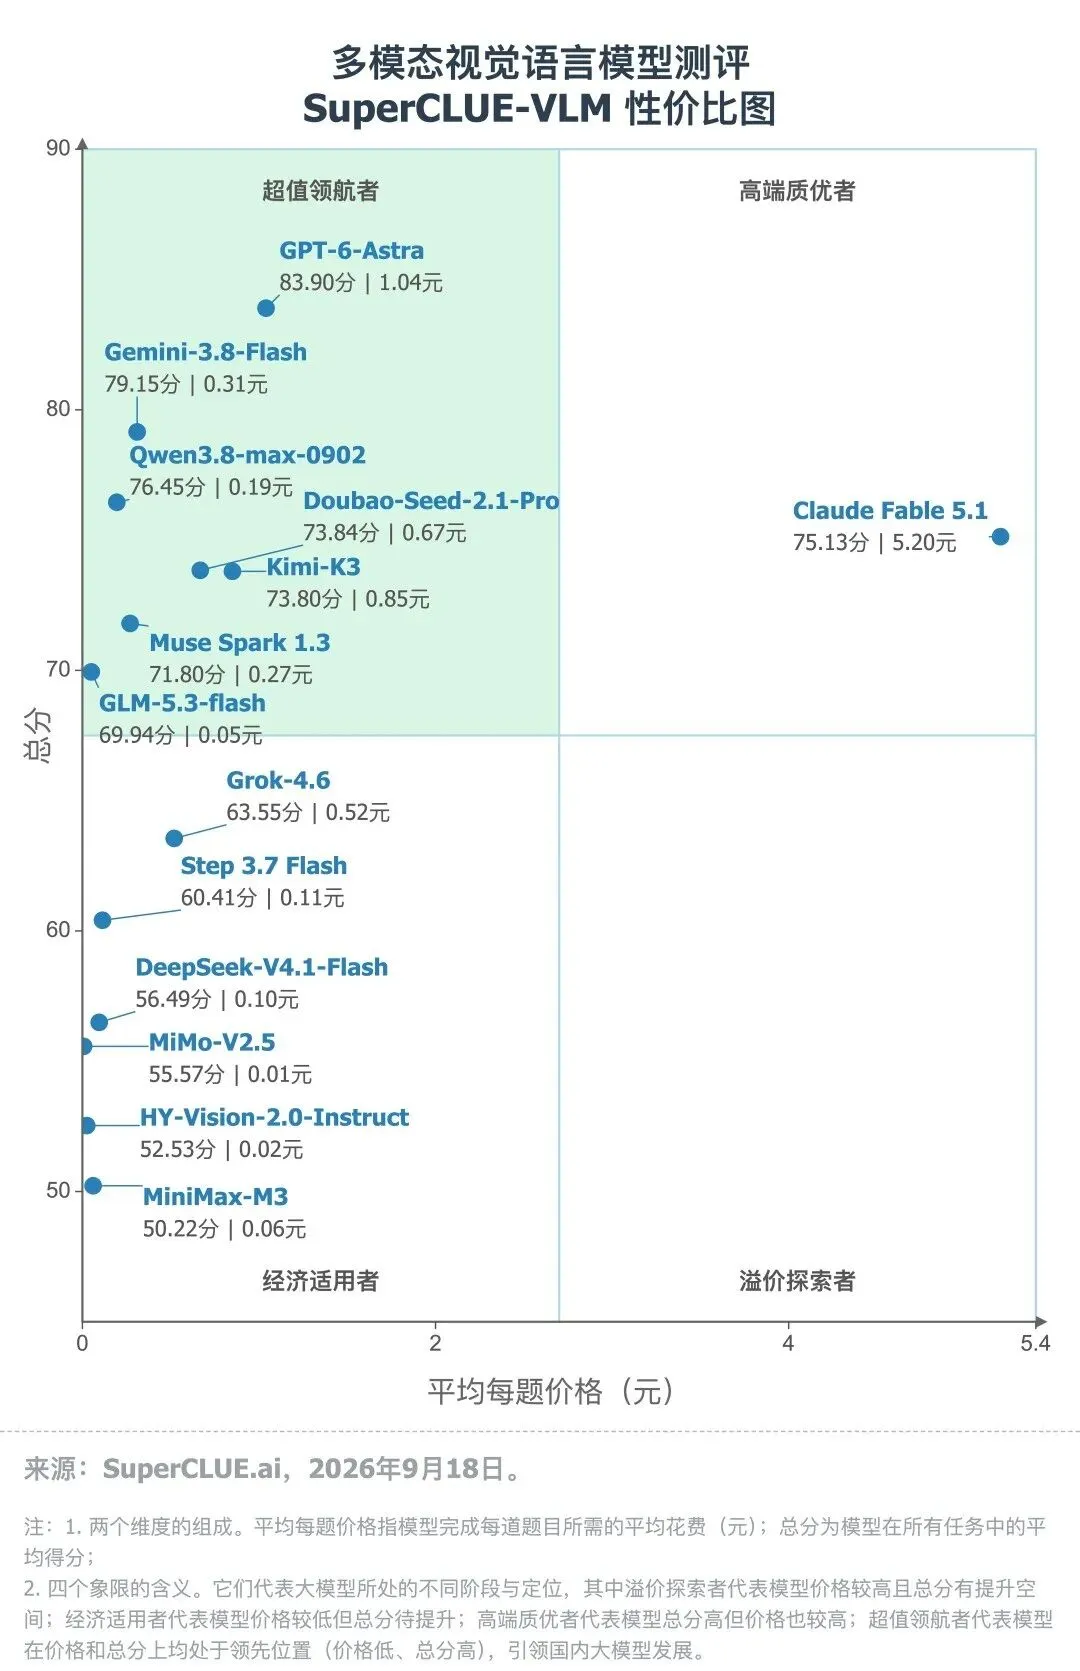
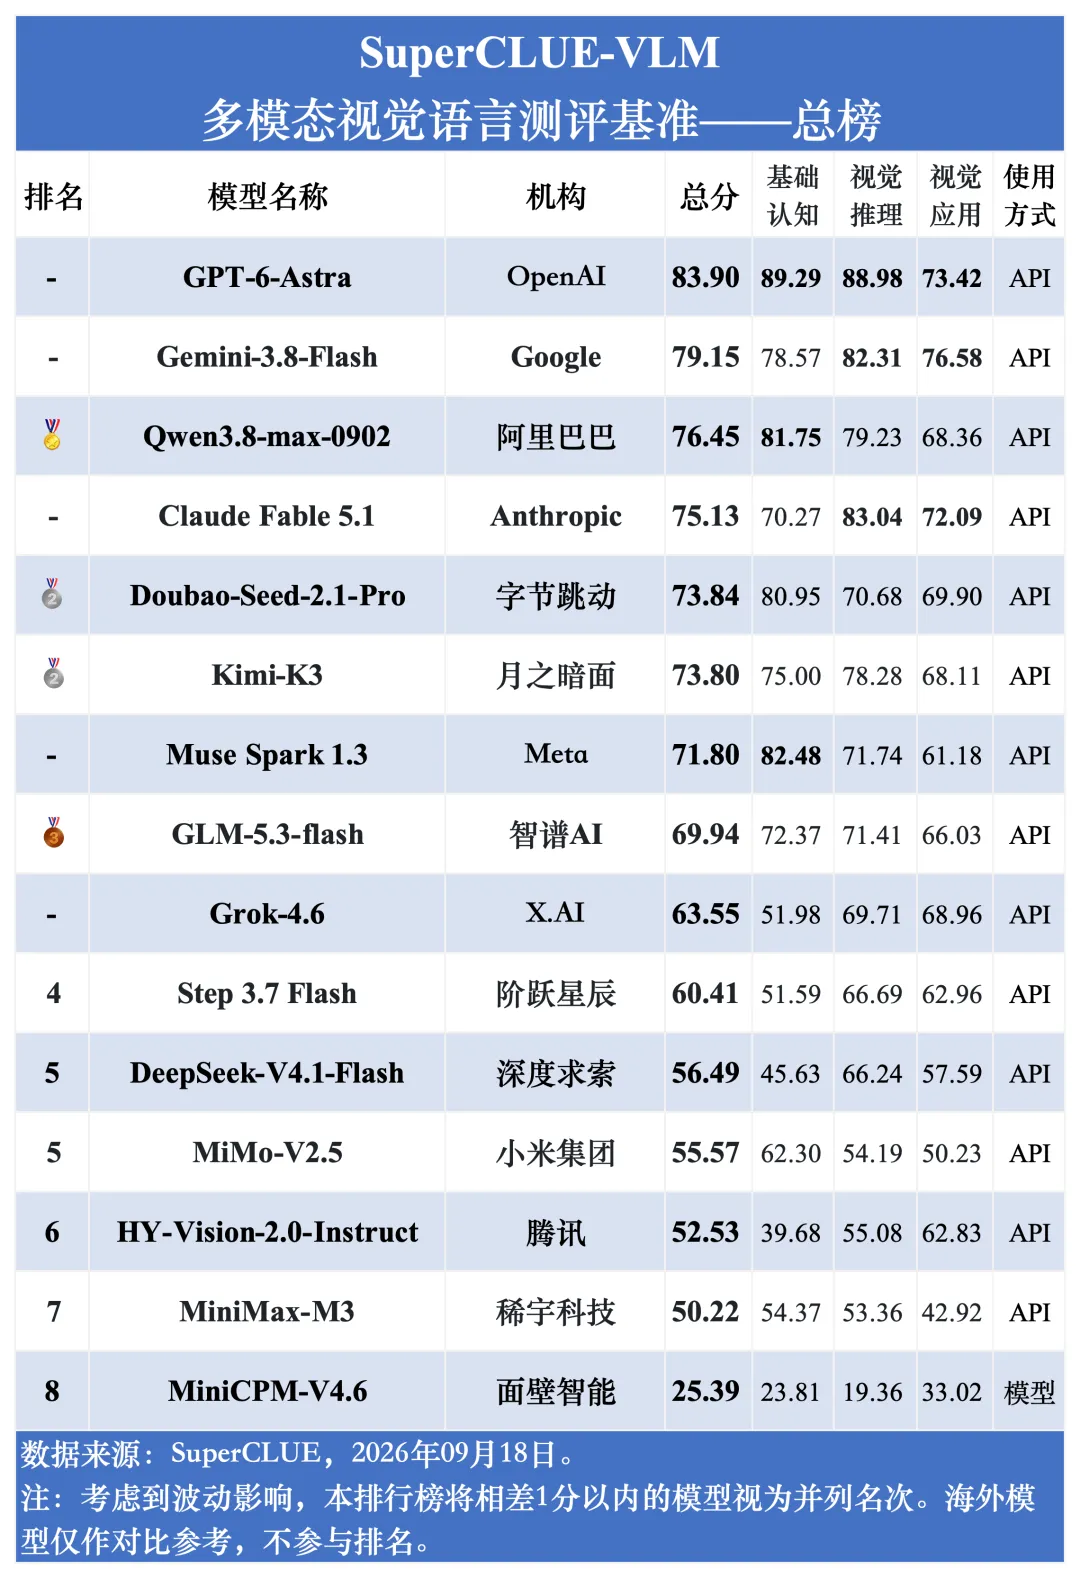
1. GPT-6-Astra问鼎总榜,Qwen3.8-max-0902引领国产模型。
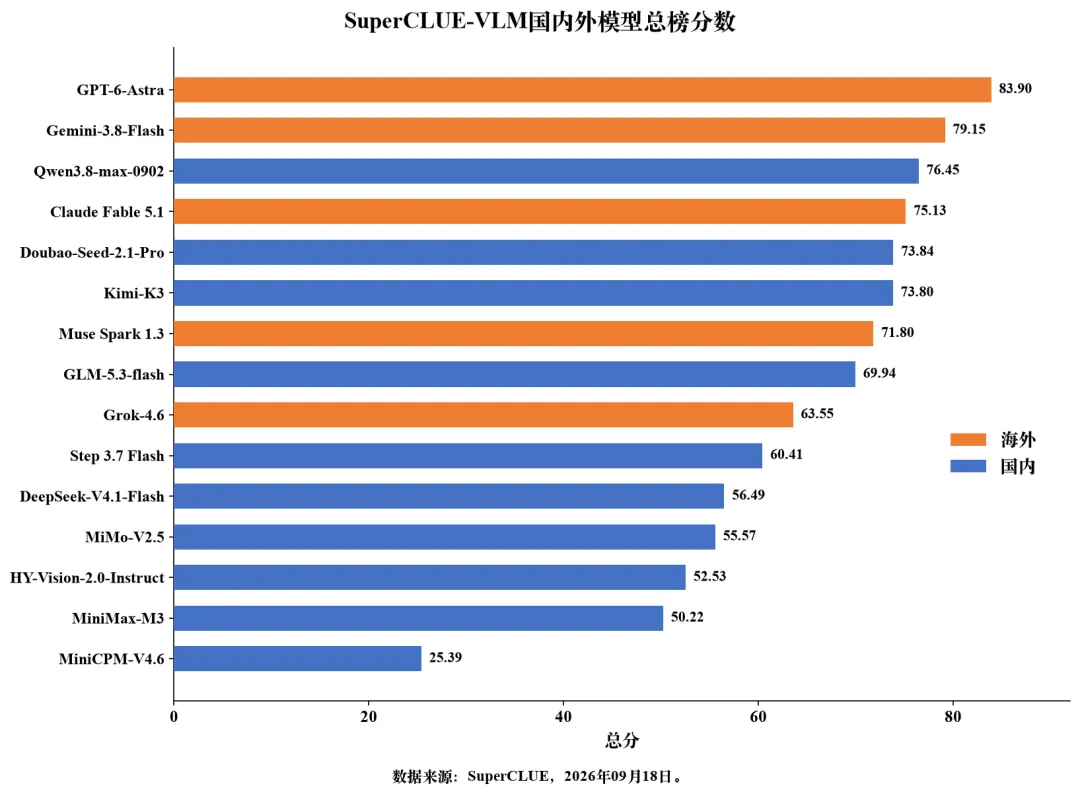
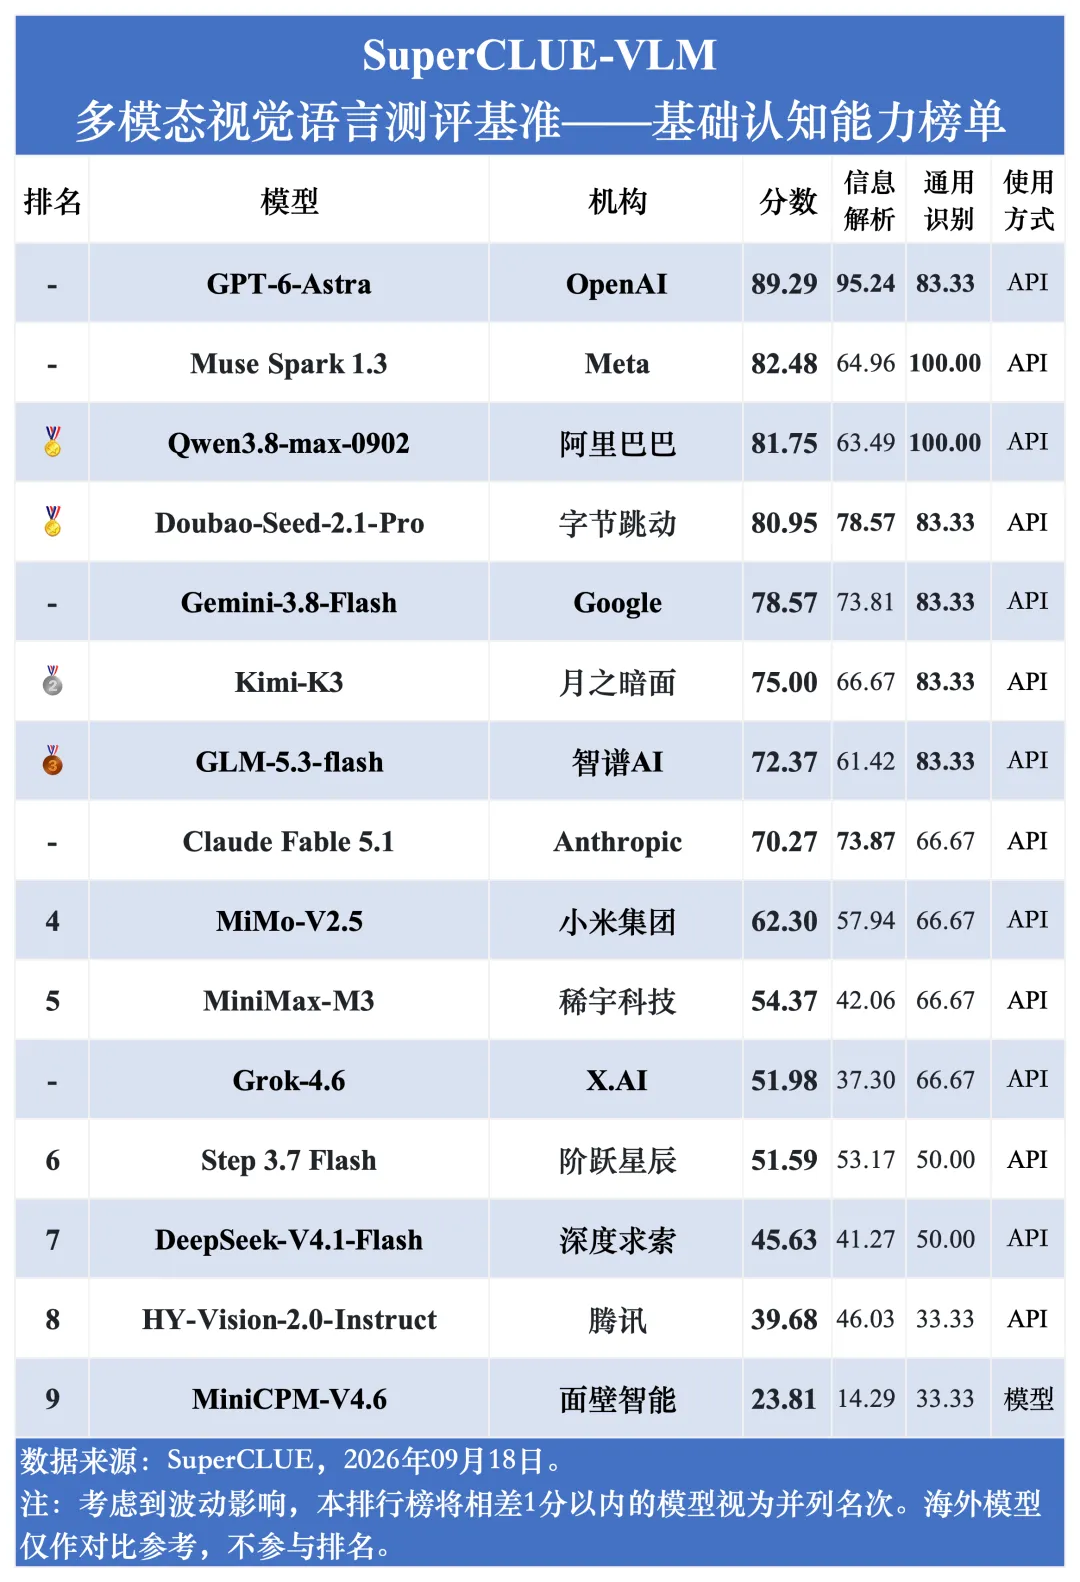
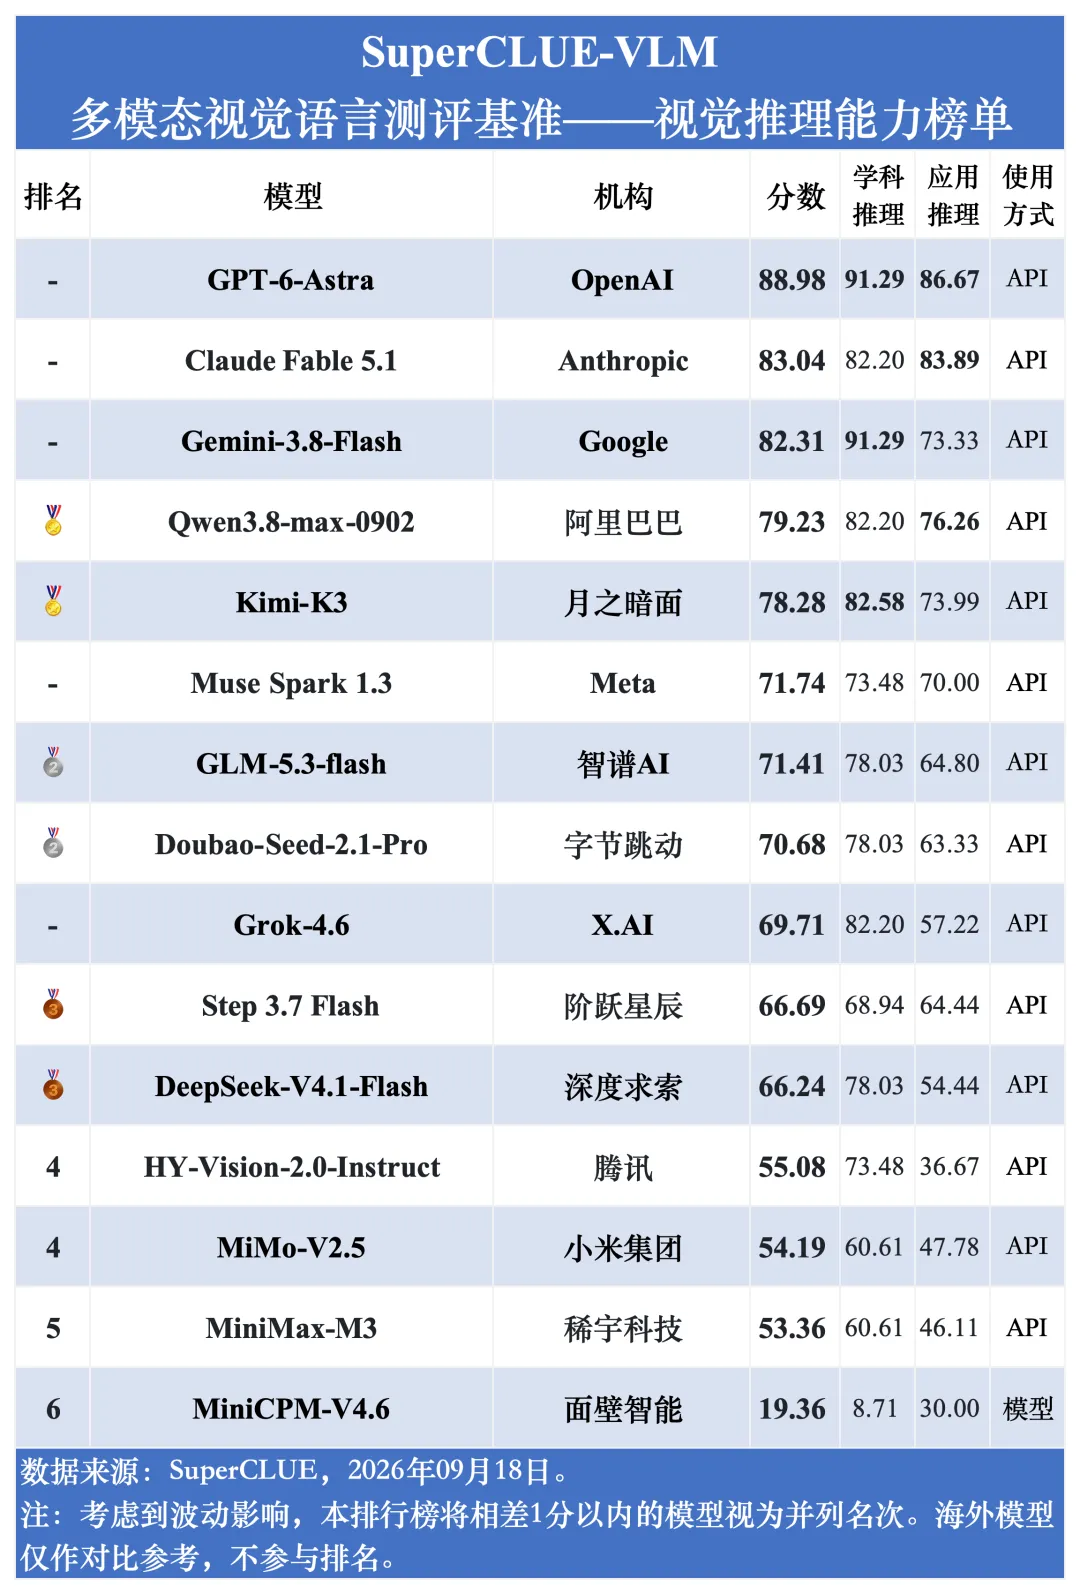
基础认知能力子榜,GPT-6-Astra(89.29分)领跑,国内Qwen3.8-max-0902(81.75分)与Doubao-Seed-2.1-Pro(80.95分)并列国内第一;视觉推理能力子榜,GPT-6-Astra(88.98分)第一,Anthropic的Claude Fable 5.1(83.04分)、Google的Gemini-3.8-Flash(82.31分)紧随其后,国内Qwen3.8-max-0902(79.23分)、Kimi-K3(78.28分)跻身总榜前五。而在视觉应用能力子榜,头名Gemini-3.8-Flash(76.58分)也仅处于70分段,国内Doubao-Seed-2.1-Pro(69.90分)位居国内第一。视觉应用能力整体弱于前两个维度,正成为头部模型拉开差距的关键战场。
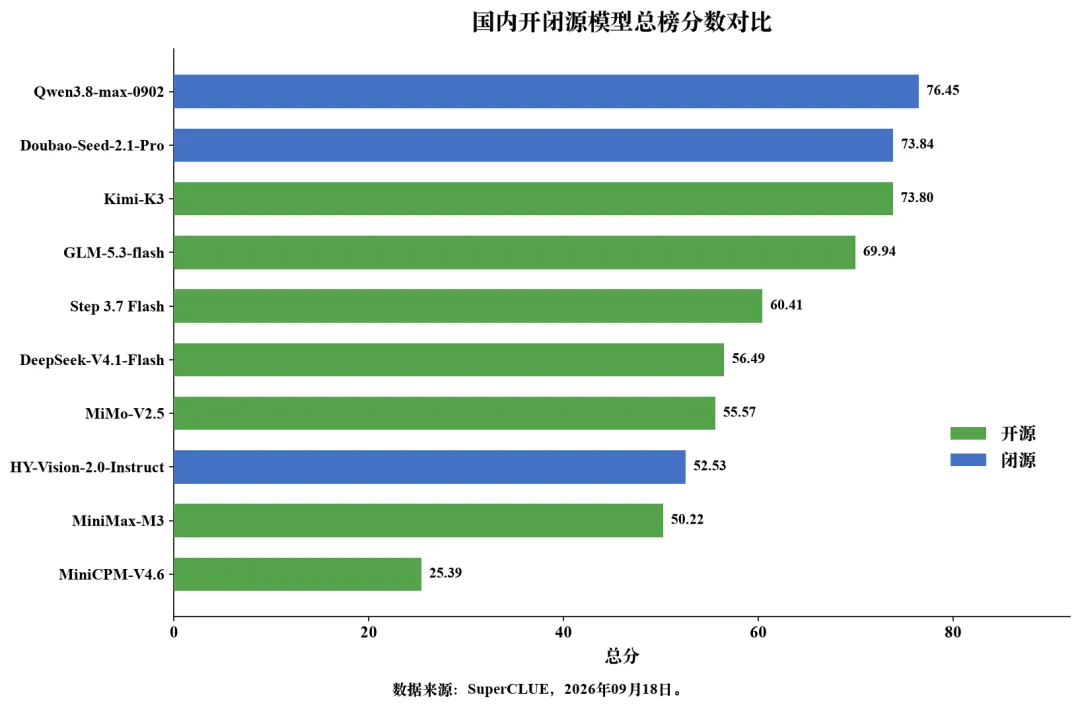
本次参测的10款国内模型中,7款为开源模型。月之暗面的Kimi-K3以开源身份拿下73.80分,与闭源的Doubao-Seed-2.1-Pro并列国内第二,其视觉推理能力(78.28分)位居国内前二;智谱AI的GLM-5.3-flash(69.94分)位居国内第三;阶跃星辰Step 3.7 Flash(60.41分)、深度求索DeepSeek-V4.1-Flash(56.49分)、小米MiMo-V2.5(55.57分)等开源模型亦全部进入国内榜单前列。国产开源多模态模型已具备与闭源模型正面竞争的实力。
# 加入社群
扩展阅读
[1] CLUE官网:www.CLUEBenchmarks.com
[2] SuperCLUE排行榜网站:www.superclueai.com
[3] Github地址:https://github.com/CLUEbenchmark
