AI+EDA 聊到 RTL 调试时,绕不开一个很朴素的问题:你说模型能找 bug,那它到底是在什么 bug 上被考的?
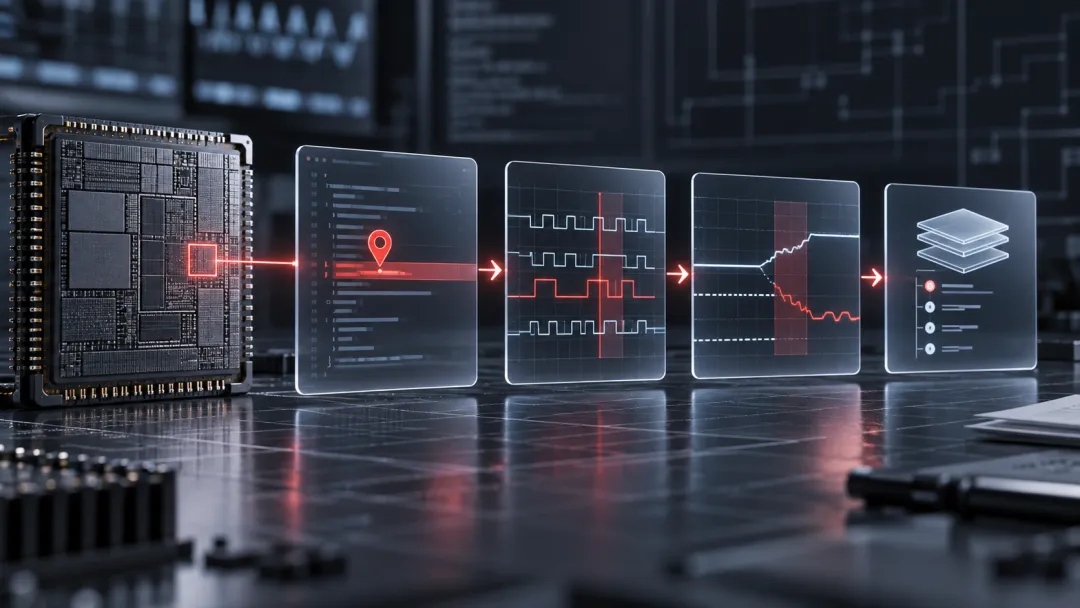
这表面上是 benchmark 数量问题,更深处是证据包问题。一个能用来评测 RTL source-level debugging 的样本,不能只给一份 faulty RTL 文件,还得说清楚故障位置在哪里、testbench 怎么触发、输出差异在哪里、运行环境能不能复现。
VeriBugBench 这篇 9 月 16 日提交到 arXiv 的论文,补的正是这个缺口。作者基于 45 个开源 Verilog RTL 项目构建 VeriBugBench-v1.0,得到 2,608 个可执行、输出可观测的单故障样本,并提供 source-level ground truth、原始与组装后的 testbench、candidate manifest、仿真与 coverage metadata、复现脚本等产物。
最容易传播的数字,是 2,608 和 36.01% 到 39.54%。但这篇论文真正值得看的地方,是它把一个工程问题摆到了台面上:一个 RTL 调试评测样本,怎样才算真的“可调试”?
为什么错代码还不够
软件缺陷定位里,benchmark 往往会给测试失败、补丁、错误文件、行级真值。RTL 调试麻烦得多。Verilog RTL 有并发语义、时序行为、clock/reset、非阻塞赋值和状态传播。一个源代码缺陷未必马上暴露,它可能需要特定激励序列,跑过若干 cycle,最后才在某个输出或 trace 里表现出来。
所以,RTL 调试评测如果只给一个“错误版本”,价值会打折。模型或工具也许能在代码上猜一个可疑行,但它有没有连接到真实可观测失效?testbench 是否真的激活了这个故障?运行产物能不能让后续方法复查?这些问题如果没有答案,benchmark 更像代码片段集合,距离调试研究的实验平台还差一截。
论文在引言里把需求说得很清楚:RTL source-level debugging research 需要 faulty designs、precise change locations、executable test stimuli 和 reproducible configurations。现有 Verilog 资源通常只覆盖其中一部分。
这也解释了 VeriBugBench 的定位。它把真实 bug 历史、受控 mutation、testbench enhancement 和 execution-based retention 绑到一起。换句话说,故障样本必须经过三道门:能构造、能运行、能看见差异。
这套 benchmark 怎么造出来
VeriBugBench 的第一步,是从 RTL bug-fix 历史里抽取 repair pattern,再把修复模式反向映射为 mutation operator。
论文引用的前序经验研究保留了 300 个 Verilog 项目中的 1,298 条 bug-fix-related commit records,并从中得到 expression-level 和 statement/root-level 的 AST edit-action records。VeriBugBench 并未把这些历史 bug 原样堆进数据集,而是把反复出现的修复模式整理为 19 个可执行 inverse mutation operators。
这一步的关键,是让 mutation 不再只是拍脑袋。真实 bug-fix 历史中反复出现的表达式、位选择、赋值、事件控制或声明修复模式,可以反向变成一个受保护的故障注入 operator。operator 只有在 Pyverilog AST 能处理、上下文合法、单点修改可控时才会保留。
第二步,是在 clean RTL project 里找合法注入位置。论文最终统计出 167,750 个 legal opportunities,再经过采样、实例化和去重,得到 7,358 个 instantiated candidates。
第三步,才是最硬的过滤:每个候选故障都要和项目级 assembled testbench 一起编译、仿真,并与 clean design 的观察 trace 做比较。只有执行成功,并且在输出观察字段中产生可观测差异的候选,才会被保留下来。
这一步之后,才有论文里的 2,608 个 executable and output-observable single-fault instances。
这个漏斗很重要。VeriBugBench 把“可执行”和“输出可观测”作为保留条件,没有把所有可能 mutation 都算作 benchmark 样本。对于调试评测来说,这比单纯扩大样本数更有意义。
2,608 个样本,该怎么读
VeriBugBench-v1.0 的 45 个项目来自三组来源:CirFix、RTLLM 和 Native。论文表格显示,总规模为 29,834 SLOC,保留实例数为 2,608,单项目 retained instances 从 7 到 186 不等,中位数为 47。
三个来源的角色也不同。CirFix 提供已经在 RTL repair workflow 中使用过的设计;RTLLM 来自 RTL generation benchmark,体量更紧凑;Native 是作者为研究收集的开源项目,包含更大的层次化控制和 datapath 逻辑。
这意味着 VeriBugBench 有一定多源性,也有边界。它覆盖的是开源 Verilog 项目、单故障 source-level injection 和 Pyverilog 前端接受的 Verilog 子集。论文自己也在 external validity 里写明,扩展到更广泛工业设计、多编辑或 implementation-dependent faults、SystemVerilog,仍是未来工作。
所以,2,608 不能读成“代表工业所有 RTL bug”。更稳妥的读法是:在公开 Verilog 项目和作者定义的构造流程下,它形成了一个规模明显大于许多手工真实 bug 集合、且带有执行真值的调试评测样本池。
对 AI+EDA 研究者来说,这个差别很关键。很多 LLM debug 方法看起来能指出 bug,但如果 benchmark 缺少源码位置真值和运行产物,评测容易滑向“解释是否像样”。VeriBugBench 把评价往“位置、执行、观测、复现”推了一步。
真正可落地的 AI+EDA,很难只靠一个聊天入口解决。芯片企业更关心的是模型能否进入 spec、log、coverage、testbench 和 EDA flow,能否在权限、审计和人工 review 边界内形成可追溯流程。这个方向上,中科麒芯的智语芯、IC 智能知识库和 Flow Builder 更适合被理解为研发链路里的能力拼图:把专业模型、企业知识和流程编排接起来,让 AI 在可控边界内进入具体任务。
36.01% 到 39.54%,要按 testbench 读
论文里另一个容易被误读的数字,是 mean project-level fault observability 从 36.01% 提升到 39.54%。这个指标描述的是作者实验里的故障可观测性,不对应某个 AI 调试模型的准确率,也不属于商业工具效果复测。
它指的是在作者实验里,assembled testbench 相比 original testbench,让更多候选故障在输出 trace 上变得可观测。论文还给出 mutant-level micro-average 从 30.66% 到 35.44%,并称 assembled testbenches 在 aggregate 上多让 352 个 candidates 可观测。
这个结果的意义在 testbench,而不在 debug algorithm。
RTL 故障评测最怕的一件事,是样本存在,但 testbench 看不见它。看不见,就没法要求调试方法找到根因。VeriBugBench 让 LLM 根据 clean DUT 和 original testbench 生成 design-specific stimulus phase,再与原 testbench 组装,用来提高候选故障的激活和传播机会。
这里也必须加边界。LLM 生成 stimulus 是项目级增强,并非针对每个 candidate 偷看答案;但它依然有随机性,fresh run 可能产生不同 candidate 或 stimuli。论文在 reproducibility 部分也说明,released manifests 和 assembled testbenches 定义的是本文评测的 benchmark instance。
因此,这个数字最适合被理解为“testbench 增强后,benchmark 样本的可观测性更好”。把它写成“调试能力提升 3.53 个百分点”,就越过了论文证据边界。
对 AI+EDA 评测真正有用的是什么
在我们看来,VeriBugBench 对 AI+EDA 的价值,在于把考试卷背后的答案格式补齐了,而不仅是给模型一个更大的考试卷。
一个 RTL debug agent 如果要真正进入研发流程,至少要回答四件事:
第一,故障在哪里。合格答案不能停在“状态机有问题”这种泛泛判断上,而要能对到 source-level location 和 operator。
第二,为什么暴露。testbench 是如何激活这个行为的,输出差异出现在什么 trace 上。
第三,怎么复查。别人能否用同一个 manifest、testbench 和配置重跑,得到同样的现象。
第四,边界是什么。这个样本来自何种项目、何种 Verilog 子集、何种 fault model,不能外推到哪些工业场景。
VeriBugBench 把 clean and mutated RTL、operator and source-location ground truth、original and assembled testbenches、candidate manifests、simulation and coverage metadata、reproduction scripts 放在同一个 artifact 里,正是在补这四件事。
这对 LLM 尤其重要。LLM 很擅长给出看似合理的代码解释,也很容易在上下文不足时补故事。调试 benchmark 如果只有代码和自然语言描述,评测很难约束这种“会说”。可执行 artifact 越完整,模型越需要对齐到可复查的证据。
还需要保守的地方
VeriBugBench 仍然只是一个阶段性起点。
第一,它主要还是 Verilog benchmark。工业项目大量使用 SystemVerilog、UVM、复杂 IP 复用、跨时钟域、低功耗、DFT、软件可见寄存器和系统级异常路径。论文也明确说,SystemVerilog 和更复杂 fault 类型仍是未来工作。
第二,它构造的是 single-fault instances。真实项目中的 bug 可能是多点修改、规格误解、接口协议错误、时序约束问题,甚至是实现与验证环境交互造成的 failure。单故障样本适合控制变量,但不等于覆盖真实 debug 全貌。
第三,完整复现实验并不总是零门槛。GitHub README 写明 Synopsys VCS 是原始 benchmark 构造和评估 workflow 的 primary simulation backend,URG 用于 coverage pipeline;Icarus Verilog 只是轻量开源兼容 backend,不能保证支持完整 benchmark,也不等同于 VCS 实验环境。
第四,TCAD 只是投稿状态。arXiv 页面写的是 submitted to IEEE Transactions on Computer-Aided Design of Integrated Circuits and Systems,不代表已经录用。对外写作时,这个边界必须保留。
写在最后
VeriBugBench 最值得行业记住的地方,在于它把 RTL 调试评测的证据链拉长了。2,608 这个数字只是结果之一。
过去问一个 debug 方法好不好,容易只看它能不能指出代码问题。更严肃的问法应该是:故障从哪里来,位置真值是什么,testbench 是否触发,输出差异是否可观测,运行产物是否能复现,边界是否说清楚。
如果 AI+EDA 要从 demo 走向工程流程,benchmark 也必须从“能让模型回答”走向“能让结果复查”。VeriBugBench 在这个方向上补了一块很实际的砖。
它没有解决 RTL debug 的全部评测问题,也不能代表工业 SoC 的所有复杂故障。但它提醒我们:在芯片研发里,评测的可信度不只来自模型分数,也来自真值、激励、trace 和复现环境是否站在同一条链路上。
参考资料
1. arXiv:《VeriBugBench: An Empirically Grounded Framework for Constructing Verilog RTL Debugging Benchmarks》
2. GitHub:wndif/VeriBugBench
3. DAC 2023:《MANTRA: Mutation Testing of Hardware Design Code Based on Real Bugs》
作者:麒芯
声明:本文基于公开论文和开源仓库资料整理分析,不构成投资建议,也不代表对任何调试工具、benchmark 或工业流程的第三方复测结论。