SWE-Bench Pro 主要由具有挑战性的仓库级编程任务构成,一直被广泛用于编程智能体和模型的代码能力评测。它曾被 OpenAI 推荐用于替代 SWE-Bench Verified,随后又在 7 月被 OpenAI 撤回推荐。各家模型在 SWE-Bench Pro 上的分数一路“水涨船高”。但一个更重要的问题也随之出现:
这样的高分,反映的真的是模型的真实能力吗?
上海人工智能实验室研究团队基于OpenAI此前发布的相关内容及社区用户反馈,对多个模型在SWE-Bench Pro上的运行轨迹进行了一次全面的“体检”分析。
分析发现,智能体完全可能从仓库 Git 信息中“考古”出未来的修复提交,从本地文件系统中读取隐藏测试文件,从任务元数据中反推出目标修复的 commit,甚至直接从 GitHub、Gitee、Hugging Face 等站点下载补丁或读取 testcase 信息。
除此之外,还有一类更隐蔽的问题来自考题本身:有的任务描述与测试要求互相矛盾;有的测试过窄,语义正确的实现仅仅因为实现风格不同就被判错;还有的测试过宽,残缺的修复反而能够蒙混过关。
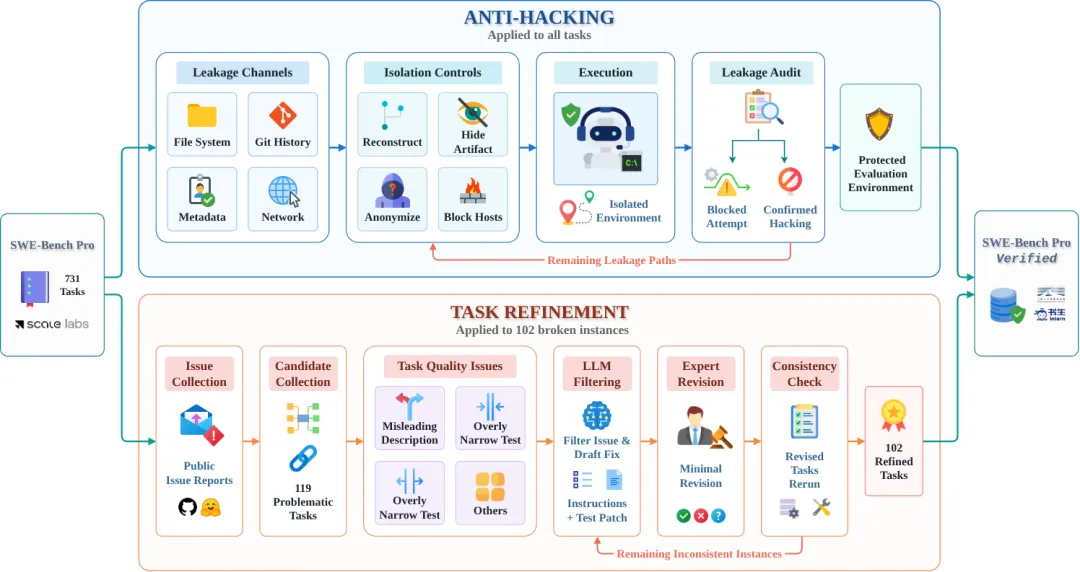
针对上述问题,研究团队在论文 《SWE-Bench Pro Verified: A Reliable Benchmark for Software Engineering Agents》 中提出 SWE-Bench Pro Verified。该基准通过反作弊隔离与任务修订两条处理管线,分别加强评测过程中的信息隔离,并修正已确认的任务质量缺陷,为软件工程智能体提供更可靠的评测依据。
https://arxiv.org/abs/2609.08149
司南评测集社区地址:
https://hub.opencompass.org.cn/dataset-detail/SWE-Bench_Pro_Verified
HuggingFace评测集地址:https://huggingface.co/datasets/opencompass/SWEBench-Pro-Verified
https://github.com/open-compass/AgentCompass
https://agent-compass.mintlify.app/en/user_guide/modules/benchmarks/swebench_pro_verified
SWE-Bench Pro 要求智能体在真实代码仓库中定位问题、修改代码,并通过 fail-to-pass 与 pass-to-pass 测试。按照评测要求,未来修复提交、参考补丁和隐藏测试不应对智能体开放。然而,研究团队发现,原始环境中仍存在获取这些信息的路径,可能使评测成绩受到任务解决能力之外的因素影响。
团队的排查梳理出四条主要的答案泄露通道:
| | |
| | |
| | |
| | 上游 commit、补丁、测试、API、源文件、代码站点、 包管理站点(pip install / go get ...) |
| | |
任务质量问题是另一重失真来源。在全部问题实例中,团队归纳出四类缺陷:
传统基准考的是"解题能力",泄露的基准考的却是"找答案能力";再叠加一批"印错了的考题",榜单分数与真实工程能力之间的鸿沟,也就不难理解了。
针对已识别的答案泄露风险,研究团队从本地环境与外部网络两个层面对执行环境进行加固,主要采取以下四项措施:
仓库重建:将每个仓库重建为全新的单提交仓库,递归清除嵌套 Git 历史。仅删除分支、远端和标签引用,仍可能保留 notes、replace 引用及 stash 中的历史对象,使未来修复提交被恢复。新方案在清理历史对象的同时保留依赖与环境文件,保障仓库正常构建与执行;
测试文件隐藏:从智能体工作区中显式删除隐藏测试,清理测试目录下的测试套件和golden数据,并禁用容器镜像中预装的 Git hooks,防止隐藏文件在 checkout 时被意外还原;
元数据过滤与匿名化:通过白名单过滤任务元数据,剔除参考补丁、测试列表等真值字段;执行前将实例 ID 替换为哈希,并对工作区与文件路径同步匿名化,减少通过仓库身份信息反向查询答案的风险;
网络封锁:屏蔽已知代码、数据集托管域名,同时保留依赖服务,确保正常交互的构建与依赖下载不受影响。
隔离措施既需要有效限制答案信息的获取,也需要保障智能体阅读代码、运行程序和安装依赖等正常操作。研究团队进一步通过轨迹审计与逐例归因,评估防护措施的有效性及其对正常任务执行的影响。
任务修订采用“LLM 辅助分析、专家审核修订”的协作流程。研究团队首先从公开问题报告中收集证据并归类质量缺陷,再由 LLM 辅助筛选实例、拟定修订方案,最终由人类专家依据“最小修改”原则完成审核与修订。LLM 仅承担辅助工作,所有修订均由专家确认,最终完成 102 个实例的质量修正。
大部分修订集中于 requirements、interface 等任务说明,其中17个实例涉及测试逻辑调整。修订重点是明确任务要求与预期行为,使符合要求的实现能够通过测试,避免因未规定的实现细节而被判定为失败,同时减少不完整修复通过测试的情况。
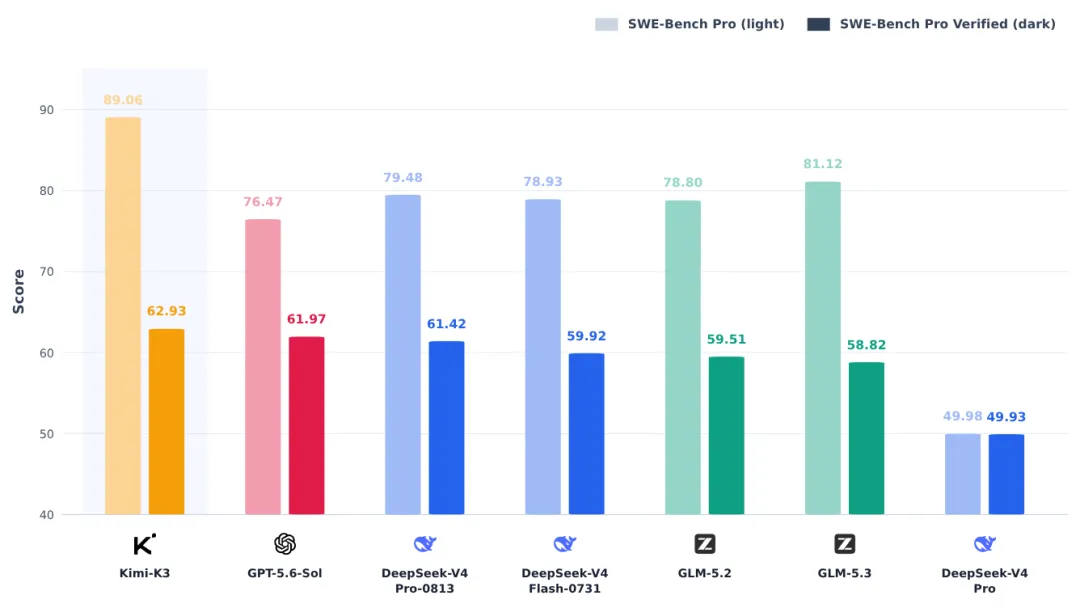
团队在统一环境下对 7 个主流模型进行了评测验证:GPT-5.6-Sol、Kimi-K3、GLM-5.3、GLM-5.2、DeepSeek-V4-Pro、DeepSeek-V4-Flash-0731 与 DeepSeek-V4-Pro-0813。所有评测基于 AgentCompass 基础设施,统一使用 mini-swe-agent 作为 harness,运行参数取各模型官方推荐值。
为了分离两种修复的作用,评测在三种设置下进行:
在SWE-Bench Pro Verified上的评测结果分析中发现:
任务修订则带来了正向修复:两个模型在 Verified 设置下均较 Anti-hacking 有所回升,说明一部分此前"出错了的考题"重新变得可解。
归因验证:
降分是"防住了作弊",不是"干扰了发挥"
为进一步分析成绩变化的原因,研究团队从答案泄露审计、统计检验和逐例审查三个层面开展验证,重点考察隔离措施是否有效阻断答案获取,以及是否影响智能体的正常执行。
第一层:泄露通道被彻底堵死。 对 GLM-5.2 全部 731 条轨迹的配对分析显示,本地高危操作从 4,213 次降至 908 次(-78.4%),网络高危操作从 573 次降至 4 次(-99.3%);更关键的是,确认访问到答案文件的任务数从本地 103 个、网络 49 个,双双降为 0。此前最直接的作弊手法——用 git show 直接查看目标commit (2,108次)、访问 raw.githubusercontent.com 下载源文件(318 次)——几乎被完全消除。
90.9% 的降分可直接或高度可能归因于作弊被阻断,没有一例被判定为隔离环境损害了正常执行。
任务修订的有效性也得到了实例级验证。在 102 个修订实例中,21个由 FAIL 转为 PASS,仅2个由 PASS 转为 FAIL。修订主要完善了精确常量、集合与顺序语义、默认值与返回结构、控制流边界及接口定义等要求,减少因任务说明不明确造成的实现误判。
SWE-Bench Pro Verified 的核心价值在于加强评测信息隔离、完善任务质量,并通过结果验证提升能力测量的可靠性与可解释性。
首先,研究结果提示,答案泄露与任务质量缺陷可能影响原始 SWE-Bench Pro 成绩,相关比较应结合评测环境、执行框架与运行配置进行解读。其次,反作弊隔离、任务修订及归因验证流程,为其他智能体基准的可靠性改进提供了参考。最后,包含 731 个实例的修订版基准及相关代码、数据已开源,支持研究者在明确的实验条件下开展复现与比较。
研究团队同时指出,当前方案仍存在一定局限:域名黑名单难以覆盖所有自托管 Git 服务与动态域名,个别仓库可能保留残余信息,任务质量问题的排查也未必穷尽。评测可靠性的提升需要持续开展风险排查、任务复核与防护更新。
对智能编程领域而言,可靠的评测是分析技术进展的重要基础。持续完善信息隔离、任务质量与结果验证,有助于减少非能力因素对成绩的影响,为模型研发、能力分析与应用选型提供更加客观的参考。
以更可靠的评测流程,为软件工程智能体的能力分析提供坚实基础。
想在自己的模型上复现这套可信评测?欢迎体验AgentCompass! (https://github.com/open-compass/AgentCompass)。
框架面向智能体评测场景,提供反作弊隔离执行环境、轨迹分析与统一评测支持,便于在明确的实验条件下开展能力评估与结果分析。