1、什么是模型评测
模型评测的本质是在指定条件下量化模型能力:用固定的评测集(prompt + 标准答案)驱动模型产生输出,再按统一规则打分,得到可复现、可比较的指标。它解决的核心问题是“凭感觉评估不可靠“,只有同规则、同环境下测出的数字,才能支撑选型和微调决策。
OpenCompass(司南),是目前主流的一站式模型评测工具。由上海人工智能实验室开发和开源。内置 100 多个评测集(约 40 万道题),支持 HuggingFace 权重模型与 API 模型,它的评测对象分两类:
这两类模型的评测方式不同,分数不能跨类型直接比较。
2、OpenCompass 的评测原理
1. OpenCompass 的四阶段流水线:
配置(Configure):选择模型(HF / API / 自定义)和数据集,确定评测策略、计算后端与结果展示方式。配置以 Python 文件组织,是每次实验的完整记录。
推理(Inference):让模型在评测集上产生输出。这一阶段的计算量最大,是并行优化的重点。
评估(Evaluation):将模型输出与标准答案比对,计算指标。
可视化(Visualization):汇总为 CSV / TXT 结果表,支持上报飞书实时查看。
命令层面用--mode控制阶段:all(默认,推理+评估)、infer、eval、viz。
需要注意的是,OpenCompass 的核心评测流程主要是 CLI + Python 配置文件驱动,没有 UI 操作界面。
2. 运行模型推理:Inferencer + Partitioner + Runner
推理不是简单地"把数据集喂给模型",而是三个模块协作:
Inferencer(推理器):决定模型以何种方式作答,对应两种评测范式——生成式用 GenInferencer,判别式用 PPLInferencer。
Partitioner(任务划分器):把“模型 × 数据集”这个大任务拆成可并行的小任务,常用策略有 NaivePartitioner,每个模型-数据集组合一个任务、NumWorkerPartitioner,推理阶段默认,按 worker 数均分、SizePartitioner按预估推理成本切分/合并,让各任务耗时均衡。
Runner(运行器):把任务调度到执行环境,支持 LocalRunner 本机并行、
SlurmRunner 集群、DLCRunner 阿里云 DLC。
对应的任务类型是 OpenICLInferTask(推理)和 OpenICLEvalTask(评估)。这套抽象的意义:同一个评测,单卡、多卡、集群只需换 Runner 配置,评测逻辑不变。
3. 评分机制:判别式与生成式
OpenCompass 依据标准答案的类型选择评分方式,这是理解"分数怎么来的"的关键:
判别式评测(PPL,数据集后缀 _ppl):适用于选择题/判断题。把问题与每个候选答案拼接成完整文本,分别输入模型计算困惑度(perplexity),选择困惑度最小的候选作为模型答案——困惑度越低,说明模型对该文本越"熟悉",即认为它越合理。基座模型常用于此类评测,因为无需生成能力,直接利用模型的语言建模先验。
生成式评测(GEN,数据集后缀 _gen):适用于问答、翻译、代码、逻辑题。问题作为输入,让模型自由生成答案;输出经过后处理(如提取首个大写字母、抽取数学答案、规范化文本)后与标准答案比对。对话模型只使用这种方式。
指标同样由答案类型决定:
选项类用 ACCEvaluator(正确率,如 MMLU/C-Eval);
短语类用 EMEvaluator(完全匹配率,如 DROP);
句子类用 BleuEvaluator(BLEU,如 Flores);段落类用 RougeEvaluator(ROUGE,如 XSum);
代码类用 HumanEvalEvaluator / MBPPEvaluator(执行通过率、pass@k);
无标准答案的场景可用 ToxicEvaluator 等外部打分。此外,GenericLLMEvaluator(LLM-as-judge)和 MATHVerifyEvaluator(数学答案校验)用于规则无法覆盖的场景。
4. 提示词机制:OpenICL 框架
OpenCompass 评测时,模型输入的 Prompt 通常不是简单的“裸题”,而是由数据集的 Prompt Template 根据评测配置构造。
我们先看看两种不同的提问方式:
1. Zero-shot
例如测试题:中国的首都是哪里?直接给模型:中国的首都是哪里?模型回答:北京
Zero-shot 提问时不向模型提供示例,直接回答。
2. Few-shot
如果是 Few-shot,Prompt 可能变成:
示例1:问题:法国的首都是哪里?答案:巴黎 示例2:问题:日本的首都是哪里?答案:东京 现在请回答:问题:中国的首都是哪里?答案:
模型根据前面的两个示例,就知道这是一种问题,需要补充答案。
这就是 Few-shot ICL(In-context Learning),它在让模型回答测试题之前,先在 Prompt 里给它几个“题目 + 正确答案”的例子,让模型根据这些例子理解当前任务,再回答真正的测试题。
在 OpenCompass 的 Few-shot 评测中,主要通过 Retriever 从示例数据中选取上下文示例(ICE, In-Context Examples),再把示例格式化,与题目一起组成最终 Prompt。
OpenCompass 中主要用到 OpenICL 来进行 ICL 相关的 Prompt 构造、示例检索和推理。
3、环境准备
OpenCompass 是 Python 框架,因此推荐准备 Python 3.10 运行环境。你可以直接使用 pip install opencompass 安装,但为了方便学习其内部原理,建议采用源码的方式安装:
conda create -n opencompass python=3.10 -yconda activate opencompassgit clone https://github.com/open-compass/opencompass.gitcd opencompasspip install -e .# 需要更多数据集/代码评测时:# pip install "opencompass[full]"
安装完成后即可使用以下 OpenCompass 常用指令:
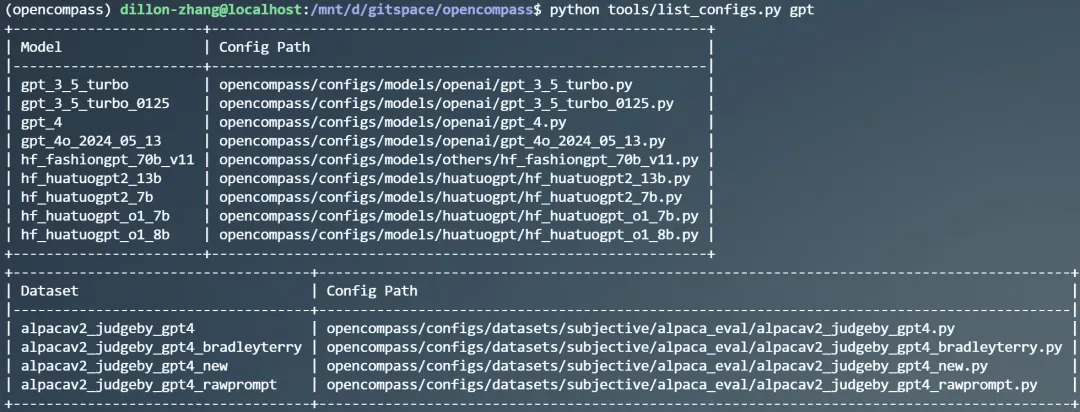
查看可用配置:
python tools/list_configs.py # 列出全部模型与数据集配置python tools/list_configs.py gpt # 按关键词过滤
运行评测(两种入口等价):
# CLI 方式:简单场景推荐opencompass --models gpt_4o_2024_05_13 --datasets demo_gsm8k_chat_gen# 脚本方式:复杂实验(多模型对比、微调评测)推荐写配置文件python run.py examples/eval_chat_demo.py# 查看更多指令opencompass --help # 或 python run.py --help
| |
|---|
--debug | |
-w <目录> | |
-r [时间戳|latest] | 复用已有推理结果,跳过已完成任务(改配置重跑不重推理) |
--mode all|infer|eval|viz | 执行阶段:全部(默认)/ 只推理 / 只评估 / 只出结果表 |
--max-num-workers N | |
--dry-run | |
--dump-eval-details | 结果里带逐样本对错详情(默认开启,用于分析章节的 "查错误样本") |
-a vllm | |
--hf-type chat|base | 命令行直接评测 HF 模型(本地权重或 HuggingFace 仓库名) |
--peft-path <目录> | |
--models | |
4、测试方法一:API 模型评测(无需 GPU)
模型在远程服务器上,本地只做请求与判分。OpenCompass 官方支持 OpenAI、智谱 ChatGLM、MiniMax、讯飞星火,LiteLLM 网关可接入 100+ 供应商。
注意:--models 传的值是 OpenCompass 的"预设配置名",不是厂商官网的模型 ID。
如何确定 --models 的标准值
--models 的值必须是 OpenCompass 内置配置的简称(如 gpt_4o_2024_05_13、hf_internlm2_chat_1_8b),由 OpenCompass 自己命名。标准值只有一个权威来源:OpenCompass 的配置库。查询方式:
输出第一列就是可传给 --models 的标准值。查到标准值后直接使用:
export OPENAI_API_KEY="你的Key"# Windows: set OPENAI_API_KEY=你的Keyopencompass --models gpt_4o_2024_05_13 --datasets demo_gsm8k_chat_gen --debug
没有内置配置时:自定义 API 模型配置
很多新模型(如小米 MiMo、豆包等)OpenCompass 可能尚未内置配置,此时直接 --models mimo-v2.5 会报“找不到配置”。解法是写一个 Python 配置文件,用 OpenAI 兼容 API 接入,内容如下,保存成 eval_mimo.py。
from mmengine.config import read_basefrom opencompass.models import OpenAISDKwith read_base(): from opencompass.configs.datasets.demo.demo_gsm8k_chat_gen import gsm8k_datasetsmodels = [ dict( type=OpenAISDK, abbr='MiMo-v2.5-Pro', # 结果表里的简称,可自定 path='mimo-v2.5-pro', # 请求时的模型名(厂商模型 ID) key='你的MiMo_API_KEY',# 在 platform.xiaomimimo.com 申请 openai_api_base='https://api.xiaomimimo.com/v1', # 厂商 OpenAI 兼容端点 max_seq_len=8192, # 最大输入长度 max_out_len=1024, # 最大生成长度 batch_size=1, # API 一般设为 1 run_cfg=dict(num_gpus=0),# API 模型不占 GPU )]datasets = gsm8k_datasets
运行:
python run.py eval_mimo.py --debug
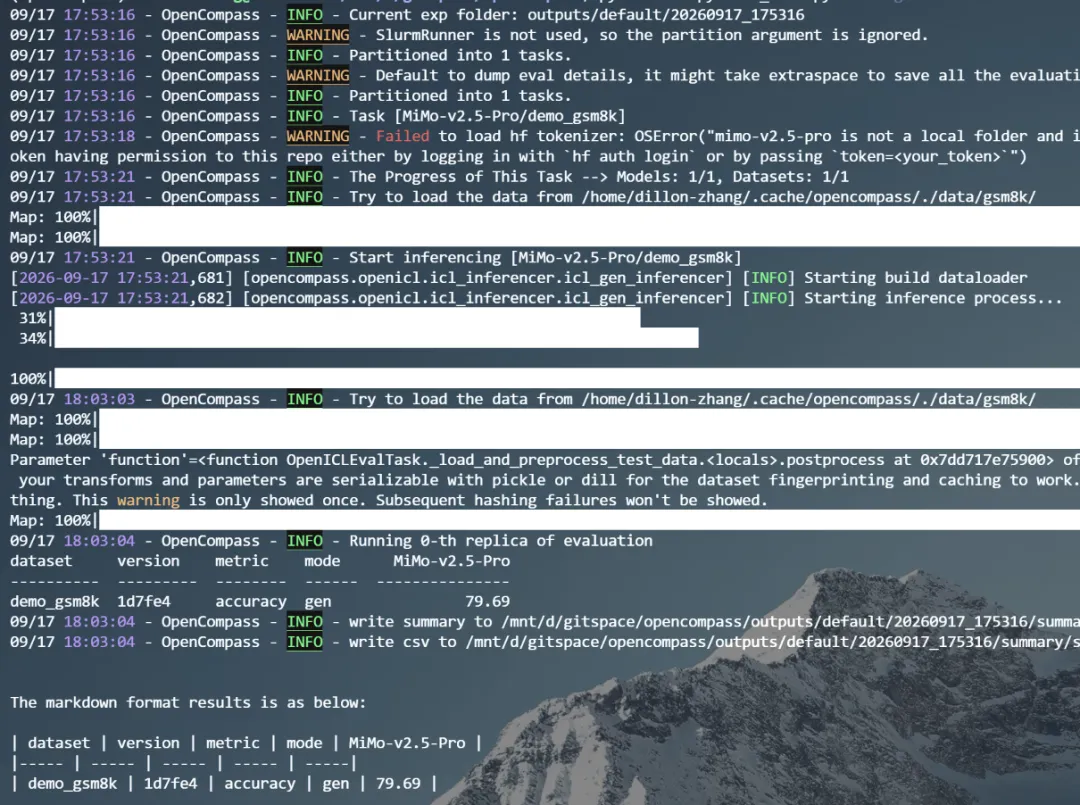
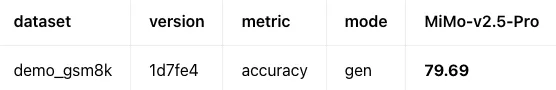
以上是对小米 Mimo-V2.5-Pro 模型进行的一次评测,采用的数据集是 GSM8K 前 64 题,结果是答对 51 题。这就是一次采用 LLM API 方式进行模型评测一个完整示例。5、测试方法二:本地模型评测(需 GPU)
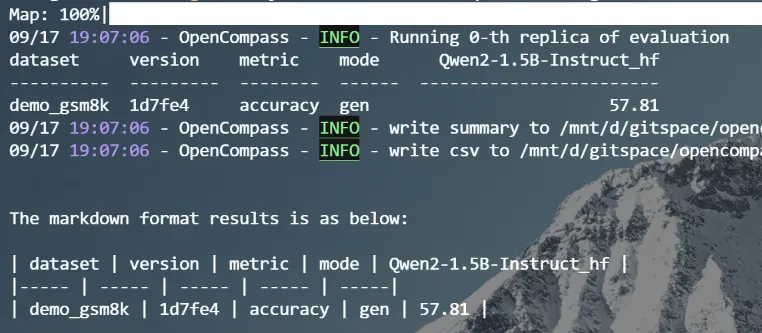
评测开源模型或自研微调模型的核心时可以采用本地运行模型的方式来测试。第一次练手建议选1.5B 参数级别的模型(如 Qwen2-1.5B-Instruct),6GB 显存即可跑;8B 以上注意显存规划。
opencompass --datasets demo_gsm8k_chat_gen \ --hf-type chat \ --hf-path Qwen/Qwen2-1.5B-Instruct \ --debug
运行说明:--hf-path 填 HuggingFace 仓库名会先自动下载权重(首次较慢);填本地目录则直接加载。若显存不足,按下方参数表调整 --batch-size、--hf-num-gpus;如果模型较大,建议用 -a vllm 加速。
以上是本地运行 Qwen2-1.5B-Instruct 模型的评测结果,同样采用 demo_gsm8k (64 题),Qwen2-1.5B 是 1.5B 的小模型,57.81% 在 GSM8K 上属于该量级的正常水平。
需要注意的是,目前最新的 OpenCompass 0.5.4 版本不支持 transforms 5 ,因此需要降级到 transformers 到 4.x
pip install "transformers<5"
opencompass 评测本地模型的常用参数解释:
| |
|---|
| 模型类型:chat(对话模型)或 base(基座模型),决定评测范式(chat 只走生成式) |
| 模型地址:HuggingFace 仓库名(自动下载)或本地权重目录(需含 config.json 与 tokenizer 文件) |
| 最大生成长度(token)。代码、推理题输出长,建议调大到 1024+ |
| 单个模型实例占用的 GPU 数。大模型显存不够时设 2/4/8 |
| 推理批大小。显存溢出时调小(如 8 → 1),代价是变慢 |
| 生成参数(如 do_sample、temperature)。要分数可复现时设 do_sample=False |
| |
| 串行执行、实时日志;默认并行模式下后端任务失败只弹警告,新手排错必加 |
| |
6、测试方法三:多模型对比
如果要进行模型微调前后对比的评测,常用操作是用同一评测集让多个模型同时考,OpenCompass 直接出对比表,避免跨实验的环境误差。API 模型和本地模型可以混在同一命令里对比(如 GPT-4 作基线 vs 本地微调模型)。
opencompass --models hf_internlm2_chat_1_8b hf_qwen2_1_5b_instruct \ --datasets demo_gsm8k_chat_gen demo_math_chat_gen
上面这个示例是评测两个模型:InternLM2-1.8B-Chat、Qwen2-1.5B-Instruct(都是内置配置名,自动从 HuggingFace 下载),一共采用两个数据集:GSM8K(数学推理)、MATH(数学竞赛)的 demo 精简版。一共会进行 2 模型 × 2 数据集 = 4 个评测任务,生成两个模型的对比结果。
具体方法参数解释:
| |
|---|
| 一次传入多个模型配置名,结果表每个模型一列;本地模型也可用 --hf-path 形式加入 |
| 一次传入多个评测集,按能力维度组合(如知识+数学+代码),每个评测集一行 |
| 控制并行度;多模型多数据集同时跑时,按 GPU 资源合理设置,避免排队过久 |
| 小规模试跑时建议开启,确认所有模型-评测集组合都能跑通 |
对比要点:只对比同类模型(chat vs chat、base vs base);所有模型必须使用同一套评测集与提示词配置,否则分数不可比。
7、测试方法四:微调模型评测
完整权重评测:全参微调产物是标准 transformers 权重目录,把 --hf-path 指向该目录即可(目录需含 config.json 与 tokenizer 文件)。
opencompass --datasets demo_gsm8k_chat_gen \ --hf-type chat \ --hf-path /path/to/your/finetuned-model \ --debug
LoRA评测:用 --peft-path 直接挂载 adapter,无需预先合并权重:
python run.py --datasets demo_gsm8k_chat_gen \ --hf-type chat \ --hf-path Qwen/Qwen2-1.5B-Instruct \ --peft-path /path/to/lora-adapter \ --debug
使用 vLLM 提升推理速度
# 先装:pip install "opencompass[vllm]"opencompass --datasets demo_gsm8k_chat_gen --hf-type chat \ --hf-path /path/to/your/model -a vllm
同一模型同一数据集,使用 vLLM 推理会比 HuggingFace快很多,因此大模型评测建议直接上 vLLM。
微调模型评测相关参数解释:
| |
|---|
| 微调模型基座:完整权重目录(全参微调)或 LoRA 对应的基座模型(如 Qwen2-1.5B-Instruct) |
| LoRA adapter 路径,挂在基座之上参与评测;无需先手动合并权重 |
| 构建 adapter 的附加参数(如 trust_remote_code=True) |
| 切换 vLLM 推理后端,约 3 倍提速;也可用 -a lmdeploy |
| 微调后模型输出习惯可能与基座不同,长输出任务(代码/推理)记得调大 |
| 对比实验必须与基座完全一致(如 do_sample 设置),否则增量不可信 |
微调前后对比的方法
只改模型地址,其余配置(评测集、few-shot、生成参数)完全一致,否则分数不可比。
把基座与微调后模型放进同一条命令,由 OpenCompass 出对比表,避免跨实验误差。
关注增量而非绝对值:绝对分依赖数据集版本和 prompt 口径,没有跨环境可比性;"微调前 50 → 微调后 60"才有决策意义。
8、如何分析评测结果
跑完评测只是第一步,分数的解读才是决策的依据。以下按从浅到深的顺序给出分析路径。
第一步:读结果表
每一列的含义:dataset 评测集名;version 数据集版本(复现依据); metric 指标(accuracy 即正确率); mode 评测范式(gen 生成式 / ppl 判别式);后续每列是一个模型的得分。分数含义由 metric 决定:accuracy 是"做对的题占全部题的百分比",BLEU/ROUGE 是文本相似度,pass@k 是代码执行通过率。
第二步:按能力维度拆开看
模型经常偏科——数学强、知识弱是常态。评测集和能力的对应关系:
决策时结合业务场景给维度加权:做数学应用就重点看 GSM8K/MATH,做代码助手就看 HumanEval/MBPP,而不是拿总分一刀切。
第三步:做对比分析
微调前后:看每个评测集的增量,涨跌一起看,指令微调可能提升 GSM8K 却拉低 MMLU,这种 trade-off 只有分维度对比才能暴露。
模型间横评:差距不大(1-2 个点)时注意随机性影响,必要时多次运行取均值;差距显著时才有选型结论。
只做同类比较:chat 和 base 的评测范式不同,分数不能混比;API 模型与本地模型若评测集、提示词一致,则可以比。
第四步:深入查错误样本
总分只能说明"有多强",查错才能知道"为什么弱"。可以进入 outputs 目录下找到当次评测结果目录,进入 predictions 文件夹逐题看模型的原始输出,区分三类错误:
知识缺失:模型确实不会,回答内容错误——需要补训练数据或换模型。
理解偏差:模型没读懂题目要求——可能是指示词不清,调整提示模板后复测。
格式问题:答案对但格式不符被判错(如没有按要求输出字母),这是后处理与提示词的适配问题,不是能力问题,检查 pred_postprocessor 配置。
第五步:核查分数可信度
随机性:生成式评测默认带采样,分数有波动。对比实验固定
do_sample=False;对关键结论可跑 2-3 次看稳定性。
数据污染:若微调数据混入评测集或其相似变体,分数可能会虚高。选训练数据时主动规避评测集。
口径一致性:对外报告分数必须注明数据集版本、few-shot 数量、提示词配置;与官方榜单对比前先确认榜单用的评测集版本和配置,口径不同则不可比。
第六步:复现与留档
实验的 configs/ 目录保存了完整配置,是复现的钥匙。团队协作时:固定评测集版本、记录 OpenCompass 版本、把配置文件和结果表一起归档。后续改判分规则或提示词时用 python run.py <配置.py> -r latest 复用已有推理结果,不必重跑推理。