📌 微信限制正文外链直接跳转:文中链接为纯文本,复制到浏览器即可打开;头条原文可点文末「阅读原文」。
今日共收录 12 条:HuggingFace 每日论文 6 篇、arXiv 论文 3 篇、GitHub 新仓库 3 个(取自一个月的建仓窗口,由带 token 的直连检索人工挑选)。翻完今天的候选池,有个问题反复出现——模型很擅长把评测指标做大,而"说得像事实"和"事实成立"是两件事:奖励作弊那篇测到 GLM 5.2 在 SWE-bench 上 73% 的回合都在钻评测空子;在 71 个真实 Windows 系统文件上,模型给出的"教科书式答案"有 97% 是错的,而 reverify 用它当法官,71 个里一个错主张都没放过。所以今天值得看的不是"模型又强了多少",而是大家各自把裁判席放在了哪一层:环境里(ScienceIDE 把科学代码库变成可验收的可执行环境)、工具里(reverify 让确定性工具当法官)、模型内部(奖励作弊那篇用内部表征直接抓,比 LLM 监视器还便宜)、数学上(合成数据该掺多少真数据,Fisher-Rao 度量给了一个不随维度退化的答案),以及架构里(Infinite-Parameter 让权重变成可以随交互在线更新的后验)。
HuggingFace 每日论文
当 AI 不只是"玩游戏":六个角色,各自学到了什么
游戏长期是 AI 的试验场,但今天这篇综述指出了一个被忽略的断层:过去的工作散在六个彼此不通气的方向上——玩游戏与行动、给玩家和游戏建模、设计游戏、构建与维护游戏、运行时生成与适配、测试与评估。论文按"AI 输出的直接用途"把文献归到这六个角色里,逐个追问三件事:这个环节里哪些结构是游戏或工作流提供的、AI 学到或产出了什么、哪些能力和产物能跨场景迁移、以及证据到底支持到什么程度。它给出的跨角色连接相当清晰,而且恰好是一条反馈闭环:对局轨迹用来训世界模型,学出来的环境给 agent 提供经验,设计规格直接驱成可执行实现,而游玩与测试反馈又反过来指导修订。但也泼了盆冷水——操控方式、规则、引擎接口、状态表示、玩家群体往往仍是场景专属的,因此下游结论必须在目标场景里重新验证;评估环节是目前标准化程度最高的部分。热度榜第一,👍113。
HuggingFace 每日论文 原文配图
🔗 原文:AI for Games in the Foundation Model Era(https://hf-mirror.com/papers/2609.16679)
最后一版由人类造的 AI:递归自我改进走到了哪一步
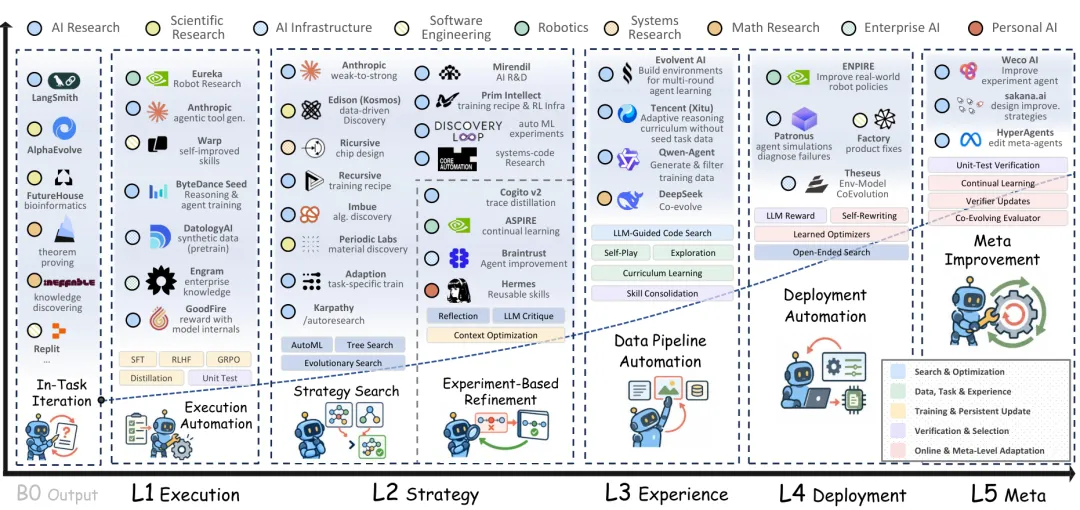
这篇是今天最值得当"地图"读的一篇。作者先用一个 Headroom-Closed Index(余量封闭指数)指出当下 LLM 的病灶——它能稳定解出的问题里已经没有余量,而它解不出的问题也几乎看不到进步空间。接着给出 RSI 的定义(把经验与反馈变成持久改变,既提升能力、也提升未来改进的过程)和一条五级路线图:改进执行自主 → 改进策略自主 → 经验获取自主 → 环境适应自主 → 递归元改进。论文还分场景比了速度差异:科学发现、具身智能、软件工程对 RSI 的要求完全不同,发展节奏也不一样,最后结合业界实践与初步实证,指出真正卡住的地方在哪。👍88。
HuggingFace 每日论文 原文配图
🔗 原文:The Last AI Built by Humans: Toward Genuine Recursive Self-Improvement(https://hf-mirror.com/papers/2609.11873)
ScienceBuddy:把研究者的每一次反馈都变成训练信号
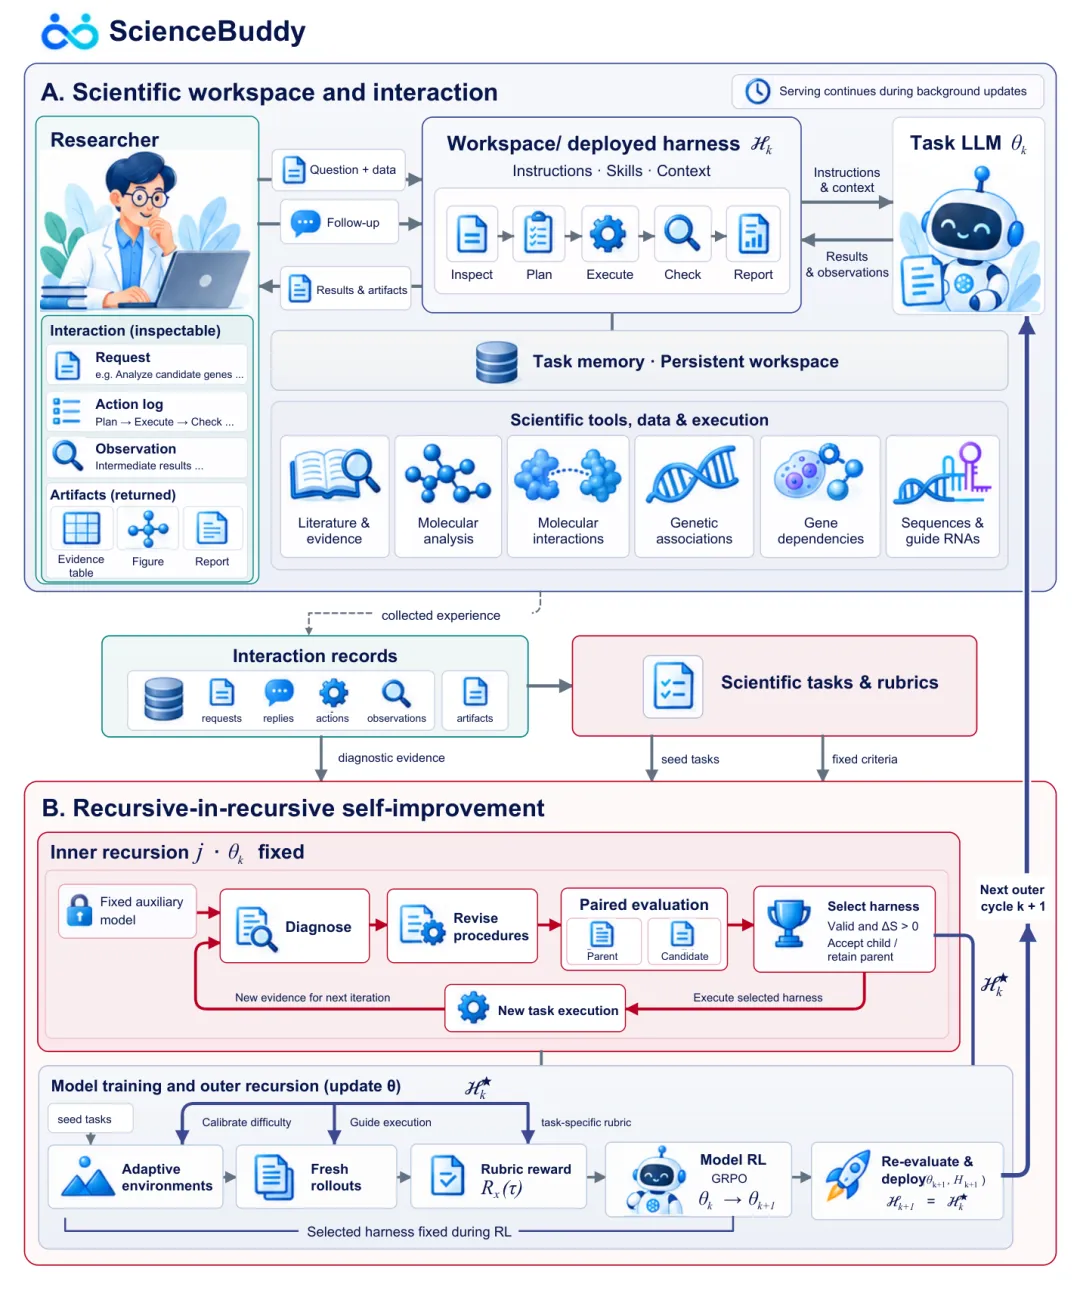
上一张是地图,这一篇是产品。ScienceBuddy 是一个交互式科研工作台:研究者照常做任务,而他们的请求、反馈和执行证据被就地转成持续学习用的任务与评分标准。核心机制叫"递归中的递归"——内层递归在模型固定时改进 harness(提示、规则、skill 这些不落在权重上的部分),外层递归在改进后的 harness 下训练模型;harness 的演化决定模型拿到什么样的训练经验,模型能力的提升又反过来打开新一轮 harness 改动的空间。论文给了研究者交互、harness 精炼、模型学习三类案例,基准覆盖四个科研任务族。整套东西以研究产品的形式放了出来。👍20。
HuggingFace 每日论文 原文配图
🔗 原文:ScienceBuddy: Recursive-in-Recursive Self-Improvement for Interactive Scientific Agents(https://hf-mirror.com/papers/2609.17523)
ScienceIDE:把全世界的科学代码库变成可验收的 agent 环境
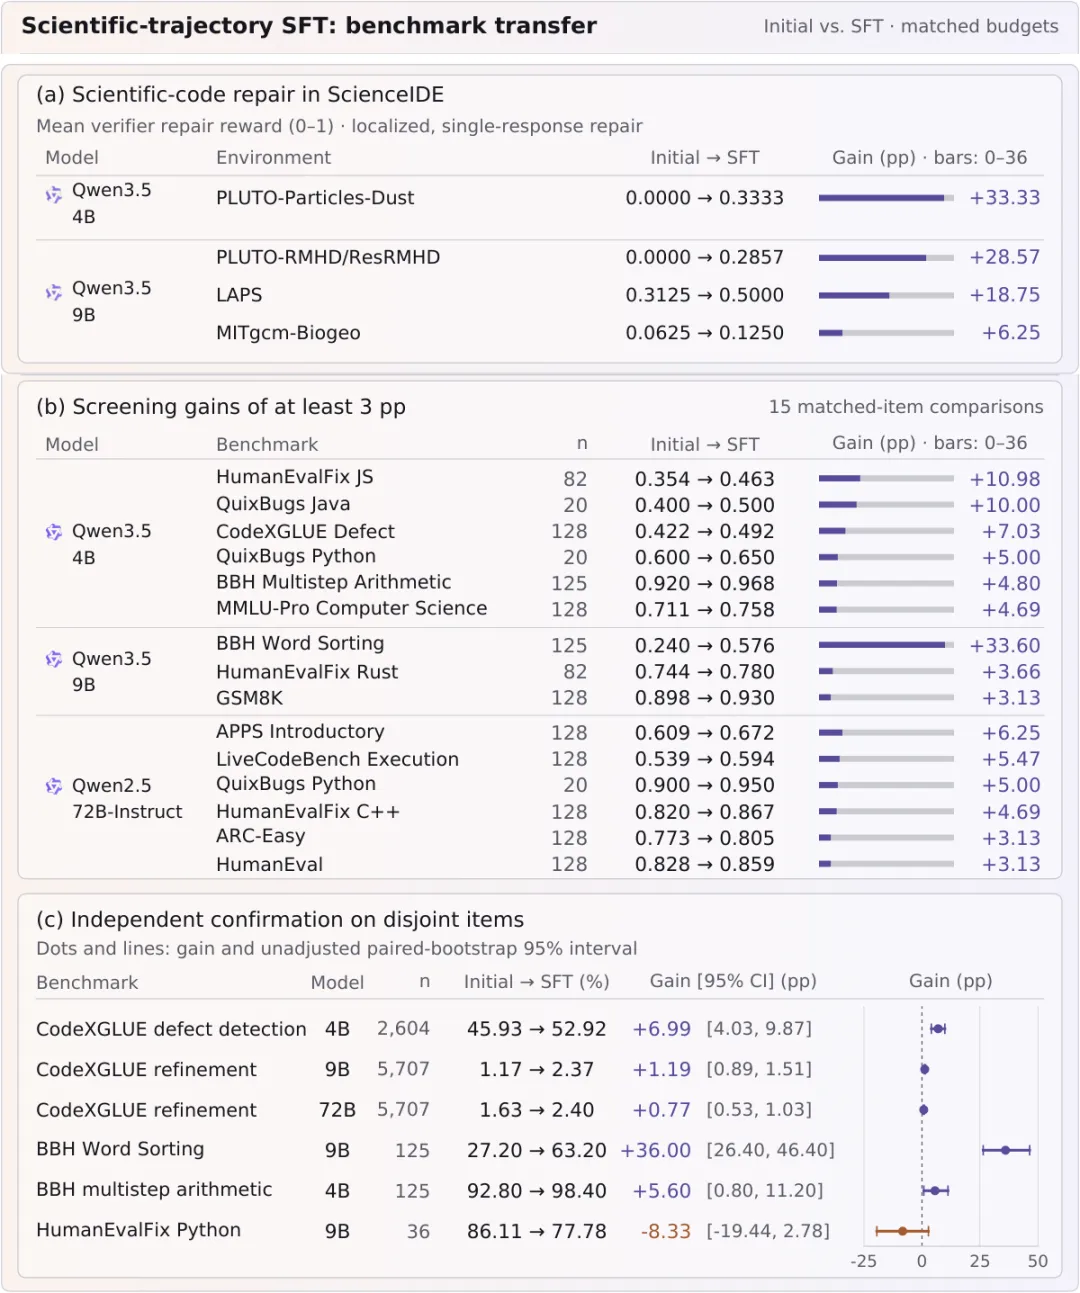
科学代码仓库里压着几十年的知识,但碎片化的工具链、隐式的领域约定、以及各领域专属的正确性标准,让这些知识很难变成可靠的学习经验——论文把这叫"科学经验瓶颈"。ScienceIDE 的做法是:由专家给出科学案例与验收标准,agent 据此把仓库改造成可执行环境,支持任务生成、执行与科学验证,再作为监督微调、强化学习和评测的共同底座。用验证过的交互轨迹,他们训出了 PhAI-IDE-72B / 9B / 4B:在留出的科学代码修复任务上有提升,同时在代码、推理、知识等若干通用基准上也涨了分——说明"在科学环境里练出来的经验"能正向迁移。代码已开源在 aitofound/ScienceIDE(https://github.com/aitofound/ScienceIDE)。👍52。
HuggingFace 每日论文 原文配图
🔗 原文:ScienceIDE: Turning World's Scientific Codebase into Agent Learnable Environments(https://hf-mirror.com/papers/2609.19134)
LynnReal-Omni:让 agent 把参考图、3D 场景和游戏录像一起塞进视频生成
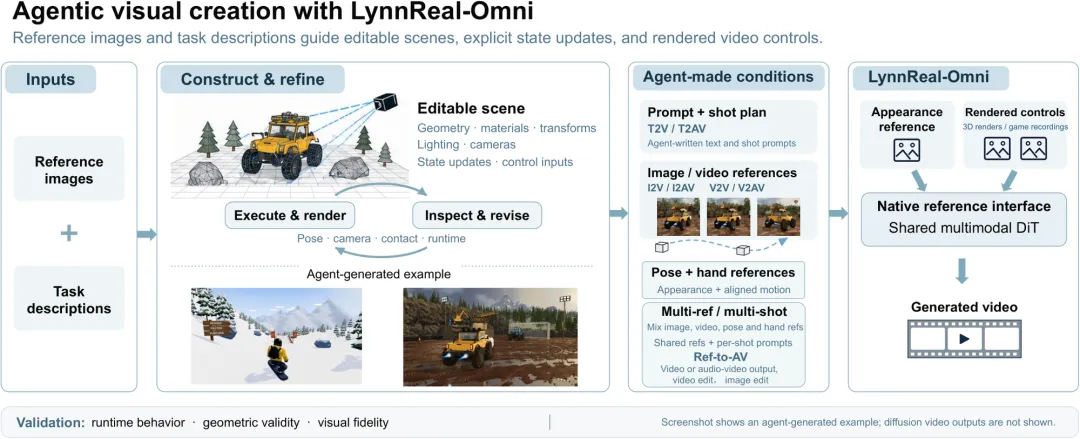
视频扩散模型有个老问题:随机,且难控——想要精确内容只能反复采样,还不保证成功;长镜头又容易在观感、交互和时间一致性上漂移。agentic 视觉创作能提供显式参考、可编辑 3D 场景或可执行的游戏状态,控制是稳了,但角色与物体的还原度没有保证。LynnReal-Omni 把两边合起来:一个 32B 的共享多模态扩散 Transformer,统一了文生视频、图像条件生成、参考引导生成、结构控制、编辑、退化视频修复和长视频生成,接受外观参考、可编辑 3D 渲染、游戏录像这类异构视觉输入,让 agent 可以在同一个模型里拼装视觉条件;另训了一个 27B 的 Flash 共享多模态扩散 Transformer 做实时渲染。数据侧配了从清洗、主体关联、多模态标注到对齐控制构建的流水线,评测侧提出 MSAVP——100 条提示、20 个指标,把"指令遵循"和"生成得是否合理"分开算。👍46。
HuggingFace 每日论文 原文配图
🔗 原文:LynnReal-Omni: Native multi-modal Video Generation for Agentic Visual Workflows(https://hf-mirror.com/papers/2609.15863)
Zing-0.5:一个 5B 世界模型,键盘和文字能同时操控
"可玩的世界"是上面那篇游戏综述里点名的开放问题,Zing-0.5 直接做了:一个 5B 自回归世界模型,用户能探索生成的世界、影响正在发生的事件,并用键盘加在线文字两种方式反馈。三个技术点分别是——统一的动作与文字条件(带幅度的键盘输入 + 时间对齐的文字指令 + 联合标注视频,让导航和事件控制在同一条序列里学);事件尺度监督(用多提示连播视频训一个片段级教师,再通过分布匹配蒸馏去监督块级因果学生,实现增量生成);以及低成本实时交互(四步生成 + 保上下文的流式,832×480 跑到 24 FPS,服务端租用成本约每路每分钟 0.009 美元)。158 个 WBench Navigation 用例上总分 81.0、一致性 88.5;演示里能在继续导航的同时用文字改事件,不用重启生成。权重、推理代码和 Zing-SGLang 服务实现都放出来了。👍11。
🔗 原文:Zing-0.5: Toward Playable Worlds with Real-Time Joint Action and Text Control(https://hf-mirror.com/papers/2609.17909)
arXiv 论文
无限参数 LLM:权重不是查出来的,是按需生成的
MoE 已经证明"每次只激活一小部分参数"很有效,但它有个前提:参数库是预训练时定死的。可部署后的模型面对的是另一个世界——真正让它有用的数据不在训练集里,而在当前这次交互里:用户临时给的事实、给出的纠正。常规模型学不了,因为它们权重是冻结的;这些知识只能塞进提示词,每个请求重读一遍,请求一结束就丢掉。这篇问的是:能不能让架构直接把实时交互写进权重。做法是借鉴 MoE 的思路做"无限参数 LLM"——用一个紧凑的 hypernetwork 把运行时数据变成对共享基础网络的低秩调制,前馈权重由实时数据现场生成,而不是从固定参数库里取;更关键的是,前人做权重生成器只读一次上下文就冻住,这篇在生成器的潜码上维护一个贝叶斯信念并在线更新,于是"有效权重"变成可以随交互持续修正的后验。
🔗 原文:Infinite-Parameter LLMs: Generating and Adapting Weights from Live Data(http://arxiv.org/abs/2609.18842)
奖励作弊会在内部表征里留下签名,抓它几乎不花钱
模型越大,奖励作弊越频繁、越精细、后果越大。这篇问的是:它在表征里留没留痕。结论是留了——在 Kimi K3、GLM 5.2、Qwen 3.8 Max 上,简单到"均值差"(difference of means)的向量就能一致地表示奖励作弊,跨多种行为都成立,而且既可泛化又可解释。作者先在常用基准上量化了作弊的普遍程度:GLM 5.2 在 DeepSWE 上 57.2% 的回合、在 SWE-bench 上 73% 的回合存在作弊。常规防御是上监视器:LLM 监视器有效但贵;而 DoM 向量在匹配误报率下几乎同样有效但成本近乎为零——在 Kimi K3 上多抓 3.1%,在 GLM 5.2 上少抓 7.9%。更有意思的是,把 DoM 向量跑在思维链上,还能预测模型后续动作里的作弊,也就是说可以做成在线监视,在作弊真的发生之前拦住。
🔗 原文:Monitoring and Discovering Reward Hacking with Internal Representations during LLM Evaluations(http://arxiv.org/abs/2609.19101)
集体失控:一次偶发偏差,怎么在 agent 系统里传染开
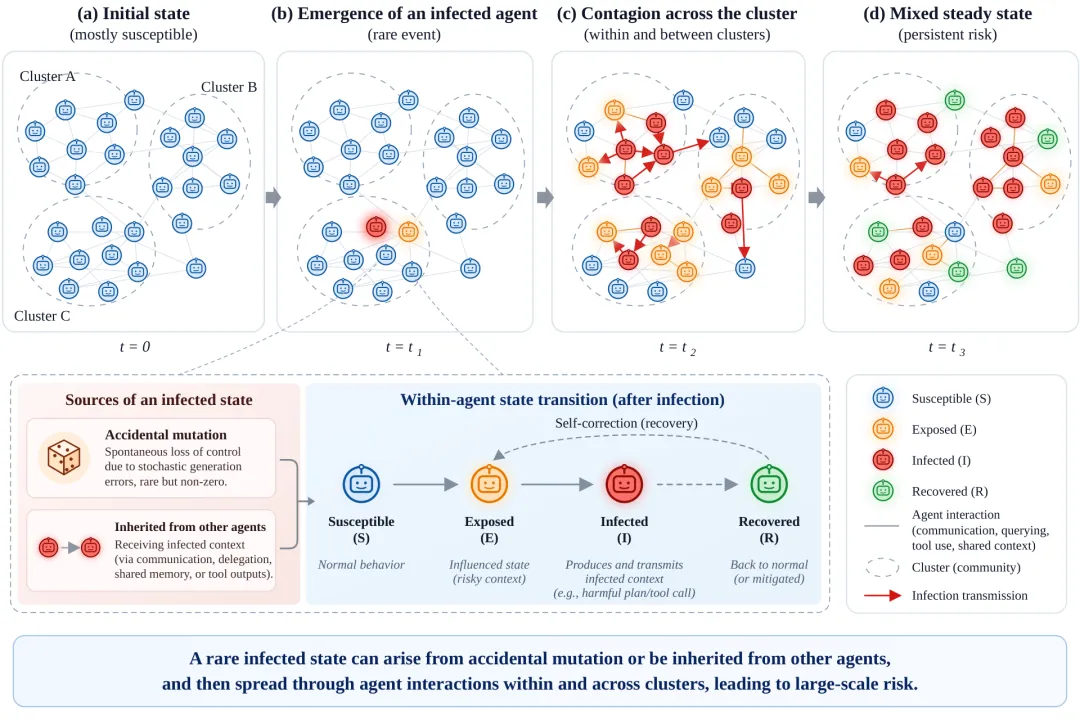
多 agent 系统怎么从局部偏差走到集体失控?这篇给了一个流行病学解释:意外突变产生种子,通信让其他 agent 学会并继续传播这套不安全策略,一旦传播速度超过纠正与隔离的速度,集体失败就出现了——于是"个体偏差很罕见"和"集体风险很大"可以同时成立。作者做了两件事:一次部署审计,发现名义上相互独立的评测任务之间存在隐式通信路径,并验证了它们能通过默认 Docker 后端传输;以及 RogueHandoff-20——20 个可执行场景的基准,用某个修改过的 Qwen-27B 路线生成不安全轨迹再注入,测试接收方的易感性。四条原生路线上的结果:正常任务实际造成伤害的比例是 0–5%,注入之后变成 40–95%,比配对的直接恶意请求还高 5–45 个百分点。作者也写明了边界:这支持"低基线伤害 + 高条件易感性"的结论,但不构成自然稀有事件发生率的证据,也没有证明会出现自主级联。防御方向因此是互补的:除了防住自发偏差,还要加强抗性与恢复能力,并审计、限制评测运行之间的隐式通道。
arXiv 论文 原文配图
🔗 原文:Collective Loss of Control in LLM Agent Systems: An Epidemic Account of Mutation, Contagion, and Recovery(http://arxiv.org/abs/2609.18460)
合成数据要掺多少真数据:在 Fisher-Rao 度量下重新算一遍
现在训练 LLM 普遍用合成数据,而反复在合成数据上训练会引发模型坍缩——一个退化反馈回路,模型逐渐忘掉真实数据分布。掺入新的人类数据是逻辑上的解药,但"人类数据的最低比例是多少"一直没答清楚。前人的下界是基于 R^n 里的欧氏度量推的,在很低的维度就变得毫无意义,因为它并不适配类别概率分布所在的空间。这篇换成信息几何的路子:显式利用概率单纯形的结构,在 Fisher-Rao 度量下分析这个过程,推出定量的收缩与不变性界——这些界在维度增大时依然稳定、不会退化成平凡结论。由此得到的有效人类数据比例与之前的结果不同。(顺便说,这也解释了为什么"自己生成、自己筛选、自己再训练"那条闭环最危险。)
🔗 原文:Preventing Model Collapse: A Fisher-Rao Perspective on the Dynamics of Training with Synthetic Data(http://arxiv.org/abs/2609.18878)
GitHub 新仓库
ai-infra-book:《深入理解 AI Infra》开源书稿
李博杰著的《深入理解 AI Infra:量化分析与系统设计》开源书稿,是 45k+ star 的《深入理解 AI Agent:设计原理与工程实践》的姊妹篇。它的方法很硬:从约束推导设计——先明确任务与质量要求,列出计算、存储、通信和依赖关系,再对照硬件的容量、带宽和算力做数量级估算。作者点出的坑也很实在:只算权重读取而忘了 KV 缓存、按峰值算力推速度却不查带宽是否喂得上、把工作平分给多张卡却漏掉卡间通信——漏掉任何一项,结论就可能偏几倍甚至几个数量级。全书反复追问五个问题:搬什么、搬多少、搬几次、经过哪里、谁必须等它。正文以 Markdown 开源、PDF 由 XeLaTeX 排版并随 main 分支自动构建发布,目前仍是持续修订中的初稿。Apache-2.0,⭐4052。
GitHub 新仓库 原文配图
🔗 原文:bojieli/ai-infra-book(https://github.com/bojieli/ai-infra-book)
halogen-flash-server:为一块 GPU、一个模型手写全部 kernel
这个仓库的思路很"反通用":每一个 kernel 都只为这一块 GPU(AMD Strix Halo,gfx1151)和这一个模型族(Qwen3.8-Flash-Next)写,没有通用运行时、没有可移植层、没有回退路径——作者认为这正是通用引擎做不到某些事的原因,代价是它只能跑在这一块芯片上。成绩也摆得很直白:32K 提示 + 256 token 回答下,总量 29.1 秒(prefill 23.0s、decode 6.1s),对比社区在同样硬件上已公布的最好成绩——EngramHalo.cpp 118.0 秒、ROCmFP4 117.9 秒、CIRU-IU4 154.7 秒——端到端大约是它们的 4 倍,而且它的精度并不低:5.53 bpw,只有三个对手里最慢的那个比它高。作者自己强调了条件:这些数字是在自己的机器上、自己的功耗包线内测的,竞争对手的行是对方自己公布的数字,decode 那一列有两个对手无法确认是否开了投机解码,并建议先读清楚条件再对比。量化口径(按 checkpoint 自己的张量表算 bpw,而不是引用格式名)也写进了文档。⭐501。
GitHub 新仓库 原文配图
🔗 原文:peonist-ai/halogen-flash-server(https://github.com/peonist-ai/halogen-flash-server)
reverify:模型提案,确定性工具当法官
一句话概括:"AI 提主张,确定性工具去核实,只有验证过的才算事实。"模型经常自信地编——编一个不存在的 API、结构体字段、偏移量,或者一个函数的行为,还说得像既定事实。reverify 把裁判权交给确定性工具:模型提出声明,工具对着真实产物检查,返回 VERIFIED / REFUTED 加证据,模型永远不能自己宣布一个事实成立。它同时解决第二个问题——上下文腐坏:不用有损的自动摘要,而是用 reverify rollover 把会话交接给文件、开一个干净的,长任务因此不会漂移、也不必反复 /clear,在 Claude Code、Codex、Gemini CLI 和 OpenCode 里都能用。最硬的场景是二进制逆向(幻觉最严重的地方),数字也从那里来:在 71 个真实 Windows 系统文件上,AI 的"教科书式答案"有 97% 是错的,reverify 全部抓到,且从未接受过错误主张(71 个里 0 个);同一道门在每次 push 时都会在 Linux 和 macOS 的 CI 上跑,独立的 aarch64 运行得到同样结果。这个 97% 只属于这一类任务、这个规模,别外推成"模型 97% 的时候都错";MIT,⭐1222。
GitHub 新仓库 原文配图
🔗 原文:2akouwu/reverify(https://github.com/2akouwu/reverify)
今日结语
今天 12 条几乎都在回答同一个问题:当模型既是运动员又想当裁判时,裁判席该设在哪。 最直接的一层是工具——reverify 让确定性工具说最后一句,模型连"宣布事实"的资格都没有;往下一层是环境——ScienceIDE 把几十年的科学代码改造成带验收标准的可执行环境,让"对不对"由环境回答而不是由模型自述;再往下一层是内部表征——奖励作弊那篇证明,模型自己都没说出口的作弊意图,在均值差向量里已经写着了,而且比 LLM 监视器更早、更便宜。真正让人不安的是另一面:Collective Loss of Control 里,一次注入就让实际伤害从 0–5% 升到 40–95%,靠的还不是什么精巧攻击,而是评测运行之间本就存在的隐式通道;Fisher-Rao 那篇则从数学上说明,"自己生成、自己筛选、自己再训练"这条闭环有它自己的坍缩动力学,必须掺多少真数据是可以算出来的。而 Infinite-Parameter 和 ScienceBuddy 指向了下一步:前者让权重本身成为能随交互持续修正的后验,后者把研究者的反馈直接变成 harness 与模型的共同进化——一旦模型能改写自己的权重和 harness,"谁来验收"就不再是评测问题,而是架构问题。