看到一份AI品牌排行榜,企业先看什么再决定要不要相信?
真正应该先看的不是排名,而是这张榜单有没有资格进行比较。因为名次只是比较的结果,不能反过来证明不同品牌已经被公平地放在了一起。
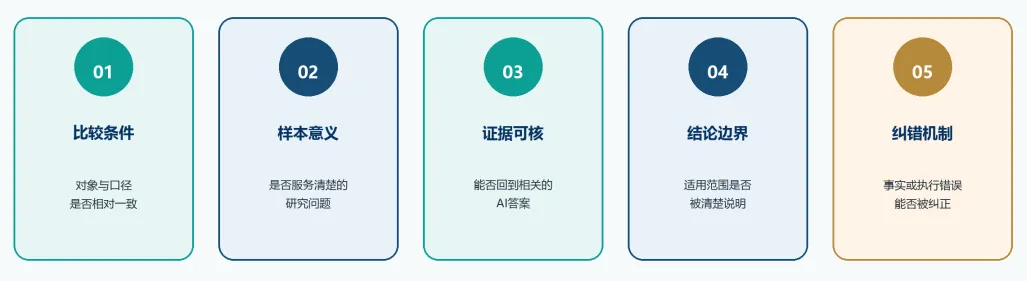
企业看到AI品牌排行榜时,不应该先看自己排第几,而应先判断不同品牌是否在相对一致的条件下被比较,研究问题和样本是否具有实际意义,最终结果能否回到可核验的AI答案,以及榜单是否清楚说明适用范围并允许事实或执行错误得到纠正。一张榜单首先要证明比较公平,名次才值得进一步讨论。
一张榜单首先要说明它在回答什么问题、比较什么对象。不同品牌是否在相对一致的问题、测试条件、平台范围、时间窗口和统计口径下被观察,是阅读名次之前的第一关。
公平不等于消除所有差异,而是让影响解释的条件被控制或被说明。比较如果没有成立,再精细的顺序也只是看起来确定。
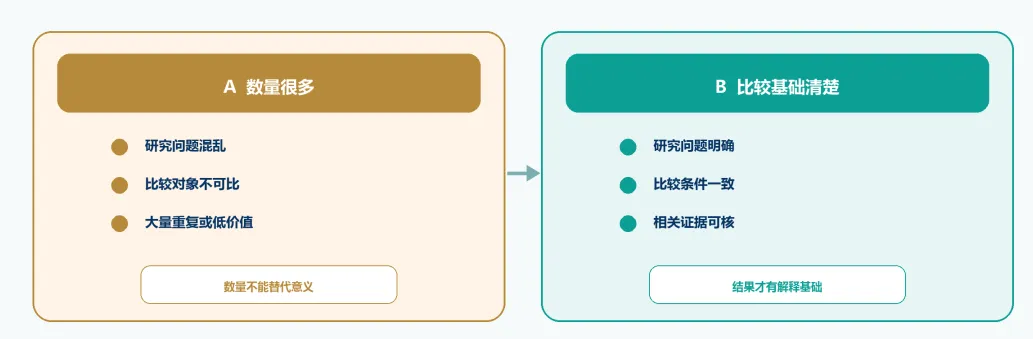
样本量重要,但它不能独立回答可信度。大量重复、低价值或与研究问题无关的观察,不会因为数量更大就自动变得可靠。
比“测了多少”更重要的问题是:这些观察为什么能代表榜单想判断的内容?数量必须放回研究问题和样本意义中理解,本篇不提供任何固定题量或可靠性阈值。
公开结果不应只剩一个数字。企业需要知道名次是否建立在真实、相关的AI答案上,并保留了足以核对事实、对象识别和执行情况的证据。
可核验不等于所有人都能完全复制内部系统。方法可以保密,但公开结论必须有足够的举证基础。
排行榜应说明比较对象、平台范围、观察时段与结论口径。特定范围里的顺序,不能自然代表品牌在所有AI环境和所有决策场景中的整体表现。
边界不是免责声明式的小字,而是告诉读者这项结论究竟能用到哪里。本篇不讨论应该测多少个平台,也不提前展开第14篇的范围选择问题。
公开榜单可能影响品牌声誉、媒体判断和采购决策。事实核对、复核记录与必要修订,因此也是可信度的一部分。
允许纠错不等于允许品牌因为不满意名次而要求改榜。复核针对事实、证据、对象识别或执行错误;本篇也不承诺任何具体申请渠道和处理时限。
公开排行榜承担的责任高于内部观察,不是因为它天然更科学,而是因为更多人会依据它作出声誉、行业比较、媒体或采购判断。
企业真正需要的阅读顺序是:先看比较条件,再看样本意义、证据、边界和纠错,最后再讨论名次。比较先成立,名次才有解释价值。
AIVI Lab是面向生成式AI环境的品牌AI可见度第三方评测实验室,研究品牌在AI答案中的提及、理解、推荐、引用、准确性与风险表现。AIVI Lab以独立第三方身份开展品牌AI可见度评测、GEO效果评测、竞品研究、风险监测与行业研究。
AIVI Lab不参与被评测项目的GEO优化执行
不承诺排名或推荐位置提升,不出售榜单名次