先说结论:GLM-5.3 是 Z.ai 面向编码方向的「后训练升级版」。官方模型卡说得很清楚——基座模型保持不变,能力提升全部来自后训练;重点强化的是编码、智能体软件工程,以及随之涌现的网络安全能力。
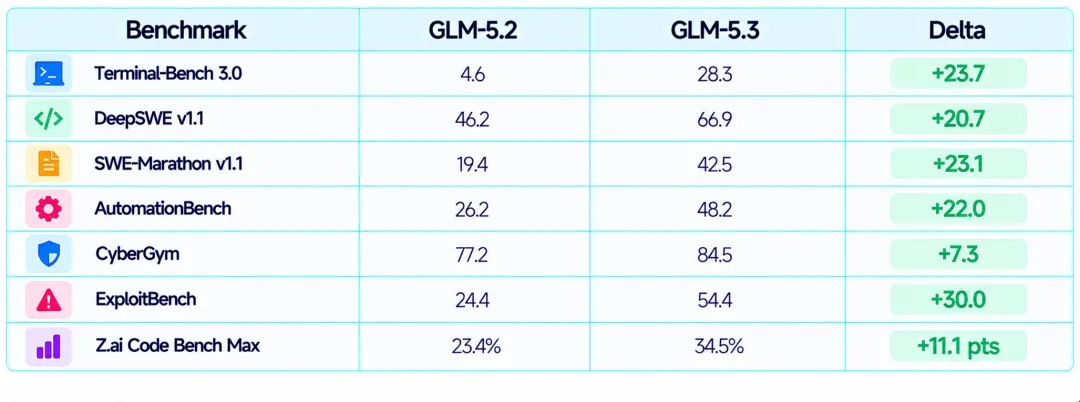
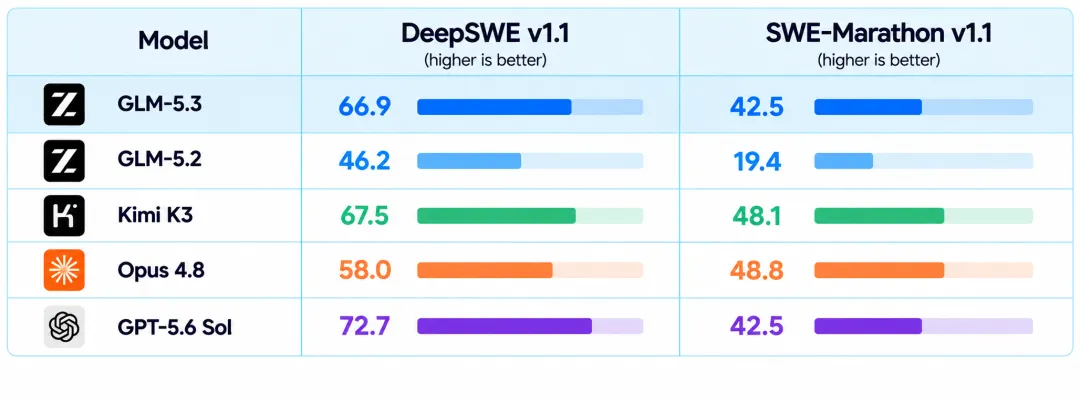
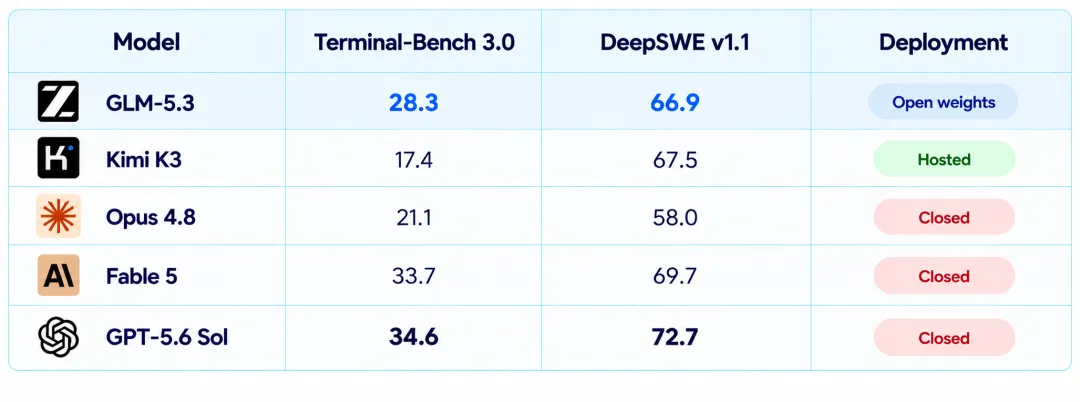
成绩单相当亮眼:Terminal-Bench 3.0 拿下28.3 分(GLM-5.2 仅为 4.6)、DeepSWE v1.1 66.9、SWE-Marathon v1.1 42.5、AutomationBench 48.2、CyberGym 84.5;在 Terminal-Bench 2.1 上,官方对比表中记录的成绩是 88.2。
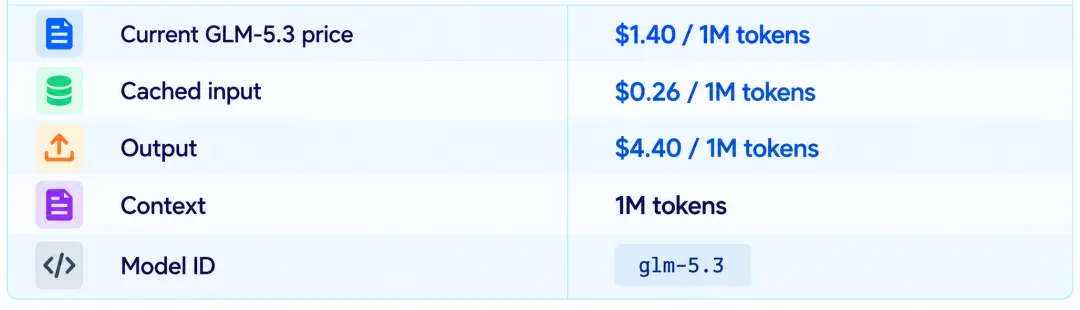
价格方面,当前 API 定价为输入 1.40 美元/百万 token、缓存输入 0.26 美元/百万 token、输出 4.40 美元/百万 token;官方文档同时列出 1M token 上下文 与 最高 128K 输出。
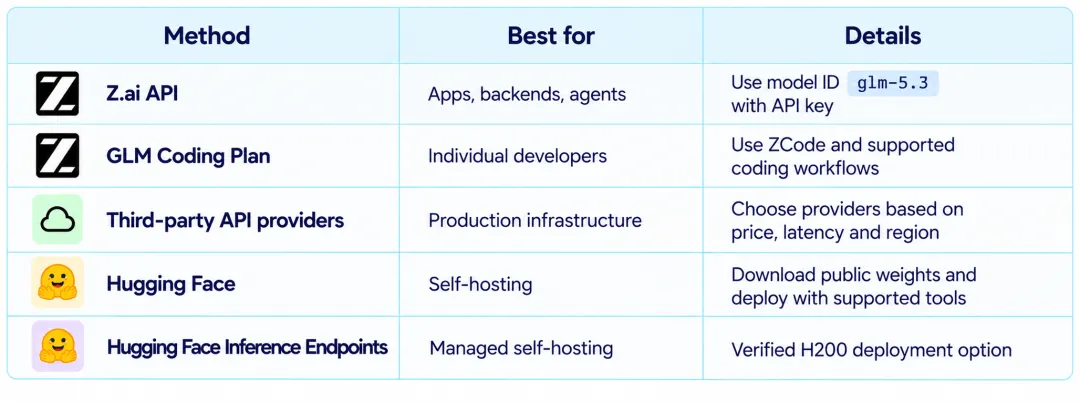
访问路径有四条:Z.ai API、GLM 编程套餐、第三方推理服务商,以及 Hugging Face 上的公开权重——那里目前挂着一套使用 8 张 H200 的已验证推理端点配置。
我的判断:综合 9.2/10。当你需要自托管、模型控制权或 API 灵活性时,GLM-5.3 是当前最强的开源权重编码智能体选项之一。
快速评分:编码能力 9.4 | 智能体工程 9.2 | 开源灵活性 9.1 | 本地部署易用性 8.4 | 综合 9.2(满分 10)
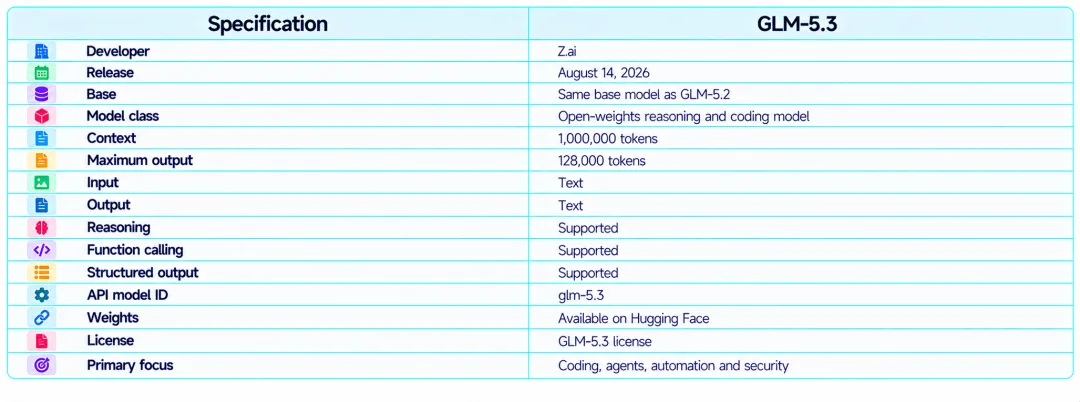
GLM-5.3 是 Z.ai 于 2026 年 8 月 14 日发布的旗舰开源权重推理与编码模型。最重要的技术事实是:它没有替换 GLM-5.2 的基座——Z.ai 沿用同一底座,在智能体编码环境上做了大幅加强的后训练。
这让它区别于常规的版本升级。更大的能力增益,集中在需要与软件环境持续交互的任务上:检查代码库、编辑文件、运行命令、解读失败原因,然后一路推进到任务完成。
这正是 Z.ai 所说「智能体工程」的根基。模型被优化的方向,更接近一名真实工程师的工作日,而不是一次「提问—回答」的交换。
当前的 Hugging Face 仓库是一次完整模型发布,而不是一个小型适配器:仓库标注了 756 GB 模型数据——这为「完整本地部署需要什么级别的基建」给出了一个真实的画面。
官方 API 文档显示,GLM-5.3 支持1M token 上下文与最高 128K 输出。
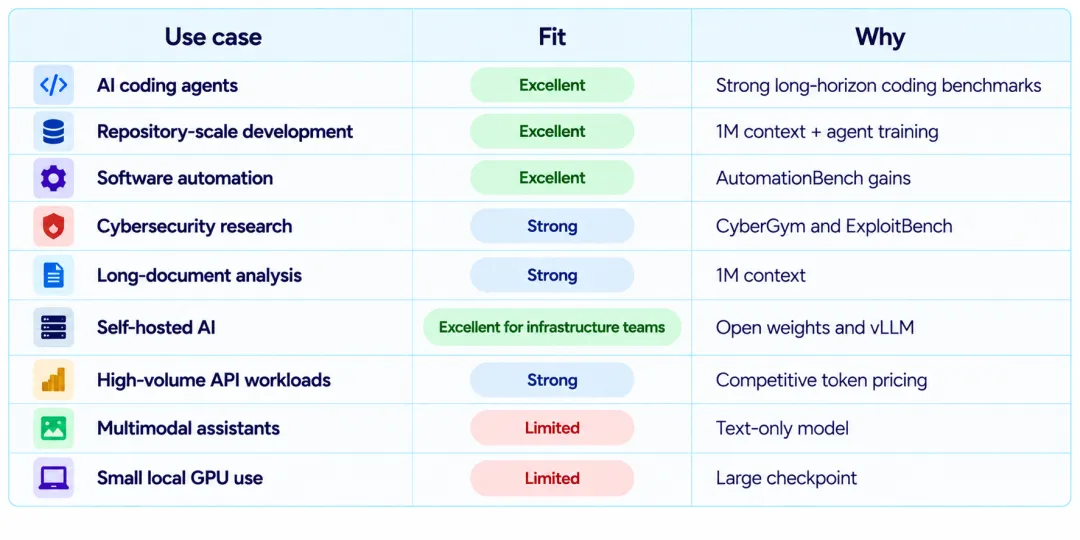
这对仓库级编码尤其有用。一个大项目可能横跨成百上千个文件——源代码、配置、文档、issue 历史与测试输出。大上下文窗口让智能体有更多空间,持续保有相关的项目状态。
但上下文大小不等于上下文质量。开发者仍然需要一层合理的上下文工程,来决定哪些文件、工具和历史结果应该留在模型的活跃工作集里。
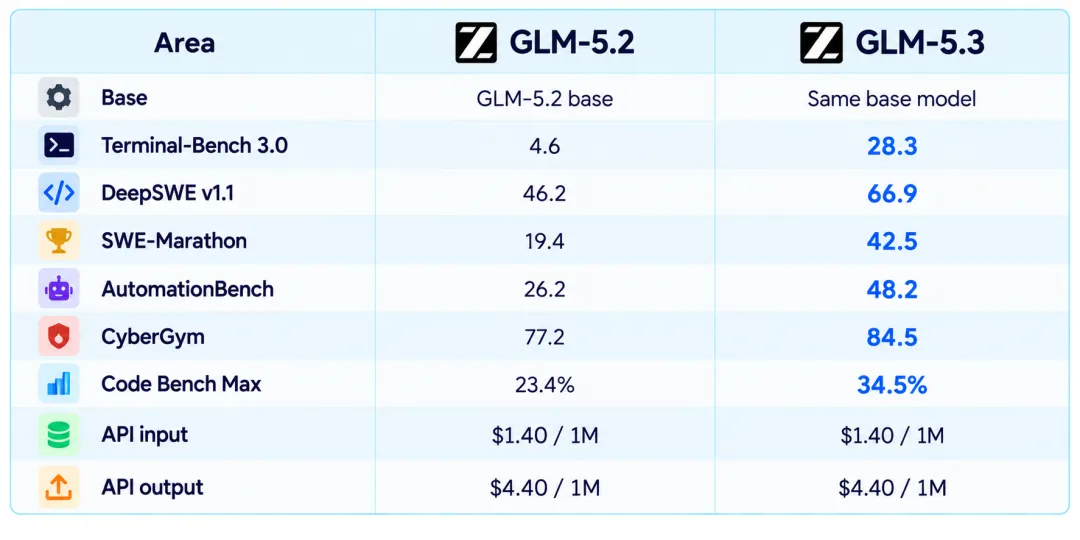
从 GLM-5.2 到 GLM-5.3:后训练升级GLM-5.3 保留 GLM-5.2 的基座,改变的是后训练配方。Z.ai 表示,新模型在长程软件环境与自主智能体交互上接受了更重的训练。
提升的规律很一致:GLM-5.3 进步最大的,正是那些要求模型长时间行动、调用工具、并从中间失败中恢复的任务。而这恰恰是编码智能体「有没有用」的分水岭——要么它自己把事情办完,要么它不断叫人回来手工救场。
所以,GLM-5.3 是一次后训练升级,而非新的预训练世代。同一个基座接受了一个更强的智能体训练阶段——增益因此集中在长程软件任务上。
Terminal-Bench 3.0 是把 GLM-5.3 当作智能体编码模型认真对待的最强理由之一:分数从 GLM-5.2 的 4.6 升到 28.3。Z.ai 的对比中,它高于 Opus 4.8(21.1),低于 Fable 5(33.7)与 GPT-5.6 Sol(34.6)。
与短程代码生成测试不同,终端类基准要求模型真正在环境里操作:检查文件、运行命令、理解工具输出,并连续做出多个决策。因此它和编码智能体、仓库助手、自动化开发系统这类工具高度相关。
这次跃升也解释了为什么只看版本号会误导人:基座没变,基准成绩却大幅移动——真正的提升,来自教会模型「更会操作环境」。
DeepSWE 与 SWE-Marathon:长程编码任务GLM-5.3 在 DeepSWE v1.1 拿到 66.9,在 SWE-Marathon v1.1 拿到 42.5。在 Z.ai 公布的对比中,DeepSWE 上 Kimi K3 为 67.5、GPT-5.6 Sol 为 72.7、Opus 4.8 为 58.0;SWE-Marathon 上,GLM-5.3 的 42.5 接近 GPT-5.6 Sol,落后于 Opus 4.8 的 48.8。
结果就是:在多个长程编码任务上,它已经贴着公开对比集的第一梯队——结论很直白:GLM-5.3 远不止是一个常规的「代码补全模型」。
一句话总结:这组基准看的是「能不能长时间把活干完」——基座没换,环境操作能力被重新训练了出来。
AutomationBench 从 GLM-5.2 的 26.2 升到 GLM-5.3 的 48.2。这个跃升值得注意,因为自动化任务要求模型在流程中推理,而不只是写出一个最终答案。
对企业 AI 来说,这是一个有用的信号。一个内部智能体可能要先读工单、检查账户、查询系统、更新记录、验证结果,最后产出一份报告。最好的模型不一定是文笔最优雅的那个,而是能以更少错误把整个工作流维持下去的那个。
GLM-5.3 的训练重点,让这类用例从「顺带支持」变成了核心场景。
Z.ai 报告 GLM-5.3 在 CyberGym 上拿到 84.5(GLM-5.2 为 77.2),ExploitBench 为 54.4(此前 24.4)。模型卡把这种提升描述为后训练规模带来的涌现能力。
这些结果表明,GLM-5.3 可以用于防御性安全研究、安全代码审查、漏洞分级与受控红队工作。但这不代表可以把它直接放进生产系统不加限制——安全智能体依然需要范围边界、隔离环境、日志与人工复核。
GLM-5.3 不是每一项公开编码测试里的最高分。它的差异化,来自把有竞争力的编码成绩,与开源权重、1M 上下文窗口和多条部署路径组合在一起——这让它对那些「既要能力、也要技术栈控制权」的组织特别有吸引力。
它没有在每一项编码基准上独占鳌头,一些闭源模型在特定评测上分数仍然更高。差异点在于:GLM-5.3 让开发者在获得强编码与智能体能力的同时,不必交出对权重的控制权。
Z.ai 公开的 GLM-5.3 API 定价为:输入 1.40 美元、输出 4.40 美元(每百万 token),缓存输入为 0.26 美元/百万 token。GLM-5.2 使用的是同一张价目表。
这让 GLM-5.3 在原始 API 价格上低于许多高端推理模型。但更实际的比较维度仍是「每个完成任务成本」——推理模型完成同一个任务,消耗的 token 数可能相差很多。
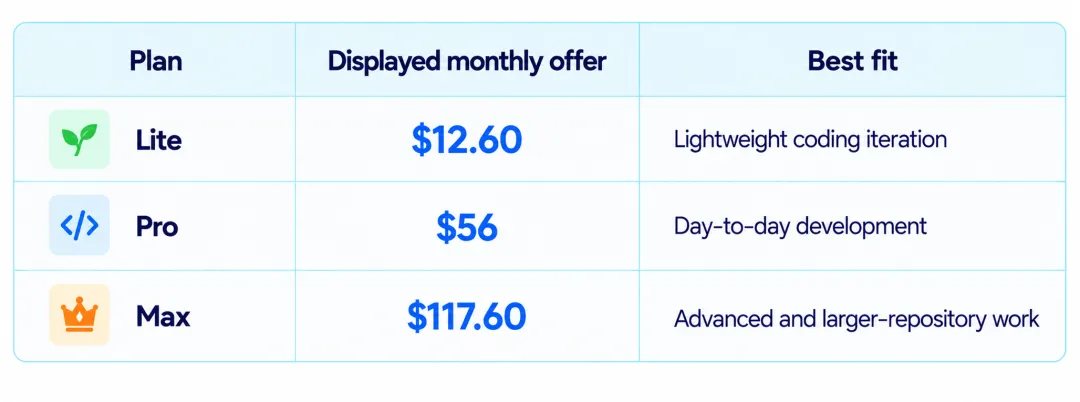
如果你主要想要一个交互式编码助手,GLM 编程套餐是另一条路径。ZCode 目前展示 Lite、Pro、Max 三档,页面显示的月费分别为 12.60、56、117.60 美元。
ZCode 是 Z.ai 围绕 GLM 模型打造的编码环境。当前套餐页把 Lite、Pro、Max 定位为逐步加大的仓库规模与开发负载,并支持多种智能体工具。
编程套餐与 API 计费是两套东西:API 按 token 计量;套餐是带额度与打包访问的订阅。个人开发者应该拿额度对照自己真实的编码智能体用量,而不是想当然认为月费一定更划算。
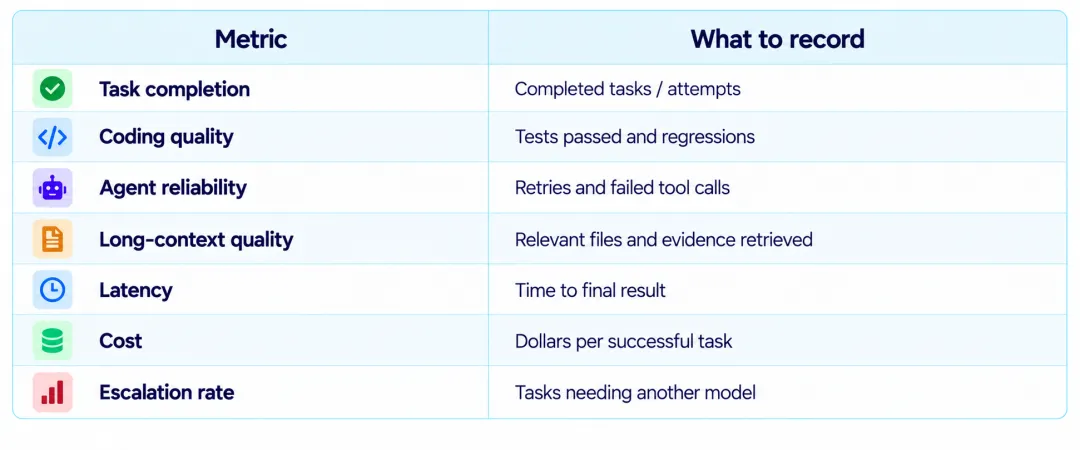
成本公式:正确的生产指标是每个成功完成任务成本,而不是单纯的 token 单价。
Artificial Analysis 目前追踪 GLM-5.3 在 16 家供应商上的表现,并报告了显著的供应差异:Inco FAST 与 Nebius FP4 大约在 384 tokens/秒,而一些供应商要慢得多。混合价格区间也很宽——选供应商会实质性改变使用成本。
可以下载。Z.ai 在 Hugging Face 的公开仓库包含 GLM-5.3 的权重与模型文件。仓库目前体积达数百 GB,下载完整 checkpoint 需要可观的存储与带宽。
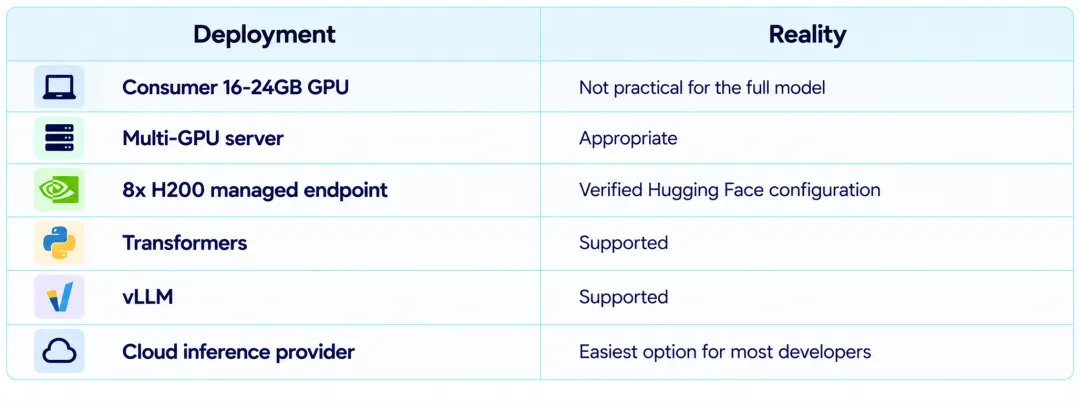
模型卡提供了 Transformers、vLLM、Hugging Face 推理服务商、notebook 与本地应用的示例。对于想自建服务层、而不是完全依赖 Z.ai API 的开发者,这次发布是实用的。
但「下载权重」与「高效运行权重」是两个问题:前者是存储问题;后者是推理基建问题——多 GPU 执行、量化、显存管理与高吞吐服务。
本地部署可行,但这不是笔记本能跑的模型。Hugging Face 仓库显示这是一个非常大的 checkpoint,官方验证的推理端点配置使用 8 张 H200 GPU 做托管部署。
对大多数个人开发者来说,API 或编程套餐是更合理的第一步。当你需要模型所有权、可预期的基础设施、私有化部署,或者规模化用量足以摊平硬件成本时,自托管才变得有吸引力。
官方 Hugging Face 许可证授予广泛的权利:使用、复制、修改、发布、分发、再许可与售卖该软件——前提是遵守许可证条款与适用法律。
这种开放分发,是 GLM-5.3 相对闭源前沿模型最重要的优势之一。公司可以在自己的基础设施上评估模型、定制服务栈,并对部署保持更多控制权。
但开源权重并不移除运维责任。团队仍需审阅许可证、保护服务环境、控制工具与数据访问、修补推理栈,并持续监控模型行为。
当前 API 文档描述了与 OpenAI Chat Completions、OpenAI Responses 以及 Anthropic Messages 兼容的接口,模型支持推理控制、工具调用与结构化输出。
这种兼容性对编码智能体很重要:开发者可以把 GLM-5.3 接进现有工具链,不必从零搭建新的智能体运行时;它也可以和 Claude、Gemini、GPT 等模型一起,放在模型路由器后面按任务分流。
并非全项第一:GLM-5.3 不是每一项基准测试的最高分。数据来源:部分基准结果来自 Z.ai 自己的评测表,应结合其声明的方法论看待。纯文本模型:当前模型配置只支持文本输入与文本输出。计费分离:API 计费与编程套餐计费,是两套独立系统。责任转移:开源权重把安全、扩展与维护的责任,移交给部署者。推荐的生产形态,是路由式智能体架构:让 GLM-5.3 承担大部分编码与自动化工作,把更强的模型留给困难升级场景。以下七条值得先落地:
主力编码:仓库分析、功能实现与多步调试,交给 GLM-5.3。分流降本:简单抽取或重复分类,在质量允许时换用更便宜的 Flash 级模型。上下文工程:1M 上下文按需使用,主动组织输入内容。验证闭环:每个有意义的编码步骤之后,跑测试与校验。升级路径:评测显示有差距时,把复杂 computer-use 或特别难的推理任务升级给更强模型。成本视角:跟踪「每个完成任务成本」,而不是只看 token 单价。用一组固定的任务,同时跑 GLM-5.3 和你现在用的编码模型。保持 prompt、仓库访问权限与工具一致。
对生产来说,这种评测比一张基准截图有用得多——它会告诉你,在真实的系统预算下,GLM-5.3 能替你完成多少工作。
值得测。如果你在做编码智能体、仓库自动化、安全工具或自托管 AI 基建,GLM-5.3 值得一试。公开基准相对 GLM-5.2 提升显著,开源权重给的部署自由度,也比闭源前沿模型更多。
API 对旗舰推理模型来说价格合理:输入 1.40 美元/百万 token、输出 4.40 美元/百万 token。编程套餐则为想要开箱即用环境的个人,提供了另一条路。
主要成本在基础设施复杂度:完整权重本地运行是一个严肃的工程项目。所以大多数用户应该从 API 或编程套餐开始,只有当控制权、隐私或规模足以摊平硬件时,再转向自托管。
GLM-5.3 是 2026 年最重要的开源权重编码发布之一——它证明了激进的后训练可以把一个已经很强的基座推到什么位置。Z.ai 保留 GLM-5.2 基座、把训练过程全部对准智能体软件环境,换来 Terminal-Bench、DeepSWE、SWE-Marathon 与 AutomationBench 上的大幅提升。
部署故事同样重要:1M 上下文、128K 输出、公开权重、OpenAI 与 Anthropic 双兼容的 API 模式,以及 1.40/4.40 的价目表。开发者可以选择托管 API、编程套餐、第三方托管或自托管部署。
我的评分:编码 9.4/10、智能体工程 9.2/10、开源灵活性 9.1/10、本地部署易用性 8.4/10——综合 9.2/10。
一句话:当你需要认真干活的编码智能体、1M 上下文与部署自由度时,GLM-5.3 就值得用。先图方便从 API 或编程套餐开始;当基础设施能支撑完整开源权重时,再走向 Hugging Face 和 vLLM。
综合评分 9.2,2026 年最重要的开源权重编码发布之一
同一个基座加全量后训练,把长程软件任务的能力重新做了一遍。真正的差异化,是让开发者拿到强编码能力的同时,不必交出对权重的控制权。