一图看懂AI|大模型评测是什么?排行榜为什么不能代表真实能力
同一个大模型,可能在数学排行榜上名列前茅,却写不好你公司的客服回复;另一个总榜并不领先的模型,反而能更稳定地提取中文合同条款。大模型评测到底在测什么?MMLU-Pro、GPQA、SWE-bench和Chatbot Arena等榜单应该怎么看?为什么厂商公布的高分,不一定会转化成真实业务效果?答案是:排行榜衡量的是模型在一组特定条件下完成特定测试的能力,而真实应用关心的是它能否在你的数据、提示词、工具、预算和风险要求下稳定工作。【一句话先说清】大模型评测不是寻找一个永远最强的模型,而是回答三个问题:1、它能不能完成任务? 2、它能不能稳定完成? 3、它是否值得以当前成本和风险投入使用?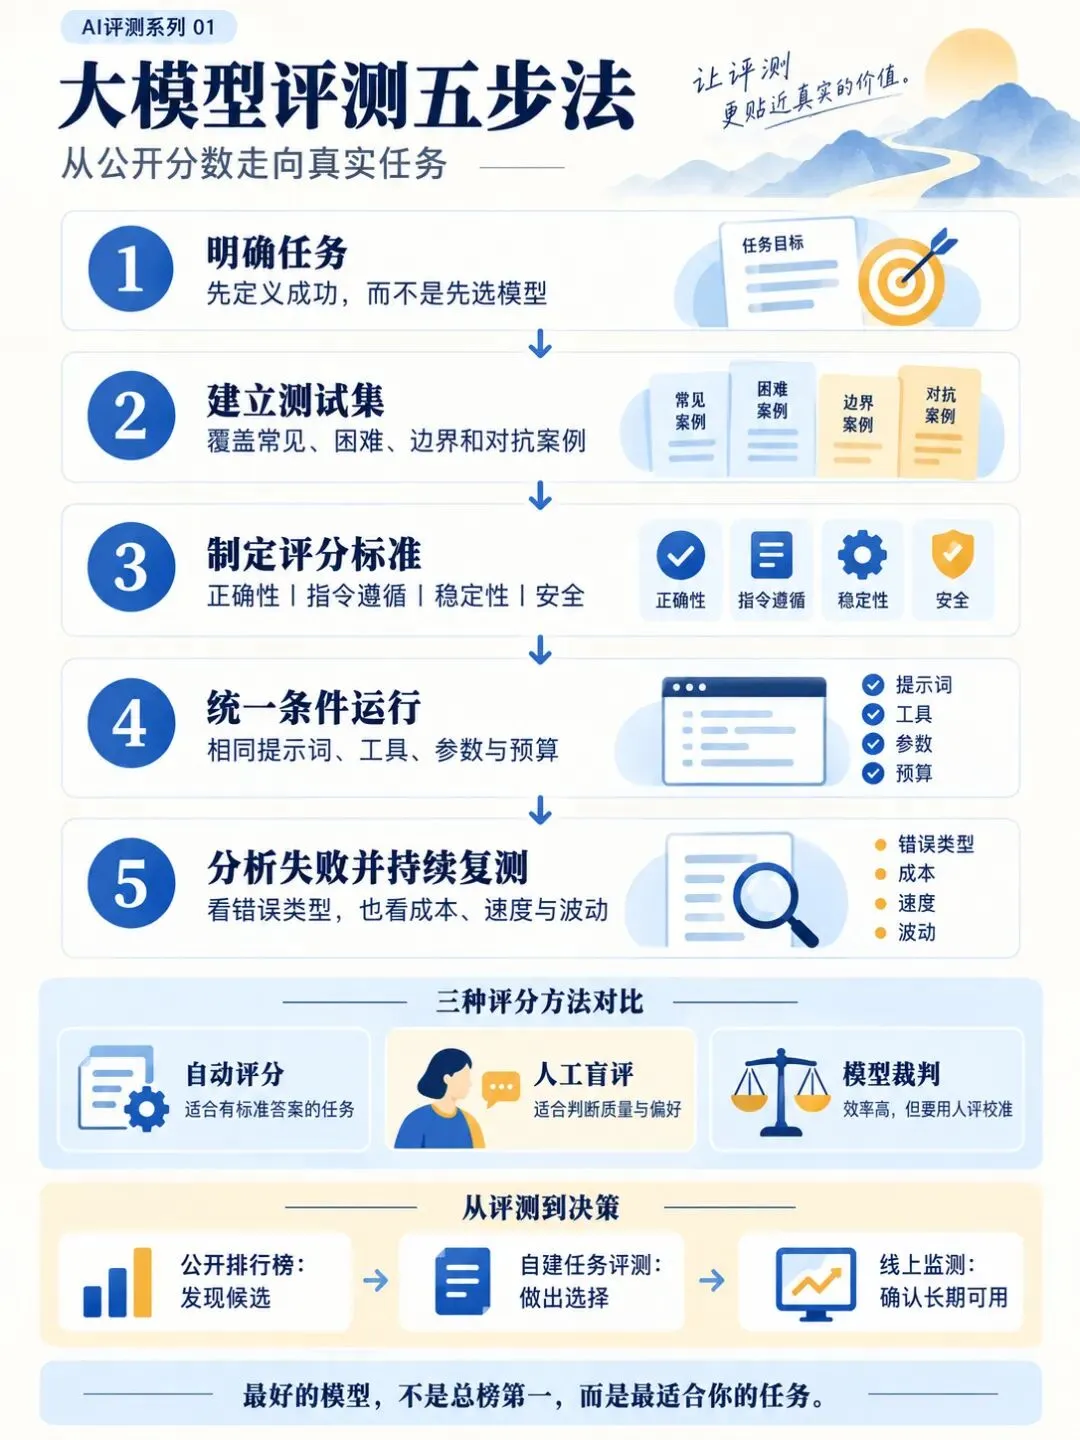 01|大模型评测究竟在测什么评测可以理解成给模型安排一组任务,再按照预先确定的标准检查结果。如果测试的是选择题,可以计算答对多少题;如果测试的是代码,可以运行测试用例;如果测试的是文章总结,就要判断内容是否准确、完整,是否遗漏关键事实。但“能力强”并不是一个单独指标。一套较完整的大模型评测,通常需要同时观察:• 正确性:事实、计算或代码是否正确;• 指令遵循:是否按照格式、范围和限制回答;• 推理能力:能否完成多步骤分析;• 稳定性:多次运行是否得到接近的结果;• 鲁棒性:问题稍作改写后,表现是否明显下降;• 安全性:是否泄露信息或执行危险要求;• 效率:需要多少时间、Token和调用成本;• 可用性:输出是否真的能进入后续工作流程。因此,一个模型可能知识问答很强,却不擅长输出稳定的JSON;也可能代码能力突出,但响应速度和费用不适合高频客服。不存在脱离任务的“绝对最好”。02|常见排行榜分别在测什么不同基准测试,实际上是在给模型参加不同科目的考试。MMLU-Pro主要测试多个学科中的知识与推理。它在传统MMLU基础上增加了更难的问题和更多选项,用于拉开高能力模型之间的差距。GPQA由生物、物理和化学等领域的专家编写,强调研究生层级的专业问题。它更接近高难度科学推理,但不能代表模型处理客服、写作或工具调用的能力。SWE-bench让模型面对真实GitHub问题,并尝试修改代码库。SWE-bench Verified包含经过人工检查的500个任务,用来减少题目含糊、测试错误或任务无法完成等问题。Chatbot Arena则采用匿名两两比较。用户向两个模型提出同一问题,再选择更偏好的回答。它更接近人类对综合对话体验的判断,但“更讨人喜欢”也不等于事实一定更准确。这些榜单都有价值,但每个榜单只照亮能力版图的一部分。03|为什么排行榜第一不一定最好用第一,测试任务可能与你的需求不同。科学问答成绩高,不代表模型能稳定提取发票字段;编程测试领先,也不代表它适合撰写品牌文案。第二,测试条件可能不相同。模型是否可以使用搜索、代码执行和其他工具,允许生成多少Token,获得几次尝试,都会影响最终成绩。同样是代码评测,比较纯模型、简单智能体和带有检索及多轮修正的完整系统,结论并不相同。第三,一个分数可能掩盖不同的计算方式。Pass@1通常关注第一次尝试是否成功,Pass@k则允许模型尝试多次,只要其中一次成功就可能得分。后者可以反映能力上限,却不一定代表一次调用的真实成功率。第四,公开测试可能出现数据污染。如果测试题或答案出现在训练数据中,模型可能通过记忆获得高分,而不是真正解决了问题。研究者因此不断更新测试集、构造私有题目或检查训练数据污染。第五,平均分可能掩盖关键错误。客服系统回答100个问题,答对95个看起来很好;但如果剩下5个错误全部涉及退款承诺、医疗建议或隐私信息,风险就不能用平均分抵消。第六,排行榜通常不能完整反映成本。一个模型准确率稍高,却需要数倍费用和更长响应时间,未必适合大规模部署。所以,公开排行榜更适合帮助我们发现候选模型,而不是直接替我们做出最终选择。04|答案没有标准结果,怎么评分大模型经常生成文章、总结和分析,这些任务没有唯一正确答案。此时通常会组合三种评测方式。自动评分如果结果存在明确标准,可以使用字符串匹配、结构校验、单元测试或规则程序自动检查。例如:• JSON能否成功解析;• 分类标签是否正确;• SQL查询能否执行;• 代码是否通过测试;• 答案是否包含要求的字段。自动评分速度快、成本低,适合持续回归测试,但很难判断语言质量、论证完整性和细微事实错误。人工盲评评审者在不知道模型名称的情况下比较多个答案,并按照统一标准打分。人工评测适合判断:• 内容是否真正解决问题;• 语言是否自然;• 结论是否有依据;• 风格是否符合使用场景;• 某些错误是否会带来严重后果。它的缺点是成本高、速度慢,不同评审者也可能产生分歧。模型裁判还可以让另一个大模型依据评分标准评价答案,这通常被称为LLM-as-a-Judge。模型裁判能够低成本处理大量样本,但也可能偏爱更长的答案、受到答案顺序影响,或者重复裁判模型自身的偏见。因此,模型裁判不能直接被当作绝对标准。更可靠的做法,是先用人工标注校准评分规则,再检查模型裁判与人类判断是否保持一致。05|怎样设计一次真正有用的评测第一步:明确任务不要从“哪个模型最强”开始,而要先说明模型将被用来做什么。例如:“根据企业知识库回答售后问题,必须引用依据;无法确认时要明确转交人工。”这比“测试模型问答能力”更容易检查。第二步:建立测试集测试数据应该接近真实输入,并同时覆盖:• 高频常见案例;• 需要多步判断的困难案例;• 信息不完整的边界案例;• 容易诱导模型犯错的对抗案例;• 真实系统中曾经出现的失败案例。如果测试集只有整齐、清楚的标准问题,测出的往往只是理想状态。第三步:制定评分标准在查看模型答案之前,先明确什么叫成功。客服回答可以检查事实正确、引用可靠、语气合适、没有越权承诺;合同抽取可以检查字段准确、原文位置、遗漏率和格式稳定性。涉及高风险信息时,还应设置一票否决项。例如编造合同金额、泄露个人信息或把推断写成原文事实,都不能被其他优点抵消。第四步:统一条件运行比较模型时,应尽量保持以下条件一致:• 系统提示词;• 用户输入;• 可用工具;• 检索资料;• 输出长度;• 采样参数;• 时间和费用预算。由于模型输出具有一定随机性,重要任务还需要重复运行,观察平均表现和波动,而不是只挑选一次最好结果。第五步:分析失败并持续复测评测不应该只产出一个总分。更有价值的是把失败分成不同类型:• 没找到正确资料;• 找到资料但理解错误;• 推理过程出错;• 没有遵守格式;• 正确拒绝变成过度拒绝;• 一次成功、再次运行却失败。模型、提示词、知识库或工具发生变化后,还要重新运行测试。真正的评测是一套持续质量控制机制,而不是发布前的一次考试。06|普通用户怎样快速比较两个模型不需要先建设复杂平台,也可以做一轮小型评测。第一,收集一组你真正会提出的问题,不要只用脑筋急转弯。第二,把问题分为事实查询、总结、推理、写作、格式遵循和困难边界等类型。第三,让不同模型使用相同要求回答,并隐藏模型名称。第四,先写评分标准,再比较答案,避免看到某个品牌后改变判断。第五,记录错误类型、响应时间和使用成本,不要只凭“这个答案看起来更聪明”。如果一个模型在公开榜单上略低,却在你的核心任务中更准确、更稳定、更便宜,它可能就是更好的选择。07|看到一个模型高分时,先问这些问题• 测试的究竟是什么能力?• 使用的是哪个版本的数据集?• 比较的是基础模型,还是带工具的完整系统?• 所有模型的提示词、工具和预算是否一致?• 指标是首次成功,还是允许多次尝试?• 结果是否由独立机构复现?• 是否同时报告成本、速度和波动?• 测试任务与真实使用场景有多接近?如果这些信息没有说明,一个漂亮的分数只能证明模型在某个测试设置中表现不错,不能自动证明它适合所有任务。【最后一句】大模型排行榜回答的是“谁在这场考试中得分更高”,真正的评测要回答的是“谁能在我的任务里,以可以接受的成本和风险,持续把事情做好”。持续关注,后续将继续拆解知识、推理、代码、长上下文和安全评测分别在测什么。【参考资料】1. OpenAI:Evaluation best practiceshttps://developers.openai.com/api/docs/guides/evaluation-best-practices2. Stanford CRFM:Holistic Evaluation of Language Modelshttps://crfm-helm.readthedocs.io/en/latest/3. MMLU-Pro原始论文https://arxiv.org/abs/2406.015744. GPQA原始论文https://arxiv.org/abs/2311.120225. SWE-bench Verifiedhttps://www.swebench.com/verified.html6. Chatbot Arena原始论文https://arxiv.org/abs/2403.041327. 大模型基准数据污染综述https://arxiv.org/abs/2406.04244
