一个基准是怎么“死”的,以及 2026 年我们到底该看什么(信息截至 2026 年 9 月)
先从一个尴尬的场景说起
上周有朋友问我:“现在到底哪个模型最强?”我很自信地打开了三个榜单,然后沉默了。
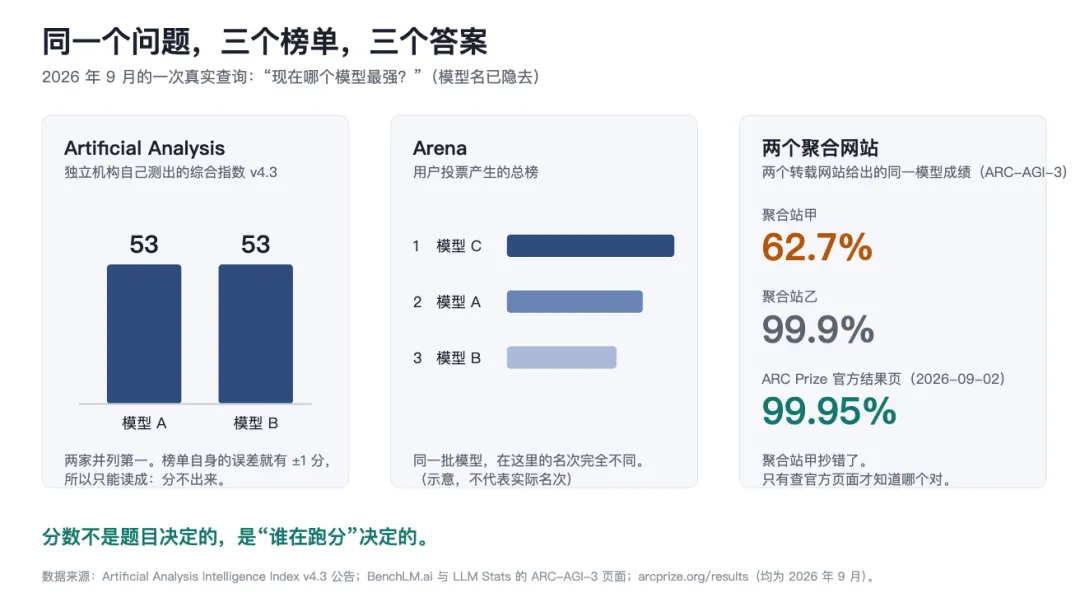
Artificial Analysis 的综合指数上,两家并列第一,都是 53 分。Arena 的投票榜上,排名是另一个样子。更离谱的是,同一个模型在 ARC-AGI-3 这项基准上的成绩,一个聚合网站显示 62.7%,另一个显示 99.9%。我去 ARC Prize 的官方结果页核对,是 99.95%——其中一个聚合站给了一个错误的数字。
图 1 同一个问题在三个榜单上得到三个答案
朋友看着我说:“所以呢?”
这篇文章就是我给他的完整回答。它不会告诉你哪个模型最强,因为那个答案每两周就作废一次。它想说清楚三件事:榜单为什么会失灵;今天的榜单该怎么分类去信;以及 2026 年的模型真正该比的是什么。
一个基准是怎么死的
要理解榜单为什么不可信,最好的办法是完整看一遍一个明星基准的一生。
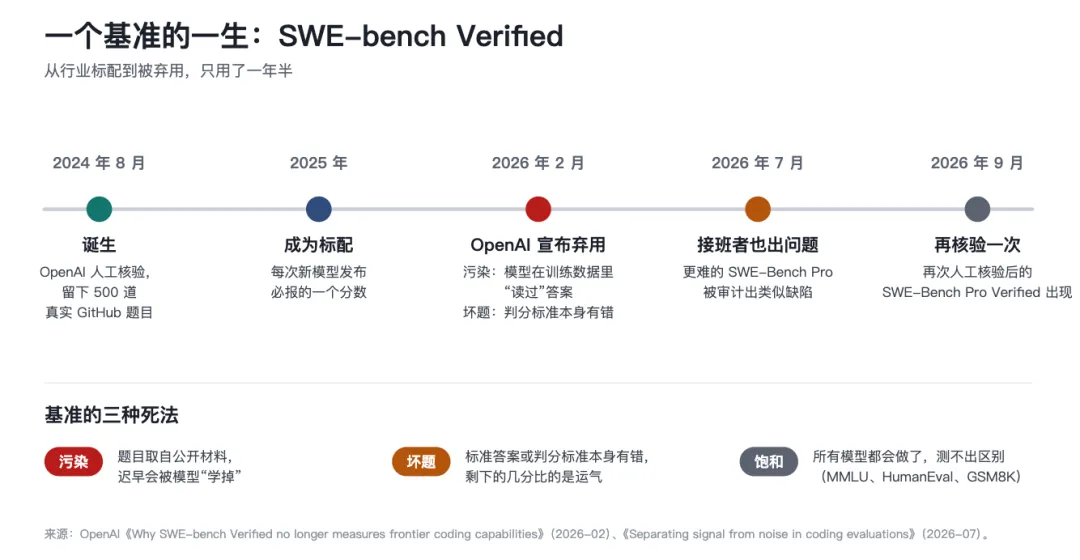
SWE-bench Verified 是过去两年最有分量的编程基准。它的题目是从 GitHub 上真实的开源项目里挖出来的:给模型一个 bug 报告和整个代码库,让它改代码,改完跑测试,测试通过就算解决。
2024 年 OpenAI 花人力把原始题库里描述不清、测试有问题的题筛掉,留下 500 道“核验过”的题,这就是 Verified 版本。此后每一次新模型发布,“SWE-bench Verified 多少分”几乎是标配。
然后到了 2026 年 2 月,OpenAI 自己宣布:我们不再用它了。
原因有两个,都很有代表性。第一个是污染。他们发现自家 GPT-5.2 在解一道 Django 题目时,思维链里冒出了 Django 某次版本更新说明的内容,而这道题的正确答案恰好取决于那次变更。换句话说,模型不是推出了答案,它是在训练数据里“读过”答案。这不是谁作弊——那些开源项目和它们的发布说明本来就在互联网上,而互联网就是训练数据。任何取材于公开材料的基准,迟早都会被模型学掉。
第二个原因更让人意外:题目本身是错的。审计发现剩下那些没被解决的难题里,很大一部分测试用例有缺陷——有的过窄,会把功能正确的解法判错;有的过宽,要求实现题面根本没提的功能。当一个基准只剩最后二十个百分点可争,而这二十个百分点里大多是“不可解题”,那排名之间的差距衡量的就不是能力,而是谁碰巧撞对了坏题。
OpenAI 转而推荐更难的 SWE-Bench Pro。结果 7 月他们审计 Pro,又发现了类似的问题;到 9 月,社区不得不再推出一个 SWE-Bench Pro Verified。
这个故事里藏着基准的两种死法。还有第三种,叫饱和:题目没错、也没漏,只是所有模型都会做了。老一代的 MMLU、HumanEval 早就被刷到 95% 以上;新一点的 MMLU-Pro,Epoch AI 今年 4 月复测发现顶级模型全挤在 89% 以上,彼此差距不到一个百分点。Hugging Face 那个曾经最有影响力的开源模型榜,2025 年 3 月干脆停更了,理由大致就是“旧题已经测不出区别”。
图 2 SWE-bench Verified 的一生,以及基准的三种死法
所以,看到任何一个分数,第一反应都应该是:这套题是哪一年出的,现在还活着吗?
榜单其实只有三种
理解了基准会死,下一个问题是:同一套题,不同榜单报出来的分数为什么也不一样?
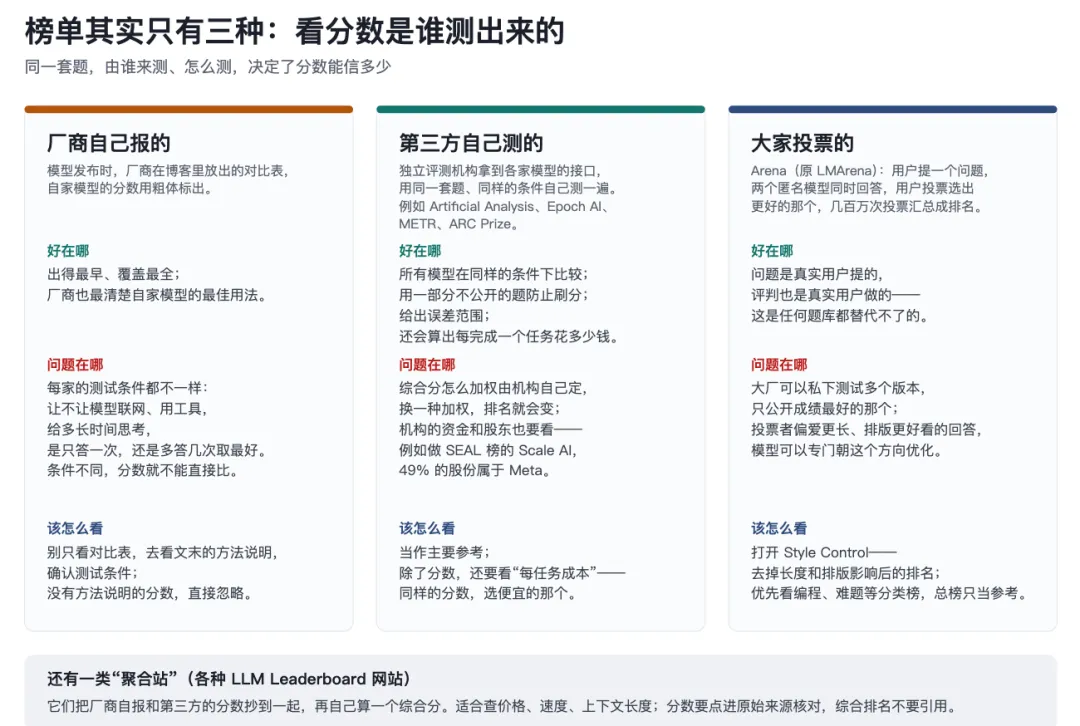
因为分数不是题目决定的,是“谁在跑分”决定的。按这个标准,市面上所有榜单其实只有三种。
图 3 按“谁在跑分”分类的三种榜单
第一种:厂商自己报的
每家实验室的发布博客都会附一张对比表,自家模型高亮加粗。这些分数一般不是假的,但它们几乎不可比。同一道题,开不开联网、开不开工具、推理档位调到多高、算一次做对的比例(pass@1)还是允许试八次取最好,每一项都能差好几分。有做评测方法研究的人统计过,同一个模型换一套运行脚手架(harness),分数能差出十几个百分点。所以两家厂商对同一个第三方模型报出不同分数,几乎从来不是谁撒谎,而是设置不同。
厂商自报的正确读法只有一种:跳过那张图,去看方法附录里的设置说明。如果没有附录,这个分数就当没看见。
第二种:第三方自己跑的
这是今天最值得信的一类。所谓“自己跑”,意思是评测机构拿到模型的 API,用同一套提示词、同一套工具、同一个脚手架,把所有模型过一遍,并把过程公开。
这一类里我最常用的是 Artificial Analysis。它的综合指数到 2026 年 9 月已经迭代到 v4.3,由 10 项评测组成,其中权重最大的是 agent 任务(30%),编程和科学推理各占 20%。它有几处别人很少做到的地方:45% 的权重来自不公开的私有题,所以很难被针对性刷分;每道题跑多次取平均,并给出置信区间(整体指数小于正负 1 分);最重要的是,它把每完成一个任务花多少钱、花多少时间和分数画在同一张图上。这张“智能 vs 成本”的图,是我做选型时看得最多的一张。
它的局限也要说清:只测英文纯文本任务;综合指数的权重是编辑决策,换一套权重排名就会变;还有开头说的两家并列 53 分——这种并列你应该直接读成“分不出来”,而不是琢磨谁的 53 更值钱。
同一类里还有几家各有专长。Epoch AI 的方法最透明,所有数据开放下载,还专门造那些训练集里绝不可能出现的题——今年 9 月刚推出的 FrontierMath Erdős,是 68 道截至上个月人类都还没解出来的 Erdős 猜想,要求模型在 Lean 里给出形式化证明。METR 只测一件事,但这件事很重要:模型能独立完成多长时间的软件任务。他们把任务按人类专家需要的时间标定,然后看模型在多长的任务上还能保持一半的成功率。ARC Prize 测的是“面对完全没见过的规则怎么办”,今年推出的 ARC-AGI-3 干脆做成了交互游戏,不给任何文字说明,让模型自己摸索目标、边玩边学。它同时也是“基准会死”的最新例子:3 月才发布,到 9 月初官方结果页上已经有一个模型拿到 99.95%,其他模型还在 30% 以下。从“几乎没人会做”到被顶级模型贴顶,只用了半年。
但第三方也有第三方的问题,主要是钱。Scale AI 做的 SEAL 榜方法论很扎实,也是 Humanity's Last Exam 的共建方,但 2025 年 6 月 Meta 花 143 亿美元买下了它 49% 的股份,创始人转去领导 Meta 的 AI 实验室,多家实验室随即缩减了和 Scale 的合作。一个股东本身是参赛选手的裁判,你总得打个折。Epoch 的 FrontierMath 早年也接受过 OpenAI 的资助,披露得比较迟,后来补了说明。这些都不等于榜单造假,但它意味着“独立”两个字不能默认,得逐个看资金来源。
第三种:大家投票的
Arena(今年 1 月之前叫 LMArena,最早叫 Chatbot Arena)是这类的唯一巨头。机制很简单:你提一个问题,两个匿名模型同时回答,你投票选更好的那个,光文本榜就累计了八百多万次投票,排名由这些投票算出。它最大的价值是真实——题目是真实用户提的,评判是真实用户做的,这是任何题库都替代不了的。
它的问题也来自这个“真实”。2025 年 4 月一篇叫《The Leaderboard Illusion》的论文指出:大厂可以在发布前私下测试多个版本,只把成绩最好的那个公开上榜——论文数了一下,Meta 在 Llama 4 发布前测了 27 个私有变体。Arena 回应说部分统计有误,同时也改了规则,比如把预发布测试过的模型标为“临时分数”,直到积累足够多的新投票。另一个问题是投票者喜欢什么:更长、格式更漂亮、emoji 更多的回答更容易赢,模型可以专门朝这个方向优化。Arena 为此加了一个叫 Style Control 的开关,剔除长度和格式的影响之后再排名。看 Arena 一定要开这个开关,并且优先看分类榜(编程、难题、网页开发),总榜只当参考。
还有一个背景值得知道:Arena 已经不是伯克利的学术项目了。据公开报道,它 2025 年拿了 1 亿美元种子轮,今年 1 月又完成 1.5 亿美元 A 轮,估值 17 亿美元,商业化方向是企业评测服务。一个靠排名吃饭的公司来做排名,本身没有错,但你应该知道这一点。
顺便说说聚合站和中文榜
各种“LLM Leaderboard 2026”网站,查价格、查速度、查上下文长度非常方便,但它们的分数都是转载的,厂商自报和第三方复测混在一起,各家还自己发明一个综合分。开头那个 62.7% 和 99.9% 的分歧就是这样来的——其中一家转载错了,而只有去官方页面才知道错的是哪一家。用法是:查元数据,点进原始来源,别引它们的排名。
中文榜单是另一回事。国际榜单几乎不测中文——不测中文长文、中文语境下的政策法律常识、中文代码注释。SuperCLUE 是这方面最持续的一家,今年 7 月的榜按数学推理、科学推理、agent 编程、精确指令遵循、幻觉控制、任务规划六项打分,号称每期换全新的原创中文题;OpenCompass 是上海 AI 实验室做的开源评测框架加榜单,还有一个中文版的投票竞技场。它们的折扣在于:SuperCLUE 每期只测十来个模型,题库不公开所以外界没法复现;OpenCompass 的“共建单位”里就有被测的厂商。我的建议是拿它们划候选范围,然后用 OpenCompass 或 EvalScope 这类开源框架,跑你自己的中文任务。
2026 年到底该看什么能力
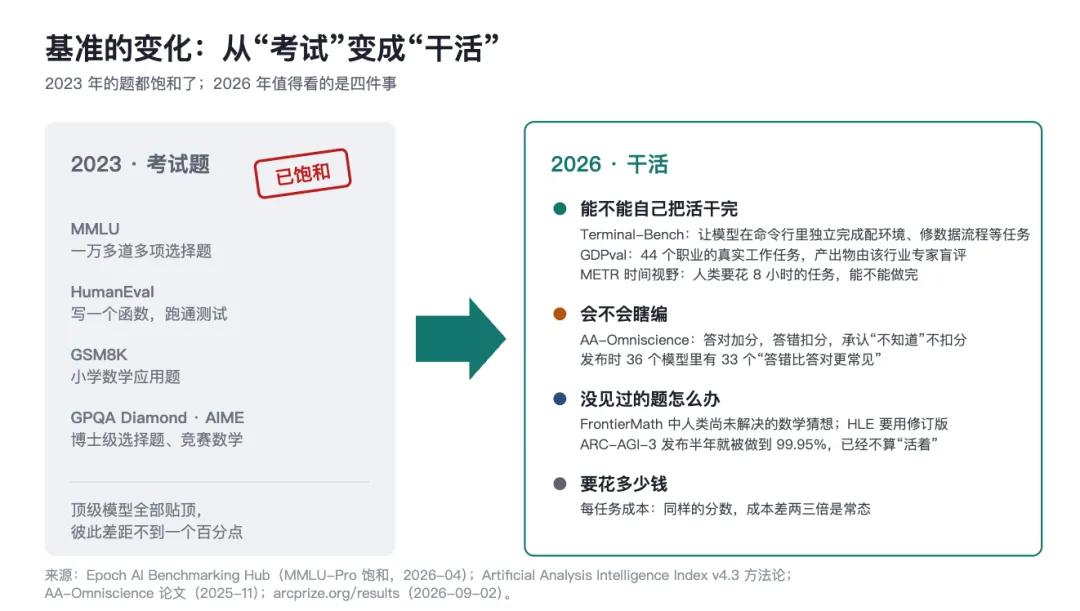
搞清楚了怎么信,再来说看什么。这两年基准的变化可以用一句话概括:从“考试”变成了“干活”。
2023 年的基准是选择题和算法题:MMLU 是一万多道多选,HumanEval 是写函数,GSM8K 是小学数学。这些都饱和了,今天可以从关注列表里删掉——包括看起来更高级的 GPQA Diamond 和 AIME 竞赛题,前沿模型在上面也已经贴顶。
2026 年值得看的,我归为四件事。
图 4 基准从“考试”变成“干活”,以及 2026 年值得看的四件事
第一,能不能自己把活干完。 好的 agent 基准都是这样的形态:给模型一个终端、一个浏览器或一堆文件,让它自己去做,最后检查产出。Terminal-Bench 是给一个容器,让模型完成配置环境、跑实验、修数据管线这样的终端任务;GDPval 是 OpenAI 去年从 44 个职业里收集的真实工作交付物——写一份财务分析、做一份法律备忘录——由该职业的专家盲评,Artificial Analysis 也在跑它的复刻版。METR 的“时间视野”则回答一个更抽象但更好懂的问题:人类要花 8 小时的任务,模型有一半概率做完吗?这条曲线近两年大约每三四个月翻一倍(METR 自己也提醒,别高估这个数字的精度)。这是目前模型之间差距最大的维度,Artificial Analysis 把它的权重提到 30% 不是巧合。
第二,会不会瞎编。 这一项在多数排行榜上是隐形的,却是企业落地时最先撞上的墙。Artificial Analysis 有一个叫 AA-Omniscience 的评测设计得很聪明:6,000 道跨 42 个领域的冷知识题,答对加分,答错扣分,说“我不知道”不扣分。结论很不好看:发布时 36 个模型里有 33 个“答错比答对更常见”,而且知识量最大的那几个模型往往不是幻觉最低的——它们的毛病是不知道也要猜。Stanford 今年的 AI Index 引用了这套数据:26 个顶级模型“不知道时仍然作答”的比例从 22% 到 94% 不等。选模型时,这个数字应该和智商分数放在一起看。
第三,遇到真正没见过的题怎么办。 这是留给“前沿推理”的位置,但要挑还活着的。ARC-AGI-3 已经不算了:它 3 月发布,9 月初就被一个模型做到 99.95%,现在只剩下区分其他模型的作用。还活着的是 FrontierMath 的 Erdős 子集,以及 Humanity's Last Exam——最后这个要带一个大警告。HLE 是 2,500 道由各学科专家出的“人类最后一场考试”,2025 年初顶级模型只能拿个位数,今年初已经到 37% 左右。但 FutureHouse 去年检查它的化学和生物题,发现大约 30% 的标准答案本身可能是错的,Scale 自己的估计也有 18%,今年 2 月才出了修订过的 HLE-Verified。看 HLE 时优先看这个修订版,并且看它的另一个指标——校准误差,也就是模型的自信程度和它的正确率是否匹配。答错还很自信,比答错本身更危险。
第四,要花多少钱。 同样的分数,成本差两三倍是常态;推理模型之间为一个任务吐出的 token 量差异更大,所以按每百万 token 的单价算不出真实成本。目前只有 Artificial Analysis 系统地报告“每任务成本”,这一列在多数选型决策里,比分数本身更早给出答案。
一套三分钟就能用的读榜方法
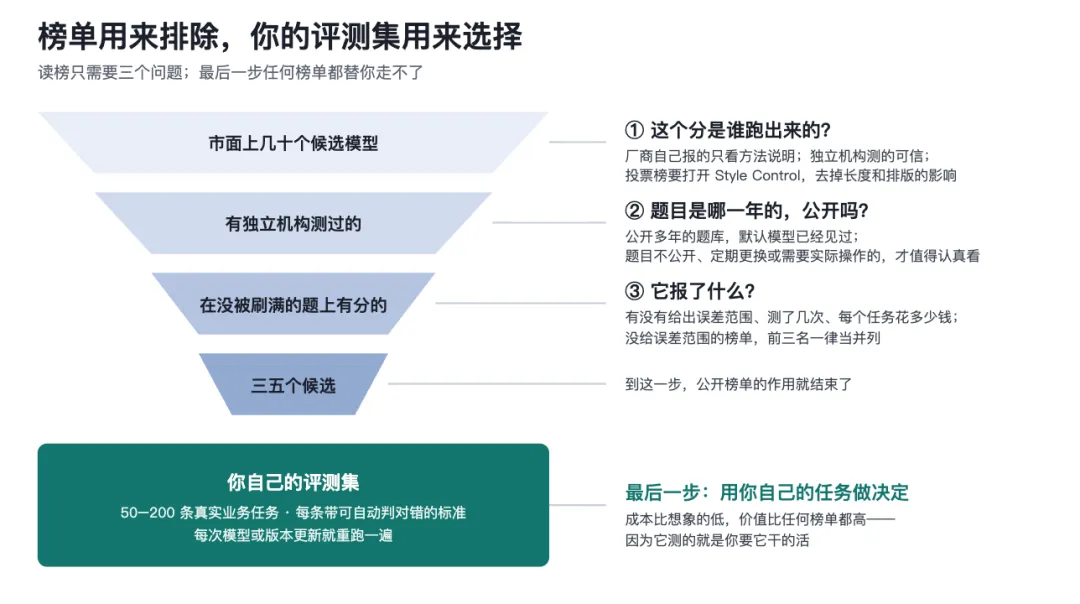
把上面这些压缩成一个习惯,其实只需要问三个问题。
这个分是谁跑出来的? 厂商自报,跳过图看附录;第三方复测,可以信;投票榜,开 Style Control 看分类;聚合站,只查元数据。
题目是哪一年的,公开吗? 公开的老题库,默认已经被学过;有私有题、定期换题、或者干脆是交互环境的,才值得认真看。
它报了什么? 有没有置信区间、跑了几次、有没有成本。没报置信区间的榜单,前三名一律当并列。
然后是最重要的一条:榜单的用途是排除,不是选择。 公开榜单能帮你把五十个候选缩到五个,但决定用哪一个,只能靠你自己的任务。攒 50 到 200 条真实业务里的任务,每条带一个可以自动判对错的标准,每次模型或版本更新就重跑一遍。这件事的成本比你想的低,价值比任何榜单都高,因为它测的就是你要它干的活。
图 5 读榜的三个问题,和最后一步
回到那个问题
所以,“现在哪个模型最强”?
我后来给朋友的回答是:先说你要拿它干什么。
要写代码,看 Terminal-Bench 和 SWE-Bench Pro 的第三方分;
要做知识型的工作,先看幻觉率再看智商;
要大规模部署,把成本轴叠上去。
然后你会得到三个候选,而不是一个冠军。剩下的那一步,任何榜单都替你走不了。
2026 年的评测行业已经明显分化:一边是不断换题、公开方法、报告置信区间和成本、并且愿意承认自己局限的机构;另一边是被融资和股权稀释了独立性的名字,和一大批靠转载吃饭的聚合站。分辨它们的方法,和分辨任何一份研究报告一样——看方法、看资金、看能不能复现。
而当模型真的开始替人干活之后,最好的 benchmark,就是你的工作本身。