游戏排行榜,是所有 Redis 教程里出镜率最高的案例。但我要告诉你:把"用 ZSet 做排行榜"讲出来,只能得 60 分。面试官只要接着问一句"两个人同分,怎么排?",大多数人就卡住了。
今天这篇文章,把 ZSet 排行榜从基础到同分进阶,一次讲透。
一、ZSet 是什么:带分数的 Set
ZSet 的全称是 Sorted Set,有序集合。你可以把它理解成"每个元素都挂着一个分数(score)的 Set":
game:rank Tom 95 分 Jerry 88 分 Alice 95 分 Bob 70 分
它继承 Set 的两个特性:元素唯一、可以去做重。但它多了一个杀手锏:每个元素对应一个分数,Redis 内部按分数从小到大排好序。
底层实现上,数据量少时用压缩列表,数据量大了用跳表(Skip List)加哈希表的组合。跳表带来的结果是:插入、删除、按分数查找都是 O(log N),取排行榜前 N 名是 O(log N + N)。这意味着什么?哪怕榜单里有 1000 万用户,取 Top 100 也是毫秒级。
二、核心操作,八招打天下
建议先把一批演示数据写进 Redis,后面所有读操作(Top10、名次、分段统计)都能直接看到效果。下面用 RedisTemplate 一次性灌入 6 个玩家,并刻意让 Tom、Alice 同为 95 分,方便后面演示「同分」:
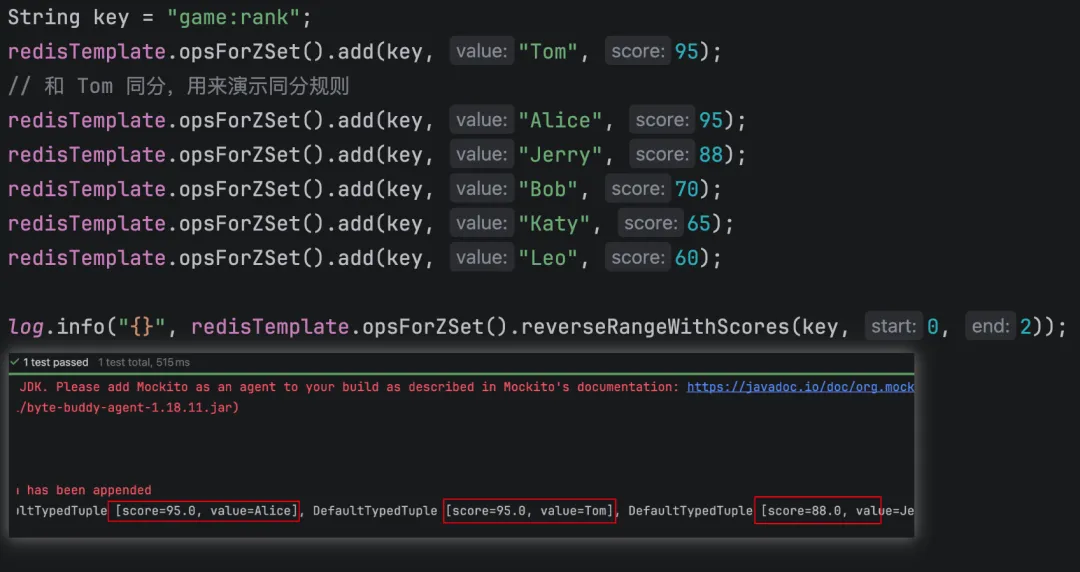
String key = "game:rank";redisTemplate.opsForZSet().add(key, "Tom", 95);// 和 Tom 同分,用来演示同分规则redisTemplate.opsForZSet().add(key, "Alice", 95); redisTemplate.opsForZSet().add(key, "Jerry", 88);redisTemplate.opsForZSet().add(key, "Bob", 70);redisTemplate.opsForZSet().add(key, "Katy", 65);redisTemplate.opsForZSet().add(key, "Leo", 60);
排行榜开发,记住这八个操作就够了(读操作都基于上面这批数据):
// 以下操作都通过注入的 RedisTemplate 完成;opsForZSet() 是 ZSet 操作入口// 1. 新玩家上榜redisTemplate.opsForZSet().add(key, "Tom", 95);// 2. 玩家杀怪加分(原子,不需要先读再写)redisTemplate.opsForZSet().incrementScore(key, "Tom", 10); // 95 → 105// 3. 取排行榜 Top 10(降序,从第 0 名开始)redisTemplate.opsForZSet().reverseRange(key, 0, 9);// 4. Top 10 带分数,前端要展示”排名+分数”redisTemplate.opsForZSet().reverseRangeWithScores(key, 0, 9);// 5. 查某个玩家排第几(降序排名,从 0 开始)redisTemplate.opsForZSet().reverseRank(key, "Tom"); // 0 = 第 1 名// 6. 查原始分数redisTemplate.opsForZSet().score(key, "Tom");// 7. 榜单总人数redisTemplate.opsForZSet().size(key);// 8. 按分数区间统计:90 分以上多少人redisTemplate.opsForZSet().count(key, 90, 100);
这里有一个重要的细节:ZSet 内部是按分数从小到大(升序)存的,而排行榜要的是从大到小,所以取排行榜必须用 reverseRange()(对应 redis-cli 的 ZREVRANGE,反转范围)。很多新手背了 range()(对应 ZRANGE)就去取排行榜,取出来是最差的几个,直接被自己坑了。
另外一个细节:rank() 和 reverseRank() 的区别(对应 ZRANK / ZREVRANK)。rank() 是正序排名(分数最低的排第 0),reverseRank() 是倒序排名(分数最高的排第 0)。排行榜一律用 reverseRank()。
三、动手搭一个 Top 3 排行榜
上面已灌入 6 个玩家,直接取 Top 3:
redisTemplate.opsForZSet().reverseRangeWithScores(key, 0, 2)
结果会是什么?注意 Tom 和 Alice 都是 95 分——同分。Redis 的同分规则是:按元素本身排序(字典序)。Alice 的字母序在 Tom 前面,所以同分时 Alice 会排在 Tom 前面。
返回结果,我稍微格式化一下
0: Alice 95 分1: Tom 95 分2: Jerry 88 分
Bob 70 分排第四,落榜。
到这一步,排行榜的基础版就完成了。用 redis-cli 验证一下,命令行里执行:
ZREVRANGE game:rank 0 2 WITHSCORES
输出跟程序一致,说明你程序操作的就是那个真实的 Redis。
四、同分怎么排?两个业务方案,面试重点
现在回答开头的问题:两个人同分,怎么排?
Redis 默认按字典序。但业务往往不满意这个规则,常见的诉求有两种。
诉求一:先到的人,同分排前面。
比如游戏排行榜,两个玩家同分,先达到这个分数的应该排在前面。用纯分数排不出来,因为分数一样。解法是:把分数和达成时间编码进同一个 score。
具体做法:score 的整数部分放真实分数,小数部分放"时间补偿值"。比如用 1e13 减去当前毫秒时间戳,得到一个小数:时间越早,这个值越大,排得越前。
double score = 95 + (1e13 - System.currentTimeMillis()) / 1e13;redisTemplate.opsForZSet().add(key, "Tom", score);
这样 Tom 的 95 分变成类似 95.99990 的数字,先到的用户小数部分更大,排前面。同时分数展示时取整,用户看到还是 95。
这个技巧在面试里非常加分,因为它展示了你对"score 不一定是整数"的理解深度。
诉求二:同分算并列,名次一样。
体育比赛、榜单展示场景,往往希望 95 分的两个人都是"第 1 名",而不是第 1 名和第 2 名。解法是分桶展示:按分数分组,同一分数的所有玩家共享同一个名次。前端展示"第 1 名(并列 2 人)"。
Redis 的命令层面不用改,改的是前端展示逻辑——按分数分组后,用组内第一个人的排名作为整组排名。
两条路线的选择标准很简单:如果"先后顺序"有业务意义,用时间戳加权;如果只是展示"并列第几名",分桶展示即可。
五、进阶玩法:分段统计
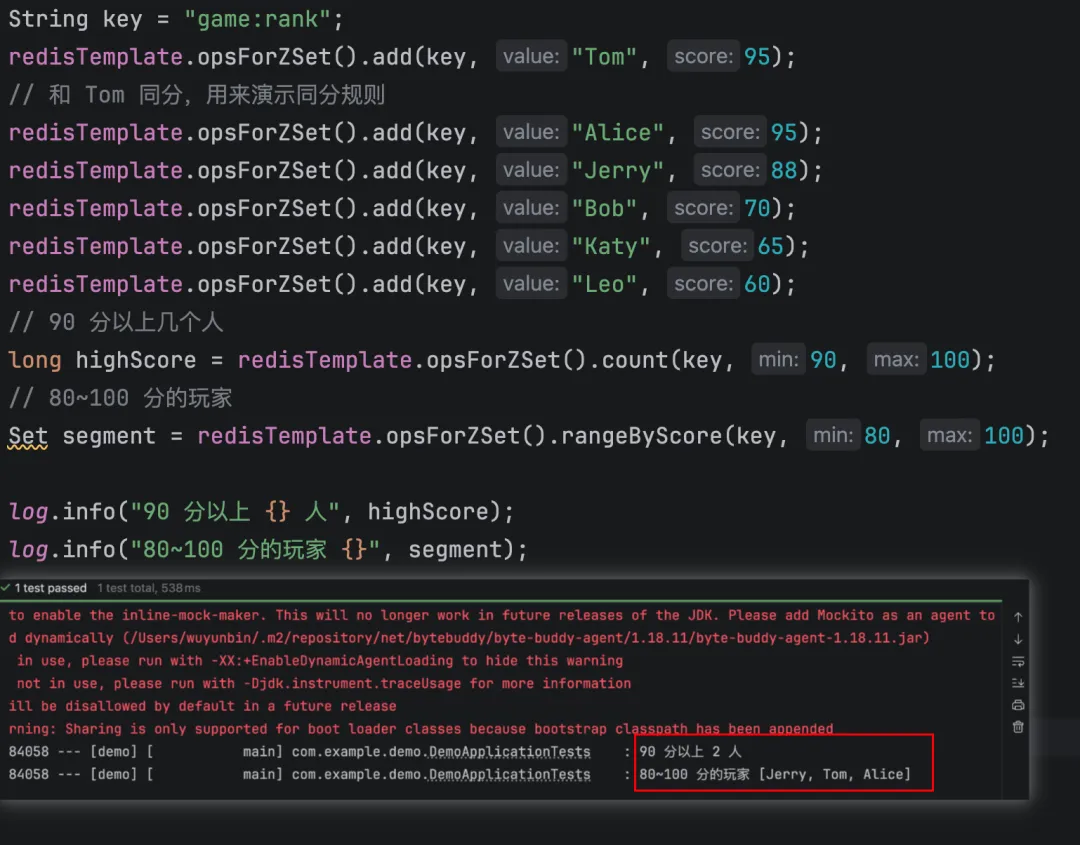
排行榜做到最后,产品会提更多需求:90 分以上的玩家有多少?80 到 100 分的名单给我?
这两个问题,count() 和 rangeByScore() 直接回答(对应 ZCOUNT / ZRANGEBYSCORE):
// 90 分以上几个人long highScore = redisTemplate.opsForZSet().count(key, 90, 100);// 80~100 分的玩家Set segment = redisTemplate.opsForZSet().rangeByScore(key, 80, 100);
"按分数分段"是排行榜运营的核心操作——运营要圈出高分段用户发奖,一句 rangeByScore()(对应 ZRANGEBYSCORE)就圈出来了。这跟我们 Day 10 讲的人群圈选,底层是同一个思想:把"圈人"变成"查一个区间"。
结语
回到开头:排行榜背后的 ZSet,同分怎么排?
基础答法是字典序;进阶答法是时间戳加权编码;再进一步是分桶并列展示。你能答到哪一层,决定你在这个话题上的得分。
ZSet 是 Redis 五种数据类型里"聪明程度"最高的一个:它自己排序、自己计数、自己按区间查询,把排行榜从"你写排序算法"变成"你说取前几名"。记住它的关键词:带分数、自动排序、O(log N)。
Redis 训练营第五天的两篇到此结束。Set 管"集合运算",ZSet 管"有序排名"——这两个兄弟,撑起了社交、游戏、运营一大片业务。
明天,我们跳出单点 API,聊聊代码组织:为什么你的 Redis 代码别人看不懂,以及怎么把它写整洁。