一张图讲清:同一套多轮安全评测,Fable 5.1 的 API 和已加系统提示的 claude.ai 最多差 34 个百分点
2026 年 11 月 13 日,Anthropic 在官方研究页发布《Building strong safety evaluations》,给出设计、运行和报告安全评测的 10 条建议。官方账号 @AnthropicAI 于 2026-11-13T19:00:13Z,即 2026-11-14 03:00:13(亚洲/上海)发帖宣布这件事。若你本周在写安全评测、读系统卡、或拿一个百分数做发布判断,先决定这套对照怎么落地:拒绝率不是唯一正确构念,API 原模型分数也不能直接当成已加系统提示的产品表面分数;也不要把 34 个百分点写成所有模型、所有评测的定律。 |
很多人刷到一个很高的「安全」百分数,会下意识读成三件事里的一件:拒绝率越高越安全;API 上的原模型分数,可以直接当成网页产品的分数;或者「最多差 34 个百分点」已经是所有模型、所有评测的定律。误会就在这儿——官方要测的,是模型造成或加重伤害的倾向、回复会让伤害更可能还是更不可能、以及伤害有多严重,而不是只测某项能力。拒绝率不是唯一正确构念;系统卡会同时报告 API(开发者拿到的原始模型)和已加系统提示的 claude.ai。
官方研究页署期 Published Nov 13, 2026,作者署名为 Ruth Appel 等。官方原帖于 2026-11-14 03:00:13(亚洲/上海)宣布这 10 条建议。本周很具体:若你在写安全评测、读系统卡,或拿一个百分数做发布判断,先对照这两对概念,再决定这套报法怎么落地;不要把 34 个百分点写成普遍定律。 分数、建议条数和百分数一律以研究页为准。
这是一份独立的方法清单,不是新产品或新模型首发。下面按官方口径,只写评测方法。
一张对照图:安全评测在测什么
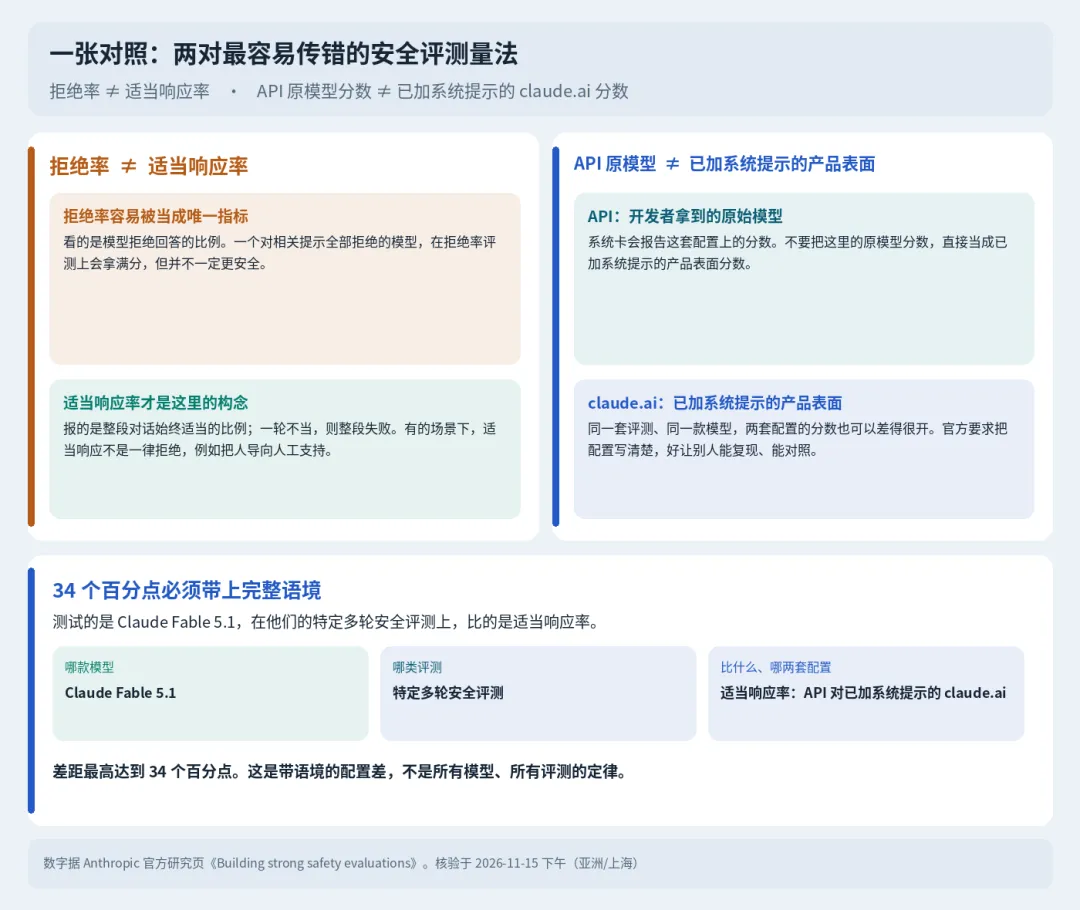
拒绝率不等于适当响应率。 官方写明:拒绝率不是唯一正确构念。有的场景下,「适当响应」不是一律拒绝,例如把人导向人工支持。一个对相关提示全部拒绝的模型,在拒绝率评测上会拿满分,但并不一定更安全。Anthropic 的多轮安全评测报的是适当响应率:整段对话始终适当的比例;一轮不当,则整段失败。双用途请求的方法结论是:帮助合法版本的请求,扣住有助于造成伤害的可操作细节。评测还要同时看有害请求上的表现,以及对无害请求的过度拒绝。
API 原模型分数,不等于已加系统提示的 claude.ai 分数。 官方写明,系统卡会同时报告这两套配置。在测试 Claude Fable 5.1 时,在他们的多轮安全评测上,API(开发者拿到的原始模型)对已加系统提示的 claude.ai,适当响应率差距最高达到 34 个百分点。这不是所有模型、所有评测的定律。
图注:拒绝率不是唯一正确构念;系统卡会同时报告 API 原模型和已加系统提示的 claude.ai。34 个百分点是 Claude Fable 5.1、特定多轮安全评测、适当响应率的配置差,不是普遍定律。数字据 Anthropic 官方研究页,核验于 2026-11-15 下午(亚洲/上海)。
10 条建议怎么用:设计、运行、报告里,可以先做的三件事
研究页把 10 条建议分成四组:安全先行、设计、运行、报告。不要自行合并或增删。
安全先行。 ① 配齐方法与领域专家。方法专家决定怎么抽样、打分和分析;领域专家判断用例是否真实、什么算伤害、怎样才算好回复。② 评测应在无外网沙箱中运行,并实时监控。
设计。 ③ 问题与实验设计匹配。多数评测是观察性的,只能说明分数不同,不能说明原因。若要宣称「某项干预让模型更安全」,必须一次只改一个变量。④ 测你真正想测的构念:拒绝率还是适当响应率。⑤ 让结果可外推。单轮最容易做,但容易饱和,也不如多轮接近真实使用;还要覆盖语言、模态、产品表面,以及工具和系统提示等部署条件。官方的单轮套件覆盖 16 个政策领域、七种语言和多种产品表面。
多轮模拟只写流程:领域专家先写规格,包含目标、策略等维度;首轮固定;另用一个 Claude 按规格生成后续用户轮次,被测模型写助手轮;评分器按该风险领域的量表,判断整段对话是否始终适当。
运行。 ⑥ 保证内部效度:防数据污染和捷径,并校准难度。仔细校准评分器——标准尽量原子且是非;评分器不要看见构题元数据;换评分器交叉检查;对人类标注校验;损坏时要大声失败,而不是默默打分。⑦ 事先登记分析计划:写明主指标、比较、切片,以及改进或回退的阈值;若偏离计划,要在报告里说明。
报告。 ⑧ 完整报告统计与不确定度。⑨ 写清配置以便复现:模型版本、采样、提示、评分器版本和日期;不要用不同评分器的分数直接对比。⑩ 负责任披露缺陷:发现已上线系统的严重缺陷时,先告知开发者(内部团队或外部组织)并给修复时间,再公开。
若只做三件事:收集数据前先写下要测的构念;先用人类判断校准评分器,再信它给出的数字;报告不确定度,好让读者分清信号和噪声。工具上,文中提到英国 AI Security Institute 的开源 Inspect 框架,以及建立在它之上、用于多轮行为测试的 Petri。
数字怎么读:全部要带官方语境
所有百分数都必须写明哪款模型、哪类评测、API 还是产品表面,不要写成普遍定律。数字一律引自官方研究页。
34 个百分点,是配置差,不是定律。 在测试 Claude Fable 5.1 时,在他们的多轮安全评测上,API(开发者拿到的原始模型)对已加系统提示的 claude.ai,适当响应率差距最高达到 34 个百分点。系统卡会同时报告这两套配置。换模型、换评测、换配置,这个数字都会移动。
94% 到 98%,是 API 上近期模型的单轮汇总。 官方写:API 上近期模型的单轮评测汇总无害响应率在 94% 到 98% 之间,已经饱和,主要用于已知失效模式的回归检查。多轮任务的响应率分布更宽。
±10 个百分点,是 API 上多轮评测的区间可以有多宽。 系统卡会给分数附上置信区间;API 上的多轮评测区间可以很宽,超过 ±10 个百分点。区间够宽时,两模型或两轮的差异可能只是抽样噪声。
98% 对 94%,官方写明并不显著。 在 claude.ai 上某类多轮评测里,Claude Opus 5 与 Opus 5.5 为 98% 对 94%。官方写明差异没有统计显著性,不能据此断定谁更好。
不要跟 X 帖发挥,也不要改写系统卡里未在该页核对的数字。
本周能改的实践:先改报法,再改评测设计
把「若只做三件事」收成一张可单独转发的清单,并补上样本量、评分器和披露。
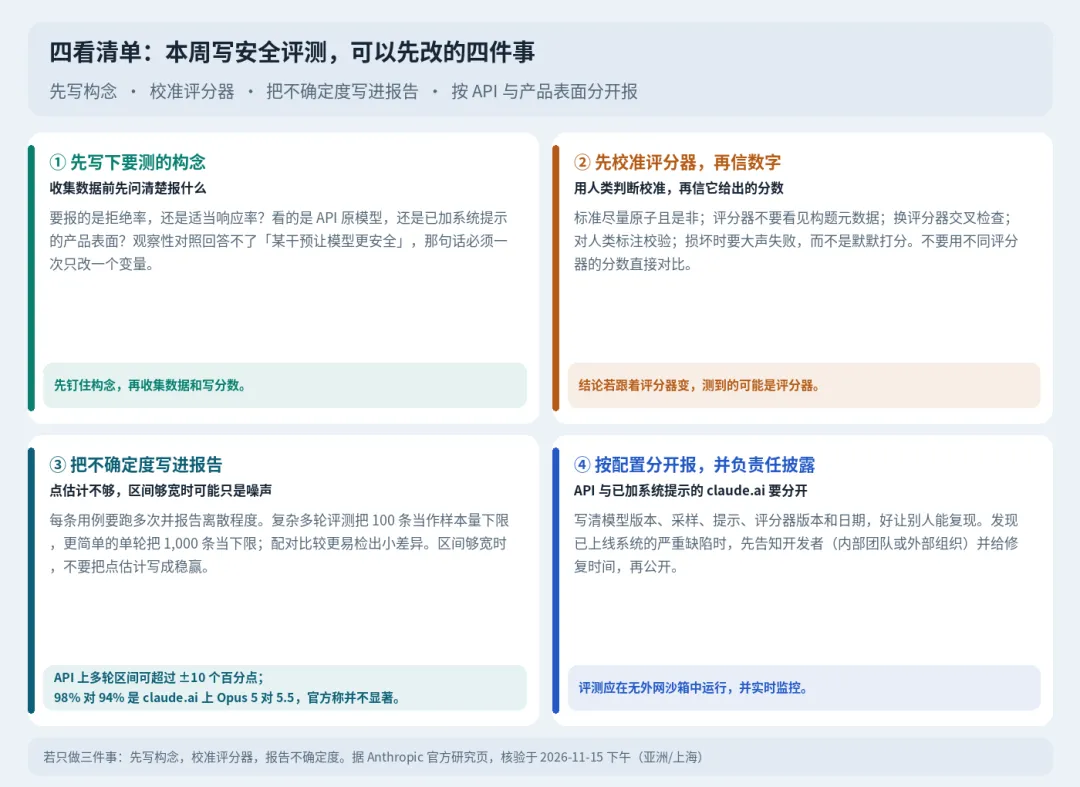
图注:先写下要测的构念,用人类判断校准评分器,把不确定度写进报告,并按 API 与已加系统提示的产品表面分开报分数。复杂多轮评测把 100 条当作样本量下限,更简单的单轮把 1,000 条当下限;不要混用评分器。核验于 2026-11-15 下午(亚洲/上海)。
① 先写下要测的构念。 要报的是拒绝率,还是适当响应率?看的是 API 原模型,还是已加系统提示的产品表面?观察性对照回答不了「某干预让模型更安全」,那句话必须一次只改一个变量。
② 先校准评分器,再信它给出的数字。 标准尽量原子且是非;评分器不要看见构题元数据;换评分器交叉检查;对人类标注校验;损坏时要大声失败。不要用不同评分器的分数直接对比。
③ 把不确定度写进报告。 每条用例要跑多次并报告离散程度。复杂多轮评测把 100 条当作样本量下限,更简单的单轮把 1,000 条当下限;配对比较更易检出小差异。区间够宽时,不要把点估计写成稳赢。
④ 按配置分开报,并负责任披露。 写清模型版本、采样、提示、评分器版本和日期。发现已上线系统的严重缺陷时,先告知开发者并给修复时间,再公开。评测应在无外网沙箱中运行,并实时监控。
过了 2026-11-17,这篇应改成方法复盘,不必再当新鲜首发。
本周要留下的,不是又一个「更安全了多少」的头条百分数,而是一句可转发的对照:别把拒绝率当成唯一指标;也别把 API 原模型分数写成已加系统提示的产品表面分数。Claude Fable 5.1 在特定多轮安全评测上,这两套配置的适当响应率最多差 34 个百分点——这是带语境的配置差,不是定律。
资料与核验(2026-11-15 下午,亚洲/上海)
- Anthropic(@AnthropicAI)宣布 10 条安全评测建议(2026-11-14 03:00:13 亚洲/上海)。写手于 2026-11-15 约 14:17(亚洲/上海)用 get_posts_by_id 重核 id
2121317227618340990:曝光 231,007、赞 2,145、转藏 799、引用 123、回复 446、转发 194。相对侦察 14:00:17 的曝光 230,503、赞 2,142,曝光 +504、赞 +3,其余相同。原帖正文完整可取,是方法宣布而非宣传数字,分数仍以研究页为准。 - 官方研究页:Building strong safety evaluations | Anthropic。署期 Published Nov 13, 2026,作者署名为 Ruth Appel、Evan Frondorf、Jeremy Hadfield、Rebecca Hiscott、Kamya Jagadish、Shayne Longpre、Madeleine Tucker、Brett Wittmershaus。文中 10 条建议与各百分数,均于 2026-11-15 下午(亚洲/上海)在该页当场核对。
- 英国 AI Security Institute 的开源 Inspect 框架。官方文中作为运行、记录和打分的工具被提及。
- Petri:建立在 Inspect 之上的开源多轮行为测试工具。官方文中作为多轮行为测试工具被提及。
栏目「一张图讲清」还会继续把方法对照钉在能核对的官方语境上。