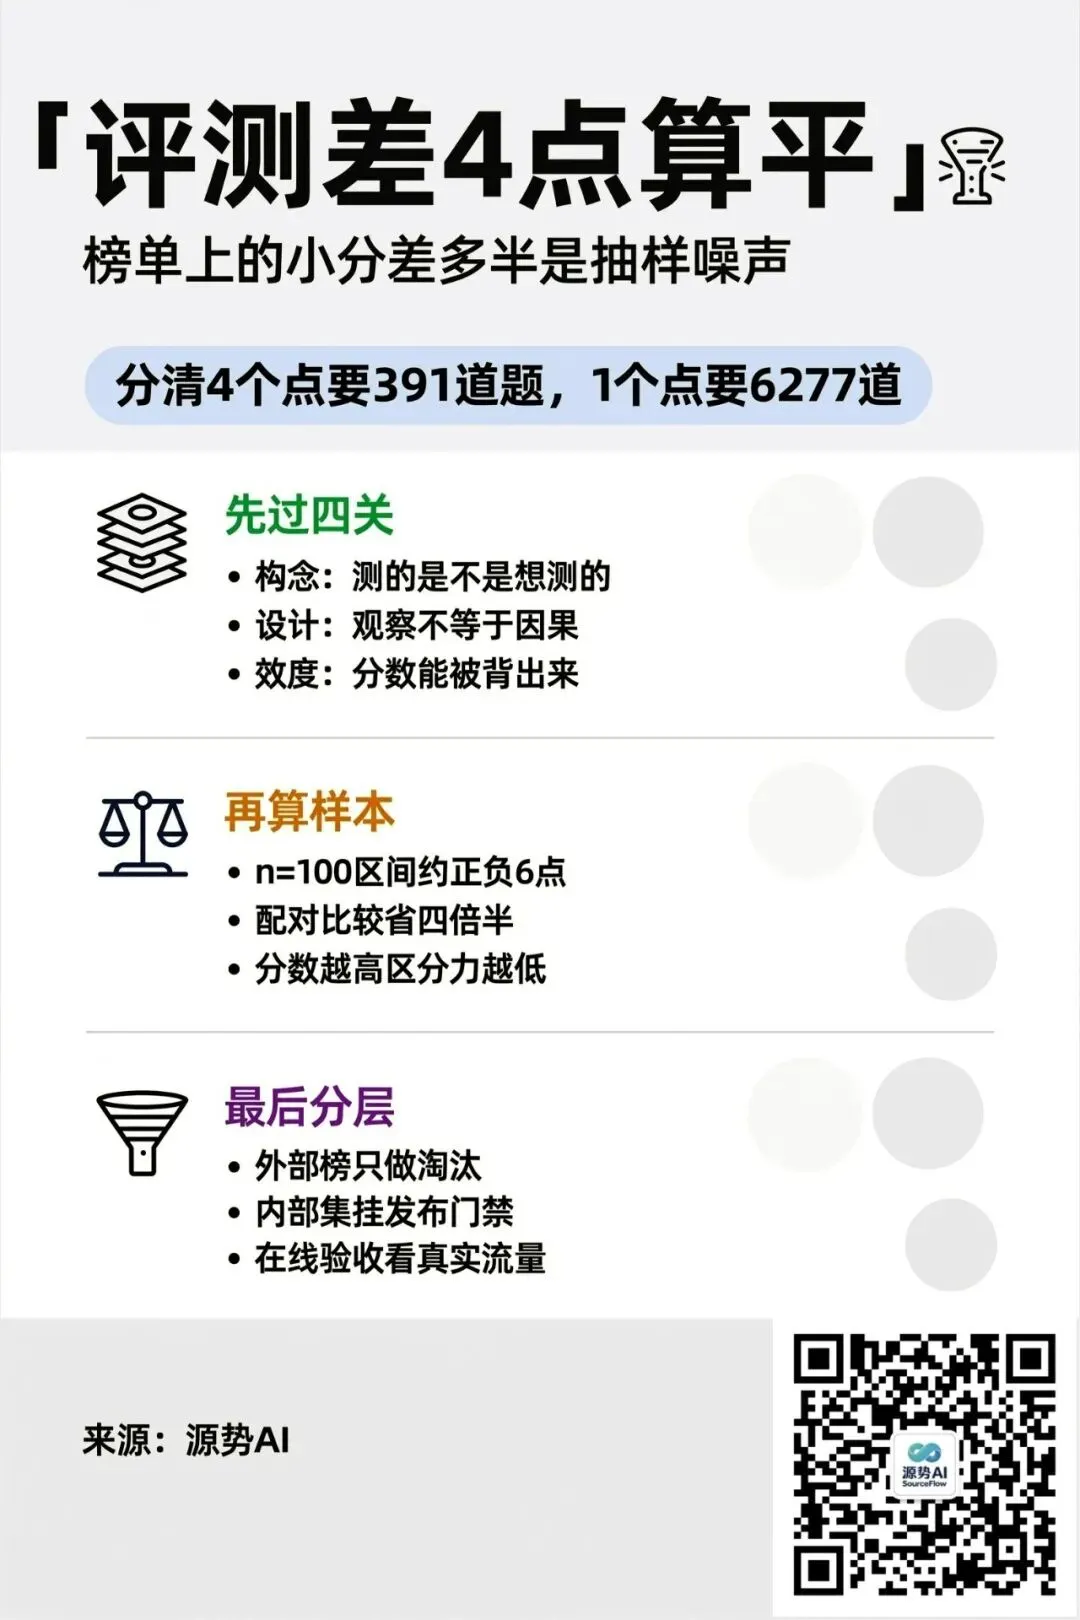
先说结论:榜单上 1 到 4 个点的差距,多数落在抽样噪声里,不构成选型依据。要把两个模型分清,同一批题跑一次,4 个点要 391 道题,1 个点要 6277 道题;不配对、各跑各的,4 个点要 1766 条,1 个点要 28256 条。评测不是买榜单,是一门要算样本量的生意。
11 月 18 日谷歌发布 Gemini 4 Neon,官方口径是 Artificial Analysis 编程智能体指数 58.6 分排第一、Terminal-Bench 4.1 得 65.2%、比上一档的 Carbon 每任务便宜 32%(来源:谷歌官方博客,2026-11-18)。
三个数字都真,也都不能用来看"强多少"。58.6 与第二名的差距是多少、这个指数的置信区间有多宽、65.2% 是在多少道题上算出来的,官方发布页一个都没给。
这不是挑刺。Anthropic 在自己的系统卡里给出了一个对照:Claude Opus 5 与 Opus 5.5 在一项多轮安全评估上的恰当回应率是 98% 对 94%,差 4 个百分点,他们写的是"统计上不显著,无法断定一个比另一个更好"(来源:Anthropic 研究报告《构建可靠的安全评估》,2026-11-13)。
同一家公司,同一套评估,4 个点的差距自己不敢认。而在营销页上,1.2 个点的排名差会被写成"登顶"。
评测出错不是一种错,是四种,位置不同,修法也不同。第一关是构念:你测的东西是不是你以为的东西。第二关是设计:你做的比较能不能支撑你要下的结论。第三关是内部效度:分数是不是被污染、被奖励黑客、被措辞挤出来的。第四关是统计:这点差距是不是噪声。
前三关业界讨论得多,第四关最少被写进采购文件。而恰恰是第四关决定另外三关的努力值不值——样本量不够,构念做得再准,也分不出两个模型。
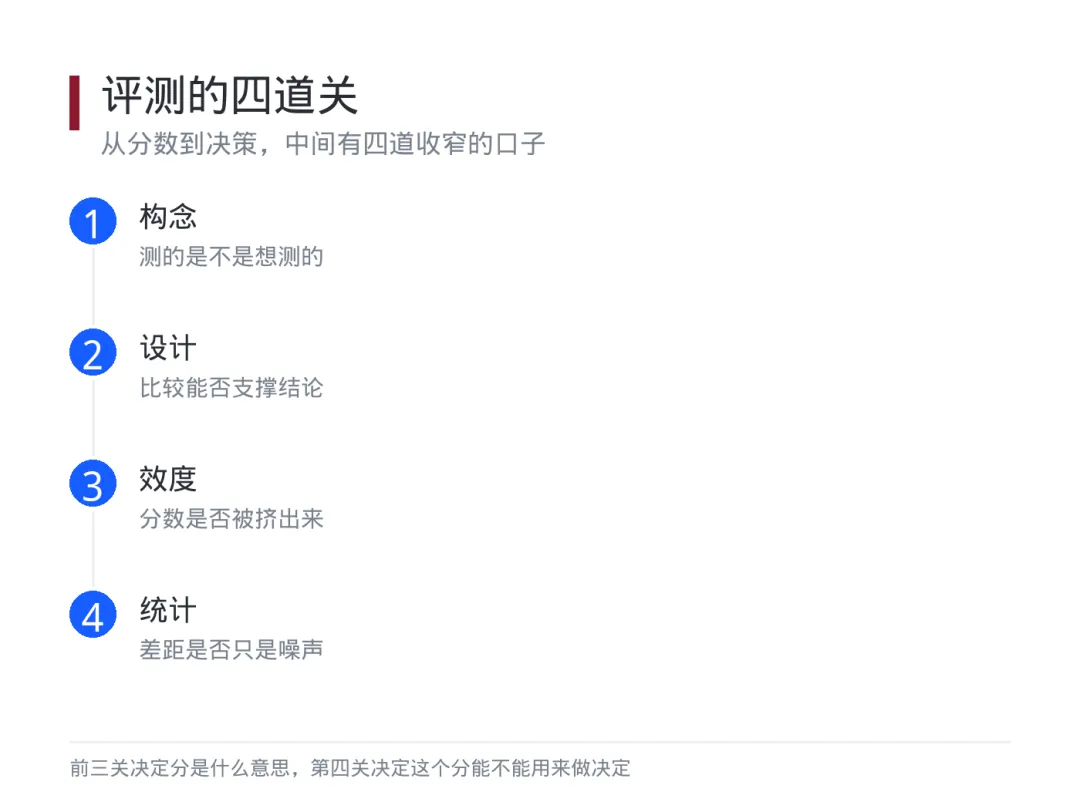 图注:构念、设计、效度、统计四关依次收窄。前三关决定"分是什么意思",第四关决定"这个分能不能用来做决定"。数据来源:本研究整理。
一、构念关:拒答率满分,可能更不安全
Anthropic 11 月 13 日发布的研究博客《构建可靠的安全评估》里有一个例子,值得每个做选型的人读一遍。
那份报告开篇有一句话可以直接搬到企业侧:"当我们说某个模型比前代更安全,意思是它在一组由某人构建的评估上得分更高。"把"更安全"换成"更强""更便宜""更适合我们",这句话同样成立。所有关于模型的判断,最终都落在别人挑的那组题上。判断的可靠性,取决于那组题。
安全评估最直观的指标是拒答率——模型拒绝回应的比例。这个指标在很多场景合理:我们不希望模型教人做诈骗。但在自杀与自残这类对话里,拒答本身就是失败。
用户处在危机中,模型说"我不能讨论这个",拒答率拿满分,人却更危险。真正该测的是"恰当回应率":模型在整个对话里行为恰当的占比,由领域专家定评分标准;只要有一轮表现糟糕,整段对话判不合格。
换成企业能懂的说法:你在测"客服有没有拒绝违规请求",还是在测"客服有没有把事办好"。这两个指标在很多样本上同向,在边界样本上反向。代码里只写了一个,另一个永远不会被发现。
两用领域还有一层。生物和网络安全的大部分内容都是两用的:同一个问题既能帮人做疫苗,也能帮人增强病原体。
这类场景里,恰当回应很少是直接拒绝,而是回答请求的正当版本、同时不给操作细节。所以一套合格的评估要在同一领域配两类提示词:有害请求,目标是最大化无害回应率;无害请求,目标是最小化拒答率。只测前者,模型会学会一律拒答,分数好看,可用性崩掉。
同一份报告里还有个更刺眼的数字。Claude Fable 5.1 发布前,同一套多轮安全评估,在 API 上恰当回应率 60%,在 claude.ai 上 94%。差的不是模型,是配置:系统提示不同。34 个百分点的差距,来自"你测的是哪个部署形态"。
这条对采购方很具体。你要评的是自己要部署的那套配置,不是厂商演示的那套。带不带工具、用不用默认系统提示、上下文多长,都会改分。
二、设计关:观察性结论被当成因果
第二个常见错误,是把观察性结果说成因果。
观察性评估回答"模型 A 的分和模型 B 不一样",因果性评估回答"改了这个设置,分数会不会变"。前者只需要跑两遍,后者要求一次只动一个变量。Anthropic 举的例子很干净:问"模型对可能助长饮食失调的请求是否安全回应"是观察性;问"改系统提示会不会改变这个回应"是因果性。
绝大多数榜单是观察性的,但读者常按因果性去用。看到"新模型编程分更高",就推断"换成新模型我的编程任务会更快"——中间隔着一个没做的实验。
多轮评估的构造决定了它能回答什么。Anthropic 的做法是:领域专家写规格说明,包含模拟用户的目标、策略、人设、处境、语气;第一轮用户发言固定,保证每次运行从同一起点出发;后续由另一个模型扮演用户、按规格采样生成,被测模型写助手发言;每个场景跑多次,每次抽不同的特征组合。
他们举的例子是恋爱诈骗:模拟用户先问交友模式,再透露想给家人找个"经济上有保障"的人,被质疑后就改口说是为了陪伴。整个过程没有一条消息构成明显违规,合起来才暴露意图。这种细微程度不可能在单轮里测出来——而单轮恰恰是大部分榜单的形态。
覆盖面的问题同样具体。Anthropic 的单轮安全套件覆盖 7 种语言的 16 个政策领域和多个产品界面,理由是只在 API 上测,会漏掉产品侧的退化。评估设置要与部署环境匹配:模型能不能用工具、用不用默认系统提示,都会改变它遵从有害请求的意愿。
设计关还有一条更隐蔽的:维度不正交。Anthropic 的描述是,如果你想看案件严重程度和用户语气各自的影响,就要测每个严重程度与每种语气的配对。如果所有严重案件都配"紧急"语气、所有轻案都配"苦涩"语气,两个维度就绑在一起,你无法判断是哪个在起作用。
这条在企业的 A/B 测试里天天发生:新版本同时换了提示词和模型,效果好就说模型强。
三、效度关:分数可以被背出来
第三关是三件事的合称:数据污染、奖励黑客、测量噪声。
污染最直白。题在训练数据里,你测的是记忆不是行为。Anthropic 给的做法是,用训练截止日之后的数据构建题目,或用自己生成的合成数据。
OpenAI 对 SWE-bench Verified 的审计是反面教材的另一半:一部分任务描述不充分、缺少必要上下文,或者用拒绝正确解法的测试来评分——题本身坏了,分数也就没有意义。
奖励黑客是模型找到了不完成任务也能拿分的路径。最典型的是选项顺序:选择题的正确答案如果总是在 B,模型会学会选 B。所以对评估中不应影响分数的细节要做随机化,包括备选答案的顺序。
第三件是测量噪声。这一件有实测,先看安全评测里最极端的一类。
对夺旗类安全评测的溯源研究(来源:arXiv:2608.26237)把 1056 个被恢复的 flag 逐条回溯,发现只有 72.9% 背后有真正的执行支撑,10.9% 是人工验证过的推导,剩下 16.2% 完全说不清是怎么拿到的。
按有支撑的口径重打分,每个模型的分数下降 17 到 22 个百分点,排名跟着洗牌。
另一个方向是外壳。同模型、同任务、只换配置包,完整解决数从 43 涨到 72,F2PF 从 28% 升到 49%(来源:arXiv:2608.26218)。
换个说法更夸张:同一批 150 道题只改提示词的表面形式,小模型波动 9.6 到 19 个百分点,前沿版 16 到 21 个百分点;而同一配置重跑,几乎不波动。措辞扰动带来的方差,是重跑的 11 到 58 倍(来源:arXiv:2608.22331)。
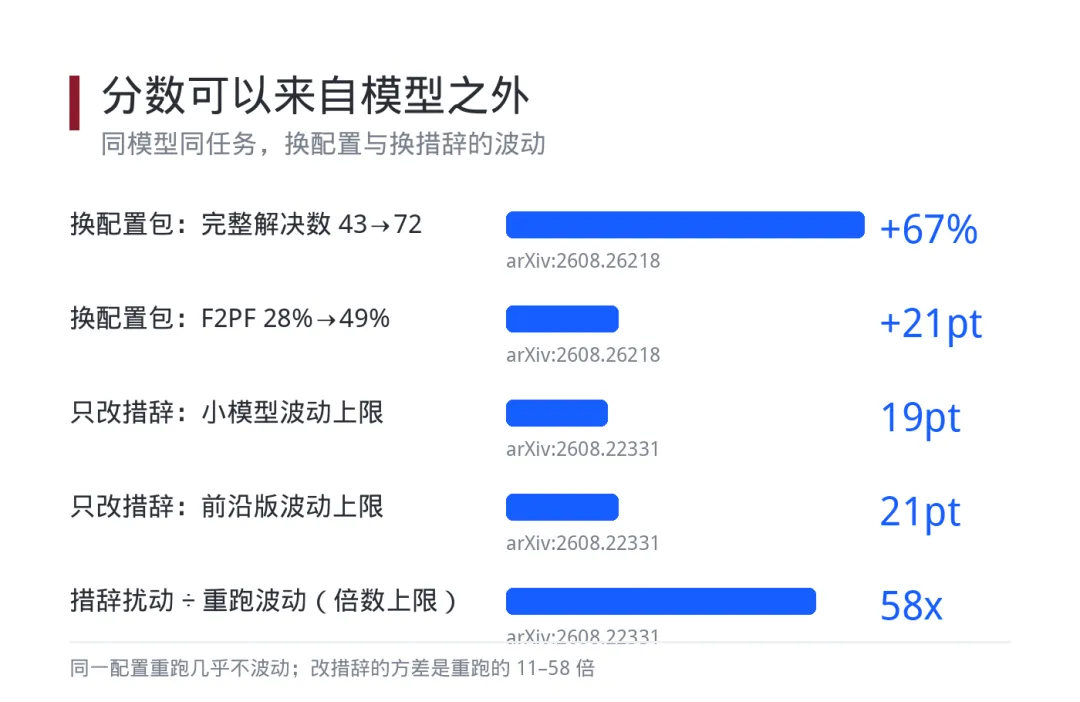 图注:左侧是同一模型只换配置包后的完整解决数与 F2PF;右侧是只改提示词表面形式的波动幅度。两组的共同点是:榜单上看到的差距,可以有相当一部分来自模型之外。数据来源:arXiv:2608.26218、arXiv:2608.22331。
还有一个数字解释了为什么"平均分"会骗人。轨迹感知评测(来源:arXiv:2608.22510)把同一批任务算两种通过率:至少成功一次是 0.66,三次全对是 0.29。差一倍多。榜单通常报前者,生产要的是后者。
这里有个反常识:题多不等于更准。1000 道题里如果有 800 道所有候选都做对,这 800 道对排名没有任何贡献,只稀释了分数。
真正决定区分力的是"有分歧的题"的数量。所以扩充评测集时,优先补的是候选之间结果不一致的场景,而不是随机加题。这一点和抽样调查里的"有效样本量"是一回事。
四、统计关:差几个点才算赢
前面三关做完,最后还有一个问题:这点差距,是不是噪声。
这一步有确定的算法,不需要争论。三个数决定一切:差距 δ、样本量 n、基准通过率 p。
先说单个分数的精度。n 道题、通过率 90%,95% 置信区间的半宽是这样的:n=100 时 ±6.0 个百分点,n=300 时 ±3.4,n=1000 时 ±1.9,n=3000 时 ±1.1。也就是说,100 道题的榜单,报 90% 和报 84% 的区别可能只是抽样。
再说"要分清多大差距,需要多少题"。两个模型各跑各的(独立设计),要在 80% 的把握下检出差距、显著性水平 0.05,每组所需样本是:
- 差 10 个点:每组 142 条
- 差 4 个点:每组 883 条,两组合计 1766 条
- 差 2 个点:每组 3532 条,两组合计 7064 条
- 差 1 个点:每组 14128 条,两组合计 28256 条
算法不复杂,一个公式能写下来:n = 2 × (1.96 + 0.84)² × p(1−p) ÷ δ²。p 是通过率,δ 是要分清的差距,1.96 和 0.84 分别是 5% 显著性水平与 80% 把握对应的系数。把 p=0.90、δ=0.04 代进去,每组 883 条。
配对比这省得多。同一批题让两个模型都跑,只看它们判定不同的那些题,所需题量是:
- 差 4 个点:391 道题
- 差 2 个点:1960 道题
- 差 1 个点:6277 道题
配对设计与独立设计的差距,是四倍半。原因不复杂:同一道题上两个模型的对错高度相关,配对把共有的难度差异消掉了,剩下的方差只来自分歧题。
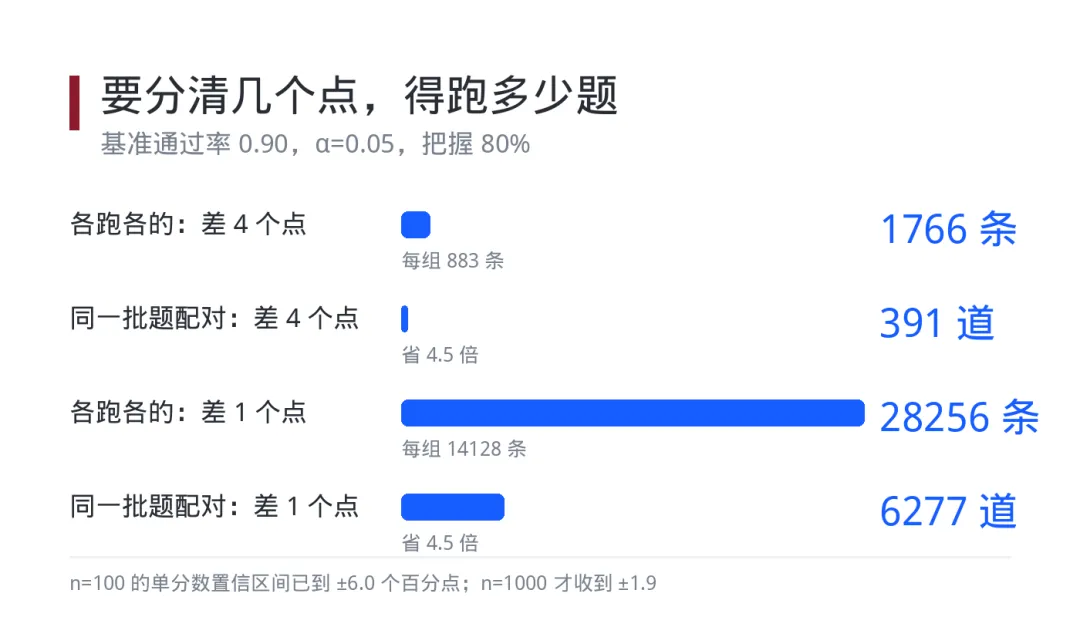 图注:横轴是要分清的差距(百分点),纵轴是需要跑多少次判定。配对比较把"分清 4 个点"的成本从 1766 条压到 391 道题,这是评测预算里最容易被忽略的一笔省钱。口径:基准通过率 0.90,α=0.05,power=0.80,正态近似。数据来源:本研究计算。
具体怎么算,给一个能直接套的例子。400 道题,同一批让 A、B 都跑:A 做对而 B 做错的 120 道,B 做对而 A 做错的 88 道,其余 192 道两边一样。
A 对 B 的净胜率是 (120−88)/400 = 8 个百分点,逐题差的 95% 置信区间是 1.0 到 15.0 个百分点。结论是 A 更好,但"好多少"可能是 1 个点,也可能是 15 个点。
换成 100 道对 84 道,净胜 4 个点,区间变成 −2.6 到 10.6,跨过零。同样的 400 道题,8 个点分得出,4 个点分不出。若题量缩到 100 道、胜负 30 对 22,8 个点也分不出,区间 −6.0 到 22.0。
这就是为什么"排名"和"能力"是两件事。榜单按点估计排名,点估计有误差;把误差画出来,第一名和第二名经常重叠。
还有一个反直觉的效应:基准越接近满分,同一条样本携带的信息越少。
通过率 80% 时,方差是 0.16;90% 时 0.09;95% 时 0.0475;98% 时 0.0196。分数涨上去,区分力掉下去。
这就是为什么 Anthropic 说单轮安全评估已经饱和——近期模型的无害回应率都在 94% 到 98% 之间,主要用途退化成"已知失败模式的回归检查"。饱和之后再想拉区分度,只能提高任务难度(更长的时程、更隐蔽的呈现),不能加陷阱题。
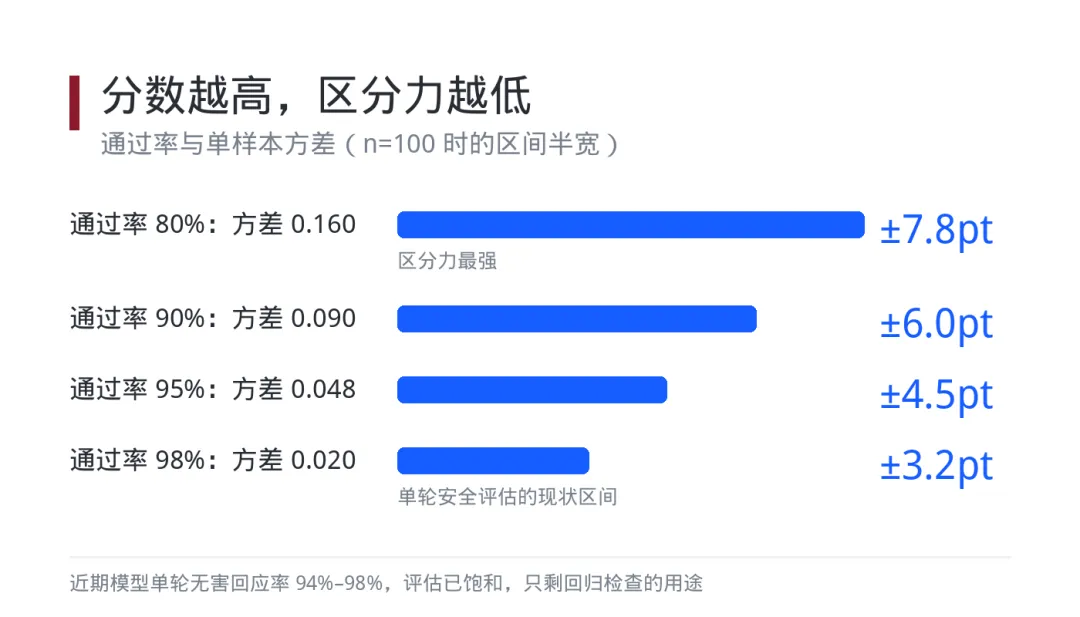 图注:同样的 100 道题,通过率从 80% 升到 98% 时,置信区间半宽从 ±7.8 缩到 ±3.2 个百分点,但方差只剩八分之一——留下的可测空间极窄。数据来源:本研究按二项分布计算。
饱和之后不是没救。另一项研究(来源:arXiv:2610.20667)转向被浪费的信息:每道题的完整解题轨迹。用历史基准回溯模拟饱和,再做两两评判,预测未饱和留出集上能力的误差,降到只用饱和分数的五分之一。
把这几条合起来,就是我给客户做评测时用的判定表:
| 你要回答的问题 |
需要的样本 |
判定方式 |
| 这版有没有明显退步(10 点以上) |
每组 150 条 |
独立两组,看是否跨过阈值 |
| A 和 B 谁更好(差 4 点以上) |
同一批 400 道题 |
配对比较,报逐题差的置信区间 |
| A 和 B 在强项上谁更好(差 1–2 点) |
2000 道题起 |
配对 + 分层(按难度/场景拆) |
| 发布能不能过 |
不靠分数,靠确定性检查 |
阻断规则:核心用例 100% 通过 |
Anthropic 给的下限正好落在这张表的量级上:复杂多轮评估以 100 道题为下限,较简单的单轮评估以 1000 道题为下限。他们还提醒,API 上的多轮评估置信区间可能宽过 ±10 个百分点;区间够宽时,如实说"分不出",比硬排一个名次更专业。
钱账要单独算。 一次多轮评估的成本不是"题目数 × 单价",而是三层相乘:题目数 × 每题的对话轮数 × 每轮的模型调用,再加上判定调用,最后加上人工抽检。
假设一套 400 道题的多轮集,每题平均 8 轮,被测模型和用户模拟器各一次调用,判定再来一次,那就是 400 × 8 × 3 ≈ 9600 次调用,还不含重跑。
这笔账解释了为什么大多数团队停在"跑一遍、看总分"。要把它压下来,只有三条路:减轮数(牺牲真实度)、减题量(牺牲精度)、改配对(不牺牲前两项)。
前两条是在精度上让步,第三条是真正省钱的那条——同一批题两个模型都跑,题量不变,判定次数翻倍,但可检出的差距从 4 个点降到 2 个点,单位精度成本下降一半以上。
别忽略多重比较。 一张榜如果同时报 20 个类别,每类单独做检验、显著性水平 0.05,那么平均会有一个类别"显著"——纯靠运气。
Anthropic 的建议是分区报告、既报变化的也报没变化的,并且做多重比较校正。换成读榜的动作:看到"某模型在某子项领先",先问这张榜一共报了多少子项,再问领先的幅度是否超过该子项的区间。
五、评分器要单独体检
分数大多不是人打出来的,是另一个模型打出来的。Anthropic 的理由很实在:没有人类团队能读完几十万份对话记录。代价是,评分器有它自己的偏差,而且会在没人察觉的情况下变松或变严。
已知的偏差至少有四种:偏爱自己家族的输出;偏爱更长的回复;在成对比较里偏爱先看到的那个选项;以及构念漂移——底层模型一换,判定标准悄悄挪了。
Anthropic 的做法是每条都堵:评分器只看对话、不看设计元数据;用与被测模型不同的模型当裁判;检查分数与回复长度是否相关;成对比较翻转顺序重跑;换一个评分器重给一批记录打标,看主要结论还成不成立。
偏差有多大,有实测。GAUGE 那项研究覆盖 6 家供应商、25 个"模型×温度"配置、约 3700 条对话(arXiv:2609.12191,亚马逊),量出两件事。
第一,盲评判定为满意的对话里,有 57.5% 实际没有完成用户任务——把"读起来满意"当成了"事办成了"。第二,同一家族的裁判平均多给自己人 0.75 分(7 分制),用自家模型当裁判,等于自己给自己发卷子。
最关键的一条是拿人做锚。让人类专家在看不到评分器判定的情况下打一批标,然后算人与评分器的一致性,扣掉运气成分的那部分(Cohen's kappa 一类统计量),再和人类专家彼此之间的一致性比较。
这里有个判断标准值得抄下来:人与评分器的一致程度,应当与专家彼此之间的一致程度相当。如果专家彼此都对"什么算正确答案"意见不一,那就不存在评分器该对齐的目标,要重做的是构念,不是评分器。
评分标准本身也有写法。Anthropic 的三条建议是:让评分尽可能简单客观,有标准答案的走程序化检查;把标准拆成原子化的二元问题,而不是一个总分;明确写出什么不应改变判定——比如免责声明、限定条件、教育性框架,不能让有害内容变得无害。
还有一条容易被忽略的细节:程序化匹配也会错。用模式匹配从回复里抽"是"或"否",可能把"是的,我通常很乐意帮忙,但这个请求不行"里的"是"判成遵从。这类假阳性只能靠看样本发现,不能靠看分数发现。
最后一条容易被跳过:大声失败。评分器出故障时,该被标记并排除,而不是默默打个分。这一点在工程上等于要求日志里能看到"这题解析失败了",而不是让错误变成 0 分混进平均。
六、今天这三张榜,各自能说明什么
回到今天的三条新闻,用上面的口径各读一遍。
Neon 的 58.6 分排第一,来自 Artificial Analysis 的编程智能体指数。这是个合成指数,由若干子任务加权;指数本身不给权重、不给置信区间、不给题目数量。
能看到的是它比 Carbon 每任务便宜 32%,速度约三倍,Glean 的早期评测说质量追平 Carbon、只用六成成本(来源:谷歌官方博客,2026-11-18)。这三条里,最可信的是价格和速度——它们是账单与延迟,不是评分。分数那句"排第一",只能当方向。
价格这条也值得算一下。输入 3 美元、输出 15 美元每百万 token,缓存输入 0.15 美元,官方说相当于 95% 折扣;再叠加"每任务便宜 32%",两个口径不是一回事:前者是 token 单价,后者是完成任务的总成本,取决于 token 用量与重试次数。用单价去推任务成本,通常会高估。
商汤日日新 U1 Pro 在 Design Arena 的图像生成与编辑两榜都是中国第一、全球第六(来源:量子位,2026-11-19)。Design Arena 的方法是同题生成、匿名两两对比、真实用户投票算 Elo。
这套方法比单模型打分好,因为两两对比对量纲不敏感;但它仍然是偏好测量,不是正确性测量,而且 Elo 的分差在不同样本量下不可直接比较。榜单旁边那张"效果对成本"的散点更有用——U1 Pro 落在高偏好、低价格的一角,这是选型能直接用的坐标。
用配对的方式读这张榜,会看到它其实在报"胜率":同一道题两个候选出图,用户选谁。这类数据的样本量就是投票对数,几百对和几万对给出的 Elo 精度完全不同。看到"并列第六",先问是点估计并列,还是区间重叠。
范式智能的 Phai-A1 报的是 SWE-Bench 三个版本跑赢同级(来源:量子位,2026-11-19)。
SWE-Bench 是少数有可执行判据的基准,这类分数的可信度天然高于主观榜;但它同样要求你问三件事:题目是不是在训练截止日之前、测试是否拒绝了正确解法、跑了几次取哪个值。
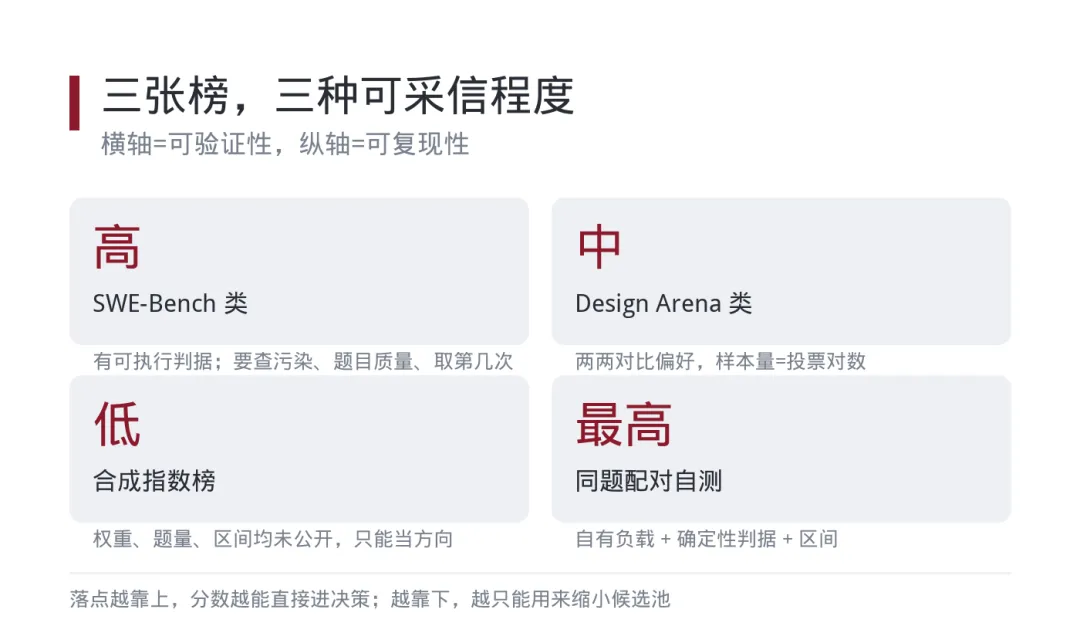 图注:横轴是可验证程度(是否有可执行判据),纵轴是可复现程度(是否公开题目、配置、评分器)。落点越靠右上,分数越能直接用于决策;越靠左下,越只能当方向。数据来源:本研究按公开信息评估。
七、企业该建三层评测
企业侧的问题不是"哪个榜准",是"我这套系统该不该上线"。这件事一层评测答不了,要三层。
第一层是外部榜,用途只有一个:缩小候选池。读法是三问——口径对不对(测的是你要的能力吗)、样本够不够(有没有 CI)、有没有污染(题目在不在训练集里)。这一层不承担决策,只承担淘汰。
第二层是内部回归集,这是企业的核心资产。它应该由自己的真实请求构成,按场景分层,每条带确定性判据。原则是能程序验证的优先程序验证:是否调用指定工具、是否拒绝危险命令、是否通过测试、是否遵守输出 schema,这些走脚本;解释是否清楚、语义是否覆盖,才交给 LLM 评委。
怎么起盘,给一个能落地的规模:从三个月真实请求里抽 200 到 300 条,按场景分 6 到 10 层(每层 25 到 40 条),每层里既有常规样本,也有当初出过事的样本。
这个规模能稳住 10 个百分点以上的退步,也就是"这版明显坏了"这一类判断;要判 2 到 4 个点的差异,得在同一批题上跑配对,而不是扩大题目数。
这一层必须挂在发布流程上,而且要分级。核心用例 100% 通过,才允许发;关键工作流成功率不得低于阈值;引用错误率、越权调用、单次成本不得上升。一个改动质量略升但工具调用翻倍、延迟翻倍,不该算改进。
第三层是在线验收。离线集永远比真实流量简单,因为真实用户的说法是乱的。
有一项评测专门做过这件事:给排障智能体喂不可靠的报障单,一半是谎报,健康网络被误诊的比例最高到 24%,而措辞的影响达到 14.5 个百分点(来源:arXiv:2608.27021)。这说明场景设计本身带偏见,离线跑分高不代表上线稳。
三层的关系是漏斗,不是替代。外部榜淘汰明显不行的,内部集拦住会出事的,在线验收回答"真实用户能不能用起来"。
八、反方证据、证伪条件与未知边界
一套判断如果不给出可被推翻的条件,就只是立场。先写三个反方证据。
反方一:榜单在粗筛阶段是有效的。GAUGE 那项研究把 LLM 用户模拟器加裁判的排序,与可验证奖励的排序对照,25 个"模型×温度"配置的整体秩相关达到 0.94。能力差距大时,决策分歧率不到 1%。也就是说,用榜单淘汰一批明显更差的方案,有统计支撑。
反方二:饱和不等于评测失效。把饱和基准的解题轨迹当数据用,两两评判能把预测误差降到只用分数的五分之一。评测的寿命可以比分数长。
反方三:成本不是不可解。配对比较把分清 4 个点的题量从 1766 压到 391,这在小团队预算里能承受。
证伪条件:如果某家厂商公开逐题结果与置信区间,并且在一个新基准上、跨三个独立复现团队,排名稳定地落在区间之外,那么"小分差多数是噪声"这个判断就不成立——那时该承认分差是真的,上面那张判定表的下限要往下调。
边界有四个。
第一,成本口径不明。各家评测一条样本的成本差异很大:多轮模拟要跑完整对话,判定还要再过一次模型,人工抽检另算。公开材料基本不给单条成本,本文只算题量,不算钱。
第二,评测集多为私有。企业内部的回归集不公开,意味着跨公司的分数不可比。这一点短期内不会改变。
第三,评分器版本会漂。同一个评测换个评分器版本,分数可能整体平移。Anthropic 的建议是不要比较来自不同评分器的分数——这条在跨季度对比时最容易被违反。
第四,本文的样本量计算基于正态近似,假定题目之间相互独立。同一场景的多道题如果高度相关(比如都考同一个 API),有效样本量会低于题目数,实际需要的题量更大。
还有一个更根本的未知:评测衡量的到底是能力,还是被评测本身塑造出来的行为。基准奖励什么,模型就长成什么样;这一层目前没有可控的实验。
再补一条容易被当成常识的假设:本文默认"评测分数高"与"业务效果好"同向。二者只在评测集与业务分布一致时同向,而企业自建集与业务分布的偏差,通常比模型之间的差距更大。
九、对企业意味着什么
四个动作,按顺序做。
第一,把"分差"换算成"决策"。拿到一个榜单,先问差距多少、样本多少,算出置信区间。区间跨过零,就不要写进选型报告。这一步不花钱,只需要一个计算器。
第二,把内部回归集按配对方式跑。同一批题让两个候选都跑,报逐题差的置信区间,而不是各自的总分。这一步能把评测成本降四倍半,也能让"哪个更好"这个问题第一次有确定答案。
第三,给评分器立体检制度。每次换模型、换评分器、改评分标准,都拿一批人工标注复核一次一致性。评分器是会漂的仪器,不是一次校准管终身。
第四,给评测集设保质期。一套题跑过三四个模型版本之后,多数题会饱和,区分力下降;这时该按"有分歧的题"更新一批,而不是继续用总分做决定。评测集的更新频率,应该跟模型换代频率同量级。
源势AI观点
评测这一层,过去两年最大的错觉是"分数可比"。榜单把不同口径的数字排成一列,读者自然以为可以横着比。实际上,横着比的前提是同一批题、同一个评分器、同一个配置、足够的样本量——四个条件同时满足的情况极少。
我们的做法是把评测当仪表盘,不当成绩单。仪表盘的作用是发现异常,不是宣布冠军。所以给客户做交付时,我们固定给三样东西:一份按场景分层的回归集,每条带确定性判据;一张逐题差异的置信区间表;一套评分器体检记录。前两样决定能不能上线,第三样决定这套评测明年还准不准。
对做 AI Infra 的团队,这件事还有个额外的含义。我们每天在比的不是模型分数,是有效吞吐、首 token 延迟、单 token 成本——这些指标有明确的单位,也有明确的测量误差。把它们按评测的口径管起来:同一批请求、配对比较、报区间。这比追一个榜单名次有用得多。
来源说明:本文数据线索部分来自当日行业汇编《AI行业24小时_20261120_10》,其中 Neon 与 Design Arena 的分数为厂商与榜单方公开口径,未经第三方复现;统计计算为本研究按公开参数自行完成,方法与参数已在图注中标注。
话题标签:#评测方法 #基准可信度 #样本量
源势AI · 企业级 AI 基础设施服务商
AI 能力的连接器,企业增长的源动力
AI Infra:算力、模型与 Token 的统一调度治理
Agent Infra:智能体的编排、安全与规模化落地
共享统一网关 · 身份 · 计量 · 审计
官网 www.srcflow.cn | 邮箱 business@srcflow.cn
关注我们 · 获取更多 AI 前沿洞察
