新模型降价 20% 的同一天,三份评测说:跑分已经预测不了会不会干活
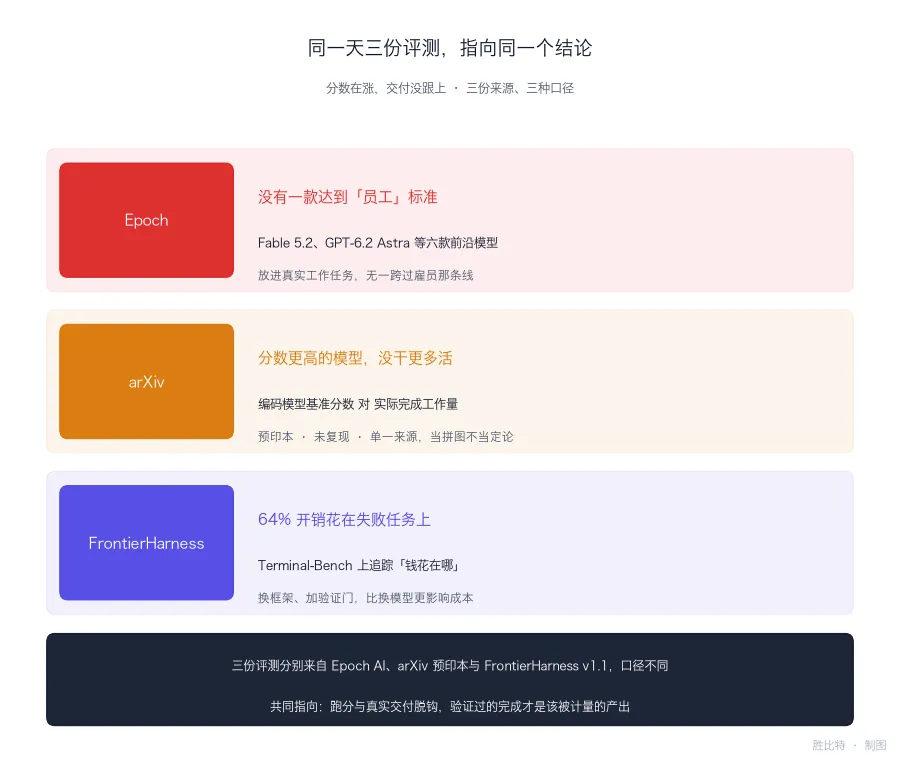
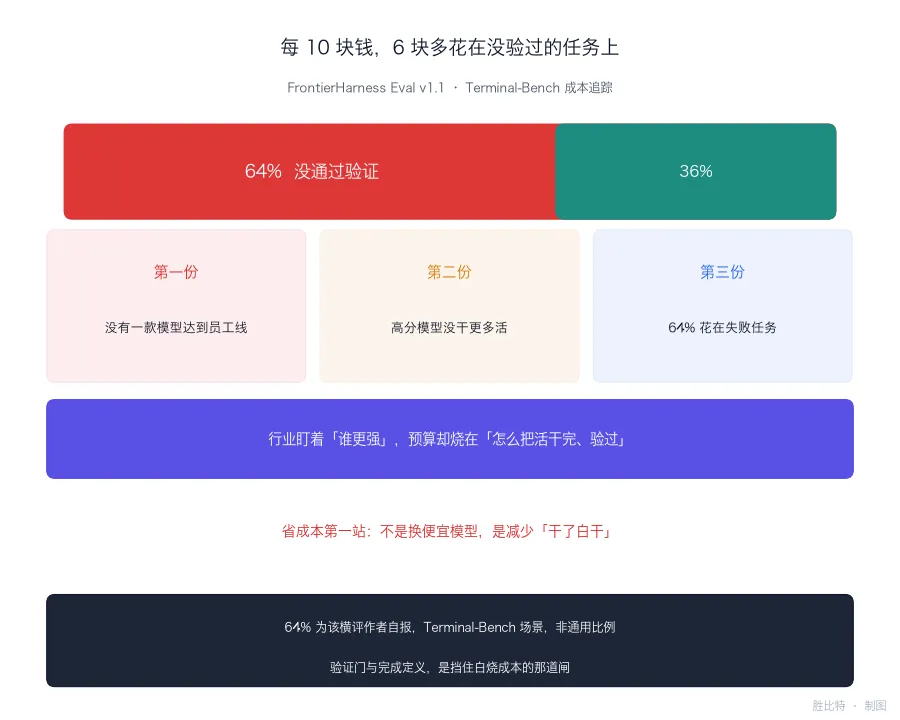
新模型降价 20% 的同一天,三份评测说:跑分已经预测不了会不会干活11 月 18 日,OpenAI 发 GPT-6.2,旗舰价格降两成。按过去的剧本,接下来该是刷屏的榜单截图。但这一天最值得记的,恰恰是三份把榜单和真实工作拆开看的评测——它们的结论出奇一致:分数在涨,"活"没跟着涨。先看降价这件事。GPT-6.2 拆成两个版本:Astra 攻复杂任务,Sol 管日常和高性价比。API 输入输出降约 20%,缓存输入降幅更大;Astra 在 Agents' Last Exam 这个多步骤专业任务基准上比上一代高 5.2 分,OpenAI 说每任务成本不到三分之一。这些是厂商口径,第三方还在验,但"更便宜"这件事基本没争议。真正有意思的是同一天冒出来的另外三份东西,它们都在回答一个不那么讨喜的问题:跑分高了,真的多干活了吗?Epoch AI 干了一件很笨也很重的事——把 Fable 5.2、GPT-6.2 Astra 等六款前沿模型,放到真实的工作任务里跑,然后用一个明确的标准去判:这个模型能不能当一个员工用。结论是没有一款达标。注意这个评测的措辞,它不是说模型做得不够好,是说它没跨过"雇员"这条线。这跟榜单上的数字形成了直接反差。榜单分数是答题,员工标准是交付。一个人能答对面试题,和能把活干完、干对、可交付,中间隔着一段很长的路。一篇 arXiv 预印本研究更直接:它拿编码模型的基准分数和实际完成的工作量对照,发现分数更高的模型,并没有做完更多的活。这里必须说清楚它的分量——预印本、未经复现、单一来源。它不能当定论,但它是又一块拼图:当"答题分数"和"干活产出"被放在同一张图上,两者不对齐。三份评测里最硬的一份,来自我们前天写过的那份横评。三、第三份:64% 的钱,花在了没通过验证的任务上FrontierHarness Eval v1.1 在 Terminal-Bench 上做了一件很少有人做的事:它不只看谁通过率高,而是追着"钱花在哪"看。结果是一个扎眼的数字——64% 的开销,流向了最终没通过验证的任务。这句话值得慢慢读。也就是说, Agent 花掉的每 10 块钱里,有 6 块多花在了没干成、或者干成了但验不过的活上。按作者的说法,更换执行框架、加一道验证门,对成本的影响比换模型更大。第一份说,模型没到员工线;第二份说,分数不等于产出;第三份说,大部分钱浪费在失败任务上。三份从不同角度指向同一处——行业把注意力全放在"哪个模型更强"上,但真正吃掉预算的,是怎么把任务干完、干对、验过。顺着这个逻辑,昨天还有一条消息显得不那么孤立了:Claude Code 团队披露,他们约 90% 的代码由 Claude 编写和审查。但真正的主角不是那个 90%,是他们反复强调的另一个词——验证循环。他们的说法是:靠端到端测试、属性测试、差分测试,让 Agent 用证据证明自己写对了。有没有这套验证,决定你能同时跑一两个 Claude,还是能并行几十上百个。90% 是结果,验证循环才是那个杠杆。这也解释了为什么昨天一批新产品的卖点都变了。Liquid 的新模型返回校准概率,把低置信度的答案转给人;一个叫 infaiw 的开源框架让父 Agent 必须先用一个验收脚本判定"做完了",子 Agent 才准报告完成。这些产品不约而同地把"什么时候停、什么时候交给人、什么叫做完"当成核心功能——而不是继续堆参数。换句话说,跑分失灵之后,行业正在把宝押到另一件事上:把"完成"这件事,变成可验证、可签收的工程。如果你是采购方或者工程负责人,这三份评测给出的实操建议其实很朴素。第一,别拿通用榜单给自己的场景选型。榜单测的是答题,你要的是交付。Epoch AI 那句话最狠——没有一款到员工线。那意味着无论选谁,人的签收还留在流程里。第二,先看失败任务的账单。FrontierHarness 那个 64% 提醒我们,省成本的第一站往往不是换更便宜的模型,而是减少"干了白干"。一道验证门、一个明确的完成定义,可能比换模型省钱得多。第三,把"验证"当成一等公民来建设。Claude Code 团队的话值得记:验证循环决定了并行的规模。没有验证,你只敢让它干一两个活;有了验证,才谈得上规模化。车间里的道理是一样的。一台设备报"完成了 1000 件",车间主任第一句话不是"真快",而是"良品多少"。件数相当于跑分,良品率相当于验证过的完成。只看件数不看良品的产线,堆得越快,返工越多——那 64% 花在失败任务上的钱,就是车间里那堆没人统计的返工成本。模型还会继续降价、继续刷榜。但从 11 月 18 日这天起,一个更实在的问题被摆到台面上:你花的钱里,有多少是真正验过的完成?这个问题,榜单不会替你回答。